跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. 男人們的大玩具 欣賞一下美國網友的 Homelab

男人們的大玩具 欣賞一下美國網友的 Homelab

已定时 已固定 已锁定 已移动 AI硬件
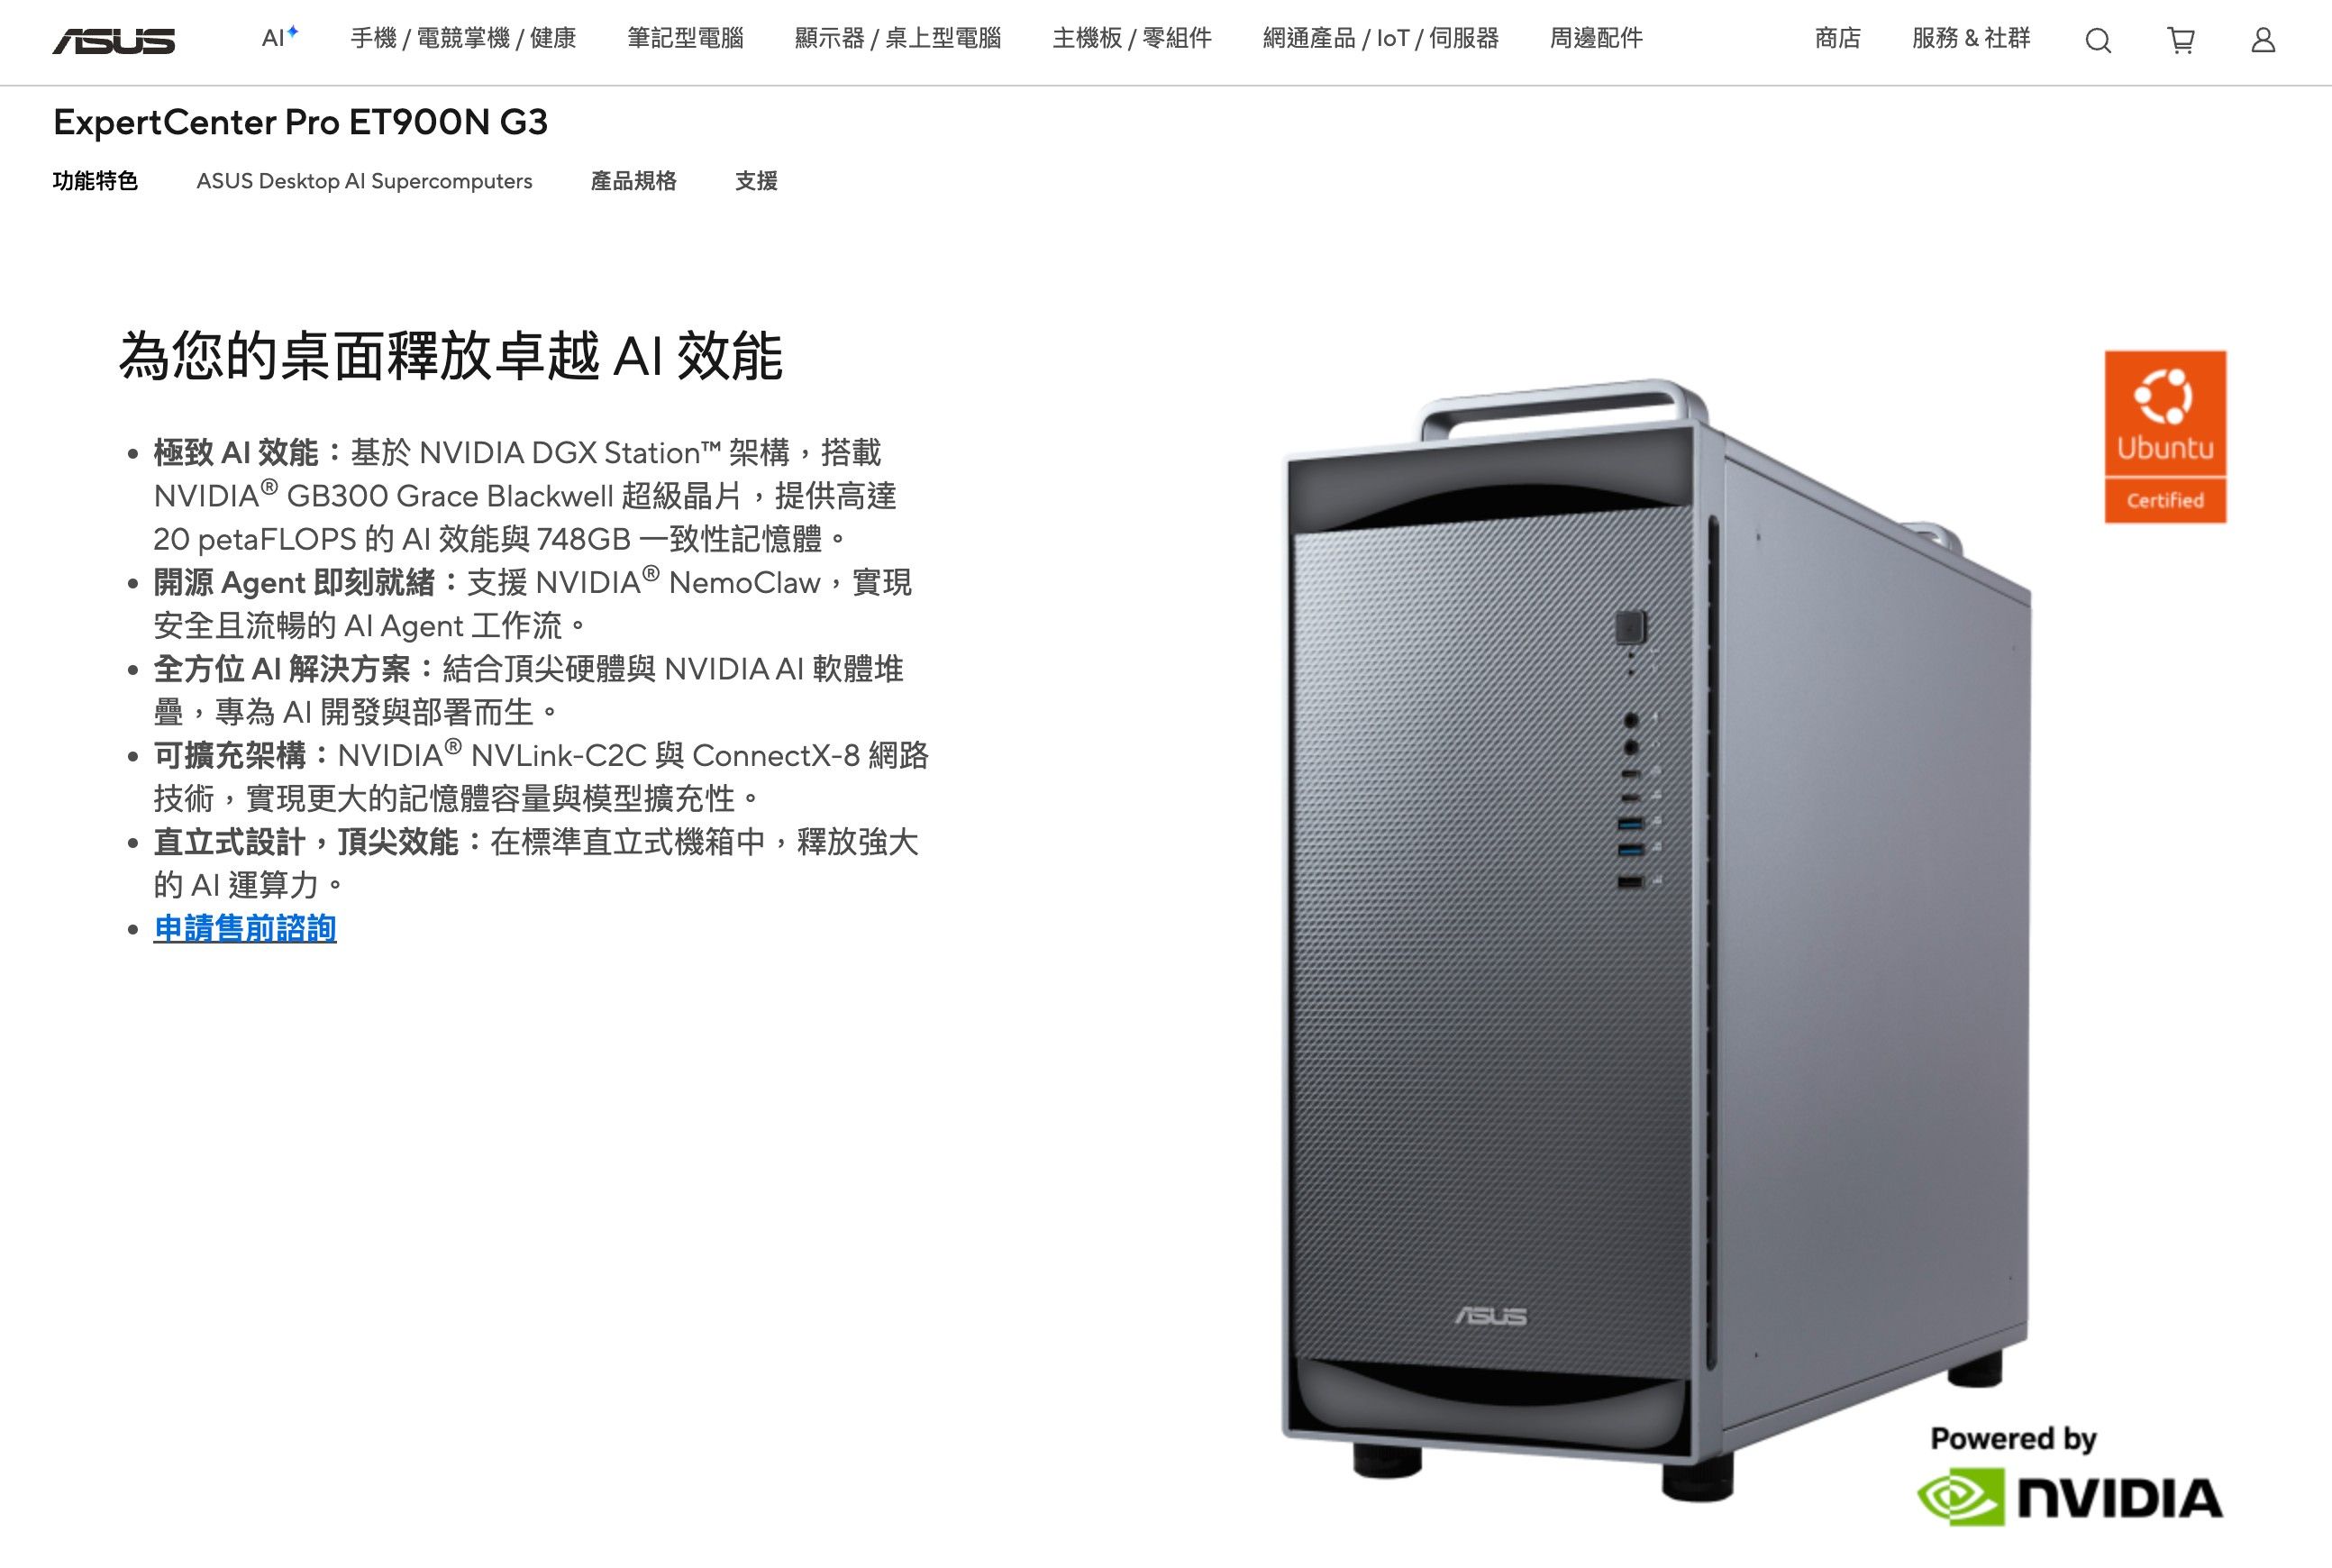
rtxpro6000多卡部署nvidia
15 帖子 6 发布者 705 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • imbiplaza ASUSI imbiplaza ASUS

    @kos-or

    吓。。。你一次过上顶了

    羡慕

    kos orK
    kos orK
    kos or
    至尊皇帝
    发表于 最后由 编辑
    #4

    @imbiplaza-ASUS

    基本上 家家戶戶 都至少要有兩張 RTX Pro 6000 MaxQ at $300 each. 😁
    AI 的價值不應該如此昂貴 , We need freedom of AI and Pro 6000.

    imbiplaza ASUSI 1 条回复 最后回复
    1
    • Tony WangT Tony Wang

      冲上云霄 👍

      kos orK
      kos orK
      kos or
      至尊皇帝
      发表于 最后由 编辑
      #5

      @Tony-Wang

      帖子的標題說得很好, Local AI is Minecraft for Adults. The whole digital world is like Minecraft Gaming. 😊

      1 条回复 最后回复
      0
      • kos orK kos or

        @imbiplaza-ASUS

        基本上 家家戶戶 都至少要有兩張 RTX Pro 6000 MaxQ at $300 each. 😁
        AI 的價值不應該如此昂貴 , We need freedom of AI and Pro 6000.

        imbiplaza ASUSI
        imbiplaza ASUSI
        imbiplaza ASUS
        谪仙人
        发表于 最后由 编辑
        #6

        @kos-or

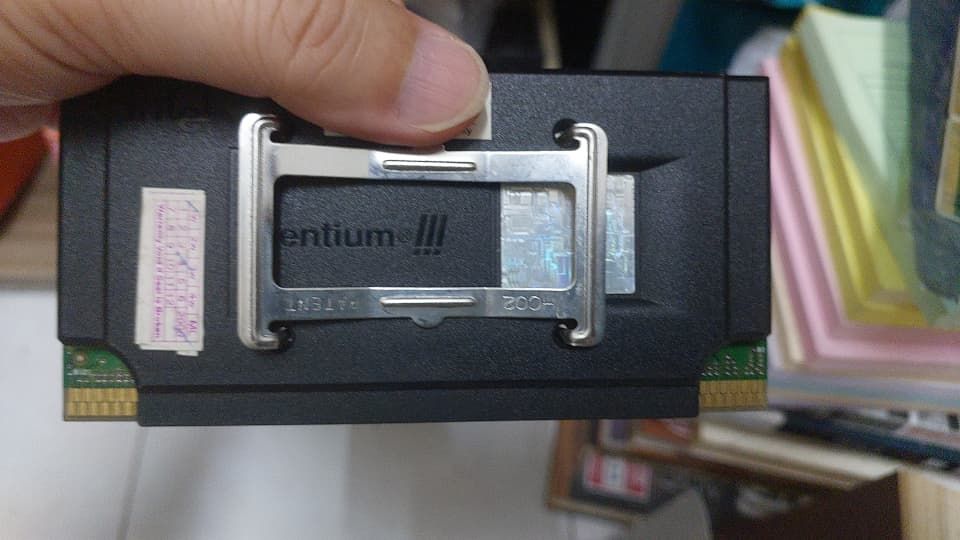
        电脑硬件一定会越来也便宜。。就好像我买的PIII 当时候就是Rtxpro 6000....

        WhatsApp Image 2026-09-06 at 5.36.52 PM.jpeg

        W Tony WangT kos orK 3 条回复 最后回复
        0
        • imbiplaza ASUSI imbiplaza ASUS

          @kos-or

          电脑硬件一定会越来也便宜。。就好像我买的PIII 当时候就是Rtxpro 6000....

          WhatsApp Image 2026-09-06 at 5.36.52 PM.jpeg

          W
          W
          wml-ai
          体面乡绅 硕果累累
          发表于 最后由 编辑
          #7

          @imbiplaza-ASUS 说:

          @kos-or

          电脑硬件一定会越来也便宜。。就好像我买的PIII 当时候就是Rtxpro 6000....

          WhatsApp Image 2026-09-06 at 5.36.52 PM.jpeg

          年代感十足!👍

          Windows-Mac-Linux-AI

          1 条回复 最后回复
          1
          • imbiplaza ASUSI imbiplaza ASUS

            @kos-or

            电脑硬件一定会越来也便宜。。就好像我买的PIII 当时候就是Rtxpro 6000....

            WhatsApp Image 2026-09-06 at 5.36.52 PM.jpeg

            Tony WangT
            Tony WangT
            Tony Wang
            易有太极
            发表于 最后由 编辑
            #8

            @imbiplaza-ASUS

            当年的Voodoo 更像是现在的RTX Pro 6000

            1 条回复 最后回复
            0
            • johnnybegoodJ
              johnnybegoodJ
              johnnybegood
              王侯将相
              发表于 最后由 编辑
              #9

              想当年我的 ATi 128

              1 条回复 最后回复
              0
              • imbiplaza ASUSI imbiplaza ASUS

                @kos-or

                电脑硬件一定会越来也便宜。。就好像我买的PIII 当时候就是Rtxpro 6000....

                WhatsApp Image 2026-09-06 at 5.36.52 PM.jpeg

                kos orK
                kos orK
                kos or
                至尊皇帝
                发表于 最后由 kos or 编辑
                #10

                @imbiplaza-ASUS

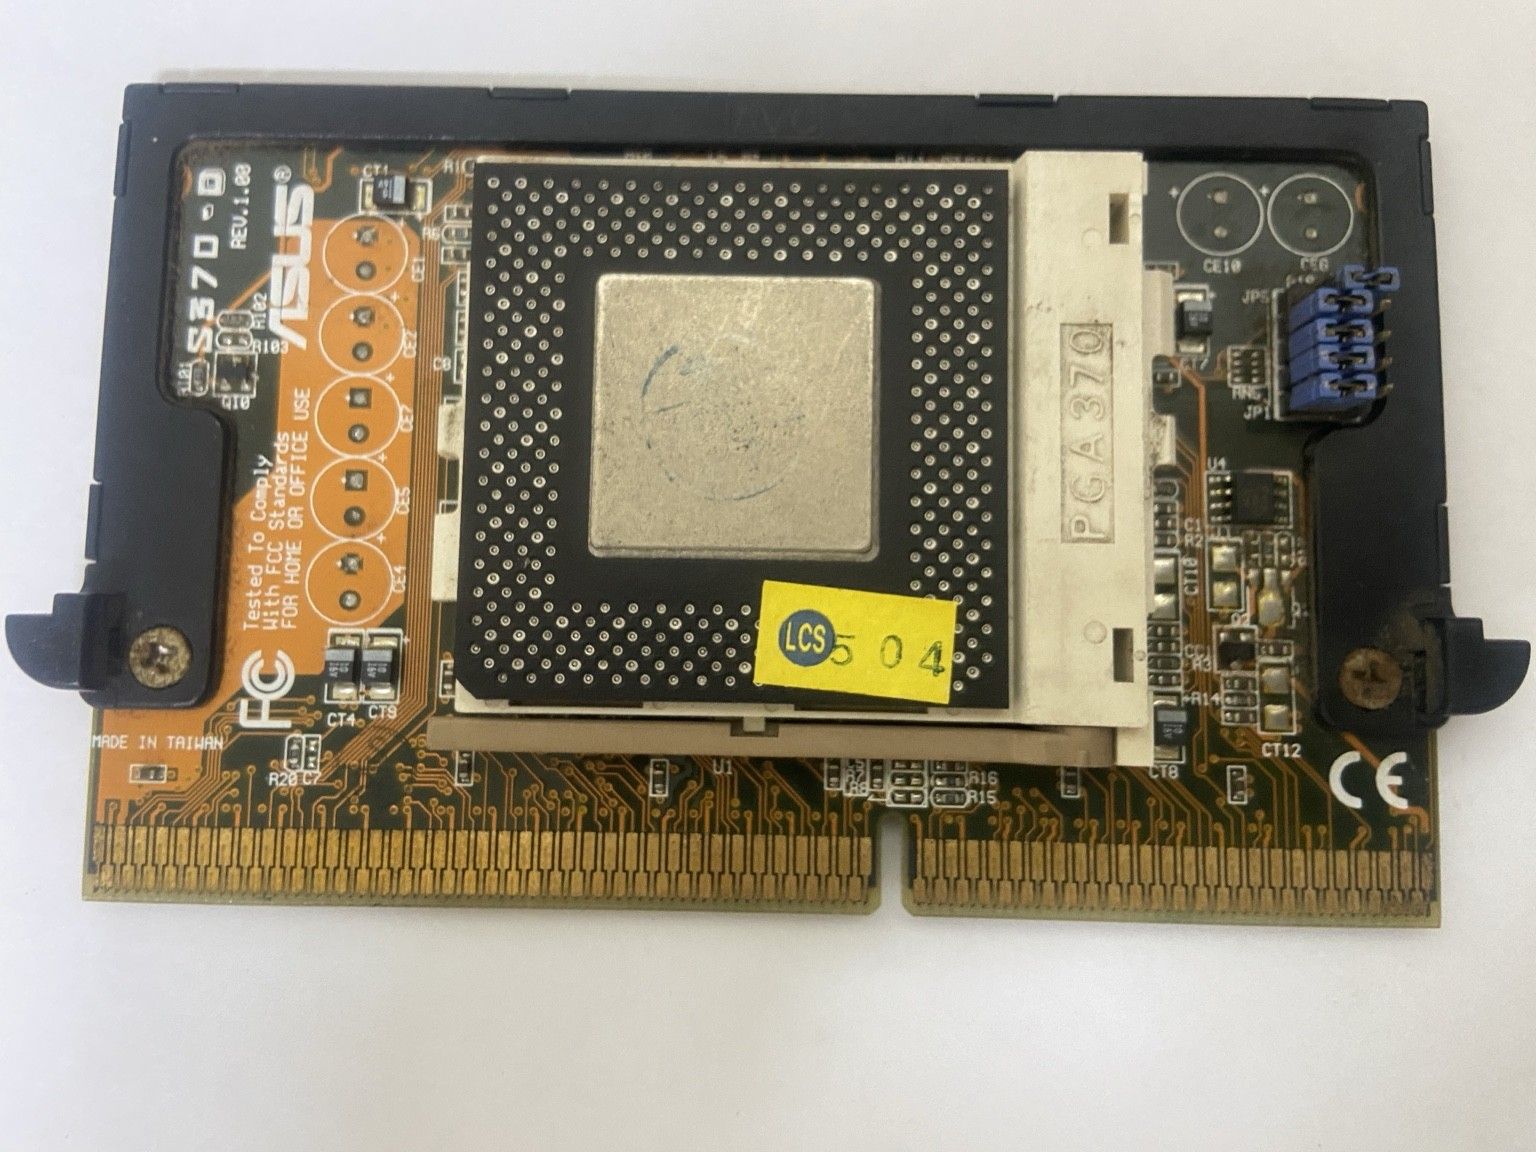
                我有一張轉接卡 整理東西的時候 都捨不得丟 其實也忘了怎麼來的
                剛查了一下是 Intel Scoket730 CPU Celeron
                8078e132-338c-4a21-adfa-5a21eba4d27e-image.jpeg

                所以十年後 大概家家戶戶 都會有一台Supercomputer了 😁

                5af2912e-e9d5-4942-b474-96e7a634500e-image.jpeg

                1 条回复 最后回复
                0
                • YDMY
                  YDMY
                  YDM
                  体面乡绅 硕果累累
                  发表于 最后由 编辑
                  #11

                  雙 5070 Ti 默默經過~~

                  kos orK 1 条回复 最后回复
                  0
                  • YDMY YDM

                    雙 5070 Ti 默默經過~~

                    kos orK
                    kos orK
                    kos or
                    至尊皇帝
                    发表于 最后由 编辑
                    #12

                    @YDM

                    謝謝您的陪伴 我也是小16G x 2 🤤
                    你要不要多一張 7900 XTX 24GB ?不錯用說 考慮一下

                    YDMY 1 条回复 最后回复
                    1
                    • kos orK kos or

                      @YDM

                      謝謝您的陪伴 我也是小16G x 2 🤤
                      你要不要多一張 7900 XTX 24GB ?不錯用說 考慮一下

                      YDMY
                      YDMY
                      YDM
                      体面乡绅 硕果累累
                      发表于 最后由 编辑
                      #13

                      @kos-or 说:

                      謝謝您的陪伴 我也是小16G x 2 🤤
                      你要不要多一張 7900 XTX 24GB ?不錯用說 考慮一下

                      暫時沒有要加硬體,現在雙卡 跑LLM 還不錯,玩HERMES夠用就好~~

                      LLama.cpp 更新 b10786 把 mmproj 放 cuda 1 VRAM 平均 跑起來還可以,試幾天看看會不會oom ,不會再拉高ctx,大該有70~75 t/s

                      llama-server.exe ^
                      -m "models\Qwen3.8-27B-UD-Q5_K_XL.gguf" ^
                      --mmproj "models\mmproj-Qwen3.8-27B-f16.gguf" ^
                      --mmproj-device CUDA1 ^
                      --image-min-tokens 1024 ^
                      --image-max-tokens 2048 ^
                      --split-mode tensor ^
                      --tensor-split 1,1 ^
                      --main-gpu 0 ^
                      -ngl 999 ^
                      -t 8 ^
                      -fa on ^
                      --ctx-size 131072 ^
                      --parallel 1 ^
                      -b 4096 ^
                      -ub 1024 ^
                      -cb ^
                      --cache-type-k q8_0 ^
                      --cache-type-v q8_0 ^
                      --spec-type draft-mtp ^
                      --spec-draft-ngl 999 ^
                      --spec-draft-n-max 2 ^
                      --spec-draft-p-min 0 ^
                      --jinja ^
                      --chat-template-file "models\chat_template.jinja" ^
                      --reasoning-format deepseek ^
                      --reasoning-preserve ^
                      --chat-template-kwargs "{"reasoning_effort":"medium"}" ^
                      --temp 0.2 ^
                      --min-p 0.05 ^
                      --samplers "min_p;temperature" ^
                      --repeat-penalty 1.05 ^
                      --host 0.0.0.0 ^
                      --port 8080

                      kos orK 1 条回复 最后回复
                      0
                      • YDMY YDM

                        @kos-or 说:

                        謝謝您的陪伴 我也是小16G x 2 🤤
                        你要不要多一張 7900 XTX 24GB ?不錯用說 考慮一下

                        暫時沒有要加硬體,現在雙卡 跑LLM 還不錯,玩HERMES夠用就好~~

                        LLama.cpp 更新 b10786 把 mmproj 放 cuda 1 VRAM 平均 跑起來還可以,試幾天看看會不會oom ,不會再拉高ctx,大該有70~75 t/s

                        llama-server.exe ^
                        -m "models\Qwen3.8-27B-UD-Q5_K_XL.gguf" ^
                        --mmproj "models\mmproj-Qwen3.8-27B-f16.gguf" ^
                        --mmproj-device CUDA1 ^
                        --image-min-tokens 1024 ^
                        --image-max-tokens 2048 ^
                        --split-mode tensor ^
                        --tensor-split 1,1 ^
                        --main-gpu 0 ^
                        -ngl 999 ^
                        -t 8 ^
                        -fa on ^
                        --ctx-size 131072 ^
                        --parallel 1 ^
                        -b 4096 ^
                        -ub 1024 ^
                        -cb ^
                        --cache-type-k q8_0 ^
                        --cache-type-v q8_0 ^
                        --spec-type draft-mtp ^
                        --spec-draft-ngl 999 ^
                        --spec-draft-n-max 2 ^
                        --spec-draft-p-min 0 ^
                        --jinja ^
                        --chat-template-file "models\chat_template.jinja" ^
                        --reasoning-format deepseek ^
                        --reasoning-preserve ^
                        --chat-template-kwargs "{"reasoning_effort":"medium"}" ^
                        --temp 0.2 ^
                        --min-p 0.05 ^
                        --samplers "min_p;temperature" ^
                        --repeat-penalty 1.05 ^
                        --host 0.0.0.0 ^
                        --port 8080

                        kos orK
                        kos orK
                        kos or
                        至尊皇帝
                        发表于 最后由 编辑
                        #14

                        @YDM said:

                        -ub 1024 ^

                        我這禮拜測試 , -ub 512 好像是 PP最佳值, 不過測試對象是 7900 XTX
                        Dual RTX5070Ti 一般沒什麼問題, SGLang 好像蠻穩的

                        Qwen3.8-27B-UD-Q5_K_XL.ggu 換Q4_K_M 可能TPS會更高, 除非是需要 Coding

                        --cache-type-k q8_0 ^
                        --cache-type-v q8_0 ^

                        我都用 Q4 換取更大的 ctx-size 😁

                        YDMY 1 条回复 最后回复
                        1
                        • kos orK kos or

                          @YDM said:

                          -ub 1024 ^

                          我這禮拜測試 , -ub 512 好像是 PP最佳值, 不過測試對象是 7900 XTX
                          Dual RTX5070Ti 一般沒什麼問題, SGLang 好像蠻穩的

                          Qwen3.8-27B-UD-Q5_K_XL.ggu 換Q4_K_M 可能TPS會更高, 除非是需要 Coding

                          --cache-type-k q8_0 ^
                          --cache-type-v q8_0 ^

                          我都用 Q4 換取更大的 ctx-size 😁

                          YDMY
                          YDMY
                          YDM
                          体面乡绅 硕果累累
                          发表于 最后由 YDM 编辑
                          #15

                          @kos-or 说:

                          我這禮拜測試 , -ub 512 好像是 PP最佳值, 不過測試對象是 7900 XTX
                          Dual RTX5070Ti 一般沒什麼問題, SGLang 好像蠻穩的

                          Qwen3.8-27B-UD-Q5_K_XL.ggu 換Q4_K_M 可能TPS會更高, 除非是需要 Coding

                          --cache-type-k q8_0 ^
                          --cache-type-v q8_0 ^

                          我都用 Q4 換取更大的 ctx-size 😁

                          我本來也是用-ub 512 開來試一下,忘記調回了😂

                          Q5_K_XL.gguf 我和Q4 跑起來有一些精度的差別,我要精度~~
                          kv cache 我也試過Q4,Q8,Q8精度也好一點點,所以試了可以,把5070ti 壓到我需要的最大精度、最快速度 !!😊

                          地端,寫個腳本,我就有感覺了~~~

                          SGLang 還沒玩,LLAMA.CPP個人使用最簡單😂

                          1 条回复 最后回复
                          1

                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                          有了你的建议,这篇帖子会更精彩哦 💗

                          注册 登录
                          回复
                          • 在新帖中回复
                          登录后回复
                          • 从旧到新
                          • 从新到旧
                          • 最多赞同


                          • 登录

                          • 登录或注册以进行搜索。
                          • 第一个帖子
                            最后一个帖子
                          0
                          • 版块
                          • 最新
                          • 标签
                          • 热门
                          • 用户
                          • 群组