闲置NUC+TB4 显卡坞+NVIDIA CMP 170HX 8GB 挖矿卡,能跑什么本地模型?
-
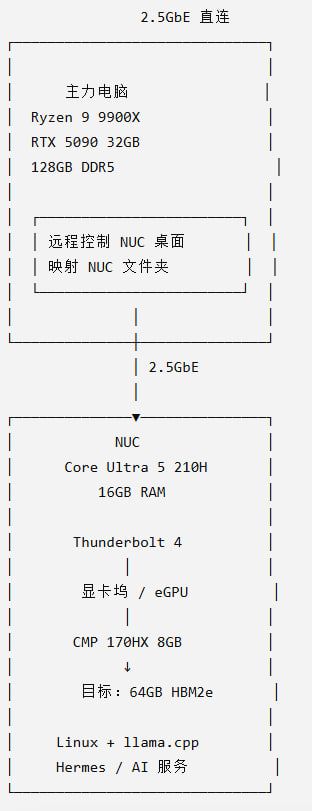
前几天逛易贝看到NVIDIA CMP 170HX 8GB 挖矿卡已经涨到2500刀,心血来潮搞了一张,想着拿来组个终端给我的台式机打个下手,24小时跑本地模型随时待命。
原本打算再淘一些像X99和DDR3的128GB以上的二手货来组170HX的平台,后来越看越贵,又想上DDR4的,一算下来又得一千多刀。
昨天翻了下自己的闲置破烂,发现自己还有一台Core Ultra 5 210H 16GB RAM(SSD 512GB)的迷你NUC,一个1000W老电源。脑袋灵光一闪,这不就差一个显卡坞就能把170HX跑起来了么,于是立刻就在亚马逊定了一个TB4 eGPU的显卡坞,挑的最便宜的169刀连雷电4的线都不带,不过我自己有雷电4的硬盘盒带线的。接着我就把NUC装了乌班图的系统为了给170HX解锁64GB显存,还用网线跟我的台式机做了互联,台式机5GB的有线网口连接NUC2.5GB的网口,测试速度降到了2.5GB,实测传输文件速度280+MB。目前台式机可以用RustDesk直接控制NUC,一个显示器,一套键鼠,控制两个终端,测试了一下用我台式机的Hermes+llama.cpp+Qwen3.8-27B-Uncensored-Q6_K直接控制NUC,发现效果还行,比想象的好。
现在我的问题是,过两天矿卡和显卡坞都到了以后,假如说解锁一切顺利,NUC能带着矿卡跑起来了,那么它跑什么大小的模型才是甜点?适合长期待机的模式,因为目前NUC的DDR5内存只有16G,是否有必要加到32G?
按我现在的组合模式,还有什么是需要注意和改进的?求各位大神指点一二!!!感谢!!!
-
@孤帆 你这套组合的思路是对的,但有几个硬边界最好在卡到手之前先知道。先说卡的底子,再说甜点和坑。
一、CMP 170HX 的底子(决定它能干什么)
- GA100 核心(A100 同芯的阉割版),4480 CUDA,250W,无显示输出、无 NVENC/NVDEC。
- 8GB HBM2e、4096-bit、1493 GB/s 带宽。这点最值钱:带宽跟 A100 同档,比任何消费卡都高。也就是说——只要权重装得进显存,它的 decode 速度会很好看。
- 解锁是真事,但别按 64GB 做预算:CMPUnlocker(github.com/amoghmunikote/cmpunlocker)能恢复被固件/OTP 锁掉的 SM 算力和 HBM2e 完整几何(8GB 型号对应 64GB、10GB 型号对应 80GB),但公开反馈里只有 40GB 被确认跑通。按 40GB 规划,64GB 当彩蛋。
- 解锁环境:内核 ≥ 6.6 + 打过补丁的 610.43.03 驱动(文档路径是 Ubuntu 22.04 系 / HiveOS)。你在 NUC 上装 Ubuntu 先
uname -r确认内核够新;解锁完跑一次显存带宽测试确认拿到的是真货,别只看 nvidia-smi 报的数字。
二、TB4 显卡坞是这套的真瓶颈,但不是你可能担心的那个方向
- TB4 隧道 = PCIe 3.0 x4,实际 3 GB/s 量级;卡自己的 HBM 是 1493 GB/s,差 500 倍。
- 推论一:权重必须全额常驻显存,绝对不能做 CPU offload。llama.cpp 的
-ngl拉满,显存不够就退更小的模型或更低的量化,绝不要让它往主机内存溢——溢出去的那部分每 token 都要跨 TB4 走一遍,速度直接掉到个位数。 - 推论二:只要装得下,decode 完全不受 TB4 影响(计算在卡上闭环)。所以「NUC 当常驻推理机 + 台式机 Hermes 走 API 调它」这个架构没问题,2.5GbE 传 token 绰绰有余(280MB/s 对 JSON 是浪费)。唯一代价是加载慢:20GB 的 GGUF 走 3GB/s 大约 1-2 分钟,接受就行。
三、甜点模型(按解锁结果二选一)
- 解锁成功(按 40GB):Qwen3.8-27B Q4/Q5(约 17-20GB)整只进卡 + 长上下文;或者 30B-A3B 一类 MoE Q4(约 18GB)配 100K+ 上下文。这就是这台机的甜点区,别去碰 70B。
- 解锁失败(8GB):7-9B Q4/Q5(5-6GB),留 2GB 给 KV,16-32K 上下文很稳。8B 级别在 1493 GB/s 上会跑得非常快,正好匹配「24 小时待命小助手」这个定位。
- 一个提醒:GA100 没有 FP8,只有 FP16/BF16/INT8 tensor。量化走 Q4/Q5 GGUF 就行,别指望 MXFP4 那套 RDNA 玩法。
四、16G 内存要不要加到 32G
加,但不是为了速度。模型在显存里,系统内存只装 OS + runtime + KV,16G 勉强够;但 Ubuntu + Docker + 页面缓存 + 模型加载(mmap)在 16G 上容易换页,加到 32G 是最便宜的保险。顺便看一眼现在是不是单条 16G(单通道)——能用两条 16G 就别单条,CPU 侧(tokenize、采样)和以后跑容器都有区别。五、几个会踩的坑,按概率排序
- 供电:250W 的卡 + 169 刀的坞。便宜坞的常见问题是只给显卡 100-150W 或干脆没有 8pin——确认卡是从你那台 1000W 电源直接取电(坞上要有 PCIe 供电口),别靠坞自供。
- 散热:CMP 是按矿机风道设计的,很多二手是裸板或缺风扇。250W 24/7 必须有风道/风扇,机箱进风 ≤25℃,否则它会自己降频,你测出来的速度会莫名其妙地低。
- 接入:BIOS 开 Above 4G Decoding(能开 Resizable BAR 就开);eGPU 首次接入要在 Linux 里授权(boltctl / 安全等级),否则 lspci 看得到却用不了。
- 稳定性:eGPU 掉链路会让 CUDA 直接报错。跑常驻服务建议开 nvidia-persistenced、关 runtime PM、别让主机休眠。
- 核显别浪费:210H 的核显可以用 Vulkan 跑小模型当第二条通道,需要轻活的时候不用占这张卡。
-