
-
4080S 32G 用 SGLang 跑 Qwen3.8-27B AWQ-INT4:双路 128K + 三级 HiCache,从"满屏乱码"到跑通的完整踩坑记录
上一篇写的是 llama.cpp + Q6_K 的成绩(单路 80-95 t/s、双路 128K + 视觉)。这次换 SGLang 引擎,目标是论坛大神帖子里那套 HiCache 三级 KV 缓存 + 双路 128K。
结果一晚上下来,坑比上次多得多,而且最大的坑不在 SGLang,在网上下载的那个 AWQ 权重包本身——它的 config 和权重文件自相矛盾,SGLang 和 HuggingFace transformers 加载出来都是满屏乱码。这篇把根因、修法、实测数据全部放出来,照着抄能省你一整晚。
1. 整机配置
- CPU:AMD Ryzen 7 9700X(8核16线程)
- 内存:64GB DDR5
- 显卡:NVIDIA RTX 4080 SUPER 32GB(32760 MiB)
- 系统:Ubuntu(SGLang 这套)/Windows 11(上一篇 llama.cpp 那套)
- 引擎:SGLang 0.5.17 + torch 2.11.0 + sglang-kernel 0.4.5
- 模型:
hotdogs/Qwen3.8-27B-abliterated-AWQ-INT4(16.5 GB,每 token KV 32 KB)
2. 先给结论
项目 结果 原始 AWQ 权重包能直接用吗  不能,config 与权重文件自相矛盾,SGLang 和 HF 都输出乱码
修好之后能不能用  能,输出正常(
The capital of France is Paris.)双路 128K 并发 跑通,2×123K token 并发,峰值显存 31114 / 32760 MiBHiCache L1(GPU KV) 生效HiCache L2(主机内存 12GB) 生效,17.9K 前缀 10.2s → 1.25sHiCache L3(磁盘)  ️ 只写不读,能落盘但 0.5.17 在混合模型上从不触发预取
MTP 投机解码 这个 checkpoint 没有 MTP 权重,方案里的 MTP 项做不了pp512(prefill) 1737 tok/s 单路 decode 41.4 tok/s(不投机)/47-75 tok/s(开 NGRAM) 双路 decode 聚合 74.8 tok/s 一句话:SGLang 这套 prefill 强、前缀复用强、并发强,但 decode 打不过 llama.cpp 的 MTP;想追平要么开 NGRAM,要么换带 MTP 的权重。
3. 最大的坑:AWQ 权重包的 config 和权重文件对不上
3.1 现象
服务器起来了,健康检查 200,但不管问什么都输出乱码:
The capital of France is  →  " is is is is is is is is is is is is is is"
中文提问                  →  "!!!!!!!!!!!!!!!!!!!!!!!!!!!!"
换温度、换 KV 精度、换层数截断、
--load-format dummy(随机权重)都试了:随机权重反而能输出正常 token,真权重反而是乱码 —— 说明模型结构没问题,问题出在"权重没加载对"。3.2 怎么定位到根因
先看
config.json里声明哪些层不量化:"ignore": [ "model.language_model.layers.0.linear_attn", "model.language_model.layers.0.linear_attn.norm", ... ]再去 safetensors 里数真实张量名:
model.layers.0.linear_attn.in_proj_qkv.weight_packed   # ← 真实名字,没有 language_model
model.layers.0.linear_attn.in_proj_qkv.weight_scale
对不上。 这个包的架构声明是
Qwen3_5ForCausalLM(纯文本),根本没有model.language_model.这一层(那是多模态Qwen3_5ForConditionalGeneration的命名)。所以那 97 条 ignore 一条都没生效。更坑的是第二点:文件里 linear_attn 其实被量化了。逐层验证:
48 个 GDN 层全部是 weight_packed(int32) + weight_scale
linear_attn 层里有 bf16 .weight 的:0 个
也就是 README 里写的"linear_attn 保持 BF16"是假的,实际全被量化了(文件 16.44 GiB 也能印证,真要是 bf16 会多出 8GB)。
3.3 于是两条加载路径都是死路
走法 结果 ignore 生效(把 GDN 当未量化) 文件里没有 bf16 权重 → 加载器找不到 → 随机/空权重 → 乱码 ignore 不生效(把 GDN 当量化) 撞上 Marlin 的 size_n % 64 == 0:GDN 融合后的in_proj_ba是[48,48]=96→ 直接崩第二种就是上游 issue #19406 那个报错。用 HF transformers 加载也是乱码(报
in_proj_qkv.weight MISSING / weight_packed UNEXPECTED),同一个根因,所以这真不是引擎的锅。顺便排除掉的怀疑对象:
- int4 的码字和 scale 数据本身是自洽的(每组 code 饱和在 ±7,
max|code-8|/scale ≈ 7)→ 权重没坏,坏的只是 config A_log的 float32 补丁、GDN stride 修复(commit 8ba9646)在 0.5.17 里已经存在- KV dtype fp8/auto、
--page-size、fused/legacy 的 GDN 拆分路径,全都试过,都不是原因
3.4 修法(关键:只反量化两个小矩阵)
对照官方
RedHatAI/Qwen3.8-27B-INT4的 config 就能看出差别:它把in_proj_a/in_proj_b也放进了 ignore。因为这两个投影输出维度只有 48,过不了 Marlin 的 64 整除要求。所以修法是:把 48 层的
in_proj_a/in_proj_b离线反量化成 bf16,其余量化权重按字节原样搬运。# 每个 GDN 层只有两个 [48, 5120] 的小矩阵,96 个张量一共才 47 MB def dequant8(pk, sc): # pk: int32,每个 int32 装 8 个 int4 x = pk.to(torch.int64) codes = torch.stack([(x >> (4 * i)) & 0xF for i in range(8)], dim=2).flatten(1) g = codes.shape[1] // sc.shape[1] return ((codes - 8).float() * sc.float().repeat_interleave(g, dim=1)).to(torch.bfloat16)然后把
ignore改成和真实张量名一致:lm_head model.layers.{N}.linear_attn.in_proj_a model.layers.{N}.linear_attn.in_proj_bSGLang 内部有一张
packed_modules_mapping:in_proj_ba → [in_proj_b, in_proj_a],所以只要把两个分片都标成忽略,融合后的in_proj_ba会自动走未量化路径;而in_proj_qkvz(2048/2048/6144/6144,每个都能被 64 整除)继续走 int4 Marlin。显存只多 47 MB,其他什么都不用改。 改完立刻正常:
greedy:  " Paris.\nThe capital of Germany is Berlin.\nThe capital of Italy is Rome..."
chat  :  "法国的首都是巴黎。"
额外提醒:网上有个 PR(#22618)给 Qwen3.5 加了个"ignore 里有 linear_attn 就把整个 GDN 设成未量化"的 guard。如果你的权重是这种"声明忽略但实际量化"的包,千万别打那个补丁 —— 它会把整个 GDN 变未量化,反而让你连权重都加载不上。
4. HiCache 三级缓存实测
启动基线:
--enable-hierarchical-cache --hicache-size 12 --hicache-write-policy write_through --page-size 1L1(GPU KV 池)
重复前缀直接命中显存:
cached_tokens_details {'device': 43008, 'host': 0, 'storage': 0},缓存命中率 0.96。L2(主机内存)
读取已验证把 L1 压小(
--max-total-tokens 32768),发 3 个互不重复的 17.9K 前缀,再重放第 1 个:请求 prompt cached 命中来源 耗时 ALPHA 冷 17935 0 — 10.208s BETA 冷 17936 0 — 10.220s GAMMA 冷 17936 0 — 10.224s ALPHA 重放 17935 16384 host 1.252s sglang:cached_tokens_total{cache_source="host"} 16384 sglang:evicted_tokens_total{cache_type="UnifiedRadixCache"} 39531冷 10.2s → 暖 1.25s,8 倍。 L2 主机内存层是真的在工作。
L3(磁盘)
️ 只写不读落盘完全正常:
sglang:backuped_tokens_total{storage_backend="file"} 104056 /mnt/sda6/hicache_l3 24G / 211010 个 .bin但读取从来没被触发。用 6 个互不重复的前缀(共 107K token)把 L1(32768)和 L2(60855)全部撑爆,L3 里确实有 ALPHA 的数据,再请求 ALPHA:
[ALPHA-again] prompt=17935 cached=0 device=None host=None storage=None e2e=10.233s ← 全量重算metrics 里连
prefetched_tokens_total的 series 都不存在 —— 根本没有发起过预取。重启进程后再试,一样。结论:0.5.17 在
UnifiedRadixCache(KV+MAMBA 混合池)上不会为 L3 触发预取。 想要真三级缓存得等上游修,相关的 PR 是 #20457(mamba 状态卸载)、#28185(linear-attn 前缀缓存的 int8 checkpoint pool),issue 是 #24121。顺带踩到的三个坑(很重要)
坑 现象 解决 --file-storage-path是空参数全树只有参数声明、没有任何地方使用它,文件偷偷写到 /tmp/hicache必须用环境变量 SGLANG_HICACHE_FILE_BACKEND_STORAGE_DIR=/mnt/sda6/hicache_l3文件后端淘汰器默认惰性 不配置就无限增长(实测涨到 24 GB) 设 SGLANG_HICACHE_FILE_BACKEND_MAX_SIZE=20G、..._MIN_FREE_SPACE=10G--hicache-size是 KV + mamba 总量给 12 时 KV host 只有 2-6 GB,剩下 5.7-10 GB 全给 mamba 状态了 看清楚分配日志再调 /flush_cache返回 400没法用它做隔离测试 用重启进程代替 5. 双路 128K 跑通:关键参数是 max-mamba-cache-size
这是本篇最值钱的一条。
GDN(Gated DeltaNet)的状态缓存默认要 34 个槽位 = ssm_state 4.92 GB。但双路并发只需要 2 路:
配置 max_mamba_cache_size ssm_state KV 池 tokens 默认 34 4.92 GB 183838(mf 0.88) 优化 6 0.98 GB 356237(mf 0.92) 白捡 4GB 显存,KV 池直接从 18 万 token 干到 35 万 token。实测双路 128K:
max_total_num_tokens=356237   max_running_requests=2   context_len=131072
[dual-A] prompt=123215  e2e=206.0s
[dual-B] prompt=123216  e2e=206.1s     ← 真并发,KV 使用率 0.69 / mamba 0.67
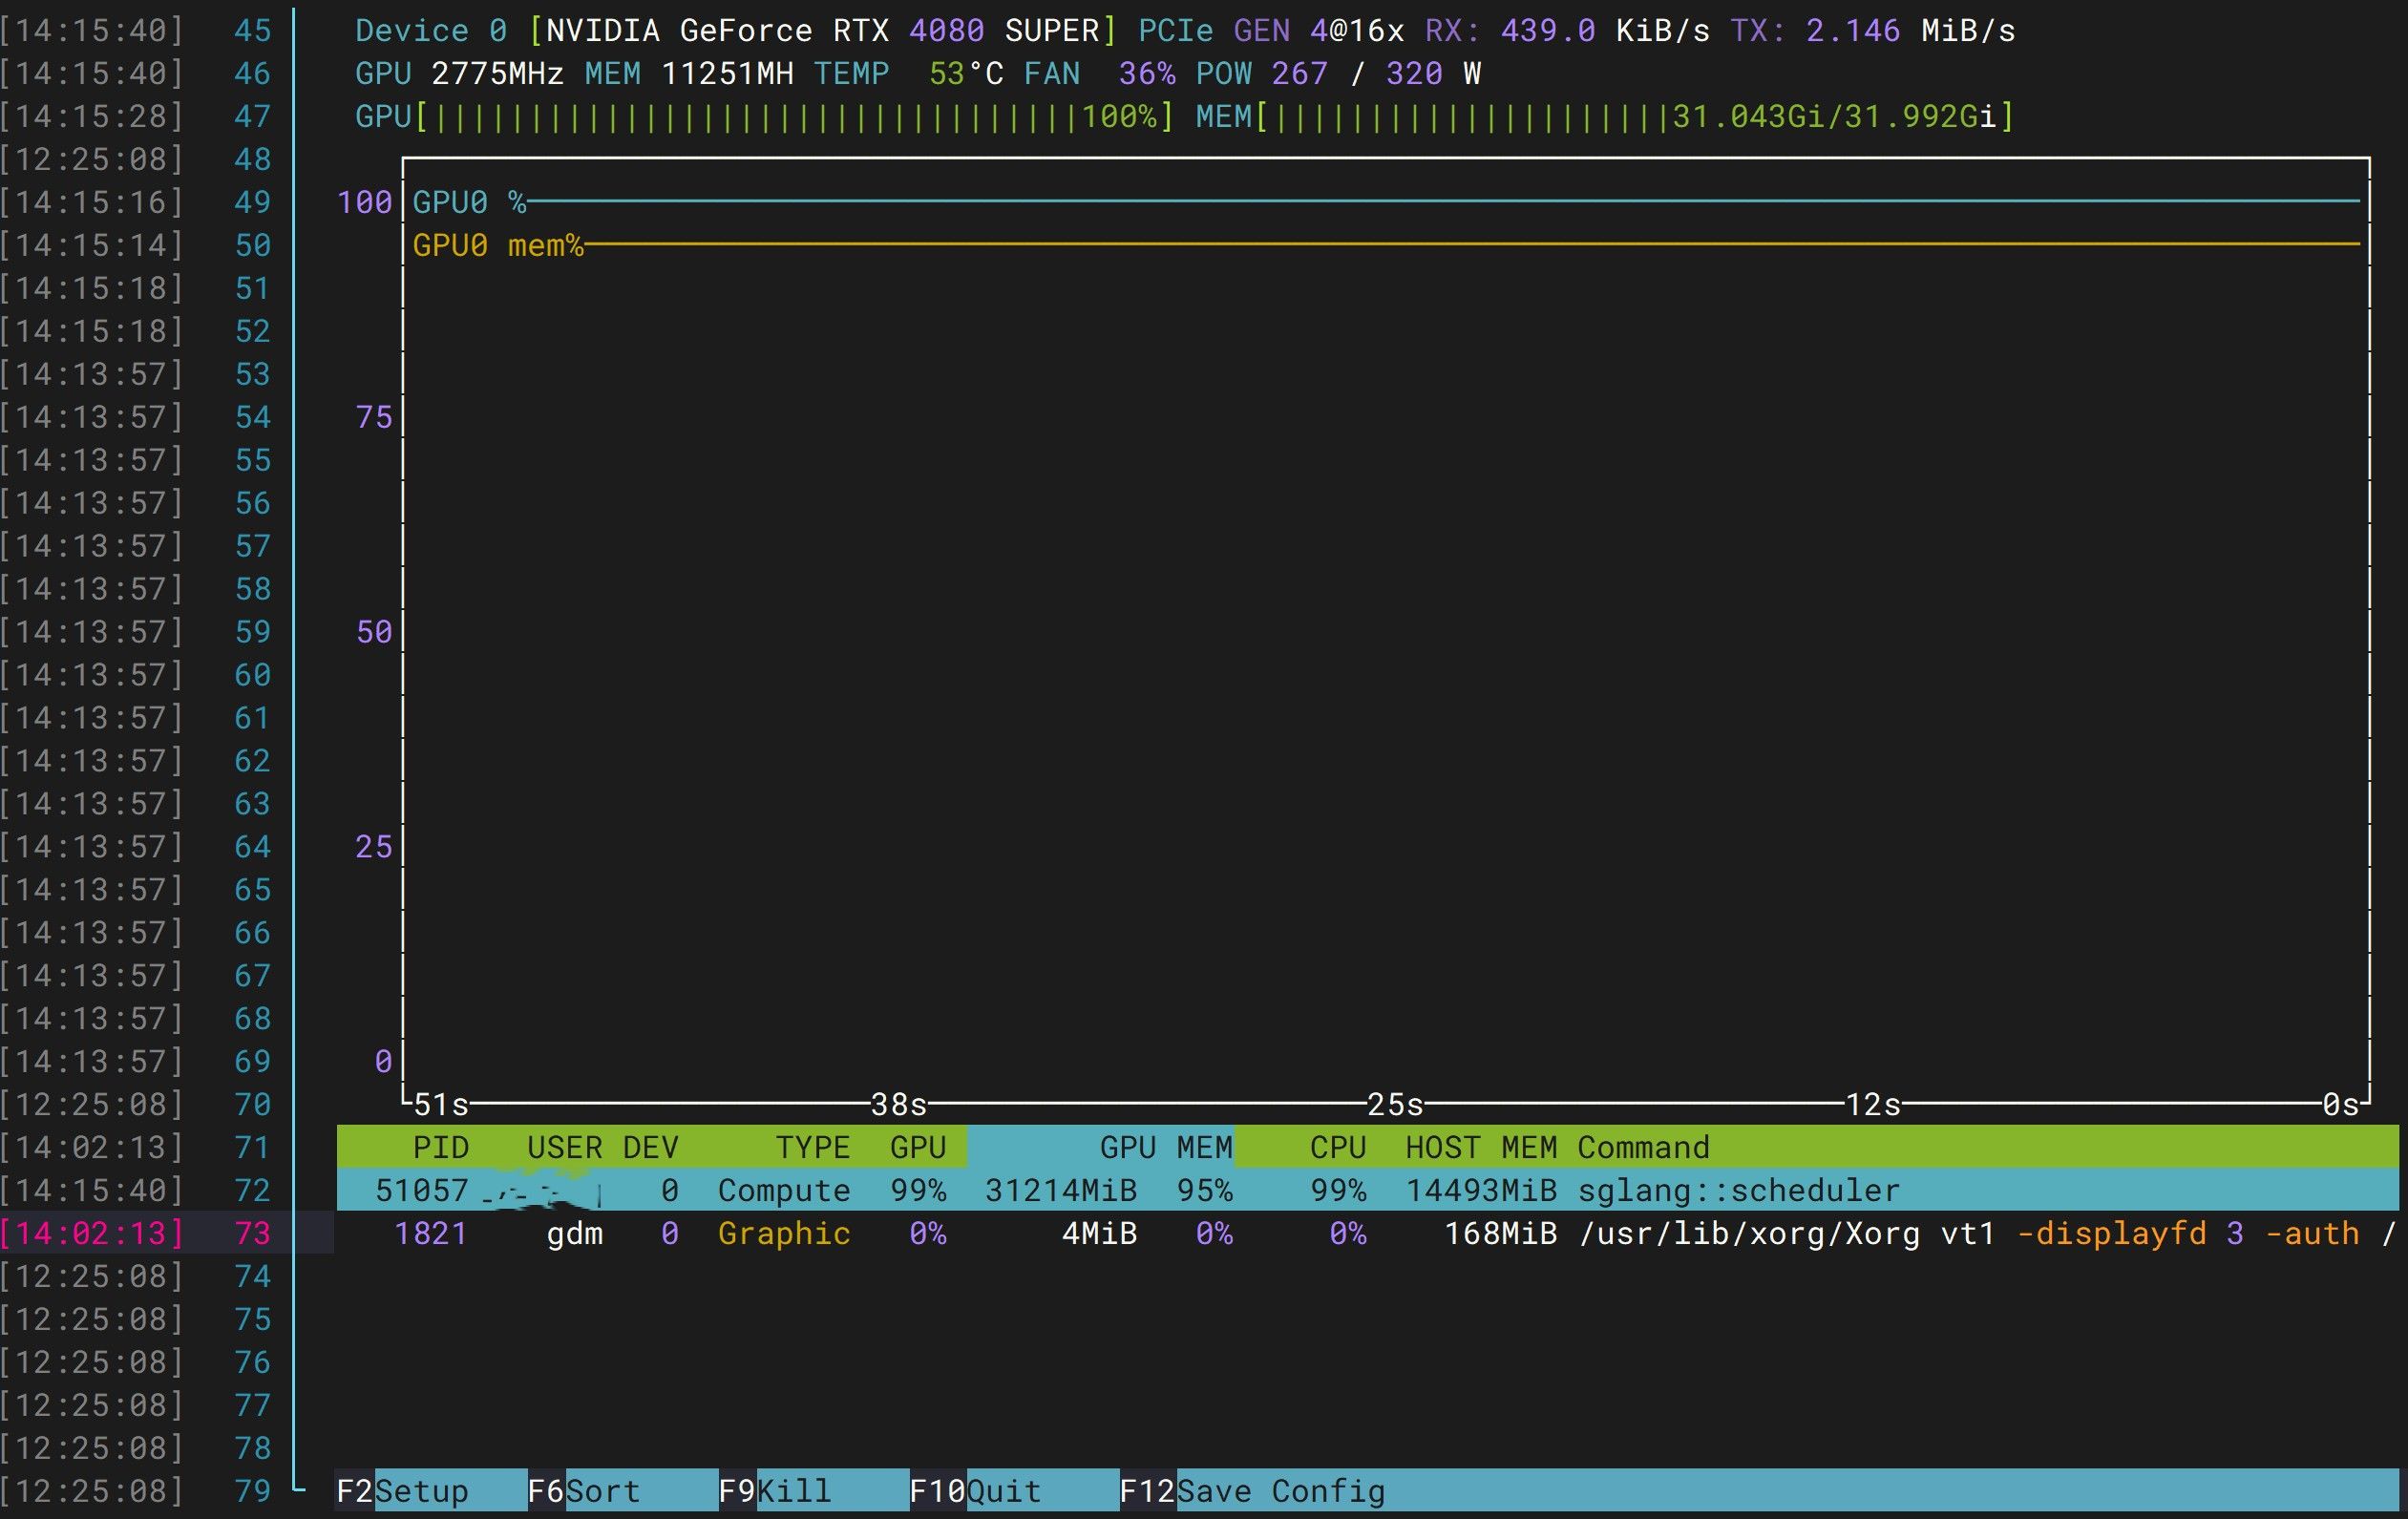
峰值显存 31114 / 32760 MiB,无 OOM、无 retraction、无 abort
6. 速度基准(和上一篇的 llama.cpp 对照)
6.1 SGLang 本机实测
指标 数值 pp512 1736.8 tok/s pp8.5k 1884.0 tok/s pp34k 1684.3 tok/s pp68k 1459.8 tok/s 单路 decode(短上下文 128 token) 41.4 tok/s(TTFT 285 ms) 单路 decode @64K 上下文 37.0 tok/s 双路同时 decode 36.7 + 38.1 = 74.8 tok/s 聚合 双路 2×120K prompt 并发 聚合 prefill 2252 tok/s,墙钟 107.0 s 峰值显存 31.1-31.3 GB / 32 GB HiCache 开关对照(其余参数完全一致):
指标 HiCache 开 HiCache 关 差异 pp512 1736.8 1849.1 −6.1% pp68k 1459.8 1466.7 −0.5% 单路 decode 41.4 41.4 0% 双路 2×120K 墙钟 107.0 s 160.6 s 快 33% write_through 的 GPU→主机 DMA 开销基本可以忽略(短上下文 −6%,长上下文 −0.5%,decode 无影响),而双路 12 万 token 时反而因为 mamba 状态能卸到主机内存、不用重算,快了三分之一。
6.2 NGRAM 投机解码(不需要 MTP 权重)
这个 checkpoint 没有 MTP,但 SGLang 的 NGRAM 投机不需要任何额外权重,白嫖:
负载 无投机 NGRAM 提升 接受率 代码生成 41.4 tok/s 56.1 tok/s +35% 0.110 抽取原文(回声型) 40.5 tok/s 75.1 tok/s +85% 0.231 中文散文创作 41.5 tok/s 47.2 tok/s +14% 0.062 参数:
--speculative-algorithm NGRAM --speculative-num-steps 5 --speculative-num-draft-tokens 6
代价:KV 池 356237 → 271673 token,mixed chunked prefill被自动禁用,启动慢 50s。6.3 和上一篇 llama.cpp(Q6_K + draft-mtp)的对照
负载 llama.cpp Q6_K +MTP SGLang INT4 不投机 SGLang INT4 +NGRAM 工具调用 decode 81.8 t/s(n-max3) 41.4 — 代码生成 80.9 41.4 56.1 中文创作 52.9 41.5 47.2 双路聚合 95-160 74.8 预估 100-135 prefill(pp) 上次没测 1737-1910 同 显存 28.4 GB(含视觉) 31.1 GB(无视觉) 同 结论:
- decode 的差距几乎全是 MTP 造成的,不是引擎差距。 llama.cpp 的 80-95 t/s 是"Q6_K + 训练过的 MTP draft head",我们这边是"INT4 + 完全不投机"。而且注意 INT4 权重只有 17.7 GB(Q6_K 是 20.9 GB),带宽上 SGLang 这套是占便宜的 —— llama.cpp 如果关掉 MTP,单路大概率只有 30-35 t/s,还不如我们的 41.4。
- prefill 是 SGLang 的大优势:1.7-1.9k tok/s,68K 长上下文只掉 15%。长文档首答和 HiCache 冷启动都靠这个。
- 前缀复用 SGLang 强:HiCache L2 跨请求共享,命中秒级;llama.cpp 的 prompt cache 是 per-slot 的,
--parallel 2两个槽各存一份。 - llama.cpp 赢在显存余量和视觉:28.4 GB 还能带视觉双路 128K;我们 31.1 GB 无视觉、只剩 1 GB。
- 精度取舍:Q6_K 比 AWQ INT4 更保险(我们这里连 GDN 的
in_proj_qkvz/out_proj都是 int4)。
7. 最终启动脚本
export SGLANG_HICACHE_FILE_BACKEND_STORAGE_DIR=/mnt/sda6/hicache_l3   # 只有开 L3 才需要
export SGLANG_HICACHE_FILE_BACKEND_MAX_SIZE=20G
export SGLANG_HICACHE_FILE_BACKEND_MIN_FREE_SPACE=10G

python -m sglang.launch_server \
  --model-path /mnt/sda6/download/qwen38-awq-fixed \
  --served-model-name qwen38 \
  --host 0.0.0.0 --port 8001 \
  --context-length 131072 \
  --max-running-requests 2 \
  --mem-fraction-static 0.92 \
  --kv-cache-dtype fp8_e4m3 \
  --page-size 1 \
  --max-mamba-cache-size 6 \
  --enable-hierarchical-cache \
  --hicache-size 12 \
  --hicache-write-policy write_through \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --trust-remote-code
想要再快就加投机(二选一):
# 方案A:不用换权重,白嫖 NGRAM
  --speculative-algorithm NGRAM \
  --speculative-num-steps 5 \
  --speculative-num-draft-tokens 6

# 方案B:换成带 MTP 的权重(如 RedHatAI/Qwen3.8-27B-INT4)
  --speculative-algorithm NEXTN \
  --speculative-eagle-topk 1 \
  --speculative-num-steps 5 \
  --speculative-num-draft-tokens 6
8. 给同是小白的提醒
- 先验证权重包本身。加载出来乱码,第一步就去比对
config.json的ignore和 safetensors 里的真实键名,别急着怀疑引擎。kv 相关的报错(Marlin size_n)和乱码往往是同一个根因的两副面孔。 --page-size必须是 1,混合 mamba 模型 + HiCache 用别的值会 segfault,这条大神帖子里就写了,是真的。--max-mamba-cache-size是双路 128K 的钥匙,默认 34 白扔 4GB。- HiCache 的 L3 目前对混合模型只写不读,别指望它;L2(主机内存)才是真正省钱的那层,
--hicache-size给 12 就够。 --file-storage-path在 0.5.17 里不生效,必须用环境变量,否则你会像我一样盯着空目录怀疑人生。- A_log 要用 float32、GDN stride 修复这些在 0.5.17 里已经内置了,不用自己打补丁;但别乱打那个 #22618 的 linear_attn guard。
- 投机参数要自己扫(和上次扫 n-max 一样),
num-steps/num-draft-tokens的甜点位因任务而异。
9. 还没解决的
- L3 磁盘层只写不读:0.5.17 的混合模型限制,等上游修。
- 这个 checkpoint 没有 MTP:想要 MTP 得换权重(代价是不再是 abliterated 版)。
- 显存只剩 1 GB:双路 128K 是这卡的极限,正式长跑建议用 96K(
mem-fraction 0.90)。 - 量化精度:AWQ INT4 + GDN 部分层量化,质量比 Q6_K 略逊,追求质量还是建议 Q6_K。
感谢论坛大神的 HiCache 帖子,也感谢上一篇里各位指路的回复。这次把一个坏权重包拆开修好、把三层缓存一层层验明白,算是把 SGLang 这条路走通了 —— 剩下的就是等上游把 L3 补上。
-
感谢分享,这篇把「量化包的 config 和权重对不上」这种最坑的类讲清楚了,排查方法也值得推广。
你用的那条反证法很关键:--load-format dummy 拿随机权重反而能吐正常 token → 说明模型结构和引擎都没问题,是权重没加载对。这比换温度、换 KV 精度、换引擎有指向性得多。可以再固化一条核验手段:直接读 safetensors header(前 8 字节长度 + JSON),把所有 *.weight_packed 的张量名列出来,跟 config 里 quantization_config.ignore 取交集——你在 3.2 手工做的那件事,现在一条命令就能跑完,以后拿到任何第三方量化包都先验一遍。
修法也对得上:Marlin 的 size_n % 64 整除限制,就是 in_proj_a / in_proj_b 这种 48 维小投影过不去的原因,离线反量化这两个小矩阵(96 个张量 47MB,显存几乎无感)是最小改动。PR #22618 那个 guard 的提醒很重要——「ignore 里声明了但实际被量化」的包要是顺手打上那个补丁,会把整个 GDN 变未量化,反而连权重都加载不上。
关于你的 decode 数据,补一个解读:AWQ-INT4 是 16.5 GB,4080S 显存带宽 736 GB/s,纯 decode 的带宽上限就是 736/16.5 ≈ 44 tok/s。你的 41.4 已经到 93%,也就是 SGLang 这边基本摸到硬件墙了,不是引擎弱。llama.cpp 那 80-95 t/s 里的大头是 MTP 投机带来的,换引擎就没了;你要追平,方向就是你现在在看的两条:开 NGRAM(47-75 已经印证),或者换带 MTP 权重的 checkpoint。pp512 1737 tok/s、L1 命中率 0.96、双路 128K 峰值 31.1/32.7 GB 只留 1.6G 余量还不 OOM,这组数据很干净。
HiCache L3 那块不用为它花时间:收益来源是 L1+L2,L3 只在冷启动、跨会话复用这类场景才有价值,混合(linear attention)模型的预取路径本来就和纯 attention 不一样,0.5.17 上不触发不影响你现在这套用法。你要说服人,拿 L2 那组实测(17.9K 前缀 10.2s → 1.25s)就够了。
-
,
 T terry 固定了此主题
-
,T terry 将此主题从 LLM讨论区 移至此处
-
非常好的帖子,你把上个帖子链接发进来,方便大家查找。我帮你贴下,以后自己的帖子注意维护。
https://lcz.me/topic/1614
两个帖子质量都很好。 -
,E Enigma 引用了 此主题
-
非常好的帖子,你把上个帖子链接发进来,方便大家查找。我帮你贴下,以后自己的帖子注意维护。
https://lcz.me/topic/1614
两个帖子质量都很好。好的,谢谢
-
,系统 取消固定了此主题
-
@Enigma HiCahce跑通,FP8KV久没有那么急迫了,还是可以研究下,我看你其他帖子似乎是有BUG?Decode其实不重要,我之前都是20多tokens,不妨碍工作,重要的就是对会话prefill,显存要够。还有DFlash如果还不饿Hicache能同时跑通,最好,或者和FP8KV。
-
,
B Ben Lee 引用了 此主题
