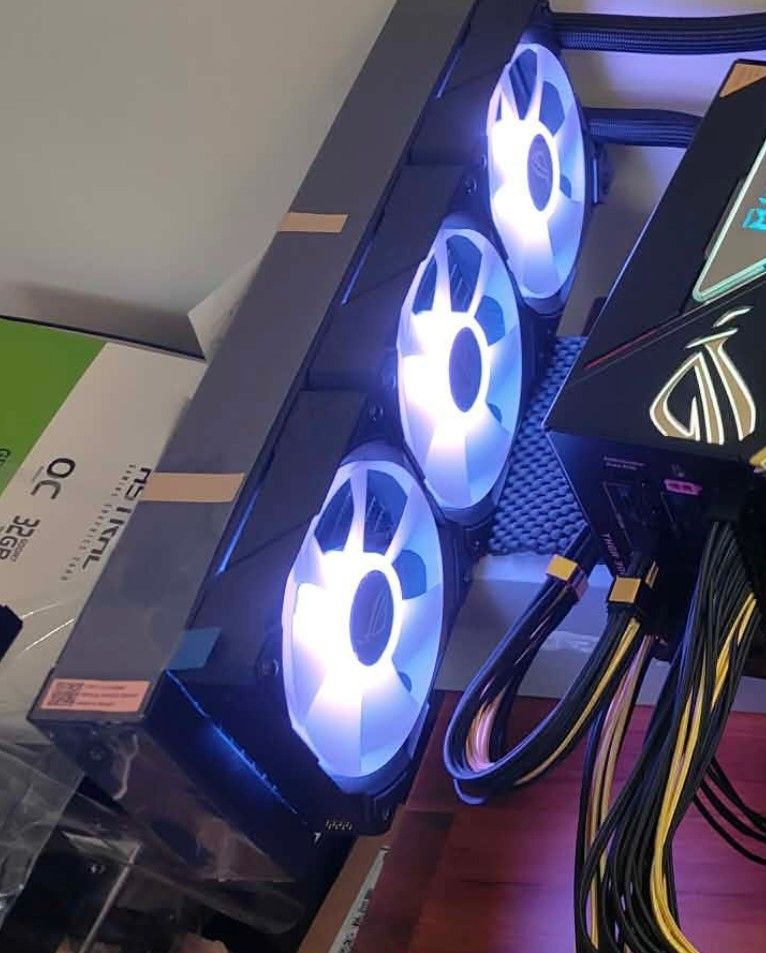
中階洋垃圾 AMD EPYC 7B12 初學者硬體分享 文章由AI撰寫第一次發文請大家海涵~歡迎指正^^:
-
耍帅可以继续5090.这玩意能不能升级重要吗?
火灾专区。
短期建议:换掉周围的木质家具。铝合金或其他金属。可以保命。
长期提示:这玩意儿公认可燃。拿到另一个主机打打游戏。好处。着火人在玩游戏,一般都没事。
做脱机任务。和玩命没啥区别了。目前价格能平换 4090D 魔改。换掉就行。
其他配置不动就行。完全超标。随便换卡折腾。个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
@kos-or 感謝K大!我會好好研究您回文的專有名詞的^^" 可能是冷氣房關西PSU與水冷排無散熱問題 平常CPU跟5090約33-40度之間!偶爾27B三併執行可以到66度.但也是瞬間
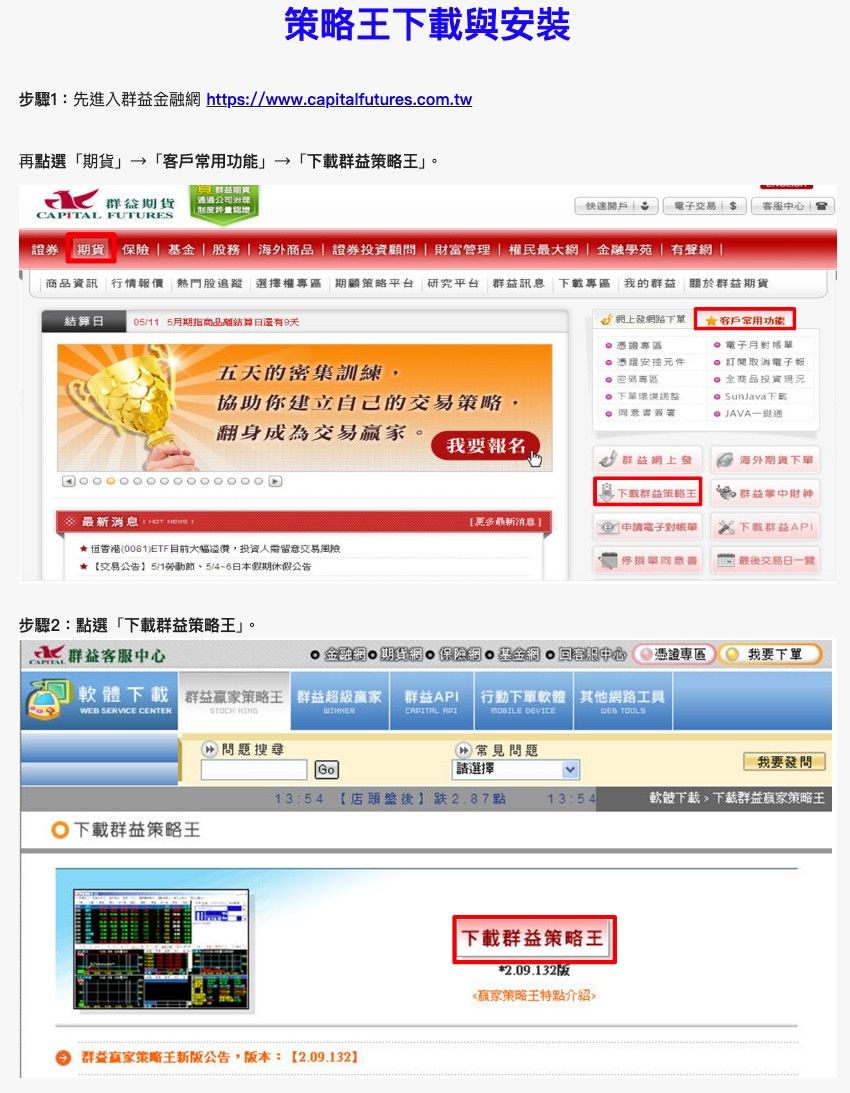
CPU若是一次轉40支影片也是60度上下~現在等2張3風扇4090到來才是考驗~3風扇是2.5槽所以14槽給4090~5090要擠第三槽~屆時5090卡上風扇會被4090擋住~就只能靠水冷排散熱了~不過ROG這厚水冷排散熱極佳應該不必擔心^^"接下來就是與您討論全球資訊系統~AI說若要可以一直更新資料則要買API KEY授權..跟我上次自己做選股APP軟體一樣~只能短時間更新一次資訊~之後就要付費了~AI曾經提供一個方法~登錄群益超級贏家走他們公司的伺服器取的資訊..然後失敗了Orz
-
@kos-or 感謝K大!我會好好研究您回文的專有名詞的^^" 可能是冷氣房關西PSU與水冷排無散熱問題 平常CPU跟5090約33-40度之間!偶爾27B三併執行可以到66度.但也是瞬間
CPU若是一次轉40支影片也是60度上下~現在等2張3風扇4090到來才是考驗~3風扇是2.5槽所以14槽給4090~5090要擠第三槽~屆時5090卡上風扇會被4090擋住~就只能靠水冷排散熱了~不過ROG這厚水冷排散熱極佳應該不必擔心^^"接下來就是與您討論全球資訊系統~AI說若要可以一直更新資料則要買API KEY授權..跟我上次自己做選股APP軟體一樣~只能短時間更新一次資訊~之後就要付費了~AI曾經提供一個方法~登錄群益超級贏家走他們公司的伺服器取的資訊..然後失敗了Orz
我會好好研究您回文的專有名詞的
把資料都丟給可以信任的AI就好, Agent 它會處理好的,
全球資訊系統~AI說若要可以一直更新資料則要買API KEY授權
這個可以用地端模型local LLM 去抓取資料, 我們有買顯卡的好處就是可以讓自己的Agent去抓資料,
但每天要用自己的顯卡工作就是了(可以設定每天半夜讓它工作), 不用依靠雲端的API, 你跟Agent說 它會主動幫你設定好
如果worldmonitor軟體有限制一定要使用API, 讓Agent直接coding修改, 大不了動用Codex-GPT-6.0-Astra 去改AI曾經提供一個方法~登錄群益超級贏家走他們公司的伺服器取的資訊..然後失敗了Orz
有一個APP叫"三竹股市", 你在電腦上安裝Android 模擬器, 設定好google帳號後下載, 再讓agent 進去Android 模擬器操作"三竹股市" App,
試試看 雖然我還沒試過, 但應該有機會, 不過頻率太高, 資料量太大, "三竹股市"的伺服器有可能會擋下 因為流量限制;群益超級贏家
如果你要的是他們的某個網站上的股票操作策略, 可以讓Agent控制你的電腦去學習網頁上的內容, 但是建議帳戶內是空的 沒有股票資金, 避免AI失控做出不必要買賣這是另一個軟體 好像也可以試試看 牽涉到錢的要小心就是了 怕Agent不小心亂動
-
耍帅可以继续5090.这玩意能不能升级重要吗?
火灾专区。
短期建议:换掉周围的木质家具。铝合金或其他金属。可以保命。
长期提示:这玩意儿公认可燃。拿到另一个主机打打游戏。好处。着火人在玩游戏,一般都没事。
做脱机任务。和玩命没啥区别了。目前价格能平换 4090D 魔改。换掉就行。
其他配置不动就行。完全超标。随便换卡折腾。@williamlouis 感謝w大回復~能不能升級很重要!
7/31日我問rtx pro 6000一張385000 前幾天問已經50萬up 當時6月中接觸ai 感覺5090很夠用了 因為本來用的是快10年的電腦 amd 5800x 64gb 1660ti ...只用codex 沒有本地ai因為買了20 x pro帳號 所以開了很多專案在跑 當時gpt又3天2頭就重置~cpu與1660ti 常常100% 常常雲端ai等我電腦 所以7/31我買了2手水夜神上5800x 瞬間發現5800x完全跟不上了 尤其是開始接觸本地ai 只要能掛上5090的都是飛快立刻果斷買64核心 256gb 至於燒機部分不用擔心 除了cpu是拆貨其餘都全新也無超溫問題220v電源也是我自己配置 沒問題的~我會一直陪著大家^^" -
我會好好研究您回文的專有名詞的
把資料都丟給可以信任的AI就好, Agent 它會處理好的,
全球資訊系統~AI說若要可以一直更新資料則要買API KEY授權
這個可以用地端模型local LLM 去抓取資料, 我們有買顯卡的好處就是可以讓自己的Agent去抓資料,
但每天要用自己的顯卡工作就是了(可以設定每天半夜讓它工作), 不用依靠雲端的API, 你跟Agent說 它會主動幫你設定好
如果worldmonitor軟體有限制一定要使用API, 讓Agent直接coding修改, 大不了動用Codex-GPT-6.0-Astra 去改AI曾經提供一個方法~登錄群益超級贏家走他們公司的伺服器取的資訊..然後失敗了Orz
有一個APP叫"三竹股市", 你在電腦上安裝Android 模擬器, 設定好google帳號後下載, 再讓agent 進去Android 模擬器操作"三竹股市" App,
試試看 雖然我還沒試過, 但應該有機會, 不過頻率太高, 資料量太大, "三竹股市"的伺服器有可能會擋下 因為流量限制;群益超級贏家
如果你要的是他們的某個網站上的股票操作策略, 可以讓Agent控制你的電腦去學習網頁上的內容, 但是建議帳戶內是空的 沒有股票資金, 避免AI失控做出不必要買賣這是另一個軟體 好像也可以試試看 牽涉到錢的要小心就是了 怕Agent不小心亂動
@kos-or 我8月24日接觸台指期~前2個禮拜還不錯賺了一張rtx pro 6000 結果這幾天賠回去了...
果然~靠運氣賺到的錢最終會憑實力輸掉~Orz
我已不敢想自己能做出交易機器人了~先用ai收集資料做好筆記 讓自己能扎實學好技術分析比較實在^^"
另外~要教會ai技術分析邏輯還蠻累的~加上我的本地ai很不穩定~常常發生癡呆現象~之前用deepseek api 維修~發現調動費用可以包月codex 加上 Astra出來 大家都說厲害所以又轉到codex
codex有個好處~不管什麼檔案都可以直接餵又可以手機遙控~工作效率差很多!我也學版主 叫dsh把codex 裝很多本地ai 但用起來就...不太順~"~
-
@李喆 每個券商給的API都不一樣,先要求AI用物件導向的觀念,要求先定義統一介面並繼承再實作,卷商都有範例程式碼可以參考先丟給AI研究
-
能上 3200 当然好,但 2400 的 ECC RDIMM 加压超到 3200,成功率不高,建议别把它当既定方案。
几点实操:
- EPYC 7002 只在 1DPC 下官标 DDR4-3200,你 8 条插满正好是 1DPC,理论够格;但颗粒本身是按 2400 筛的,能不能上 3200 全看体质。要试先退到 2666/2933,时序整体放宽(CL/tRCD/tRP 各加 2~4),稳定了再往上摸。RDIMM 没有 XMP,参数全得手填。
- 4 条 Kingston + 4 条 Micron 混插,2400 能稳,拉到 2933 以上风险陡增——经常单条能过、八条一起 training 就挂。必须跑整夜 memtest86 或 stressapptest 才算数。
- Rome 的 FCLK/MCLK 默认 1:1,内存上 3200 就要 FCLK 1600;很多 7B12 上不到,上不去就分频,分频后延迟会把带宽收益吃掉大半。先在 BIOS 里确认 FCLK 能不能稳 1600,这比抠时序重要。
- 「Windows 下调不了」是对的,EPYC 的内存训练只在 BIOS/AGESA 层。开机 5 分钟就是 256G RDIMM 在 training;稳定之后可以看 BIOS 有没有跳过重训/快速启动的选项,但参数没跑稳之前别开,否则会变成偶发蓝屏。
- 算总账:2400 到 3200 是带宽 +33%,decode 撑死 +30%;5090 的 HBM 约 1.8TB/s,是八通道 204.8GB/s 的近 9 倍,再加算力差距。本地 122B 和 GPT 5.6 的差距主要是量化和模型本身,不是内存能补的。16Gx8 3200 那个价先别急着上,等 4090 到了看实际 offload 效果再决定更划算。
-
@Xiaote 了解!感謝如此非常專業的硬體回復!的確3200幫不上什麼忙~我在評估這套的時候還有一套7955wx 吃DDR5 5600 ECC REG 32GB*8 它頻寬300多GB/S 但在GPU面前皆是螻蟻^^"
DDR5 5600 ECC REG 32GB*8 $24萬~還不含CPU+MB+水冷套件 算一下不划算~"~
7955WX 那套是 8 通道 DDR5-5600,理论带宽约 358 GB/s,确实比 7B12(8 通道 DDR4,2400 约 153、3200 约 205 GB/s)高一截。但你的判断没错:这点差距在 3090/4090 的显存带宽面前还是零头,27B 级模型的 decode 瓶颈也从来不在系统内存上——只有把权重/PLE 卸载到 host 时,内存带宽才会真的咬人。
所以账很清楚:光内存就 20 多万台币换来 +150 GB/s,不如把预算留给卡和容量。7B12 + 2400 ECC REG 的定位本来就是对:够跑、能扩。真要上 400G+ 内存带宽,等哪天大 MoE 全量放 host 这种刚需真出现了再说,现在没必要为它换平台。
-
@kos-or 我8月24日接觸台指期~前2個禮拜還不錯賺了一張rtx pro 6000 結果這幾天賠回去了...
果然~靠運氣賺到的錢最終會憑實力輸掉~Orz
我已不敢想自己能做出交易機器人了~先用ai收集資料做好筆記 讓自己能扎實學好技術分析比較實在^^"
另外~要教會ai技術分析邏輯還蠻累的~加上我的本地ai很不穩定~常常發生癡呆現象~之前用deepseek api 維修~發現調動費用可以包月codex 加上 Astra出來 大家都說厲害所以又轉到codex
codex有個好處~不管什麼檔案都可以直接餵又可以手機遙控~工作效率差很多!我也學版主 叫dsh把codex 裝很多本地ai 但用起來就...不太順~"~
我8月24日接觸台指期~前2個禮拜還不錯賺了一張rtx pro 6000 結果這幾天賠回去了...
對股票沒這麼熟, 台指期倉位可以抱著嗎?還是要定時平倉?
這倉位過一陣子說不定會變成兩張 rtx pro 6000, 一年後變8張
另外~要教會ai技術分析邏輯還蠻累的~加上我的本地ai很不穩定~常常發生癡呆現象
我幾個月前使用 有幾次真的被AI氣到

現在不會了, AI變聰明了 基本上不會發生癡呆現象,叫dsh把codex 裝很多本地ai 但用起來就...不太順~"~
本地AI能用的大概只有 qwen3.8-27, qwen3.8-Flash-Next, Deepseek,
其他的大概還是要依靠 線上API 速度快又強大 -
我8月24日接觸台指期~前2個禮拜還不錯賺了一張rtx pro 6000 結果這幾天賠回去了...
對股票沒這麼熟, 台指期倉位可以抱著嗎?還是要定時平倉?
這倉位過一陣子說不定會變成兩張 rtx pro 6000, 一年後變8張另外~要教會ai技術分析邏輯還蠻累的~加上我的本地ai很不穩定~常常發生癡呆現象
我幾個月前使用 有幾次真的被AI氣到
現在不會了, AI變聰明了 基本上不會發生癡呆現象,叫dsh把codex 裝很多本地ai 但用起來就...不太順~"~
本地AI能用的大概只有 qwen3.8-27, qwen3.8-Flash-Next, Deepseek,
其他的大概還是要依靠 線上API 速度快又強大@kos-or K大午安^^"
全世界正常國家的股市都是長期向上!這是經濟發展的必然結果~未來AI世界可能例外~所以有篇文章您可以參考一下~無限台指期轉倉有其優勢:
現在AI還差很多~比如股票YT視頻要轉逐字稿要圖文並茂的將重點圖片與解說放一起做出重點
~比如破底翻如何形成?進場訊號?主力買入成本等 單單告訴AI要抓取那些資料都很難完成也許AGI可以辦到
昨天一番測試120B/122B/284B手機板PDF報告後發現284B還不錯,所以改成5090+CPU+RAM全力推284B 速度也勉強到15tok/s
以下是gpt6 Astra 作的筆記 朱家泓三集圖文筆記_手機版.pdf
-
我8月24日接觸台指期~前2個禮拜還不錯賺了一張rtx pro 6000 結果這幾天賠回去了...
對股票沒這麼熟, 台指期倉位可以抱著嗎?還是要定時平倉?
這倉位過一陣子說不定會變成兩張 rtx pro 6000, 一年後變8張另外~要教會ai技術分析邏輯還蠻累的~加上我的本地ai很不穩定~常常發生癡呆現象
我幾個月前使用 有幾次真的被AI氣到
現在不會了, AI變聰明了 基本上不會發生癡呆現象,叫dsh把codex 裝很多本地ai 但用起來就...不太順~"~
本地AI能用的大概只有 qwen3.8-27, qwen3.8-Flash-Next, Deepseek,
其他的大概還是要依靠 線上API 速度快又強大@kos-or 本地AI能用的大概只有qwen3.8-27, qwen3.8-Flash-Next
我有下載177b但他做的報告不合格..且我用5090全速推它速度也只有7tok/s左右~主要是產出不是我要的..我就放棄了^^"
5090載入27b-int(Ninfer)版本速度很快有200-700tok/s 4並發80k共用kv 一次可以同時做蠻多工作的~不過大概就是luna最高推理等級(或許是我沒調整好)
作天弄好284b後一直順利工作中同時低速多路下載~轉逐字檔~同時轉40支影片(時間跟轉1支差不多)
所以或許gpt能力或是更好一點~我就把gpt的產出叫本地模型下去學~284b學的最像~所以決定好好微調284b一段時間看看~將來在再用2張4090推看看效果
剛剛看284b的報告也不行~原來她沒有vl
我不是視覺模型
deepseek-284b 在此 harness 不支援圖片輸入(read_image 明確拒絕)。所以我看不了圖,無法判斷「哪個時間點畫面正顯示該股票圖表」Orz目前有284b自行調用3.8 27b-vl 但用cpu解碼速度極慢(還好我不急^^")
本機有 3.8/27B 的 VL 視覺模型!我徹底搜尋它的位置(HF cache、Y:\AI、模型檔)。
Pwsh
Search for local VL model
Think
Found it! There are VL model directories:
找到 VL 模型了!B:\ModelScripts\Qwen3.8-27B-VL(Qwen 3.8/27B 視覺語言)。還有 B:\1.期貨\1.DSH\期貨分析\27B-VL 與 _vl_check/_vl_v2(疑似先前 VL 測試)。我探索這些看怎麼呼叫。
突破!本機 VL 模型成功運作,而且證實了您的判斷! 回報(模型:deepseek-284b|台北時間:2026-09-15 14:10)
 找到並啟動本機視覺模型:Qwen3.8-27B-VL(llama-server,:11438,純 CPU+RAM,16.5GB)
VL 視覺測試成功:它能看圖並描述內容
 關鍵證據:我把先前「五檔報價」截圖送 VL,它回:「這是一張教學影片截圖,畫面中央是一位亞洲男性在說話(白 Polo 衫、戴眼鏡),背景是淺灰磚牆,下方疊加文字『判斷買賣意圖』」——我的截圖根本是講者口播畫面,不是五檔報價圖! 完全印證您說「截圖都不是重點」。
這代表:我可以先用 VL 判斷每個時間點畫面是不是「關鍵圖表」,再選對的時間截圖。代價:VL 每張圖 CPU 解碼約 30–130 秒,很慢。71 支 × 多個時間點 = 數百次呼叫,需數小時。
我先用 VL 在火山爆發當沖法這支驗證流程:抽多個時間點→VL 判定哪個是關鍵圖表→重做含正確截圖的筆記。您同意我先這樣驗證一支嗎?還是要我先批量用 VL 掃描所有影片的「關鍵圖表時間點」?
VL 回傳空,因為 max_tokens:120 太低——這是推理模型,token 被推理(thinking)吃光,content 才空。提高 max_tokens 重試。Edit
_vlclassify.py
Pwsh
Re-run VL classification with higher max_tokens
Think
The VL classification is re-running with max_tokens:700. This will take ~15 min for 7 frames. Let me wait and check.
VL 分類重跑中(max_tokens 700,約 15 分鐘)。我等待並持續追蹤。現在用codex 來調整看看 能否將gpu跟vram分一點給3.8 vl
-
真好玩!重新把27b-vl放入5090後~
已完成修改並重新啟動:
- 284B:32核心32執行緒,專家層與快取放處理器,顯示卡約14.1gb。
- 27B-VL(27B視覺語言模型):56層放入5090,32k上下文、48執行緒。
- 120B:純處理器16核心。
三路目前在線且空閒,顯示卡占用約 28.4/32.6gb。文字與影像測試成功;64層會接近30gb上限,因此固定56層。
模型:GPT-5(第五代模型)] [時間:2026-09-15 15:24:11(台北時間)]
測試完成,結果正常:- 284B(284B模型):文字測試成功,約 3.5 秒。
- 120B(120B模型):文字測試成功,約 4.6 秒。
- 27B-VL(27B視覺語言模型):文字與影像測試成功,文字約 0.8 秒。
- 三路目前都在線且空閒。
- 顯示卡(GPU,圖形處理器)占用 28.4/32.6gb,溫度 40°C,沒有錯誤。
-
,系统 取消固定了此主题



 是有可行性的