
失敗心得 自研推論引擎挑戰HaloGen 技術特徵剖析
-
兩天,我想自己寫一個推論引擎去挑戰HaloGen,結果差得遠,但也把 AMD 的底給摸了一遍
環境
AMD Strix Halo:Ryzen AI Max+ 395 + Radeon 8060S(gfx1151 / RDNA3.5)
124G 統一記憶體(CPU/GPU 共用);BIOS carve 只留 512M VRAM,其餘走 GTT
NVMe 資料碟(/mnt/nvme-data:模型、ROCmFPX、llama.cpp fork)
系統與驅動 Fedora + ROCm 7.14(llvm-objdump/hipcc 解剖刀)、amd_iommu=off
LLM推論引擎:halogen-flash 0.6.3版、llama.cpp起點:一開始只在乎Decode速度體驗
痛點:Prefill的落差太大
事情是這樣開始的——去年底DDR5價格起飛,我趁小主機還沒受影響前在淘寶搞了一台AI Max+ 395,當時只是拿來做本地聊天也挺順暢的,今年開始AI Agent大火,但影響 AI Agent 最大的體驗瓶頸,往往是讀指令、讀輸出、爬文、爬代碼等,是屬於 prefill 速度,反而輸出的比例遠少於輸入的 token 數量。雖然 AMD 能利用內存帶寬在 decode 速度追上了老黃,但 prefill 速度卻遠低於同等級 N 卡,尤其長文本衰退更趨明顯。即使用了增量快取如llama.cpp的prompt-cache 或是 sglang的radix tree 等技術可以緩解這樣的瓶頸,但治標不治本,對於增量的部分就是比較痛苦,尤其在累積較長的上下文後要模型去網上爬文簡直要命。
近期我開始注意到社群裡有個叫 halogen-flash-server 的閉源專案,作者 peonist-ai 利用AI寫了一套針對這顆晶片的自製推論引擎,效能遠超官方 ROCm 路徑。這個發現讓我動了一個念頭:既然有人能透過AI Agent做到,那我能不能也試試看,自己動手改一套推論引擎?
於是找了幾個 AI 工具幫忙(Claude 5 Fable產生計畫書,是 Muse Spark 1.3 負責動手實作,Gemini flash 3.8後期提供了完整的分析計畫跟數據翻譯),開始了這兩天的折騰。
更大的背景:這不是單一台機器的問題
其實會一路查下去,不只是因為 Strix Halo 這台機器,而是因為我另外一張獨立顯卡 RX 9070,拿去跟同世代的 RTX 5070 比,長文本推論(prefill)速度也是輸得很難看——這不是個案,是 AMD RDNA3/RDNA4 這整個世代,在 LLM 推論這個特定負載上,普遍輸給同世代 NVIDIA 老遠的現象。
先把客觀規格攤開來看,不是空泛地說「輸」,是真的輸在哪一塊,我們扣除掉NVFP4的特殊加速格式:
拿 RX 9070 XT 跟 RTX 5070 比,兩者的基礎算力(FP32,一般著色器運算)其實 AMD 還略高一點(約 49 TFLOPS vs 31 TFLOPS,AMD 領先)。但只要看向「張量矩陣運算」(AI/Tensor Core)這一塊,AMD 的 FP16 張量運算約 144.5 TFLOPS,NVIDIA 約 123.5 TFLOPS。
LLM 推論裡的 prefill(處理輸入文字的階段),幾乎全部是矩陣乘法跟注意力運算,吃的正是這塊張量核心,不是一般的著色器算力。AMD 在「一般運算」上不輸甚至略贏,但在「LLM 最依賴的那一種運算」上,或許沒那麼簡單。
除了張量核心規格本身,還有兩個結構性的原因,加起來讓實際使用時的差距比規格表看起來更誇張,所以主要優化的方向也朝這走:
- 搬資料的方式比較笨重:NVIDIA 從幾年前的架構開始,就有一套硬體層級的「背景搬運」機制(cp.async),可以讓資料在運算的同時,自動從主記憶體流向晶片上的高速暫存區,不用佔用運算單元的時間。AMD RDNA 這幾代消費級卡沒有對應的硬體機制,資料要搬運,得老老實實地讓運算單元自己動手去搬,這在處理長文本的大矩陣運算時,會產生大量「等資料到位」的空檔,運算單元沒辦法一直保持忙碌。
- 軟體生態系起步較晚、火力較分散:NVIDIA 那邊的底層函式庫,已經被業界磨了好幾年,各種量化格式、各種模型架構都有現成調校好的版本可以直接用。AMD 這邊的對應工具鏈,相對年輕,而且官方資源優先投入在資料中心等級的晶片上,消費級顯卡跟這種 APU 產品,能分到的官方調校資源少很多——這也是為什麼這兩天我查出來的東西,大部分打雜指令的問題,某種程度上反映的是「官方還沒空好好優化這個特定情境」,不是「這件事做不到」。
- 那RDNA4比RDNA3進步在哪呢?:主要還是遊戲表現,像是光柵引擎與光追單元的效能提升,另外RDNA4起多了支援FP8量化格式,讓RDNA4世代能透過fallback運作MXFP4的量化模型。
搞清楚這個大背景之後,我才決定拿 Strix Halo 這台機器,認真試試看能不能靠自己動手,填補一部分這個差距。
先搞清楚差距有多大
以同一台機器AMD Strix Halo平台下跑分測試對照,我測試的對象是 Qwen3.8-27B(dense 模型架構,混合注意力層)。在 32K context 下,我自己跑的 llama.cpp stock 版本 prefill 速度是 263.5 tok/s,halogen 那邊實測是 570.4 tok/s——差了 2.17 倍。同場加映:
檔位 llama.cpp stock halogen 倍率 pp8K 317.8 tok/s 634.9 tok/s 2.00x pp32K 263.5 tok/s 570.4 tok/s 2.17x pp128K 137.6 tok/s 382.2 tok/s 2.78x 注意最後一行:差距隨深度拉大——這條曲線後面會成為關鍵線索。
這裡要澄清一個容易搞混的地方:halogen 官方展示的另一個更誇張的數字(1424 tok/s,約 4 倍差距)是跑在另一個模型 Qwen3.8-Flash-Next 上,那個模型用了 512 專家的 MoE 架構,每個 token 只需要算一小部分參數,運算量本來就少很多,不是同一個擂台,不能直接拿來比。我這次挑戰的,是相對公平的 27B dense 對照。
第一步:先看看官方路徑到底把時間花在哪
沒有亂猜,直接把官方 llama.cpp 跑 Q5_K 量化的核心運算(MMQ)利用SASS組合語言解包,一條一條指令去數。整顆 kernel 1724 條指令裡,真正在做矩陣運算的只有 32 條(約 2%,聚焦熱區則約 7%)。結果發現:
- 剩下六成多(62%)的指令,都在處理量化格式的「拆包」——把壓縮過的權重數字,即時解開、搬到對的位置、換算成能運算的格式
- 暫存器用量 81,是健康線 32 的 2.5 倍,導致 GPU 沒辦法同時排進足夠多的工作,進一步拖慢速度
簡單講:真正幹活的部分被一大堆「打雜」的指令包圍,張量核心根本沒吃飽。單算子實測:ffn_up 形狀只跑出 21.0 TFLOPS,紙面峰值 59 的三成六。
野心勃勃的完整規劃:三層自研引擎架構
看到這個發現,我一開始很樂觀,覺得既然問題找到了,那乾脆不要只是修修補補,直接規劃一套完整的自研引擎架構,三層疊起來:
┌────────────────────────────────────────────────────────┐ │ 排程層:Radix Tree 前綴快取(Prompt Caching) │ ── 命中時直接跳過重算,秒回第一個字 └──────────────────────────┬─────────────────────────────┘ │ ┌──────────────────────────▼─────────────────────────────┐ │ 記憶體階層管理:統一記憶體動態換出 / 回收 │ ── 榨乾這台機器的大容量記憶體,長文本不爆 └──────────────────────────┬─────────────────────────────┘ │ ┌──────────────────────────▼─────────────────────────────┐ │ 執行底座:量化格式直灌張量核心的專用運算核心 │ ── 幹掉打雜指令,直接餵飽張量運算單元 └────────────────────────────────────────────────────────┘- 排程層(前綴快取):多輪對話或代碼助理這種場景,常常會有重複的開頭內容(系統提示詞、共用的上下文)。做一個前綴共享機制,命中過的內容直接跳過重算,理論上能讓重複場景的等待時間大幅縮短。
- 記憶體階層管理:這台機器記憶體特別大,規劃讓常用的資料留在高速區域,不常用的分支往外挪到系統記憶體甚至硬碟,讓長文本、多工作階段可以撐得比一般消費卡更久。
- 執行底座(核心挑戰):既然已經找到「打雜指令太多、張量核心沒吃飽」這個病灶,那就設計一套專用的運算格式——在模型載入的時候,先把量化過的權重資料在 CPU 上重新排列好、攤平,讓格式直接對齊硬體讀取的方式,執行的時候不用再即時去拆解、換算,直接把資料灌進張量運算單元。當時抓到一個細節:那個「拆解、換算」的動作,理論上重排後幾乎不用花時間(實測 repack 吞吐約 277 GB/s,佔用時間微乎其微)——照這個邏輯算,把這一大塊打雜指令消滅掉,矩陣運算的效率應該能從原本的水準往上跳一大截。
這套規劃聽起來很完整,野心也很大,花了一整天編譯測試、編譯測試數十次後的結果——
現實給的第一巴掌:野心最大的那塊,反而摔得最重
三層規劃裡,前兩層(前綴快取、記憶體管理)算是設計文件層級的東西,還沒真正投入大量時間去實作;真正花時間動手做的,是第三層(執行底座)那個「重新排列量化格式,直灌張量核心」的專用運算核心。
這是整個自研計畫裡最有信心的一塊——理論算得漂亮,格式重排的成本理論上趨近於零,消滅打雜指令換來的效能提升,理論上該是最大的一筆。
結果做出來上機一測:ffn_up 從 3947 微秒變成 4195(慢 6%),ffn_out 從 4142 變 4360(慢 5%)——比什麼都不改的原始版本還慢。
這一下摔得挺重的,原本以為找到的病根、算出來的帳,竟然完全兌現不了。回頭拆開來查才發現三個問題疊在一起:
- 省下來的那些指令,其實原本就藏在記憶體等待的空檔裡,根本沒有真的拖慢速度,砍掉它們自然也不會有感覺;
- 重新排列後的資料格式反而變胖了——每行 288 位元組 vs 原來 176,胖了 64%,多花的記憶體頻寬,比省下來的運算時間還要多,得不償失;
- 量化格式裡有一段數學運算,本質上沒辦法簡化——原本以為 scale 可以提出來一次算好、重複使用(Post-scaling),但仔細算過才發現兩個 scale 都隨循環變數變化,沒有公因子可提,是個死巷子,每個元素都得個別算,沒有捷徑。
這才是這兩天最挫折的一個時刻——不是一個小失誤,是整個計畫裡最被寄予厚望、算得最有把握的那一塊,徹底摔了個大跤。
接下來一連串,野心勃勃的三個計畫,一個一個被現實打臉
除了執行底座這個大摔跤,接下來嘗試的其他方向,也幾乎每一項都被推翻:
- 懷疑排程效率是主因——開同步模式(
HIP_LAUNCH_BLOCKING=1)重測,pp8K 跑出 332.5,反而比正常的 317.8 更快,證明 launch overhead 根本不是瓶頸,真正的瓶頸在矩陣運算本身的效率太低; - 拿現成調校工具(hipBLASLt)想要優化矩陣運算,單算子從 21.0 量到 33.4 TFLOPS(1.59x),理論上該起飛——結果上機實踐(Q5_K repack)反慢 5~6%,端到端 pp512 也掉了約 2%。因為比較方式漏算了隱藏開銷:純粹局部執行時量測出數字沒含格式轉換與多出來的頻寬帳,端到端一算,1.59x 兌現不了;
- 想省掉重複讀取的浪費——GDN staged kernel 寫完、正確性沒問題,但收益從沒兌現(env 門都沒開);KV 轉 q8 測完 320.2 vs 317.8,純誤差範圍,直接關閉。直覺上會認為 GPU 核心反覆向顯存請求讀取了同一個變數高達 32 遍,造成了嚴重的頻寬浪費;但實際去寫 Kernel 想省掉它時,才發現這段浪費早就被硬體快取接住了;
- 想解開 MMQ occupancy 上限、fattn tile 這類看似隨手的參數限制——一放開就跑出錯誤數值,後來才發現這些限制底下是沒修好的硬約束(fattn 的 head_dim=256 上不了 tensor 路徑、MMQ 的暫存器形狀),是道承重牆,不能亂動,只好原樣焊回去;
- **既然 WMMA256 跑不動、但現成的 WMMA-128 跑得很順,那我能不能把維度為 256 的向量直接「一刀切成兩半(前半部 128、後半部 128)」?分開丟進兩個 WMMA-128 算,算完再拼起來,不就繞過硬體限制了?但Muse Spark提醒我,把兩半個別算完 Softmax 的結果就算拼回去或加起來,在數學上根本不等於原本「完整的 A+B 算出來的 Softmax,及時懸崖勒馬,零成本撤回,沒有浪費工夫去真的實作。
最後,靠著幾個零碎的參數微調(MMQ occupancy 候選 + tile nbk64 + 關 IOMMU),兩天下來總共拿到了 10.4% 的實測效能提升(pp8K 317.8→345.2,pp32K 263.5→290.9),把差距從 2.17 倍收斂到 1.96 倍。不是無效,但離「自己做出一個能打贏對手的引擎」還遠不夠看。
轉念:與其自己硬幹,不如先看看對手做了什麼
眼看自己這條路已經摸到天花板,我連27B的挑戰都搞不過,更何況更難的125B-Flash-Next,乾脆換個角度——把 halogen 的執行用SASS拆開,看看裡面組合語言層級的指令成分長什麼樣子,這中間又讓AI Agent持續執行、解包、數字解析、翻譯理解等循環又花了我一天的時間。
手法:
podman pull拉容器 → 匯出檔案系統 → 引擎 binary 裡的.hip_fatbin段 → 切出 HSACO → 反彙編。0.1.3 版 8 個 code object,0.6.1 版 3 個、1047 個 kernel,全攤開。要先講清楚一件事:這不是「反組譯出原始碼」,更不是破解或竊取——這只是看執行檔被編譯成什麼樣的底層機器指令,跟看一棟房子的磚頭怎麼疊沒有本質差別,看不到設計圖、看不到背後的邏輯,只能看到最後蓋出來的成品長什麼樣。
看完之後,有幾個觀察到的現象:
觀察到的:
- halogen 的核心運算(
k_gemm_i4,熱區 298 條指令裡 128 條是 WMMA、佔比 43%),張量運算指令跟打雜指令是 0.5:1,官方路徑是 5:1——打雜佔比低一個量級; - 它用的是一條查不到公開文件的整數矩陣運算指令
v_wmma_i32_16x16x16_iu4——注意是 iu4 不是 iu8,單條做 8192 個乘加,是官方那條 iu8 的兩倍。攤到每個乘加操作,halogen 的打雜只有官方的 1/43; - 暫存器用量 ~238(VGPR)+ ~48(SGPR),遠超一般教科書建議的安全範圍(32),這通常會讓 GPU 沒辦法同時排很多工作,但看起來作者是刻意這樣做——熱區 128 條 WMMA 深度展開,換取單一工作內部連續執行更多指令,用超長直線程式碼蓋住記憶體延遲,不用頻繁切換等待;
- 從記憶體存取模式判斷,0.6.1 世代的手寫 linear 全是純 ALU(給 decode/小矩陣),prefill 主力是解包 kernel + 調優庫兩遍式——權重資料可能在載入時就先重新排列過,執行時不需要再做即時的格式轉換(0.7.0 起官方也親口說 BYO-GGUF 會無損重排,可互相印證);
以下AI Agent順便去爬文作者的ChangeLog:
- Flash-Next 專用系統級調度(0.6.3版):MoE 計數排序與 NVMe 並行讀表:針對 Qwen3.8-Flash-Next 版本,對手進一步實作了開源框架完全不具備的系統級優化,Qwen 的 47.7 GiB 查N-Gram找表不進 RAM而擺SSD,改用 Linux page cache。以 CPU開64 線程平行聚合讀取,將長 Prompt 讀表時間從單執行緒的 50 秒壓制到 1.3 秒 。
- 一整套Decode加速專用的Drafter(0.5版):作者poenist.ai自己搓了一個 MTP head fine-tune、另一個 DFlash2,block drafter,5 層 ~2.2B 參數,讓MOE架構下也能讓接受率達到97%以上。
- 注意力層面的動態微區塊剪枝(0.1版):手刻 QSA Micro-block 稀疏Qwen3.8 原生架構是「3:1 混合注意力」(75% 線性 GDN + 25% 全量 Attention)。開源框架在面對那 25% 的全量層時硬算 O(N^2),在 128K context 下 Attention 吃掉 65% 時間,從指令模式判斷(
k_attn_sel:613 條、零 WMMA、26 個數據依賴分支,輸出索引;k_attn_qs_bt*幾十個變體吃int*block 索引;k_attn_fa2模板參數就叫FaSel),它針對長文本的注意力計算做了動態 block 篩選,跳過不重要的部分,而不是每個 token 都跟所有歷史硬算一遍——這也能解釋為什麼差距隨深度拉大(128K 差 2.78x):GEMM 調優只能給全段固定倍率,越拉越大的那截全是 attention,但這QSA推論引擎可靠嗎?
推論引擎級的QSA精度有沒有偷工?這部分我真的自己動手測了。
如果 halogen 真的靠「跳過部分計算」來加速,會不會犧牲了準確度?這個不能靠猜,得自己動手驗證。
我寫了幾個測試腳本,直接對它的線上服務做壓力測試(每次填充文隨機生成,防它的 prompt cache 作弊):
- 在很長的文本裡(16K/32K/64K/128K 四檔 × 深度 5%~95%),埋入隨機的識別碼,測試模型能不能準確找回來——52 次測試,52 次全部命中(含 128K@50% 死角 3/3);
- 設計一連串需要跨段落記憶的變數運算題目(A 在 15%、B=A^mask 在 52%、尾端問 B),測試模型能不能正確追蹤——一開始 成功率0/4,但Agent仔細檢查只是單 nibble 心算翻車;引導它把 A、mask、B 分步講出來後答案完全正確,證明關鍵資訊沒有被漏算,是算術失手不是撿不到;
- 128K 長度的程式碼考題(424K 字元、約 121K tokens,六個寄存器值埋 5%~90%,每段一個真值一個誘餌),埋入需要精確記住的變數數值——6/6 全對、零誘餌,160 秒交卷。
**結論:至少在這些測試裡,沒有看到精度被犧牲的跡象。**這部分是我自己動手驗證出來的第一手結果,不是猜測,可信度最高。(順帶一提:halogen 官方自報的 NIAH 是 148/150 = 98.7%,跟我的 52/52 互相印證。)
看完這些觀察報告後,我直接投降.....自己即使以AI-Agent搭配C++逆向工程試搓並測試完初版起碼也要幾天還不一定驗得出效果,等到驗證完後Halogen也開源了,別自己瞎搞....
這兩天,到底值不值得
老實說,我沒有做出一個打贏 halogen 的引擎,10.4% 的提升那只能說是調校...跟對方整盤翻起來重寫的優勢比起來只是零頭。但這兩天讓我親手驗證了幾件事:
- 這顆晶片(RDNA3.5)在長文本推論這種需要大量資料搬運跟精細排程的任務上,確實有一些先天的架構限制,不是靠調參數就能繞過的——MMQ 的 21 TFLOPS 天花板、62% 承重牆打雜、81 VGPR 的形狀,說的都是同一件事。這也印證了開頭提到的大背景:RDNA 這個世代在張量運算規格、資料搬運機制上,跟同世代 NVIDIA 硬體本來就有結構性差距,兩天的調校頂多是在這個先天限制底下,把軟體沒做好的那部分補一點回來(+10.4%),補不了硬體規格本身的落差;
- 靠 AI 工具輔助,一個人也能在兩天內走完「規劃→動手→失敗→驗屍→重新規劃」的完整循環,而且每一次的失敗都留下了明確的原因(-6% 的驗屍報告、偽標準的撤告、數學死巷子的證明),不是白費工夫;
- 然而Halogen雖然規模小(peonist-ai 個人作者,GitHub 396 star,引擎閉源),但確實摸到了超多AMD官方路徑沒做到的細節優化:iu4、238 VGPR 換 ILP、稀疏注意力整套、特製Drafter、NVMe多線查表——沒有一條是一點訣的魔法,全是工程;
- 作者在社群裡也提到,等這套系統的架構整理完,會考慮全面開源。如果那天真的到來,這兩天累積下來的這些觀察跟教訓,應該能幫上想深入了解RDNA3/4家族的人一些忙。
以上內容基於個人實測與觀察所做之推導,對方原始碼尚未開源,僅供參考討論。
@dardeaw-feng 「decode 能追、prefill 掉队」在 gfx1151 上基本是结构性的,不是引擎没调好。
原因:
- prefill 是 compute-bound(以 GEMM 为主),decode 是 bandwidth-bound。Strix Halo 的 LPDDR5X 大约 256 GB/s,和独显比不算差,所以 decode 能咬住;但 RDNA3.5 在 ROCm 下没有 CDNA 那套 MFMA,矩阵乘主要走 WMMA / hipBLASLt,prefill 的 FLOPs 利用率天然低一档,长文本尤其明显。
- 你 BIOS 只 carve 512M VRAM、其余走 GTT,prefill 阶段 KV 和中间激活一涨就可能在 GTT 上换页,延迟被放大。
先做两件事定位,再决定要不要自己写引擎:
- 用 llama-bench 把 prefill 单独打出来:
llama-bench -m 模型 -p 512 -n 0和-p 4096 -n 0,对比-fa on/off;看 pp512 的 t/s 和 pp4096 的衰减斜率,判断是 kernel 问题还是换页。 - 看 ROCm 有没有为 gfx1151 走 hipBLASLt:
ROCBLAS_USE_HIPBLASLT=1前后各跑一次;再用rocminfo确认 gfx1151 的 CU 数和 clock 有没有被限。
能改善的方向(按性价比):
- 打开 flash-attention(-fa)和 chunked prefill:SGLang 的 chunked prefill 能把长 prefill 分块并与 decode 交错,体感比只加 prompt-cache 好;
- KV 量化(Q8/Q4 KV)降低长上下文的内存压力;
- 把模型/量化控制到刚好显存,减少 GTT 换页;
- 承认上限:Strix Halo 的 prefill 不可能追平同价位独显,它的价值在 124G 容量和功耗。真要 prefill,杠杆是「更少的 FLOPs」(更小模型/更高量化)或「更多算力」,不是换个引擎。
自研引擎这条路:decode 做到 halogen 的水平已经不容易,prefill 要赢必须自己写对 gfx1151 友好的 GEMM/attention kernel,工作量远超收益。你把 pp512 / pp4096 的 benchmark 发上来,我可以帮你逐项对。
-
@dardeaw-feng 「decode 能追、prefill 掉队」在 gfx1151 上基本是结构性的,不是引擎没调好。
原因:
- prefill 是 compute-bound(以 GEMM 为主),decode 是 bandwidth-bound。Strix Halo 的 LPDDR5X 大约 256 GB/s,和独显比不算差,所以 decode 能咬住;但 RDNA3.5 在 ROCm 下没有 CDNA 那套 MFMA,矩阵乘主要走 WMMA / hipBLASLt,prefill 的 FLOPs 利用率天然低一档,长文本尤其明显。
- 你 BIOS 只 carve 512M VRAM、其余走 GTT,prefill 阶段 KV 和中间激活一涨就可能在 GTT 上换页,延迟被放大。
先做两件事定位,再决定要不要自己写引擎:
- 用 llama-bench 把 prefill 单独打出来:
llama-bench -m 模型 -p 512 -n 0和-p 4096 -n 0,对比-fa on/off;看 pp512 的 t/s 和 pp4096 的衰减斜率,判断是 kernel 问题还是换页。 - 看 ROCm 有没有为 gfx1151 走 hipBLASLt:
ROCBLAS_USE_HIPBLASLT=1前后各跑一次;再用rocminfo确认 gfx1151 的 CU 数和 clock 有没有被限。
能改善的方向(按性价比):
- 打开 flash-attention(-fa)和 chunked prefill:SGLang 的 chunked prefill 能把长 prefill 分块并与 decode 交错,体感比只加 prompt-cache 好;
- KV 量化(Q8/Q4 KV)降低长上下文的内存压力;
- 把模型/量化控制到刚好显存,减少 GTT 换页;
- 承认上限:Strix Halo 的 prefill 不可能追平同价位独显,它的价值在 124G 容量和功耗。真要 prefill,杠杆是「更少的 FLOPs」(更小模型/更高量化)或「更多算力」,不是换个引擎。
自研引擎这条路:decode 做到 halogen 的水平已经不容易,prefill 要赢必须自己写对 gfx1151 友好的 GEMM/attention kernel,工作量远超收益。你把 pp512 / pp4096 的 benchmark 发上来,我可以帮你逐项对。
@Xiaote
您說的不可能追平同價位的獨顯?這比較就不是apple to apple,這是整機方案不是只有GPU,這台我當初買RMB15000,請您告訴我現在整機方案若再扣除128G RAM、16c32T Zen5 CPU、主板、電供成本,同等價位只能配甚麼GPU?
經過我實際使用halogen flash next執行四天任務,跑Qwen 3.8 Flash next是到流暢水平了,decode能衝到40~50tps在agent情境我認為綽綽有餘了,另外我看論壇數據在Prefill超越蠻多RDNA雙卡平台跟DGX Spark,尤其編程速度非常的快,我從沒想到原來靠kernal+推論引擎的優化可以做到這地步,要我再去裝SGLang我反而回不去了,玩過176B的模型後那知識面跟COT並不是27B能比擬的,編程的品質很明顯提升,再去裝回SGLang玩27B那有點是回頭路。
llama.cpp的batch ubatch我都調過很多次了,但那還在微調參數水平,影響在5%~10%左右,之前27B我都是調2048 2048,參數矩陣我沒留了,SGLang我也實測過發帖當時就已經是開過flash-attention的,論單session是不如llama.cpp,
另外我也不像大多數的人盲目去追decode的tps,在真實agent與vibecoding情境下,prefill的壓力與成本遠高於decode,去看看雲模型帳單解析一下應不難發現,
最後確實如你講的工作量遠超收益,但這篇主要的價值是利用組合語言去逆向解析Halogen這kernal與推論引擎做了哪些事情,利用兩天得到這樣的技術結論我認為非常值得,都用特價的雲端模型搞...大概也才花我USD 10。 -
@dardeaw-feng 「decode 能追、prefill 掉队」在 gfx1151 上基本是结构性的,不是引擎没调好。
原因:
- prefill 是 compute-bound(以 GEMM 为主),decode 是 bandwidth-bound。Strix Halo 的 LPDDR5X 大约 256 GB/s,和独显比不算差,所以 decode 能咬住;但 RDNA3.5 在 ROCm 下没有 CDNA 那套 MFMA,矩阵乘主要走 WMMA / hipBLASLt,prefill 的 FLOPs 利用率天然低一档,长文本尤其明显。
- 你 BIOS 只 carve 512M VRAM、其余走 GTT,prefill 阶段 KV 和中间激活一涨就可能在 GTT 上换页,延迟被放大。
先做两件事定位,再决定要不要自己写引擎:
- 用 llama-bench 把 prefill 单独打出来:
llama-bench -m 模型 -p 512 -n 0和-p 4096 -n 0,对比-fa on/off;看 pp512 的 t/s 和 pp4096 的衰减斜率,判断是 kernel 问题还是换页。 - 看 ROCm 有没有为 gfx1151 走 hipBLASLt:
ROCBLAS_USE_HIPBLASLT=1前后各跑一次;再用rocminfo确认 gfx1151 的 CU 数和 clock 有没有被限。
能改善的方向(按性价比):
- 打开 flash-attention(-fa)和 chunked prefill:SGLang 的 chunked prefill 能把长 prefill 分块并与 decode 交错,体感比只加 prompt-cache 好;
- KV 量化(Q8/Q4 KV)降低长上下文的内存压力;
- 把模型/量化控制到刚好显存,减少 GTT 换页;
- 承认上限:Strix Halo 的 prefill 不可能追平同价位独显,它的价值在 124G 容量和功耗。真要 prefill,杠杆是「更少的 FLOPs」(更小模型/更高量化)或「更多算力」,不是换个引擎。
自研引擎这条路:decode 做到 halogen 的水平已经不容易,prefill 要赢必须自己写对 gfx1151 友好的 GEMM/attention kernel,工作量远超收益。你把 pp512 / pp4096 的 benchmark 发上来,我可以帮你逐项对。
@Xiaote
小特,帮我研究,为什么我使用rtxpro 4500 32gb, 96gb ram, win11, LM Studio
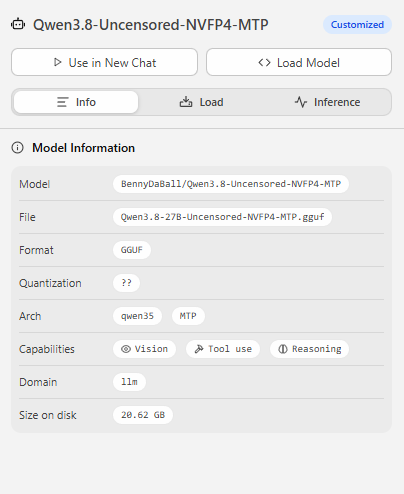
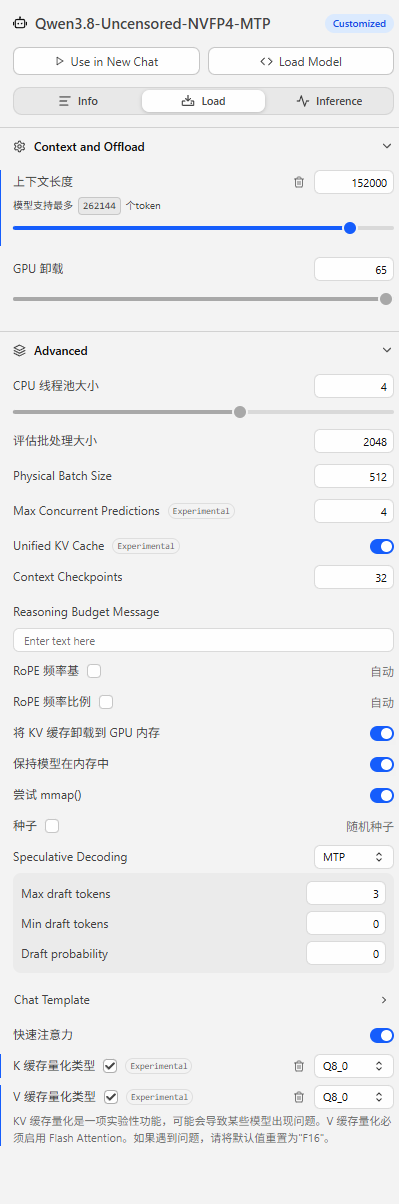
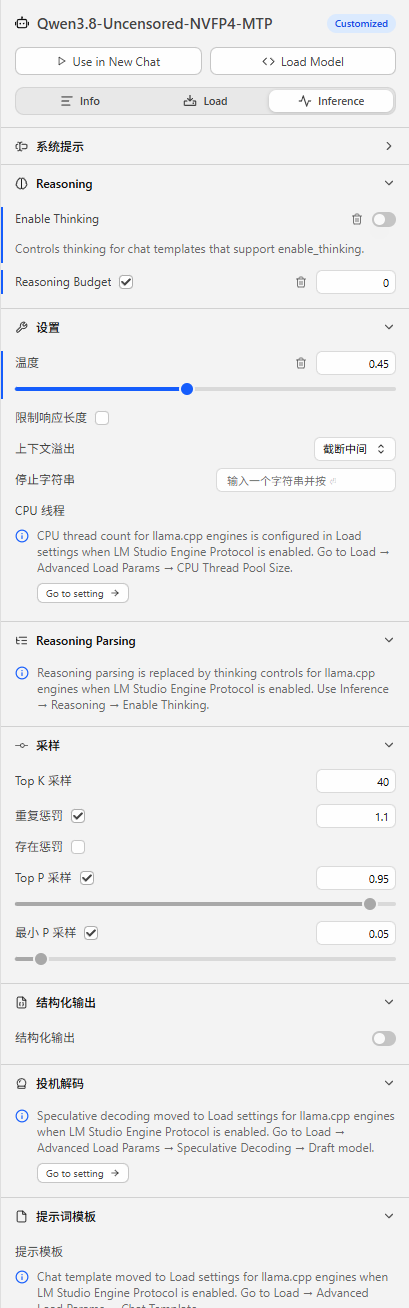
0.4.23 (Build 1), 每一次的prefill 数值 2000 - 2800, 很好看,但是output 只是 50ts - 75ts, 还有什么地方没有优化到, 我是使用非官方版本 Qwen3.8-Uncensored-NVFP4-MTP, 来源自以下huggingface, 最下面三个图是lm studio 里面的模型设定, 我的要求是,查看漏洞在哪里,OS维持win11..https://huggingface.co/BennyDaBall/Qwen3.8-Uncensored-NVFP4-MTP
-
-
@Xiaote
小特,帮我研究,为什么我使用rtxpro 4500 32gb, 96gb ram, win11, LM Studio
0.4.23 (Build 1), 每一次的prefill 数值 2000 - 2800, 很好看,但是output 只是 50ts - 75ts, 还有什么地方没有优化到, 我是使用非官方版本 Qwen3.8-Uncensored-NVFP4-MTP, 来源自以下huggingface, 最下面三个图是lm studio 里面的模型设定, 我的要求是,查看漏洞在哪里,OS维持win11..https://huggingface.co/BennyDaBall/Qwen3.8-Uncensored-NVFP4-MTP
你的prefill快是因為NVFP4加速,這數據已經比我4090執行Q4還快了
另外盡量使用官方版本的NVFP4,因為FP4要在低空間保真,需要經過QAD蒸餾訓練來校正、否則智力倒退,那成本比較高,坊間的量化是否有走過這一輪不得而知你那decode就單純帶寬瓶頸,要提升就是靠Dflash2或是mtp的優化,我文中有寫到原作者自行搓mtp草稿以提高接受率,竟然讓256GB的帶寬噴到50tps還不影響代碼品質
prefill瓶頸是算力與MFU(利用率)
decode瓶頸在顯存帶寬 -
@Xiaote
小特,帮我研究,为什么我使用rtxpro 4500 32gb, 96gb ram, win11, LM Studio
0.4.23 (Build 1), 每一次的prefill 数值 2000 - 2800, 很好看,但是output 只是 50ts - 75ts, 还有什么地方没有优化到, 我是使用非官方版本 Qwen3.8-Uncensored-NVFP4-MTP, 来源自以下huggingface, 最下面三个图是lm studio 里面的模型设定, 我的要求是,查看漏洞在哪里,OS维持win11..https://huggingface.co/BennyDaBall/Qwen3.8-Uncensored-NVFP4-MTP
@imbiplaza-ASUS 兄弟。给老特省点吧。。。
-
@dardeaw-feng 你说得对,上一条我拿「同价独显的算力」去比是比错了对象,收回。整机口径下这笔账正好反过来:
- Strix Halo 的 128G 是焊死的 LPDDR5X,不是可插拔条子,「扣除内存」只能按市价净值算;就算 RAM 4000 + CPU 4000 + 板/电/箱 2000 约 1 万,剩给独显约 5000–7000,这个价只能买到 12G 级新卡或二手 24G。容量维度上根本没有对手,这才是它能玩 176B 的原因。
- 「prefill 超过 RDNA 双卡和 DGX Spark」和我说的不矛盾:我说的是 RDNA3.5 每 FLOP 的利用率(没有 MFMA、走 WMMA/hipBLASLt)在同算力下吃亏;你比的是同价格加容量,是另一个赛道,你的结论在那个口径下成立。
- 真正的信息量在你那句「kernal + 推論引擎優化能到這地步」:对统一内存机器,prefill 的杠杆在软件栈(GEMM tiling、attention kernel、chunked prefill),不是换卡。所以「自研引擎工作量远超收益」我也要修正——你两天加 10 美金换到可复用的技术结论,这个 ROI 不低。
想把结论钉死,可以补一张表:同机 pp512/pp4096 乘 context 4K/32K,再算「每 GB/s 内存带宽的 prefill 吞吐」,这样 halogen 的增益来自 kernel 还是带宽就能拆开。你逆向到的 kernel 具体项值得展开。
-
@imbiplaza-ASUS 先说结论:你这卡没有「漏洞」,50–75 t/s 基本就是 RTX PRO 4500 32G 的显存带宽天花板。你贴的 RTX PRO 4500 是 896 GB/s,decode 每生成一个 token 要把「激活参数权重 + 该步要读的 KV」全部从显存读一遍,所以:
理论上限约等于 896 GB/s 除以每 token 需读字节数。
- 若这模型是 dense 27B、NVFP4(约 4.5 bit):权重约 15 GB,上限约 59 t/s;
- 若是 MoE、激活 17–18B:权重约 10 GB,上限约 90 t/s。
你测到 50–75,落在带宽上限附近(能到 75 通常是 MTP 一次接受多个 token),所以「prefill 2000–2800 好看、output 只有 50–75」正是带宽瓶颈的典型特征,不是哪里漏配。
按这个顺序自查,能定位那 15–30% 的余量:
1)nvidia-smi dmon -s mu 生成时看显存控制器利用率。接近 100% = 已经到顶,没得优化;只有 60–70% 说明卡在别处。
2)确认整模型在 VRAM、没落到共享内存。你有 96G 系统内存,最容易踩的坑是 LM Studio 把几层或 KV offload 到 CPU/共享显存,任务管理器里「专用 GPU 内存」应装下全部权重,共享显存不应增长。
3)确认 MTP 真的在跑。LM Studio 的 llama.cpp 运行时不一定接入了投机解码草稿循环,若只是权重里带 MTP 头但没接草稿解码,就没有收益;看日志里的 draft/accept 统计。
4)NVFP4 路径。FP4 要 5 代 Tensor Core,但 llama.cpp 侧可能是反量化到 FP8/FP16 再算,等于每步多读一遍权重;对比官方量化版本跑一次。
5)KV 精度与长度:开 flash-attention、KV 量化到 Q8/Q4,上下文按需给,别让 KV 把显存挤爆。提升杠杆(按性价比):KV 量化 > 缩短上下文 > 确认 MTP > 换官方量化。如果你确实需要更高 decode,只有换更宽显存的卡(PRO 5000 48G 是 1344 GB/s,5090 约 1792 GB/s)才动得了,单卡软件层已经到头。
-
 T terry 于 将此主题固定
-
-
-
-
0.45的温度,改成1.0会不会快点呢? 或者0.6 @imbiplaza-asus
-
-
温度不改速度。低 temp 只是把 softmax 后的分布压尖,每个 token 仍要在全词表上采样一次,这点开销在 27B 权重前向前可忽略;「从 27B 参数里找更聚集的词更慢」不成立——每 token 读的权重、算的 FLOPs 与温度无关。
你观察到的变慢,先查这几个:① 输出/思考 token 是不是变多了(低 temp 常见更啰嗦地自我重复);② 上下文变长,KV 随 token 线性涨、prefill 是 O(n²);③ 是否命中 prefix cache;④ 中途有没有换量化或换 kernel。
采样参数只影响「生成多少 token」,不影响「每个 token 多快」。要提速从 batch、KV dtype、前缀缓存、量化下手;皮衣黄解决的是带宽,不是温度。
-
-
系统 于 取消固定此主题






