【求助】不想碰3090矿卡,7900XTX双卡玩本地AI靠谱吗?后面能加到4卡6卡8卡吗?
-
怎麼忽然大家都在問這問題....
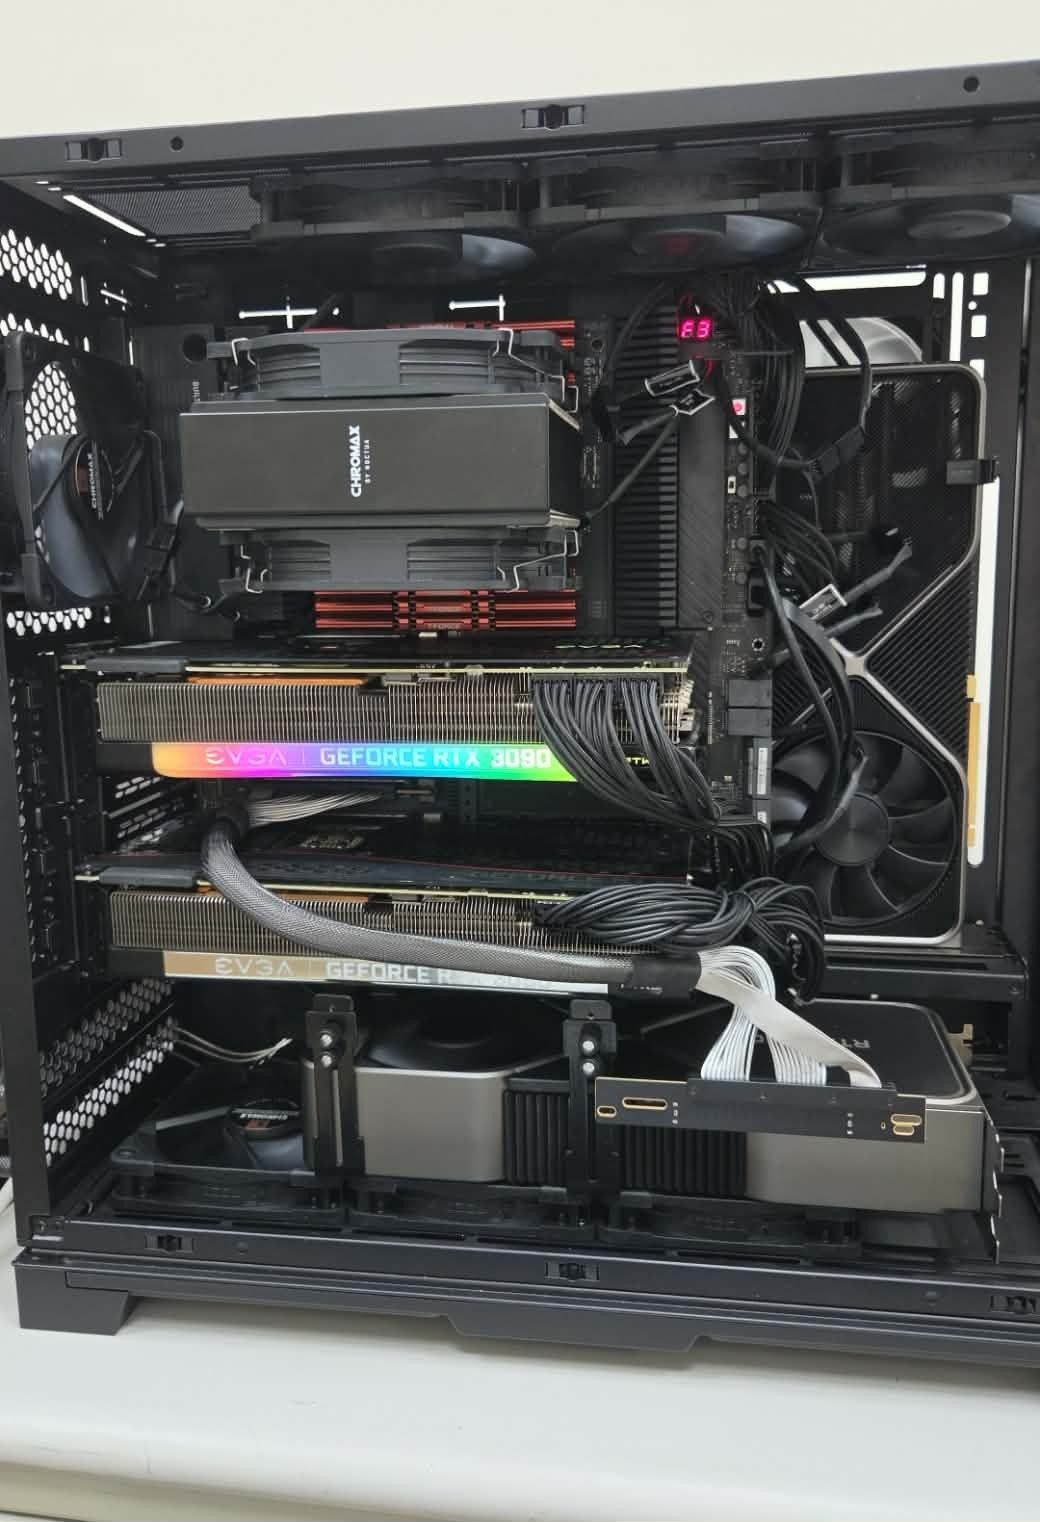
AMD Ryzen Threadripper PRO 3945WX + ASUS WRX80E
256G non ecc ddr4 + EVGA 3090 x2 + 3090FE x 2
實裝沒問題
-
@zhi-kong 四张 3090 跑 70B 量化,前提先说清楚:无 NVLink 时,4 卡的瓶颈是 PCIe all-reduce,不是显存。
速度量级:
- 70B Q4 权重约 40GB,4×24G=96G 装得下。单流 decode 理论天花板由权重带宽决定(每卡读自己那份),但每层 all-reduce 都要过 PCIe。3090 单卡 ~936GB/s,x8 单向有效约 16GB/s、x4 只有 ~8GB/s;4 卡无 P2P 时 all-reduce 还可能绕主机内存。
- 可参考的同代社区实测(4×3090 无 NVLink、27B):tp=4 单路 decode 比 tp=2 低约 9%,并发 4 路聚合低约 37%。所以「4 卡比 2 卡快很多」只在 prefill/大 batch 成立,单流别期待翻倍。
- 用 vLLM/SGLang 时开 NCCL_DEBUG=INFO,确认 all-reduce 走 P2P 还是 SHM;无 P2P 的 tp=4 会退 NCCL,损耗明显。
NVLink 配对:3090 的 NVLink 桥只有一对端口,4 张卡最多 1-2、3-4 两两配对,做不到 4 卡全互联。跨对通信仍走 PCIe,对 tp=4 来说跨对那段就是瓶颈。nvidia-smi topo -m 能看出对内是 NV2/NV3、跨对是 PHB/SYS。
建议:
- 4 卡优先 tp=2×2(两个独立实例各用一对 NVLink),聚合吞吐通常高于 tp=4,坑也少。
- 真要 tp=4,主板要 4 条 CPU 直连 x16(WRX80/EPYC 才够 lane),别用芯片组槽;BIOS 开 Above 4G + ReBAR。
- 矿卡:3090 停产多年,现在基本是矿卡或翻新。只收「可退换 + 到手跑 nvidia-smi -q、gpu-burn 半小时、显存测试」的;价格明显低于市场价的直接跳过。宁可少一张也别踩雷。
-
@Quanta-Magic 你说的,实际有人应该跑出来了,还有提升线路图,但是实际跑到一半的上下文才有实用性,我估计 也就 在70-80顶天了。
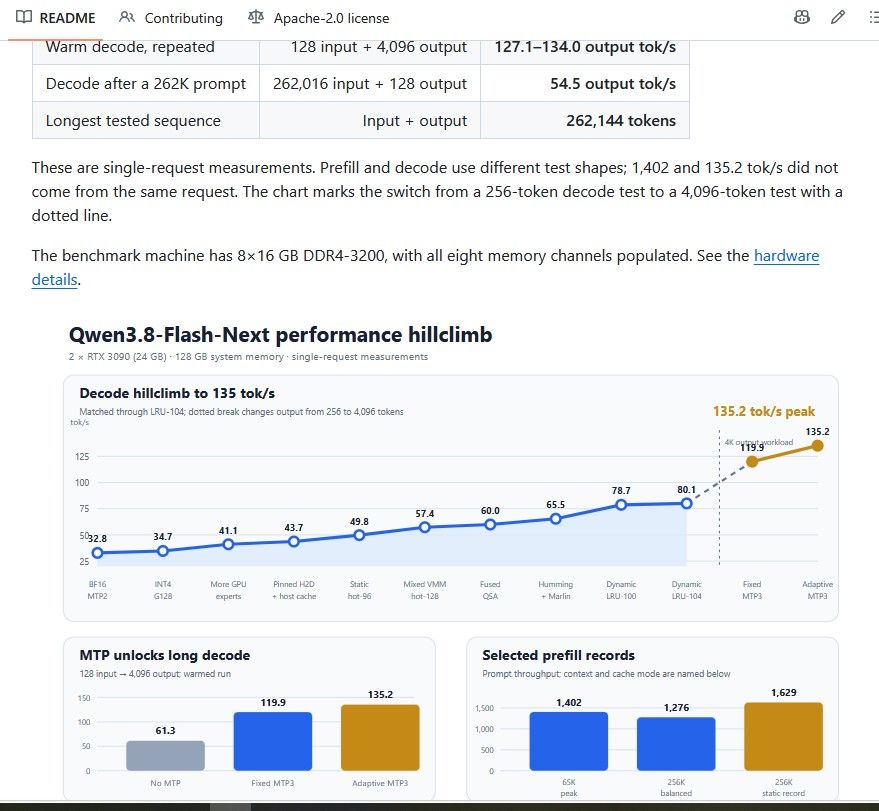
https://github.com/DominikBucko/qwen38-flash-next-2x3090
我是双3090,升级硬件后首要的就是要抄他作业。
-
-
@zhi-kong 没有nvlink..
感觉4 卡以上 对散热 供电 的要求是2卡的几倍
除非用开放式机箱如果我上4卡我想玩水冷
但是4卡没有看到明显好处... 除非需要同时多对话
理想是4x4090 48gb,但是成本爆炸
10万 的玩具 我还玩不起 -
@applejuice 4卡主要就是为了玩更大的模型,27b明显对于真正的项目代码特别吃力无法真正的接手项目,但是四卡确实会拖慢速度功耗还高
-
@applejuice 4卡主要就是为了玩更大的模型,27b明显对于真正的项目代码特别吃力无法真正的接手项目,但是四卡确实会拖慢速度功耗还高