
NInfer 4090D 48G测试,单任务长上下文体验很好,多任务长上下文4并发也能玩,个人场景可以平替SG-Lang!N卡本地部署入门利器!
-
论坛陆续有几个帖子谈到 NInfer 这个推理框架。应该是读 NInfer 吧,不知道要不要连读,就先这样读吧。这个推理框架对于压榨 32G 显存及以下,包括 24G 显存显卡的性能,有很大的帮助。就是说,这玩意现在效率挺高的。
它的作者好像是只针对 5090 做了优化,但是社区有 NInfer 的 4090 版本。我就把它下载下来测试了一下。因为这个东西最近讨论得比较多,非常流行,很多人在 3090 上也把它复现了。大家都说效率提升蛮大的,但是可能做多任务还是不如 SGLang。我长期在本地部署 SGLang,并且每天用它干活,所以我想在同一台服务器上,用同一张显卡把它部署好,对比一下。这应该是有一定参照价值的。
首先,做法其实很简单。大家到论坛找到这个帖子,我会在评论区下方留链接,也会在我的帖子中贴入原帖链接。实际上你找 1803 号帖子就行了。然后把地址粘贴给你的 AI Agent,让它来抄作业。但是你要告诉它,不要在本地自己编译 Docker 镜像,让它在网上找一个直接能用的 Docker 镜像,否则它会浪费很长时间。
我一开始没有跟它说,结果它在这里编译了一个多小时,编译了两个小时都没有把这个东西编译好。后来我就问它:“你是不是智障?你上网去找一个就是了呀,你干嘛在这里编译呢?”这么一个礼貌的问候之后,它恍然大悟,然后很快就把它编译好了。这个步骤它执行得非常快,我可能去蹲了个坑,回来它就编译好了。
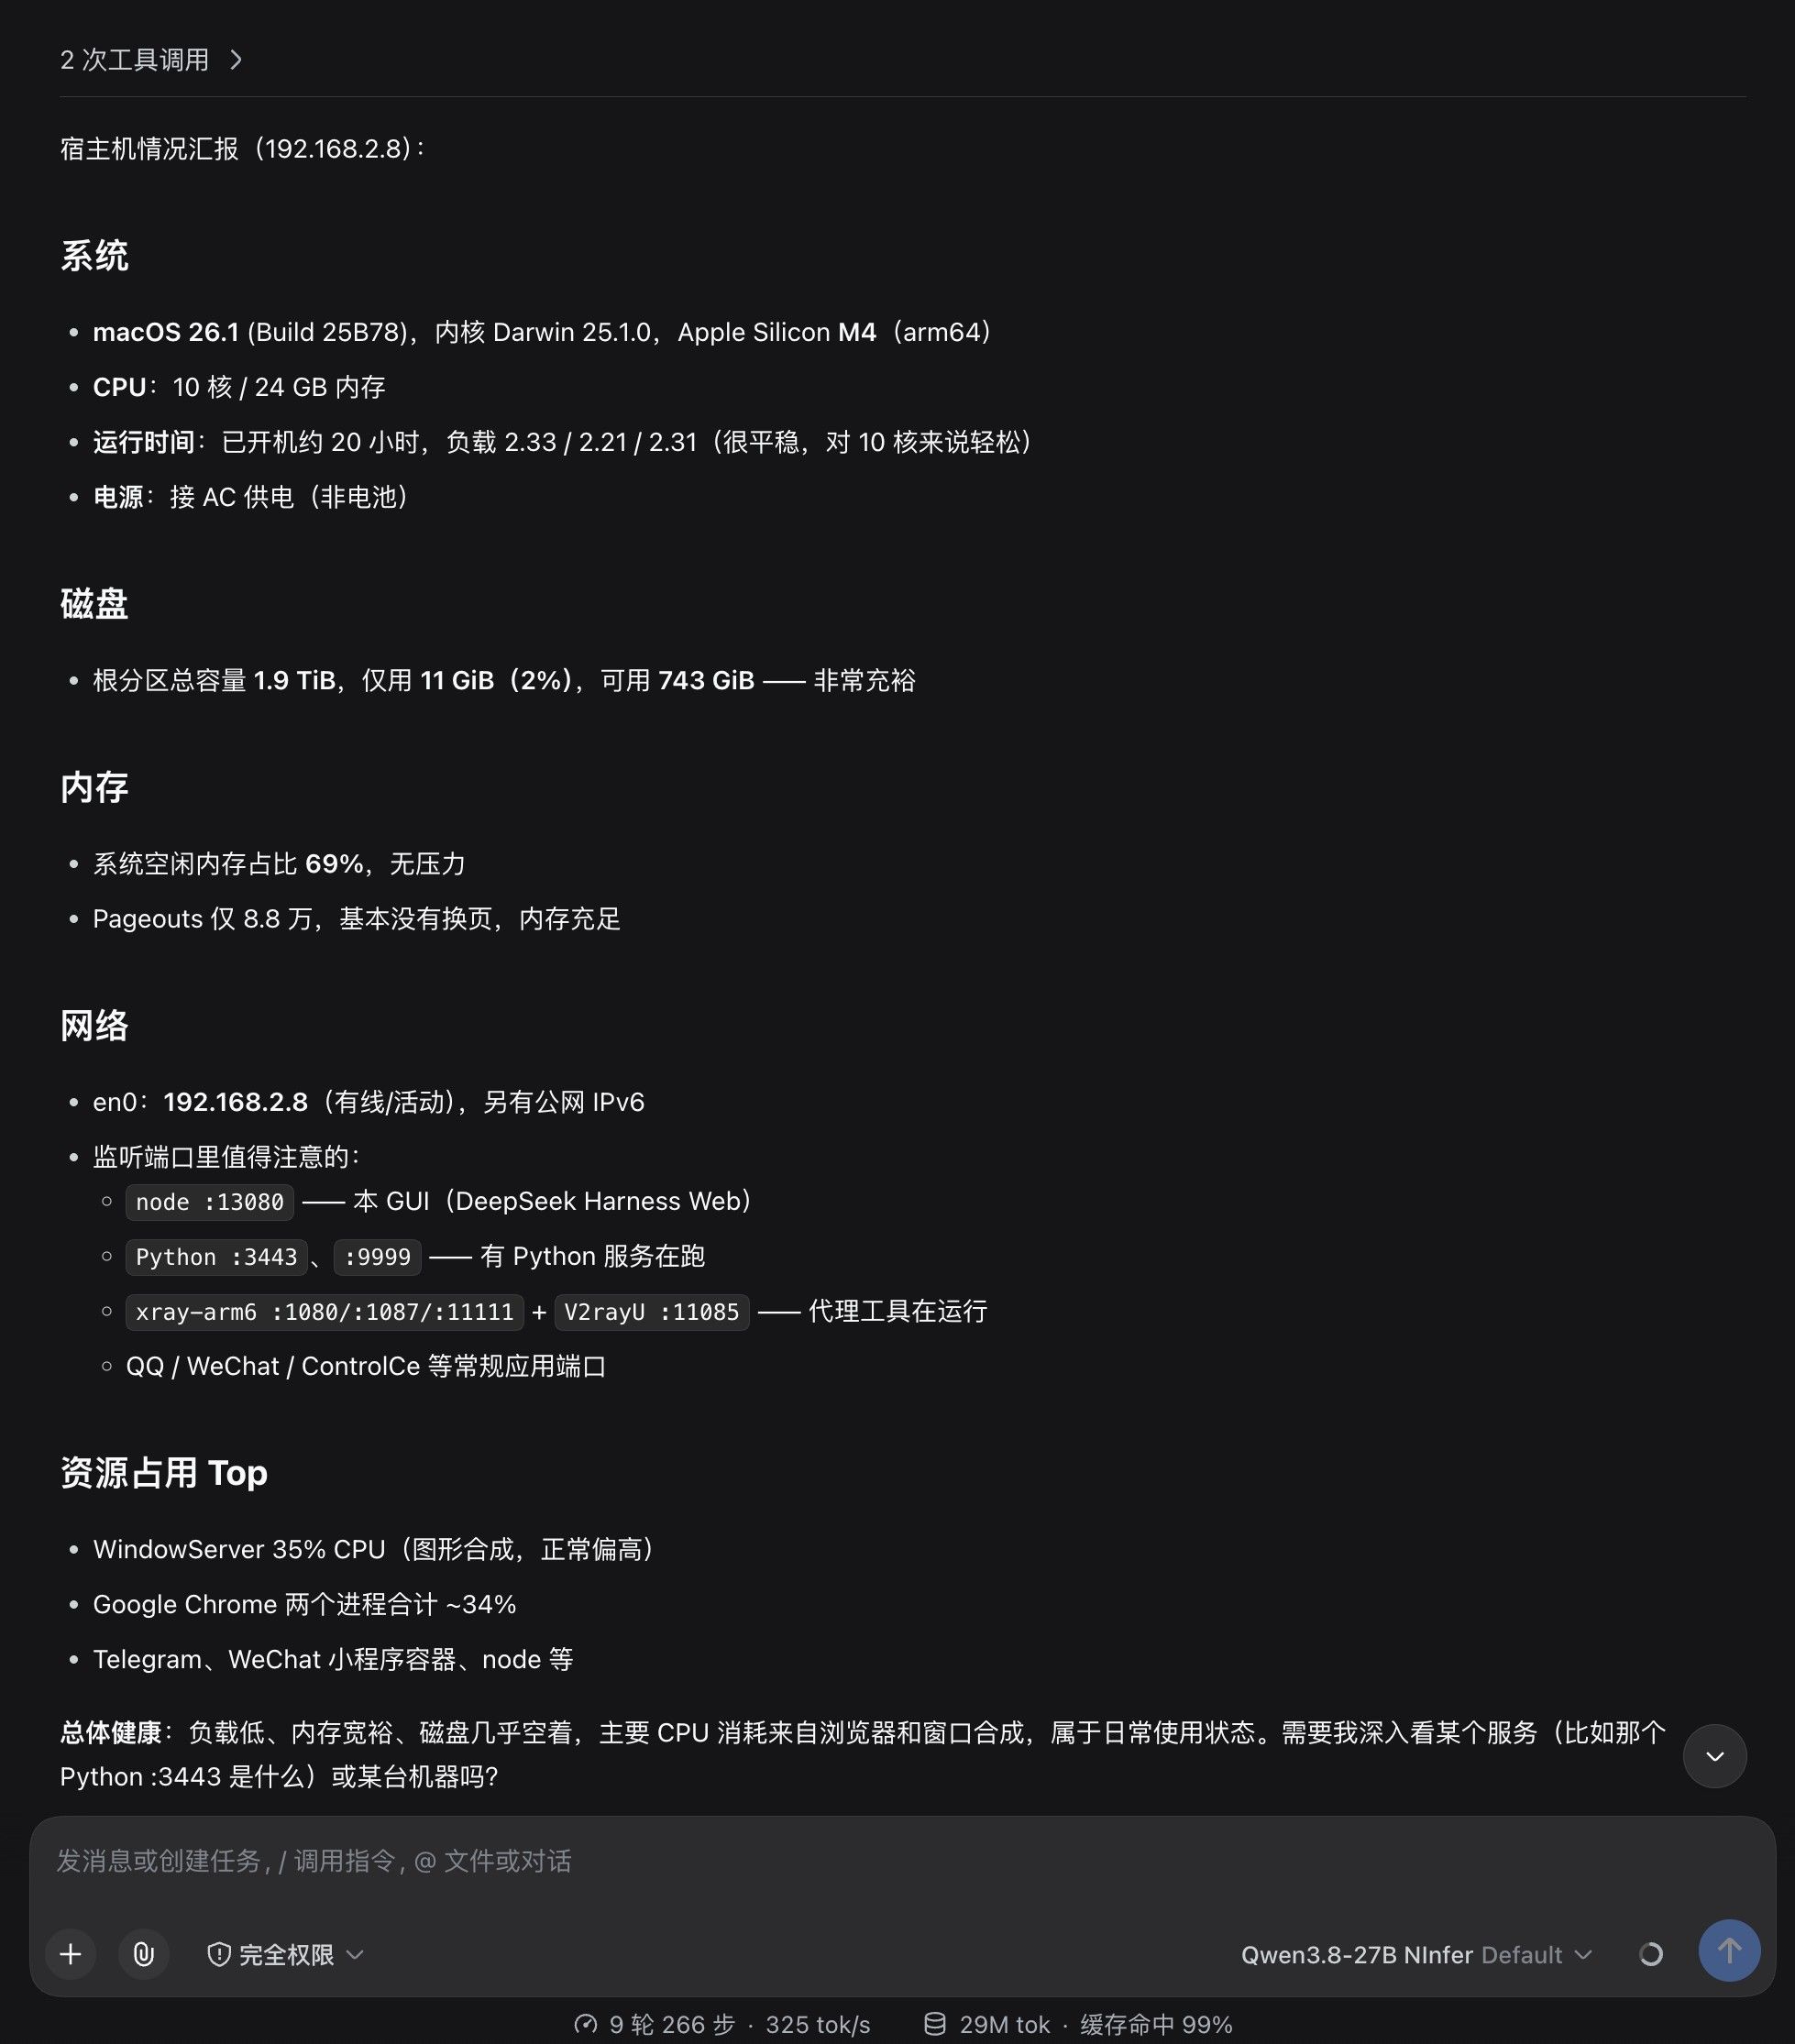
然后我让它接入 DeepSeek Harness,它就把它接进来了。接下来我对它进行测试。首先是常规的一些任务,让它汇报 DeepSeek Harness,也就是我现在这台苹果 M5 Mac mini 宿主机的情况。它给出的结果也非常准确。聊天的话,一开始启动的时候,你能感觉到这个推理框架本身响应非常敏捷。这跟 DeepSeek Harness 上下文注入得比较少也有关系。总归这是一个相互成就的事情。我现在已经很少用 Codex 和 Hermes 测试了,因为主力 Agent 已经换成了 DSH。
然后再让它到 2.9 这台服务器上去看看服务器的状况。NInfer 这个推理框架运行在我这台 192.168.2.9 的 Ubuntu Server 上,我让它去看了一下情况。它跟我说,系统的情况比较富裕,但是我经常用的两个 SGLang 服务都没开,尤其是我最常用的 AWQ DFlash2 模型没有开。但是它不是忘记了,而是不知道我现在驱动它用的不是 SGLang,而是 NInfer。告诉它之后,它就去查了一下服务器的状况,结论非常准确,然后就直接让它干活。
我不是做了一个视频吗?刚才我是让 Qwen3.8 27B 以及 DeepSeek V4 Flash 都给它做了一步修正,然后我把这个修正的内容藏起来了,让它到相应目录下重新做一次。怎么讲呢,它跟标准的 Qwen3.8 27B 比没有任何区别,也没有变聪明,也没有变笨,有些小的瑕疵都是一模一样的。你看,它厉害的地方就是,这么多字幕识别错误的地方,它全都能找出来,脏话该打码就打码。但是它也跟标准的 Qwen3.8 27B 一样,有一些地方识别得不太准确,它自己也拿不准。不过这两个没有处理的地方都是对的,基本上模型的质地没有提升。
你说工作的响应速度有没有提升?我认为比 SGLang 要快一点,因为这个任务本身上下文不长。但是它运行起来的噪音,也就是功耗消耗状况,完全不输给 SGLang,甚至比 SGLang 更严重。因为 SGLang 讲实话,在长上下文任务的时候,比如平时不是做这种字幕修正这种密集工作的任务,而是做论坛 APP 的检查,或者做一些增量的新任务、小任务,SGLang 的风扇是完全不响的。我这张 4090 48G 的风扇一点都不响,因为它有 DFlash2 的草稿小模型。小任务可能命中率比较高,然后运算量也不大。在这一块,SGLang 比 NInfer 要稍微强一点,但是我感觉如果是单任务的话,体验可能还是 NInfer 会更好一点。
下面测试一下它的多任务并发。我给聊天会话配置的是 DeepSeek V4 Flash,然后让 DeepSeek V4 Flash 做 4 路 60K 上下文模拟。本来我是认为它给我配置的是双并发,我让它发四路过去看看排队,但是我给它下达指令之后,它自己把配置改了,硬是用 4 并发同时喂进去。这一下子冷启动 Prefill 确实把它打爆了,它等了很长时间。它自己说是等了 150 多秒,报告就在这里,大家自己详细去看吧,我也不想研究这个东西。
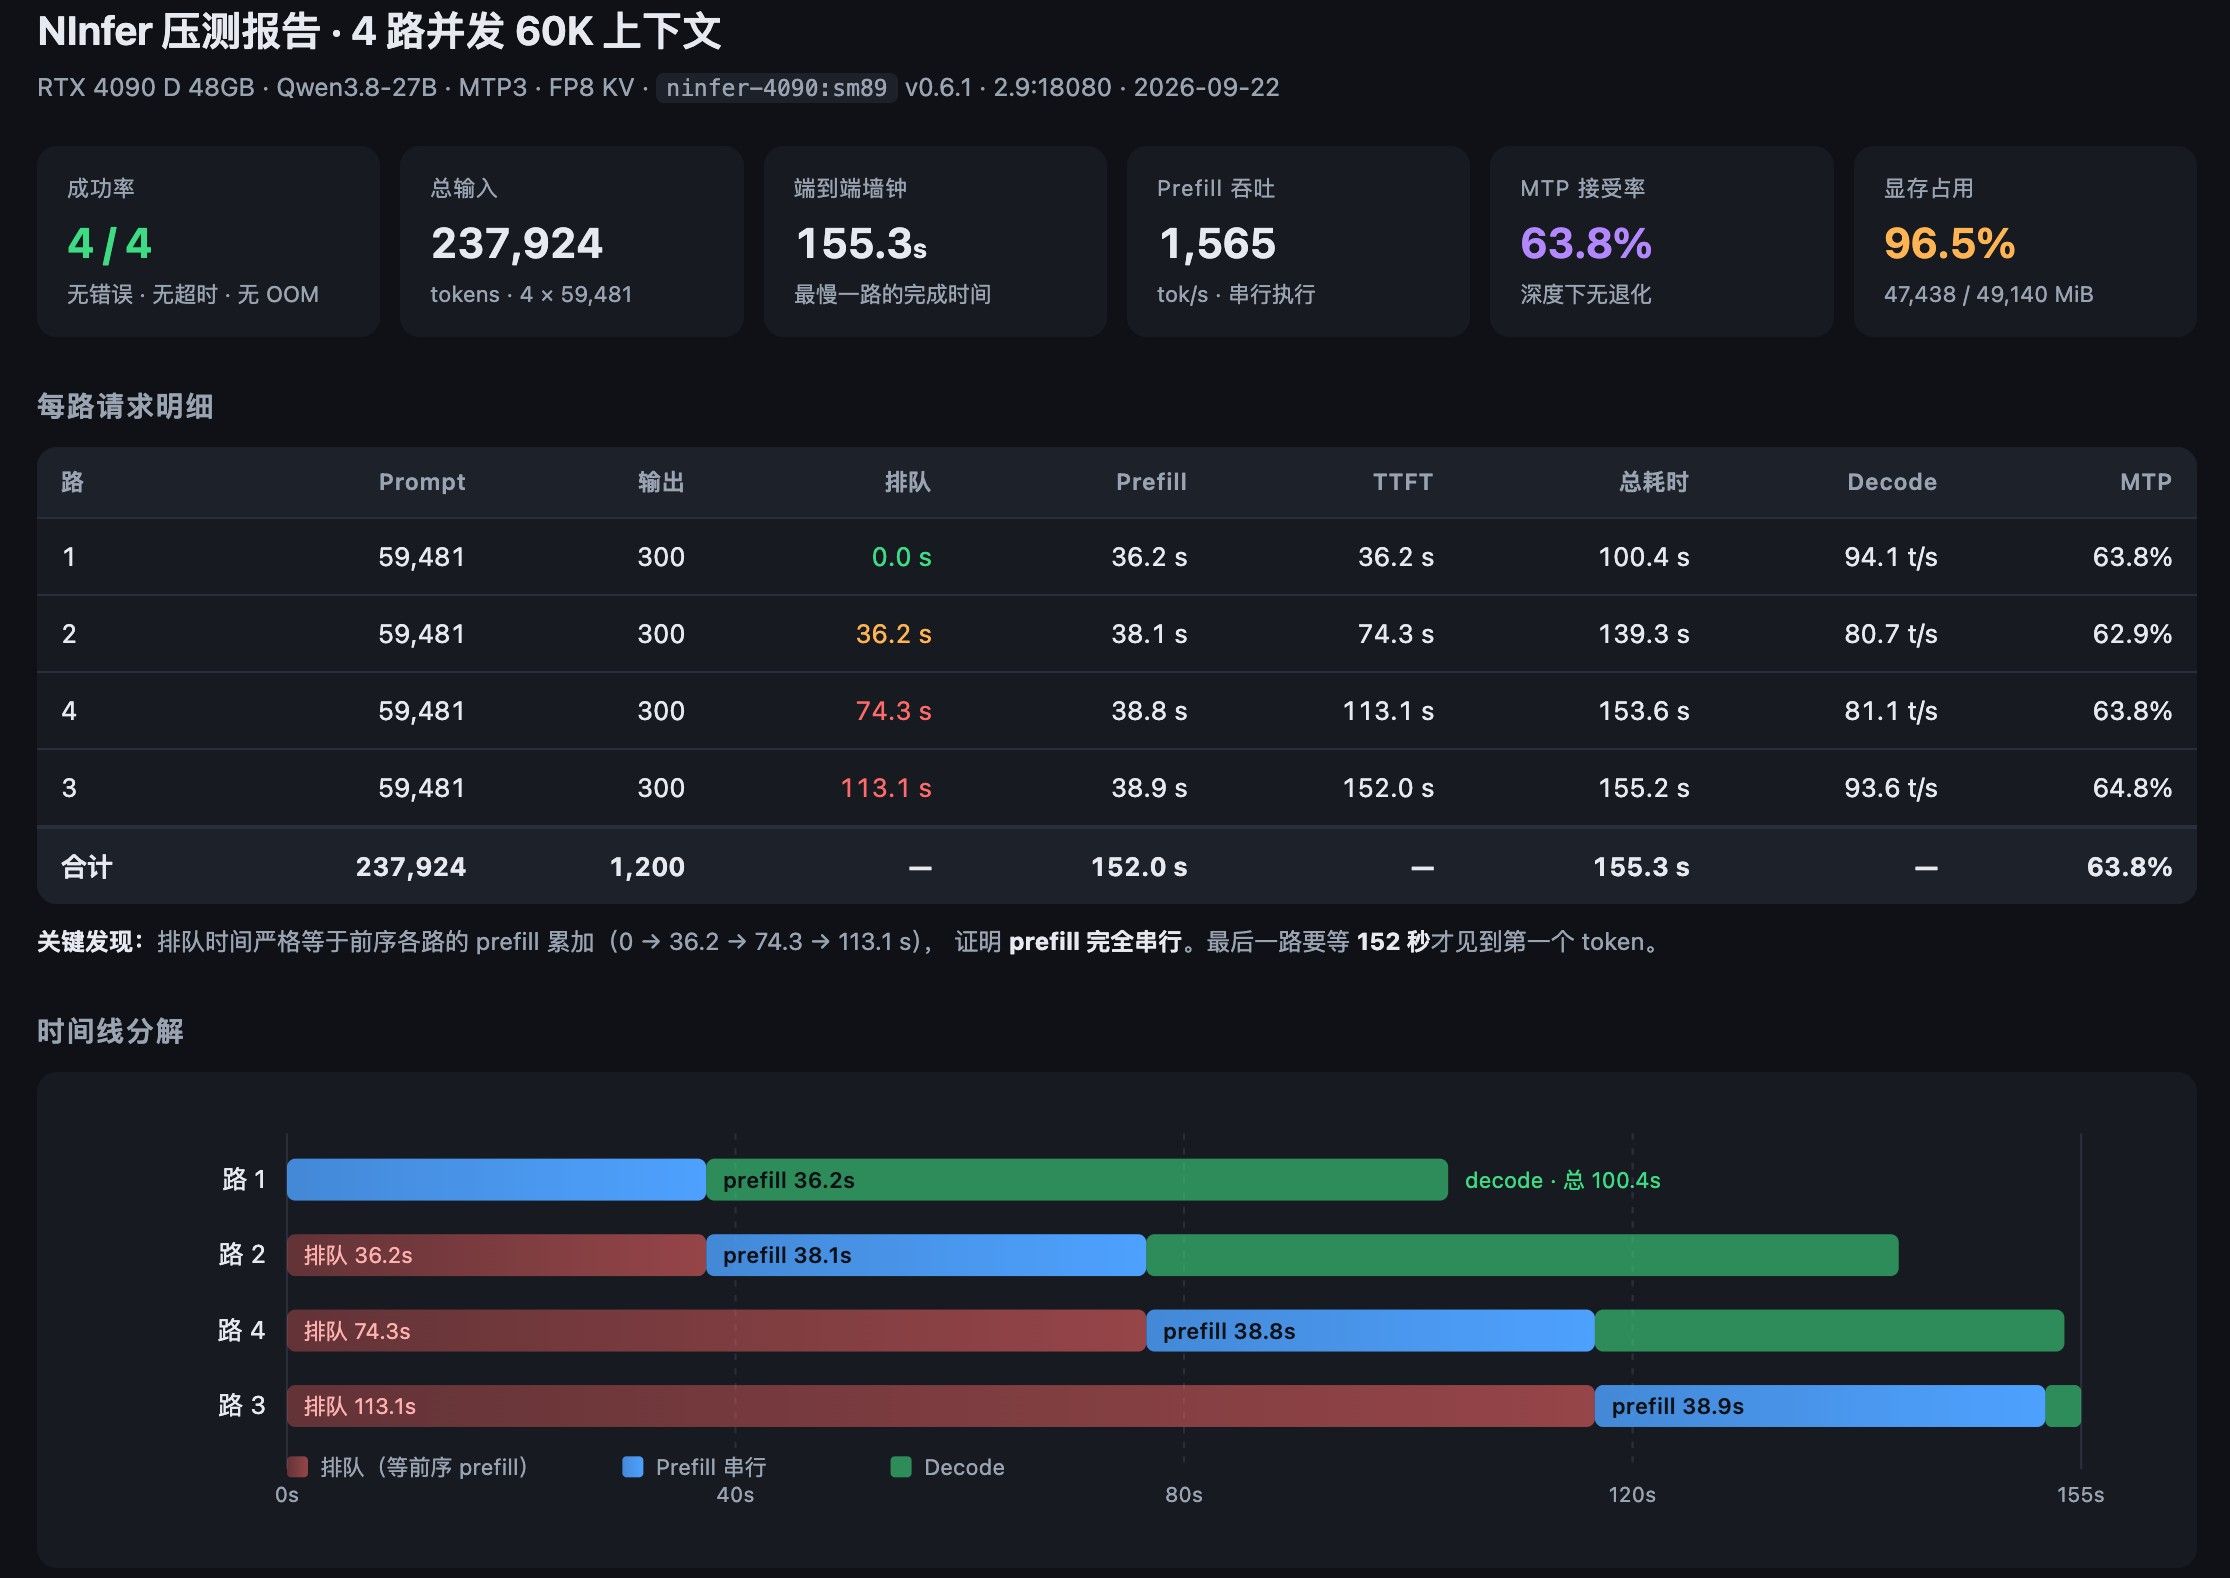
总体速度我认为处理得还是比较快的。如果执行单任务长链任务,那么它有类似 Redis 缓存树的增量 KV 缓存运行机制,只需要计算增量部分,这一点比 llama.cpp 更好。总体上我感觉它的 Prefill 时间还是可以的。Decode 压力大家可以看一下,60K 上下文的时候,基本能够维持在 80 到 90 tokens/s。
如果执行单任务,长上下文是 100K,上下文的首 Token 延迟是 1.7 秒,然后吐字速度是 281 tokens/s。这个可能有点误差,因为这是 DeepSeek Harness 统计的。这个响应速度,如果是单任务体验的话,我觉得确实要比 SGLang 更好一点。多并发我觉得可能 SGLang 要更好一点。但是在冷启动的情况下,响应被打爆,我觉得 SGLang 可能也会遇到同样的状况。
总之,有部分体验是确信比 SGLang 更好的。比 SGLang 更差的情况,暂时可能还不太明显,也不好确定,还需要长期使用和测试。反正它能干活了,我觉得这就挺好的。对于我来说,这个推理框架是可以替代 SGLang 的,而且部署起来相对比较简单。AI 只要你告诉它不要自己去编译 Docker 镜像,让它去找一个现成能用的镜像,它很快就能部署好。
这是它给出的报告,我一会儿会把报告放到论坛帖子中。大家有需要的,包括测试脚本、测试报告、测试工具和这些数据,我都会放到附件中,有需要的可以下载。
ninfer-report.html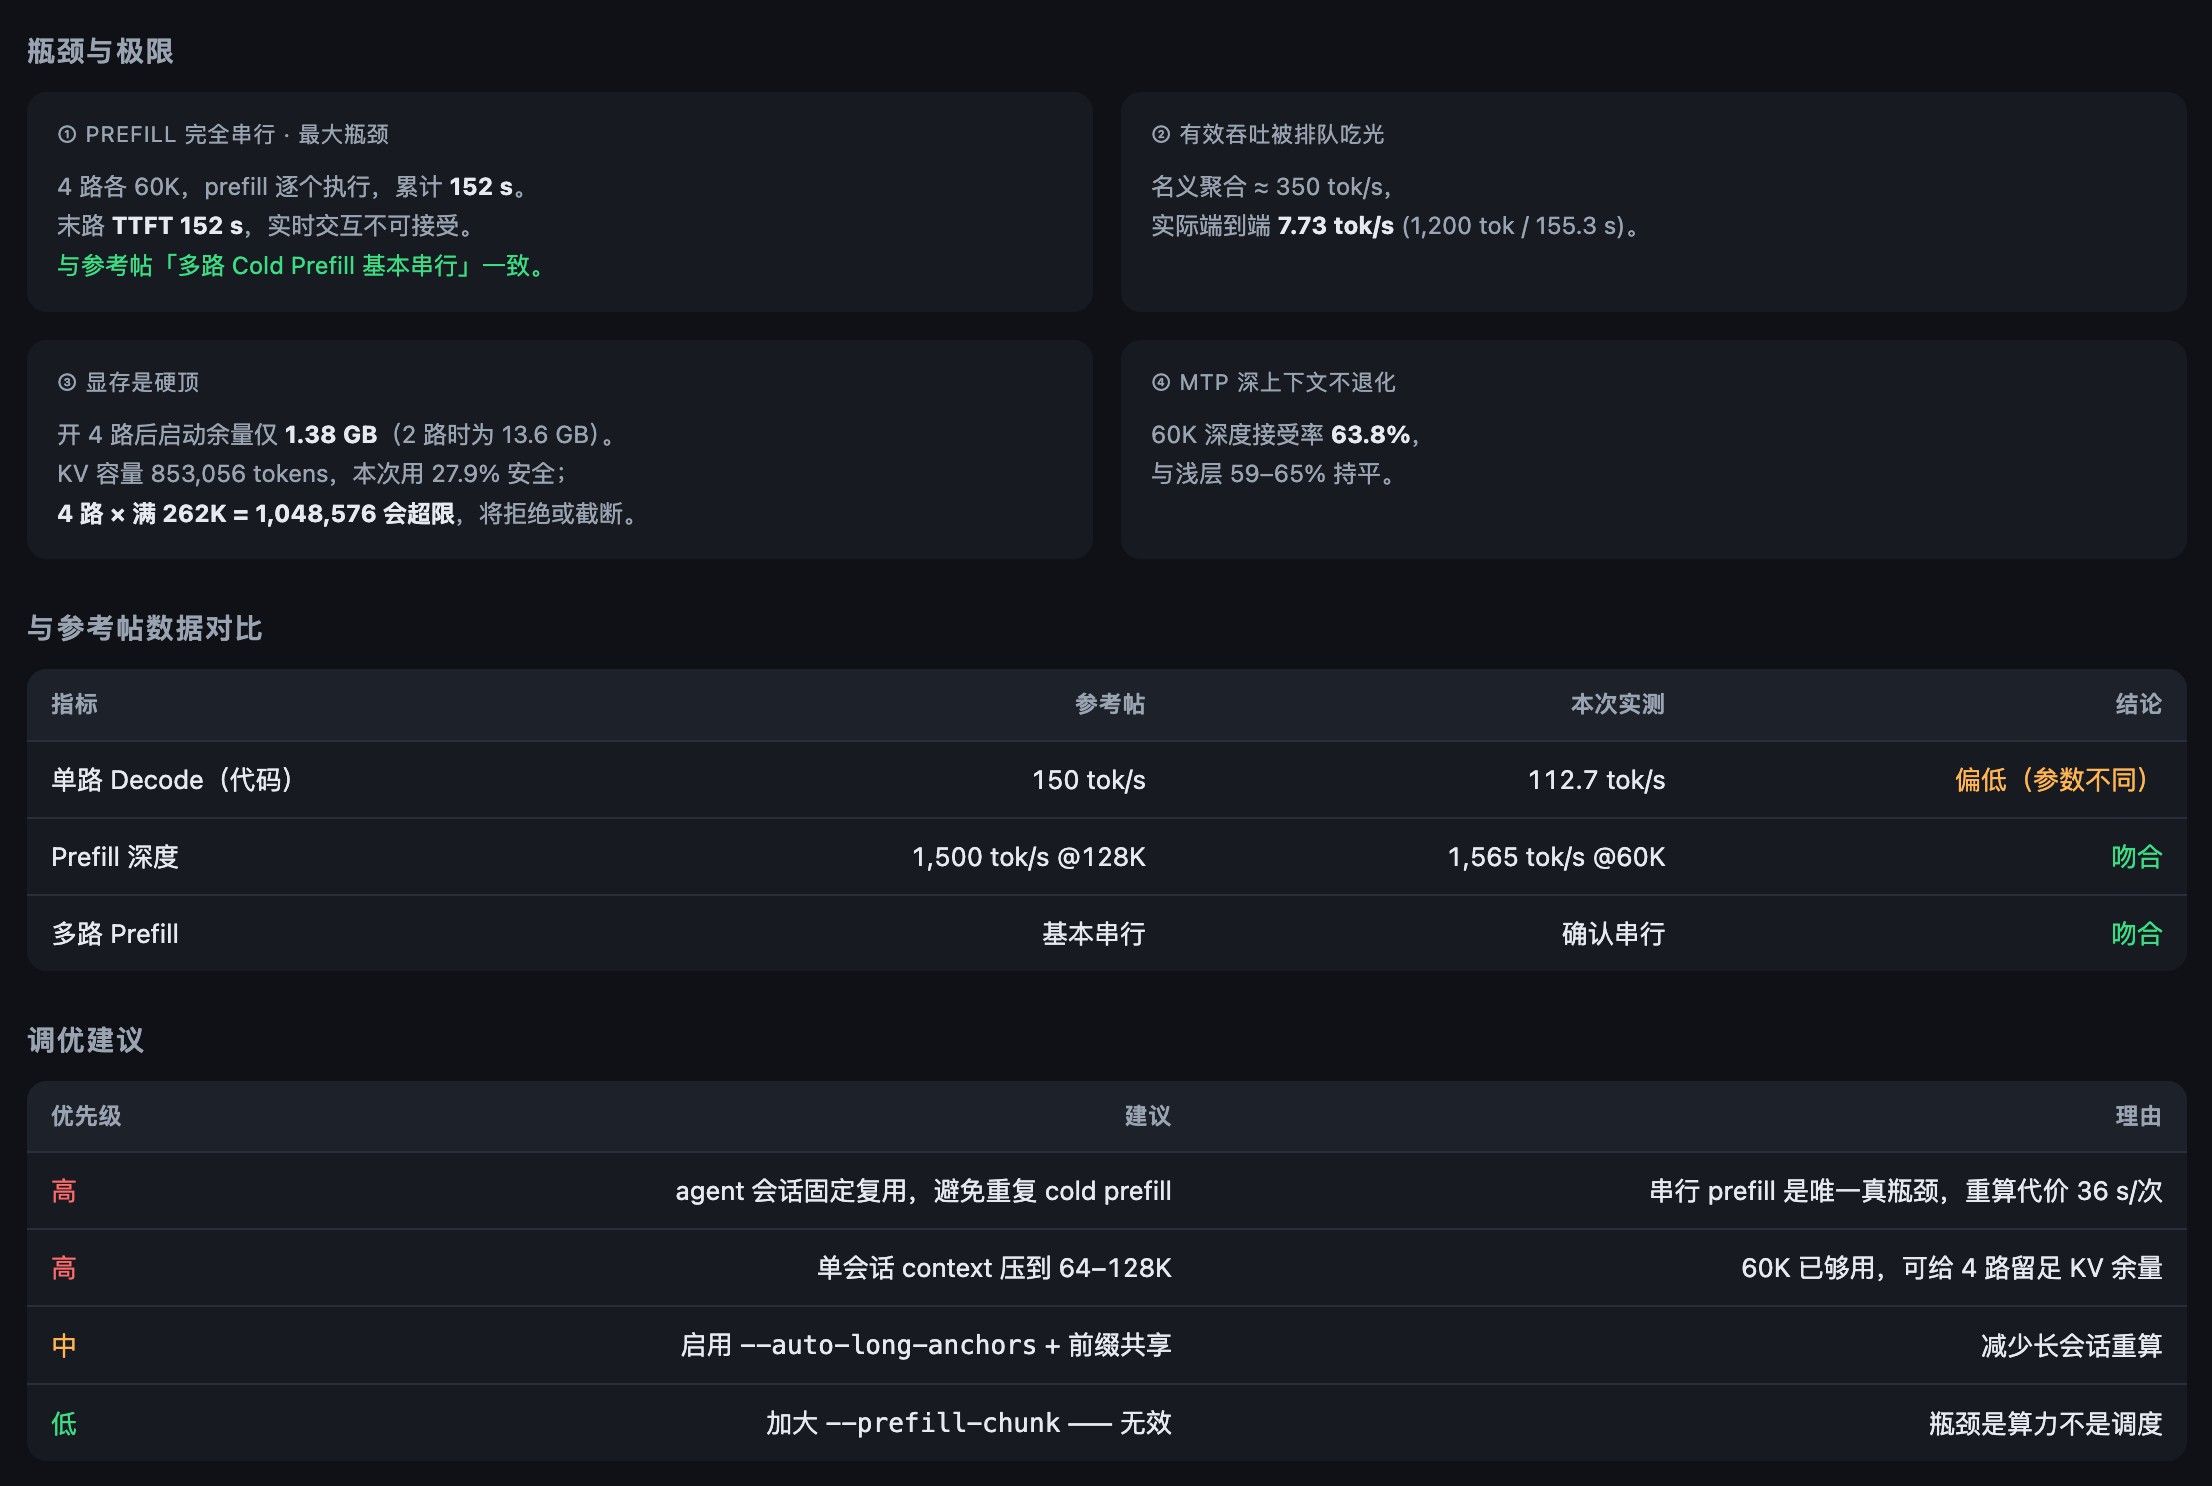
总体而言,它对 4090 48G 的意义可能不是特别大。对 RTX Pro 5000 也不是没有意义,只是没有 5090 和 3090 那么大。为什么呢?因为 32G 显存及以下的显卡,玩 SGLang 的话,显存跑多会话、长上下文是不够的,是有局限的。48G 显存基本上开三四个会话就完全没有什么问题,正常我们在本地用个三开、四开也就差不多了。不会有人长期有这种大任务,一定要开七八个会话,这种情况还是比较少的。
所以,如果你的显存比较紧张,不想让 SGLang 吃掉太多资源,当然前提是 N 卡,那么可以考虑 NInfer。它这个东西是专卡专用的。像我这次找的社区版本,我用的是 4090,就要找 4090 的版本。社区已经有人找到了 3090 的版本,而且已经跑起来了。我们看看 NInfer 这个标签,大家看到没有,3090、5090,然后 4090,刚好三个帖子。所以我说,这个社区还是有意义的。
大家也不要觉得我什么都懂,或者什么都玩在前面。其实我这个人相对而言是比较滞后的,因为我每天要做大量视频,要做好几个油管频道,每天都比较忙,而且还得开发论坛 APP,有时候还得接一些客户的单子。讲实话,我是要赚钱的,要赚钱养家糊口。所以我并没有玩得那么时髦、那么前沿。
论坛有很多大神还是比我会玩的,也有很多新的东西出来。讲实话,我这些素材都做不完。我不像其他博主,需要专门去找素材来做。论坛随便找几个帖子出来,比如 7900 XTX 双卡怎么配,R9700 双卡怎么配,有哪些坑;包括显卡坏了之后有哪些坑,在闲鱼上买的卡,维权的时候有哪些坑,都会有人发。这些网友分享的经验教训,对于有类似问题的人来说,参考价值是非常大的。
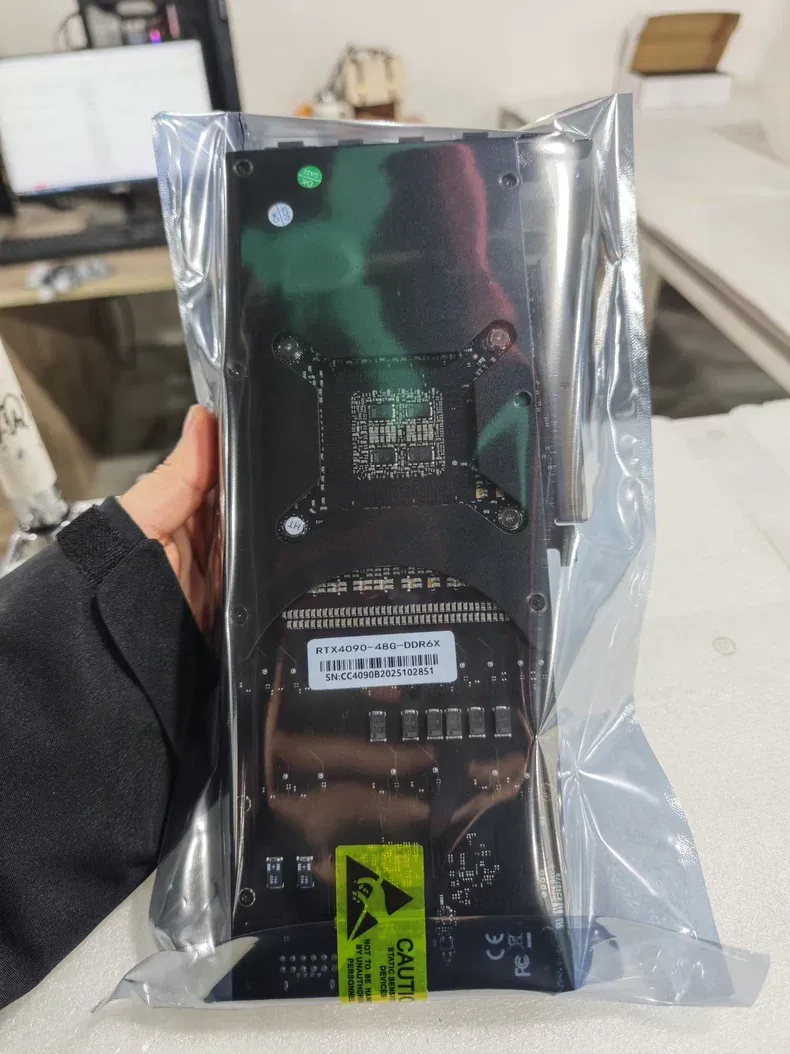
总之,如果你手里有 3090、4090、4080S 32G 或者 5090 这些显卡,可以去社区找一找对应的 NVIDIA 版本。前一段时间 AMD 不是因为 HaloGen 这个推理框架火了一阵子吗?抢了一些 N 卡的流量。现在我相信 NInfer 出来之后,可能 N 卡又是笑到最后,毕竟生态最好。
在上一个视频中,我刚刚喷过英特尔。英特尔如果知耻而后勇,就应该去搞一个 IInfer,也把自己的生态打起来。吹牛是没有用的。
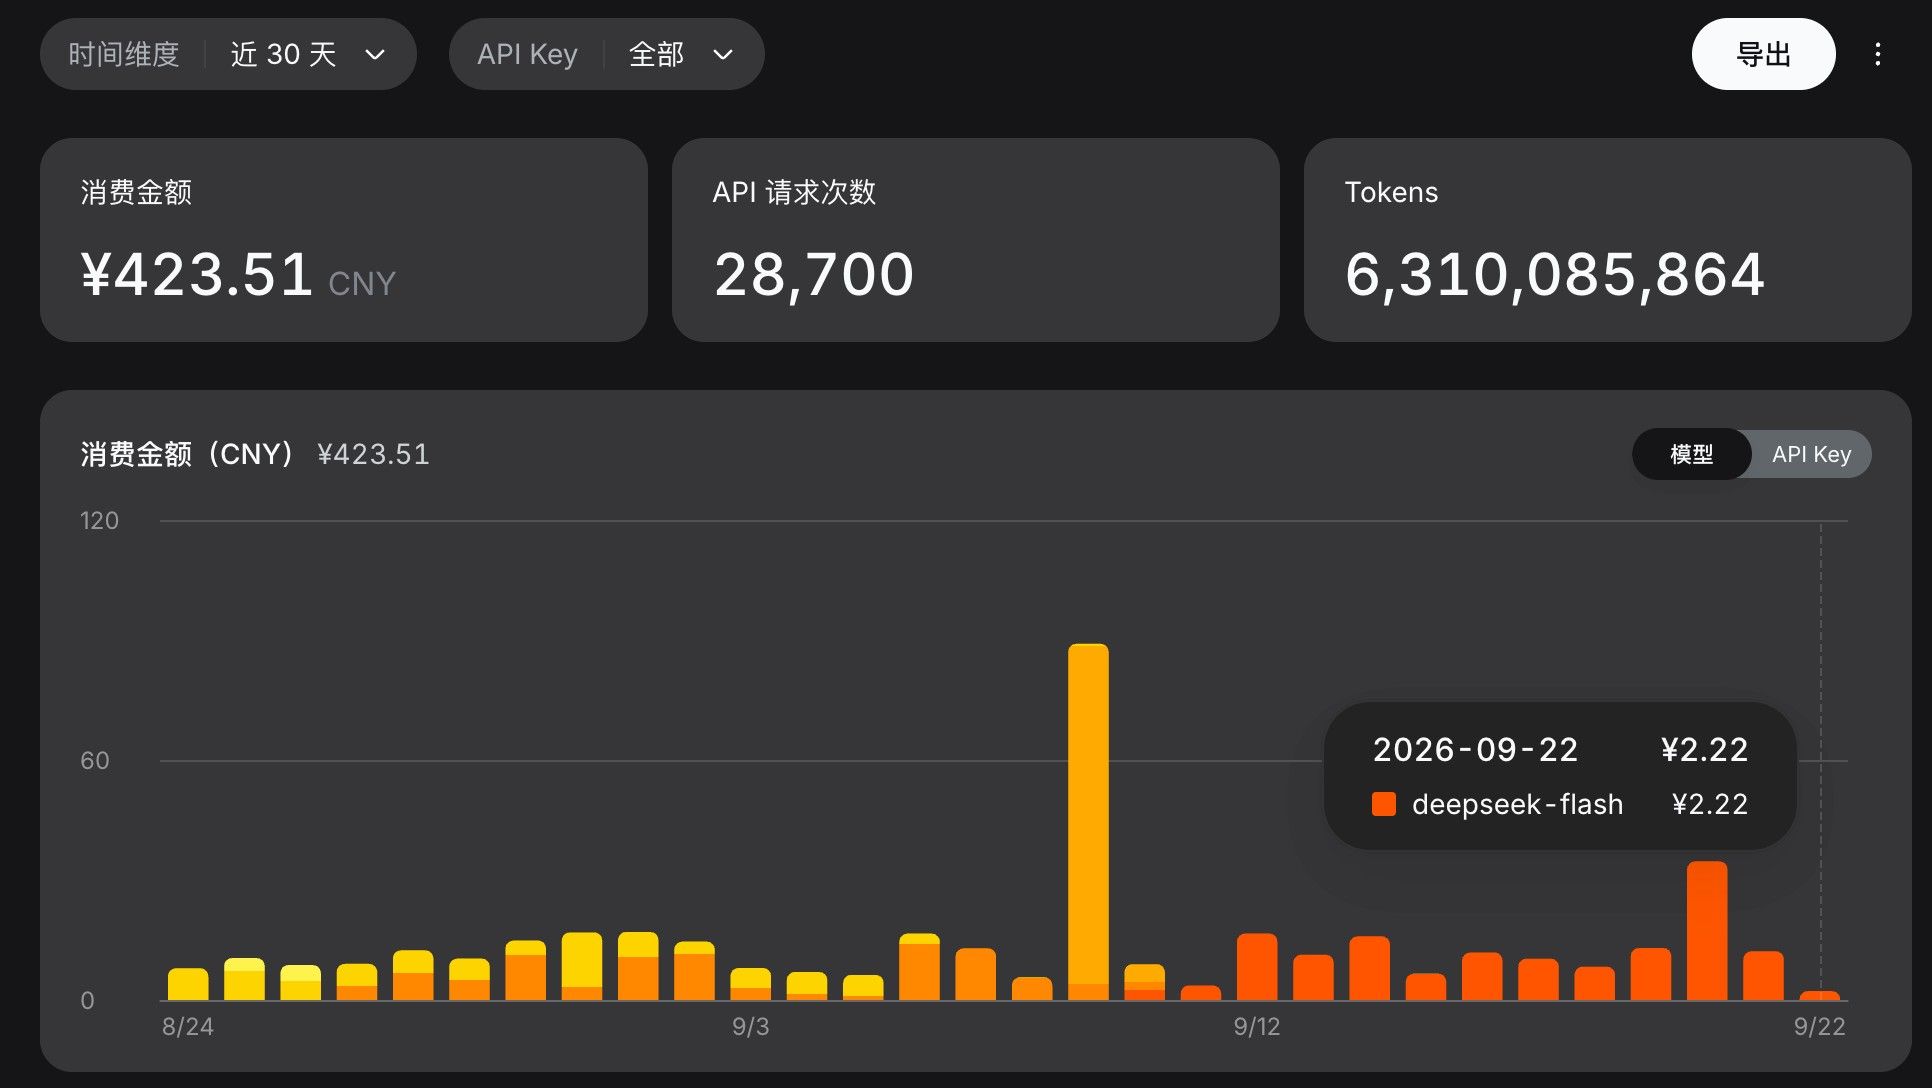
最后总结一下,今天凌晨到现在,我一共花了 2 块 2 毛 2。这个数字还真的够“2”的,比较符合我的性格。第一是配置 NInfer 这个推理框架,然后做了一些测试;第二是论坛的一些日常维护。每天凌晨都有审计,我的虚拟助手会审计云端小特的工作状况。云端用的是 DeepSeek Harness,当然云端 DeepSeek Harness 的工作也是由 DeepSeek 驱动的,工作量还是不小的。另外,它还给小特修复了一个视频的字幕,因为我要做对比。一共花了 2 块 2 毛 2。我相信这个成本低不低,大家心中自有杆秤。
在这种情况下,有很多人就比较犹豫,到底要不要部署本地的 AI 大模型。还是那句话,如果你没有隐私需求,也没有大量执行本地任务的需求,比如一些非重复的数据清洗之类的任务,而且你不玩 AI 音视频、画图,那么你就直接用在线的 DeepSeek V4 Flash 就行了。
但如果你有本地隐私的需求,就像前一阵子 Codex 前几天盗用大家的代码一样;如果你有这种保密方面的需求,或者有去审查的需求,需要干一些非常重的搬砖任务,那么在本地部署还是有价值的。
而且现在本地部署,讲实话,无论是智能水平还是体验,它的速度和效率其实都挺能打的,已经不是玩具了,真的。你说本地的 Qwen3.8 跟 DeepSeek V4 Flash,我认为差距是不大的,跟 V4.1 的差距有点大,但是没有大到 V4.1 Flash 能工作,而 Qwen3.8 不能工作的程度,还没有达到这种情况。
-
我移植到我的A40上了!
https://github.com/tctiger/ninfer-A40 -
论坛陆续有几个帖子谈到 NInfer 这个推理框架。应该是读 NInfer 吧,不知道要不要连读,就先这样读吧。这个推理框架对于压榨 32G 显存及以下,包括 24G 显存显卡的性能,有很大的帮助。就是说,这玩意现在效率挺高的。
它的作者好像是只针对 5090 做了优化,但是社区有 NInfer 的 4090 版本。我就把它下载下来测试了一下。因为这个东西最近讨论得比较多,非常流行,很多人在 3090 上也把它复现了。大家都说效率提升蛮大的,但是可能做多任务还是不如 SGLang。我长期在本地部署 SGLang,并且每天用它干活,所以我想在同一台服务器上,用同一张显卡把它部署好,对比一下。这应该是有一定参照价值的。
首先,做法其实很简单。大家到论坛找到这个帖子,我会在评论区下方留链接,也会在我的帖子中贴入原帖链接。实际上你找 1803 号帖子就行了。然后把地址粘贴给你的 AI Agent,让它来抄作业。但是你要告诉它,不要在本地自己编译 Docker 镜像,让它在网上找一个直接能用的 Docker 镜像,否则它会浪费很长时间。
我一开始没有跟它说,结果它在这里编译了一个多小时,编译了两个小时都没有把这个东西编译好。后来我就问它:“你是不是智障?你上网去找一个就是了呀,你干嘛在这里编译呢?”这么一个礼貌的问候之后,它恍然大悟,然后很快就把它编译好了。这个步骤它执行得非常快,我可能去蹲了个坑,回来它就编译好了。
然后我让它接入 DeepSeek Harness,它就把它接进来了。接下来我对它进行测试。首先是常规的一些任务,让它汇报 DeepSeek Harness,也就是我现在这台苹果 M5 Mac mini 宿主机的情况。它给出的结果也非常准确。聊天的话,一开始启动的时候,你能感觉到这个推理框架本身响应非常敏捷。这跟 DeepSeek Harness 上下文注入得比较少也有关系。总归这是一个相互成就的事情。我现在已经很少用 Codex 和 Hermes 测试了,因为主力 Agent 已经换成了 DSH。
然后再让它到 2.9 这台服务器上去看看服务器的状况。NInfer 这个推理框架运行在我这台 192.168.2.9 的 Ubuntu Server 上,我让它去看了一下情况。它跟我说,系统的情况比较富裕,但是我经常用的两个 SGLang 服务都没开,尤其是我最常用的 AWQ DFlash2 模型没有开。但是它不是忘记了,而是不知道我现在驱动它用的不是 SGLang,而是 NInfer。告诉它之后,它就去查了一下服务器的状况,结论非常准确,然后就直接让它干活。
我不是做了一个视频吗?刚才我是让 Qwen3.8 27B 以及 DeepSeek V4 Flash 都给它做了一步修正,然后我把这个修正的内容藏起来了,让它到相应目录下重新做一次。怎么讲呢,它跟标准的 Qwen3.8 27B 比没有任何区别,也没有变聪明,也没有变笨,有些小的瑕疵都是一模一样的。你看,它厉害的地方就是,这么多字幕识别错误的地方,它全都能找出来,脏话该打码就打码。但是它也跟标准的 Qwen3.8 27B 一样,有一些地方识别得不太准确,它自己也拿不准。不过这两个没有处理的地方都是对的,基本上模型的质地没有提升。
你说工作的响应速度有没有提升?我认为比 SGLang 要快一点,因为这个任务本身上下文不长。但是它运行起来的噪音,也就是功耗消耗状况,完全不输给 SGLang,甚至比 SGLang 更严重。因为 SGLang 讲实话,在长上下文任务的时候,比如平时不是做这种字幕修正这种密集工作的任务,而是做论坛 APP 的检查,或者做一些增量的新任务、小任务,SGLang 的风扇是完全不响的。我这张 4090 48G 的风扇一点都不响,因为它有 DFlash2 的草稿小模型。小任务可能命中率比较高,然后运算量也不大。在这一块,SGLang 比 NInfer 要稍微强一点,但是我感觉如果是单任务的话,体验可能还是 NInfer 会更好一点。
下面测试一下它的多任务并发。我给聊天会话配置的是 DeepSeek V4 Flash,然后让 DeepSeek V4 Flash 做 4 路 60K 上下文模拟。本来我是认为它给我配置的是双并发,我让它发四路过去看看排队,但是我给它下达指令之后,它自己把配置改了,硬是用 4 并发同时喂进去。这一下子冷启动 Prefill 确实把它打爆了,它等了很长时间。它自己说是等了 150 多秒,报告就在这里,大家自己详细去看吧,我也不想研究这个东西。
总体速度我认为处理得还是比较快的。如果执行单任务长链任务,那么它有类似 Redis 缓存树的增量 KV 缓存运行机制,只需要计算增量部分,这一点比 llama.cpp 更好。总体上我感觉它的 Prefill 时间还是可以的。Decode 压力大家可以看一下,60K 上下文的时候,基本能够维持在 80 到 90 tokens/s。
如果执行单任务,长上下文是 100K,上下文的首 Token 延迟是 1.7 秒,然后吐字速度是 281 tokens/s。这个可能有点误差,因为这是 DeepSeek Harness 统计的。这个响应速度,如果是单任务体验的话,我觉得确实要比 SGLang 更好一点。多并发我觉得可能 SGLang 要更好一点。但是在冷启动的情况下,响应被打爆,我觉得 SGLang 可能也会遇到同样的状况。
总之,有部分体验是确信比 SGLang 更好的。比 SGLang 更差的情况,暂时可能还不太明显,也不好确定,还需要长期使用和测试。反正它能干活了,我觉得这就挺好的。对于我来说,这个推理框架是可以替代 SGLang 的,而且部署起来相对比较简单。AI 只要你告诉它不要自己去编译 Docker 镜像,让它去找一个现成能用的镜像,它很快就能部署好。
这是它给出的报告,我一会儿会把报告放到论坛帖子中。大家有需要的,包括测试脚本、测试报告、测试工具和这些数据,我都会放到附件中,有需要的可以下载。
ninfer-report.html总体而言,它对 4090 48G 的意义可能不是特别大。对 RTX Pro 5000 也不是没有意义,只是没有 5090 和 3090 那么大。为什么呢?因为 32G 显存及以下的显卡,玩 SGLang 的话,显存跑多会话、长上下文是不够的,是有局限的。48G 显存基本上开三四个会话就完全没有什么问题,正常我们在本地用个三开、四开也就差不多了。不会有人长期有这种大任务,一定要开七八个会话,这种情况还是比较少的。
所以,如果你的显存比较紧张,不想让 SGLang 吃掉太多资源,当然前提是 N 卡,那么可以考虑 NInfer。它这个东西是专卡专用的。像我这次找的社区版本,我用的是 4090,就要找 4090 的版本。社区已经有人找到了 3090 的版本,而且已经跑起来了。我们看看 NInfer 这个标签,大家看到没有,3090、5090,然后 4090,刚好三个帖子。所以我说,这个社区还是有意义的。
大家也不要觉得我什么都懂,或者什么都玩在前面。其实我这个人相对而言是比较滞后的,因为我每天要做大量视频,要做好几个油管频道,每天都比较忙,而且还得开发论坛 APP,有时候还得接一些客户的单子。讲实话,我是要赚钱的,要赚钱养家糊口。所以我并没有玩得那么时髦、那么前沿。
论坛有很多大神还是比我会玩的,也有很多新的东西出来。讲实话,我这些素材都做不完。我不像其他博主,需要专门去找素材来做。论坛随便找几个帖子出来,比如 7900 XTX 双卡怎么配,R9700 双卡怎么配,有哪些坑;包括显卡坏了之后有哪些坑,在闲鱼上买的卡,维权的时候有哪些坑,都会有人发。这些网友分享的经验教训,对于有类似问题的人来说,参考价值是非常大的。
总之,如果你手里有 3090、4090、4080S 32G 或者 5090 这些显卡,可以去社区找一找对应的 NVIDIA 版本。前一段时间 AMD 不是因为 HaloGen 这个推理框架火了一阵子吗?抢了一些 N 卡的流量。现在我相信 NInfer 出来之后,可能 N 卡又是笑到最后,毕竟生态最好。
在上一个视频中,我刚刚喷过英特尔。英特尔如果知耻而后勇,就应该去搞一个 IInfer,也把自己的生态打起来。吹牛是没有用的。
最后总结一下,今天凌晨到现在,我一共花了 2 块 2 毛 2。这个数字还真的够“2”的,比较符合我的性格。第一是配置 NInfer 这个推理框架,然后做了一些测试;第二是论坛的一些日常维护。每天凌晨都有审计,我的虚拟助手会审计云端小特的工作状况。云端用的是 DeepSeek Harness,当然云端 DeepSeek Harness 的工作也是由 DeepSeek 驱动的,工作量还是不小的。另外,它还给小特修复了一个视频的字幕,因为我要做对比。一共花了 2 块 2 毛 2。我相信这个成本低不低,大家心中自有杆秤。
在这种情况下,有很多人就比较犹豫,到底要不要部署本地的 AI 大模型。还是那句话,如果你没有隐私需求,也没有大量执行本地任务的需求,比如一些非重复的数据清洗之类的任务,而且你不玩 AI 音视频、画图,那么你就直接用在线的 DeepSeek V4 Flash 就行了。
但如果你有本地隐私的需求,就像前一阵子 Codex 前几天盗用大家的代码一样;如果你有这种保密方面的需求,或者有去审查的需求,需要干一些非常重的搬砖任务,那么在本地部署还是有价值的。
而且现在本地部署,讲实话,无论是智能水平还是体验,它的速度和效率其实都挺能打的,已经不是玩具了,真的。你说本地的 Qwen3.8 跟 DeepSeek V4 Flash,我认为差距是不大的,跟 V4.1 的差距有点大,但是没有大到 V4.1 Flash 能工作,而 Qwen3.8 不能工作的程度,还没有达到这种情况。
说白了单并发还是慢, 要想干活就尽量把一个任务拆解成多并发去做。研究这个方法和工作流才有实际的意义。
-
ninfer真的好用....可惜在單卡與nvfp4效能較佳,不過已經有人開發ninfer變形項目,支援雙卡....整個效能又炸到了另一個層次 wamansou/ninfer-tp2-1m (github)
@David-Chen TP2 加 MTP 不够快基本是预期内的,两点:
- 27B NVFP4 权重只有 15 到 16G,单张 4090D 48G 完全放得下。decode 是显存带宽受限,每 token 要读一遍权重,TP2 把权重切两半、每卡读一半,但每层要多一次 all-reduce;消费卡没有 NVLink,走 PCIe 的 all-reduce 在 batch=1 时是纯开销,很容易把省下的带宽吃回去。
- MTP 是投机解码,收益等于接受率减去草稿与验证成本。TP2 下验证那一步也要参与 all-reduce,draft/verify 通信更频繁,净收益比单卡更小。
所以 ninfer 单卡加 NVFP4 最快是合理的:容量够、没有跨卡通信。TP2 真正有意义是两种情况,一是单卡装不下,二是要高并发、大 batch 服务多请求,靠分摊算力和连续批处理才划得来,前提是 P2P 真开(topo -m、rccl-tests,别退化成 host-staged)。
建议让 ninfer-tp2 作者补一组同 KV dtype、同上下文、同 batch 的单卡对比 TP2 的 pp/tg 曲线和并发曲线,再看 df2 值不值得等。




