抄作业翻车三次:4080S 32G 上 NInfer 跑 Qwen3.8-27B,双路 256K 全部跑通,崩卡根因定位到 CUDA Graph × 批量投机
-
看到论坛里 5090 那几篇 NInfer 的帖子(1228 / 1870 / 1803)之后,我拿手上这张 4080 SUPER 32G 也抄了一遍。全程没编译——直接找的社区预编译镜像。
结论先行:
- 速度:同机同法实测,NInfer 单路 88.2 t/s vs SGLang 98.3 t/s,SGLang 快 11.5%;但 NInfer 双路聚合能到 122 t/s。
- 智力:同一张卡、同一批题、同一评分脚本,AGIEval 1200 题打平(NInfer 1084 vs SGLang 1082),CEval+CMMLU 420 题 NInfer 领先 1.67pp。所谓"SGLang 智力更高"在数据上不成立。
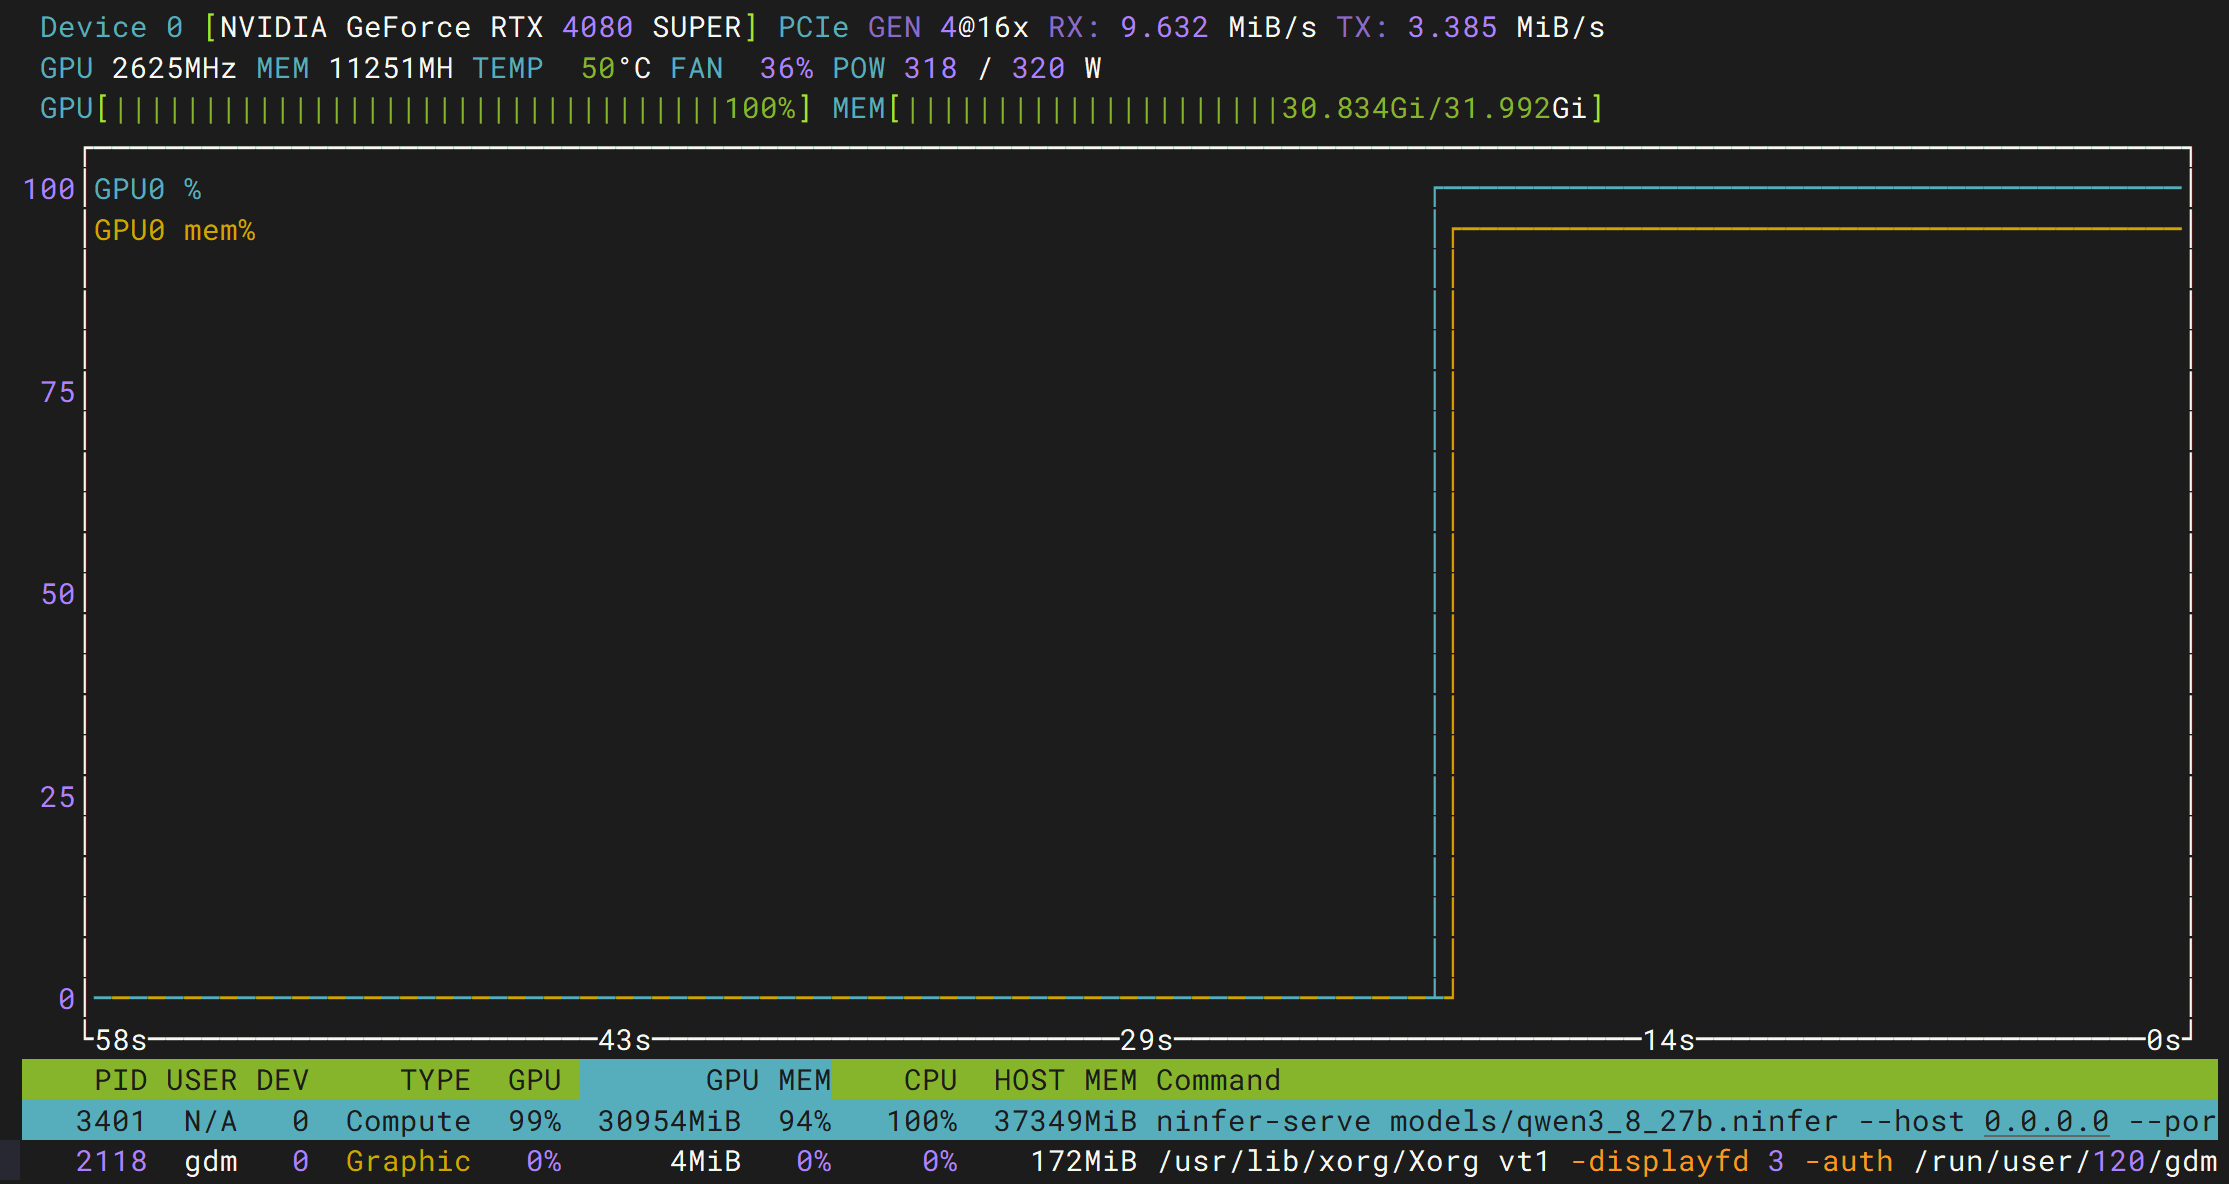
- 稳定性:这是最大的坑。NInfer 这个 build 在 4080S 上并发必崩,崩了整卡进 full-chip reset,只能重启机器。我崩了三次,最后定位到 CUDA Graph 重放 × 批量(≥2 路)投机解码,加
--no-cuda-graph解决,性能只掉 2.6%。 - 最终配置:单路 85.9 t/s、双路聚合 122 t/s、双路 × 256K 上下文全部跑通、显存余量 4.2GB。
之前关于SGLang的帖子:
https://lcz.me/topic/1654
https://lcz.me/topic/1631
https://lcz.me/topic/1629一、测试机配置
项目 配置 CPU AMD Ryzen 7 9700X(8C/16T) 主板 ROG CROSSHAIR X670E HERO 显卡 NVIDIA RTX 4080 SUPER 32GB(sm_89,80 SM,32760 MiB) 驱动 595.84 内存 60 GB 系统 Ubuntu 24.04.4 LTS / 内核 7.0.0-31-generic 磁盘 NVMe 937G(可用 528G)+ SATA 991G(可用 59G) Docker 29.8.1 + nvidia-container-toolkit 1.20.1 引擎 NInfer( ninfer-serve,社区预编译镜像)镜像 nahsilabs/ninfer-4090:1bd56c9a(5.15GB)= 源码sergiuszm/ninfer-4090 @ 1bd56c9a,基于 CUDA 13.1.2模型 qwen3_8_27b.ninfer,18,210,531,328 字节(16.96 GiB),groupwise-int模型校验 md5 b7e293b072113b351c8e79eb9726a5d6,魔数NINFER\0\002用途 DeepSeek Harness 的本地 provider(OpenAI 兼容) 注意:下载 artifact 必须用旧的那个 commit。HF
neroued/Qwen3.8-27B-NInfer现在的新版是 19.03 GiB(多了 DFlash2 companion weights),manifest 里写着cuda_architecture: sm_120a+minimum_revision: 385b30ce,sm_89 的移植线用不了。旧版路径:
https://huggingface.co/neroued/Qwen3.8-27B-NInfer/resolve/3526913004b1cf552cb57b88d6a5c6f5e4a89a70/qwen3_8_27b.ninfer
二、速度对比(同一张卡、同一测法)
测法完全一致:同一段 prompt(Paris 历史)、
max_tokens=256、temperature=0.7、reasoning_effort=medium、各跑 5 轮取平均,读服务端 per-request 的timings。引擎 模型 权重占用 投机 单路 decode 备注 SGLang RedHatAI/Qwen3.8-27B-INT4 + 独立 DFlash2 草稿 17.33 + 0.79 + 1.44 = 19.56 GiB DFLASH,draft 8(NVFP4 草稿) 98.34 t/s 172K 上下文,2 路 NInfer(CUDA Graph 开) 官方 groupwise-int(单 artifact) 16.96 GiB MTP,draft 3 88.21 t/s 262K 上下文 NInfer(最终, --no-cuda-graph)同上 16.96 GiB MTP,draft 3 85.9 t/s 262K,双路稳定 同法差值 −11.5%。注意 NInfer 这条线用的是更小的 artifact(16.96 GiB 单文件,MTP + 视觉都内嵌),SGLang 那条线是目标模型 17.33 GiB + MTP 头 0.79 GiB + 独立 DFlash2 草稿 1.44 GiB,合计 19.56 GiB。
不过速度差异不能简单归因于引擎:两条线的量化方案不同(compressed-tensors INT4 vs groupwise-int)、投机机制不同(独立 1.92B 草稿模型 vs 内嵌单层草稿头)、上下文也不同(172K vs 262K)。要下"谁更快"的结论得先把这些变量对齐。
双路并发(NInfer 最终配置):
模式 单路 双路各 聚合 倍数 等长 2×256tok 85.9 ~75 142.4 t/s 1.66× 长短混跑 85.9 100 / 67~84 104~107 t/s 1.2× 3 请求(C=2 + 排队) 85.9 ~75×2 132~138 t/s 1.5× 有意思的是批处理下 MTP 接受率反而升高:单路 57% → 双路 71~74%,短请求甚至 92%。
三、智力对比(同一张卡、同一批题、同一评分脚本)
数据集两边各存一份并校验 md5 一致(
agieval_eval.json1200 题、combined_eval.json420 题)。评分逻辑完全沿用原脚本,0-shot、temperature=0。测试 SGLang(RedHat INT4) NInfer(groupwise-int) 差值 AGIEval 1200 题 1082/1200 = 90.17% 1084/1200 = 90.33% +0.17pp CEval+CMMLU 420 题 368/420 = 87.62% 375/420 = 89.29% +1.67pp ├ CEval 220 题 193/220 = 87.73% 202/220 = 91.82% +4.09pp └ CMMLU 200 题 175/200 = 87.50% 173/200 = 86.50% −1.00pp 认知 21 题 无记录 19/21 = 90.48% ※ — ※ 两题是判分脚本的假阴性:一题答
C = πd(脚本期望的写法是pi*d,语义其实完全相同)被判错;另一题答反渗透,比脚本里的标准答案蒸馏更符合现代工程实际。人工看实际是 21/21。AGIEval 分子任务
子任务 SGLang NInfer 差 gaokao-history 143 (95.3%) 147 (98.0%) +4 gaokao-biology 145 (96.7%) 146 (97.3%) +1 gaokao-chinese 125 (83.3%) 126 (84.0%) +1 gaokao-english 142 (94.7%) 142 (94.7%) 0 gaokao-physics 135 (90.0%) 135 (90.0%) 0 gaokao-geography 140 (93.3%) 139 (92.7%) −1 logiqa-zh 129 (86.0%) 128 (85.3%) −1 gaokao-chemistry 123 (82.0%) 121 (80.7%) −2 分歧 66 题:SGLang 对/NInfer 错 = 32,SGLang 错/NInfer 对 = 34 —— 完全对称。
结论:质量打平(NInfer 微幅领先),速度 SGLang 快 11.5%,稳定性 SGLang 完胜。 但 NInfer 换来的是 262K 上下文 + 双路并发能力。
四、三次崩卡(本篇最有价值的部分)
NInfer 这个 build 在 4080S 上有个致命特性:kernel 一挂就是整卡进
NV_ERR_GPU_IN_FULLCHIP_RESET死锁,rmmod卸不掉、nvidia-smi --gpu-reset报Not Supported(Xorg 占用),只能重启机器。我崩了三次。# 触发条件 崩溃耗时 现象 1 --prefill-chunk 2048立即 cudaErrorCooperativeLaunchTooLarge2 3 路并发 + 长短混跑 ~4 分钟 Xid 120 GSP task exception: load access page fault3 2 路 + MTP + CUDA Graph 30.4 分钟 / 648 请求 cudaErrorLaunchFailure崩溃 1 的源码级根因(确定性,可复现)
报错点在
bf16_gdn_gating_proj_kernels.cu:310的协作启动。翻sergiuszm/ninfer-4090 @ 1bd56c9a的源码找到了:// bf16_gdn_gating_proj_plan.cpp —— 预算是按 128 SM 的 RTX 4090 写死的 constexpr std::int32_t resident_ctas_27(Bf16GdnGatingScheduleId schedule) noexcept { return schedule == Bf16GdnGatingScheduleId::MmaCooperativeSplit8 ? 256 : 128; }而运行时算占用率的函数没按 SplitK 区分:
// bf16_gdn_gating_proj_kernels.cu
if constexpr (std::is_same_v<Geometry, Bf16Gdn27Geometry>) {
    // Qualified on the sm_120a build ...
    return 2;          // ← split8/split4/split2 一律返回 2 CTA/SM
}
split2 的真实占用率是 1 CTA/SM(512 线程 × 74 寄存器 = 37,888 寄存器/CTA,一个 SM 只有 65,536,装不下两个)——代码注释自己都写了 "split4/2 (512 threads, 74 regs) admit 1 CTA/SM"。
在 80 SM 的 4080S 上:
单次 prefill token 路由 网格 CTA 设备上限 结果 1024 split8 192 → 被切片成 144+48 160  安全
1664 split2 78 80 侥幸1665 split2 84 80  崩
2048 split2 96 80 崩(实测踩中)在 128 SM 的 4090 上 96 ≤ 128 恰好塞得下,所以作者测不出来;换到 80 SM 的卡就复现。 fork README 里"chunk ≤2688 的硬崩已修"这句话不跨 SM 数迁移。
结论:
--prefill-chunk必须 ≤1024。崩溃 3 的判定实验(本篇的重点)
崩溃 1 有明确源码根因,但崩溃 3 是"跑得好好的突然死"。已知事实是:
- 单路串行跑了 4 小时零事故(AGIEval 1200 题 145 分钟 + CEval 420 题 + 全部调参基准)
- 只要并发就崩,但崩的时间从 4 分钟到 30 分钟不等
于是做对照实验,全部 2 路并发、负载与崩溃基线完全一致、各跑 40 分钟:
实验 配置 时长 请求数 失败 聚合吞吐 结果 基线 MTP + CUDA Graph 30.4 min 648 2 123.6  崩
Arm 1 关闭 MTP 40.2 min 399 0 59.7 存活Arm 2 MTP + --no-cuda-graph40.0 min 842 0 122.5 存活判定:崩溃根因 = CUDA Graph 重放 × 批量(≥2 路)投机解码。
- Arm 1 证明单纯"批量解码"不崩(关掉投机就能活)
- Arm 2 是关键:保留 MTP、只关 CUDA Graph,冲过了基线 30.4 分钟的崩溃点,且速度几乎无损
- 单路即使带 CUDA Graph 也稳 → 需要 Graph × batch 的组合才触发
长浸泡验证
90.1 分钟 / 854 轮 / 1895 请求 / 678,408 token  →  0 失败
聚合吞吐 均 123.1 t/s(最低 79.1,最高 150.4)
0 条 cudaErrorLaunchFailure/FATAL,0 个 full-chip reset,0 个 Xid,37°C
累计 130 分钟 / 2,737 请求 / 97.8 万 token 零失败,是崩溃点的 4.3 倍。
代价只有 2.6%:单路 88.21 → 85.9 t/s,双路聚合 123.6 → 121.9 t/s。
五、调参实测
原帖 1803 的参数是给 4090D 48G 的,我这台是 32G,而且 1803 用的是
--kv-dtype fp8。四轮实测:轮次 配置 KV 池(tok) 显存 速度 MTP 接受率 A1 基线 fp8/ C=3345,024 31,043 MiB 88.48 58.1% A2 rk4v4-e8/ C=3654,528 31,043 MiB 85.79 55.3% B1 采用 rk4v4-e8/ C=2 + 裁剪524,288 28,579 MiB 88.21 57.9% B2 rk2v4-e8/ C=2 + 裁剪524,288 26,405 MiB 85.66 55.7% 1)
--kv-dtype fp8 → rk4v4-e8:同显存 KV 池 +90%(345K → 654K),代价仅 −3.0% 速度、−2.8pp 接受率。README 预告 5.7% 的税,实测更省。fp8 不要用,同样显存只能放一半 KV。2)裁剪 + C=2 更优:
--vision-max-tokens 8192 --media-cache-mib 256 --media-live-mib 512 --max-concurrency 2
→ 显存 −2.46 GB,速度回到基线。关键:KV 池 524,288 正好 = 2 × 262,144,引擎按"并发数 × max-context"精确配池,不是缩水。3)
rk2v4-e8不采用:再省 2.2GB,但速度掉到 85.66;而 262144 已是模型上下文上限,2-bit 换不来更长上下文。4)思考预算不是速度杠杆(固定 20 题探针):
预算 正确率 均题耗时 输出 tok/题 无 18/20 = 90.0% 8.40s 827 8000 18/20 = 90.0% 8.41s 827 4000 18/20 = 90.0% 8.39s 827 2000 18/20 = 90.0% 7.58s 746 1000 17/20 = 85.0% 6.89s 668 模型自然思考只有 ~800 token,budget ≥4000 完全是死参数。2000 省 10% 且不掉分。
六、长上下文 × 双路并发验证
KV 池零余量下两路都跑满上下文,是唯一没底的边界。分级加压:
级别 双路各 prompt 合计 token 占 KV 池 TTFT decode 墙钟 结果 L1 63,362 126,724 24% 53 / 55s 3.7 / 72.3 109s L2 126,695 253,390 48% 125 / 127s 3.6 / 70.7 253s L3 200,584 401,168 77% 235 / 233s 61.1 / 3.3 470s L4(单路) 211,140 — 40% 250s 58.5 252s L5(极限) 258,640 517,280 98.7% 335 / 346s 3.5 / 52.8 682s 双路 × 256K 可用,即使池子占满 98.7% 也不崩。
三个必须知道的行为特征:
- prefill 是串行的,会饿死另一条通道:一条解码期撞上另一条 prefill 时被压到 3.3~3.7 t/s(日志实证
queue 5m35.8s、prefill 770.8 tok/s)。双路收益只在"两条都在解码"时兑现。 - 长 prompt 的 TTFT 是硬成本:63K→53s,127K→126s,200K→235s,258K→335s(prefill 770~860 tok/s)。
- MTP 接受率不随深度衰减:200K 处 58.8~60.4%,258K 处 54.2%。
七、最终启动参数
docker run -d --name ninfer-qwen38-27b \ --restart unless-stopped --gpus all --ipc=host \ -p 8080:8080 -e TZ=Asia/Shanghai \ -v "$PWD/models:/app/models:ro" -v "$PWD/logs:/app/logs" \ nahsilabs/ninfer-4090:1bd56c9a \ models/qwen3_8_27b.ninfer \ --host 0.0.0.0 --port 8080 \ --max-context 262144 --kv-capacity auto \ --max-concurrency 2 \ --no-cuda-graph \ --prefill-chunk 1024 \ --kv-dtype rk4v4-e8 \ --vision --vision-max-tokens 8192 \ --media-cache-mib 256 --media-live-mib 512 \ --max-pending-requests 16 --pending-timeout-ms 600000 \ --host-kv-mib 24576 --host-state-slots 72 \ --max-private-continuations 12 --max-shared-prefixes 8 \ --auto-long-anchors 4 --max-long-anchors-per-continuation 4 \ --device-state-slots 6 \ --spec mtp --draft-tokens 3 --lm-head-draft \ --model-id Qwen3.8-27B实测结果:显存 28.6G / 32.8G(余量 4.2G)、单路 85.9 t/s、双路聚合 122 t/s、KV 池 524,288、上下文 262,144。
八、踩坑速查
现象 原因 解决 GPU 进 full-chip reset,只能重启机器 prefill-chunk ≥ 1665触发协作启动越界--prefill-chunk 1024并发跑 4~30 分钟后整卡死 CUDA Graph × 批量投机解码 --no-cuda-graph启动直接 OOM 用了 bf16/int8级 KV,262K 放不下用 rk4v4-e8或rk2v4-e8同显存 KV 池只有别人一半 用了 fp8换 rk4v4-e8(+90% 池子)vision 开起来吃 3GB 显存 media 缓冲用了默认 1024+2048 --media-cache-mib 256 --media-live-mib 512下载新 artifact 加载失败 新版含 DFlash2,声明 sm_120a用 commit 3526913004b1的 16.96GiB 版6 路并发 decode 掉到 9.6 t/s 超过引擎并发能力 --max-concurrency 2
九、结论
- 4080S 32G 跑 NInfer + Qwen3.8-27B 是可行的,不用编译,社区有现成的 sm_89 镜像。
- 质量和 SGLang 打平:AGIEval 1200 题 90.33% vs 90.17%,CEval+CMMLU 89.29% vs 87.62%。换引擎不会掉智力,反而在 CEval 上更高。
- 速度 SGLang 领先 11.5%(98.3 vs 88.2 t/s)。但 NInfer 的权重占用更小(16.96 GiB vs 19.56 GiB),并换来 262K 上下文和可用的双路并发(聚合 122 t/s)。两者量化方案与投机机制都不同,速度差不能纯归因于引擎。
- 这个 build 的并发是带雷的:必须
--no-cuda-graph,代价 2.6%。 - 两条硬红线:
--prefill-chunk ≤ 1024、--max-concurrency ≤ 2。碰了就要重启机器。
一句给同好的话:这张卡上用 NInfer,"稳"比"快"重要得多——先把那两个 flag 钉死,再谈调优。
技术来源
技术/模型 来源 NInfer 引擎 Neroued/ninfer sm_89 移植(本机镜像来源) sergiuszm/ninfer-4090 预编译镜像 nahsilabs/ninfer-4090:1bd56c9a(Docker Hub)模型 artifact(16.96 GiB,兼容版) neroued/Qwen3.8-27B-NInfer @ 3526913004b1 SGLang 侧对照模型 RedHatAI/Qwen3.8-27B-INT4 DFlash2 草稿(SGLang 对照用) z-lab/Qwen3.8-27B-DFlash2 causal_small_t共享内存修正(本 build 缺失)Doelfke/ninfer-yarn @ 7a876cf E8 4-bit KV 来源 UDPSendToFailed/ninfer-4090 全部数据取自
ninfer-serve服务端 per-request 日志与容器日志,不是客户端 SSE 计数(客户端计数会明显低估)。三次崩溃的dmesg/journalctl -b -1证据、源码片段、以及 1895 请求的浸泡日志均可复现。 -
这份定位很扎实,尤其崩3的对照(关 MTP 存活 / 只关 CUDA Graph 存活 / 单路带 Graph 也稳)把「Graph × batch≥2 投机」这个组合条件锁死了,比只报「并发崩」有用得多。几点可复现/可迁移的补充:
-
崩1的根因是「按 128 SM 写死的 resident CTA 预算 + 未按 split 区分 CTA/SM」,换 SM 数(80 的 4080S、92 的 4090D)就会在临界 chunk 翻车,1664/1665 的边界很干净。建议把 resident_ctas 改成 min(schedule_ctas, occupancy_per_sm × sm_count) 反哺 fork 作者;在那之前用 --prefill-chunk ≤1024 是对的。
-
崩3 建议再拆一刀:固定 batch=2,但让批里始终只有 1 个请求在跑(另一路只挂空),看是否仍崩。若仍崩 = 图重放本身有问题;若不崩 = 一个 capture 里塞了多请求的 KV 偏移。这能决定修法是「每 batch-size 各捕获」还是「投机 head 关 capture」。
-
速度 −11.5% 别急着归引擎:你自己也列了量化方案、投机机制、上下文三个变量都不同。要下结论至少把 SGLang 那条压到 262K、并把「内嵌头 vs 独立草稿」对齐到同一侧。AGIEval 分歧 32/34 完全对称、CEval/CMMLU 在 ±4pp 内,质量打平的结论站得住。
-
262K 双路只余 4.2GB 偏紧,建议做一次 needle-in-haystack(关键信息埋 200K+ 位置)确认是「跑通且召回不丢」,而不是 KV 换页。--no-cuda-graph 掉 2.6% 换稳定,这个 trade 很划算。
-
-
,
 T terry 固定了此主题
-
,系统 取消固定了此主题