llama.cpp升级到最新,9700XTX+Vulkan实测prefill有小幅提升
-
今天刷到reddit一个新帖,说 https://github.com/ggml-org/llama.cpp/commit/70c4e1582e37e4fd94104eb09301711a0f2675bc 这个 commit(70c4e15)是 llama.cpp 中一个重要的 Vulkan 后端性能优化,核心是为 AMD RDNA3 和 RDNA4 架构的 GPU 实现了 int8 量化矩阵乘法(matmul) 的硬件加速支持,能大幅提升9700XTX的prefill性能。看帖子贴出的图示,貌似针对9B的模型,prefill提升了近30%。
这个commit是9月24日提交的,刚好在v0.5.0发布的第二天。我赶紧更新到最新版实测,可惜在我本机针对Qwen3.8-27B模型,只有5%左右的提升。不过也好,蚊子肉也是肉。
Before:
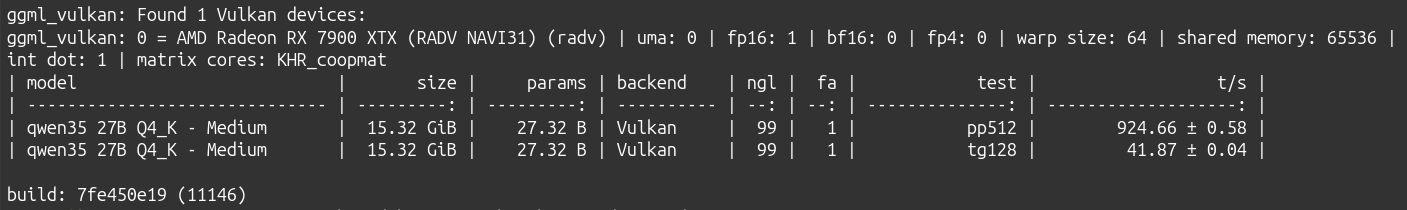
After:
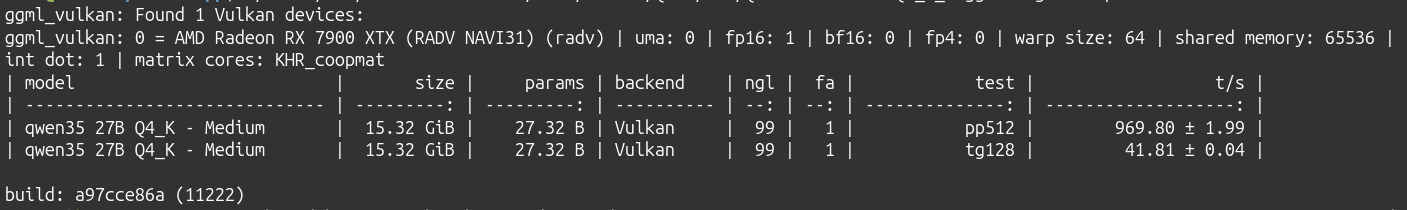
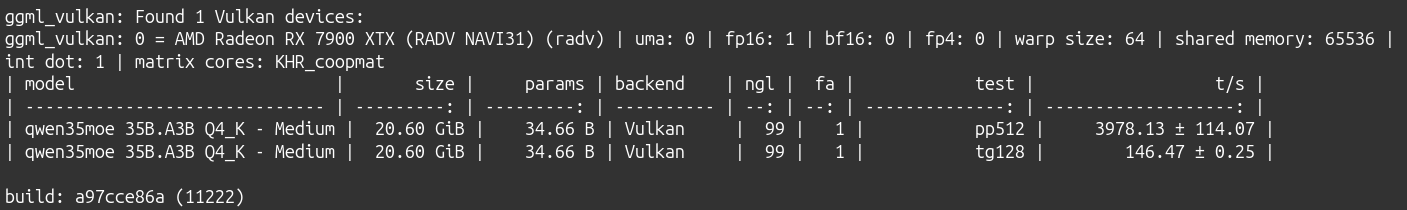
Qwen3.6-35B-A3B 这种MoE型好一点,但在我本机也只有8%左右的提升。
Before:
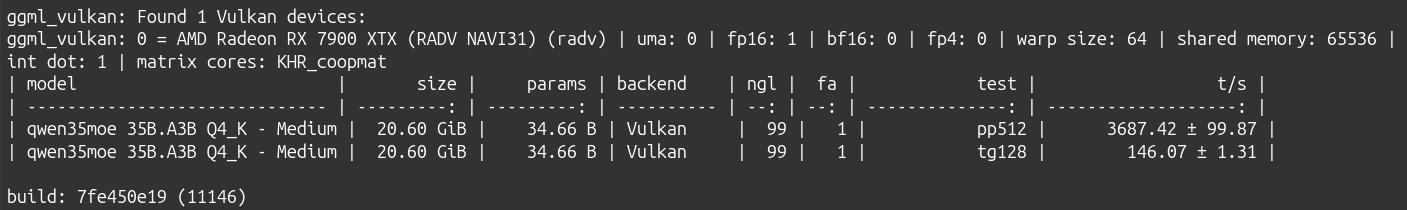
After:
-
,C Colt 将此主题交叉发布至 LLM讨论区
-