
4×RTX 3090 +256G内存 跑 Qwen3.8 Flash Next:从四卡 6.5 tok/s 到单卡 100+ tok/s 的几条 MoE 路线
-
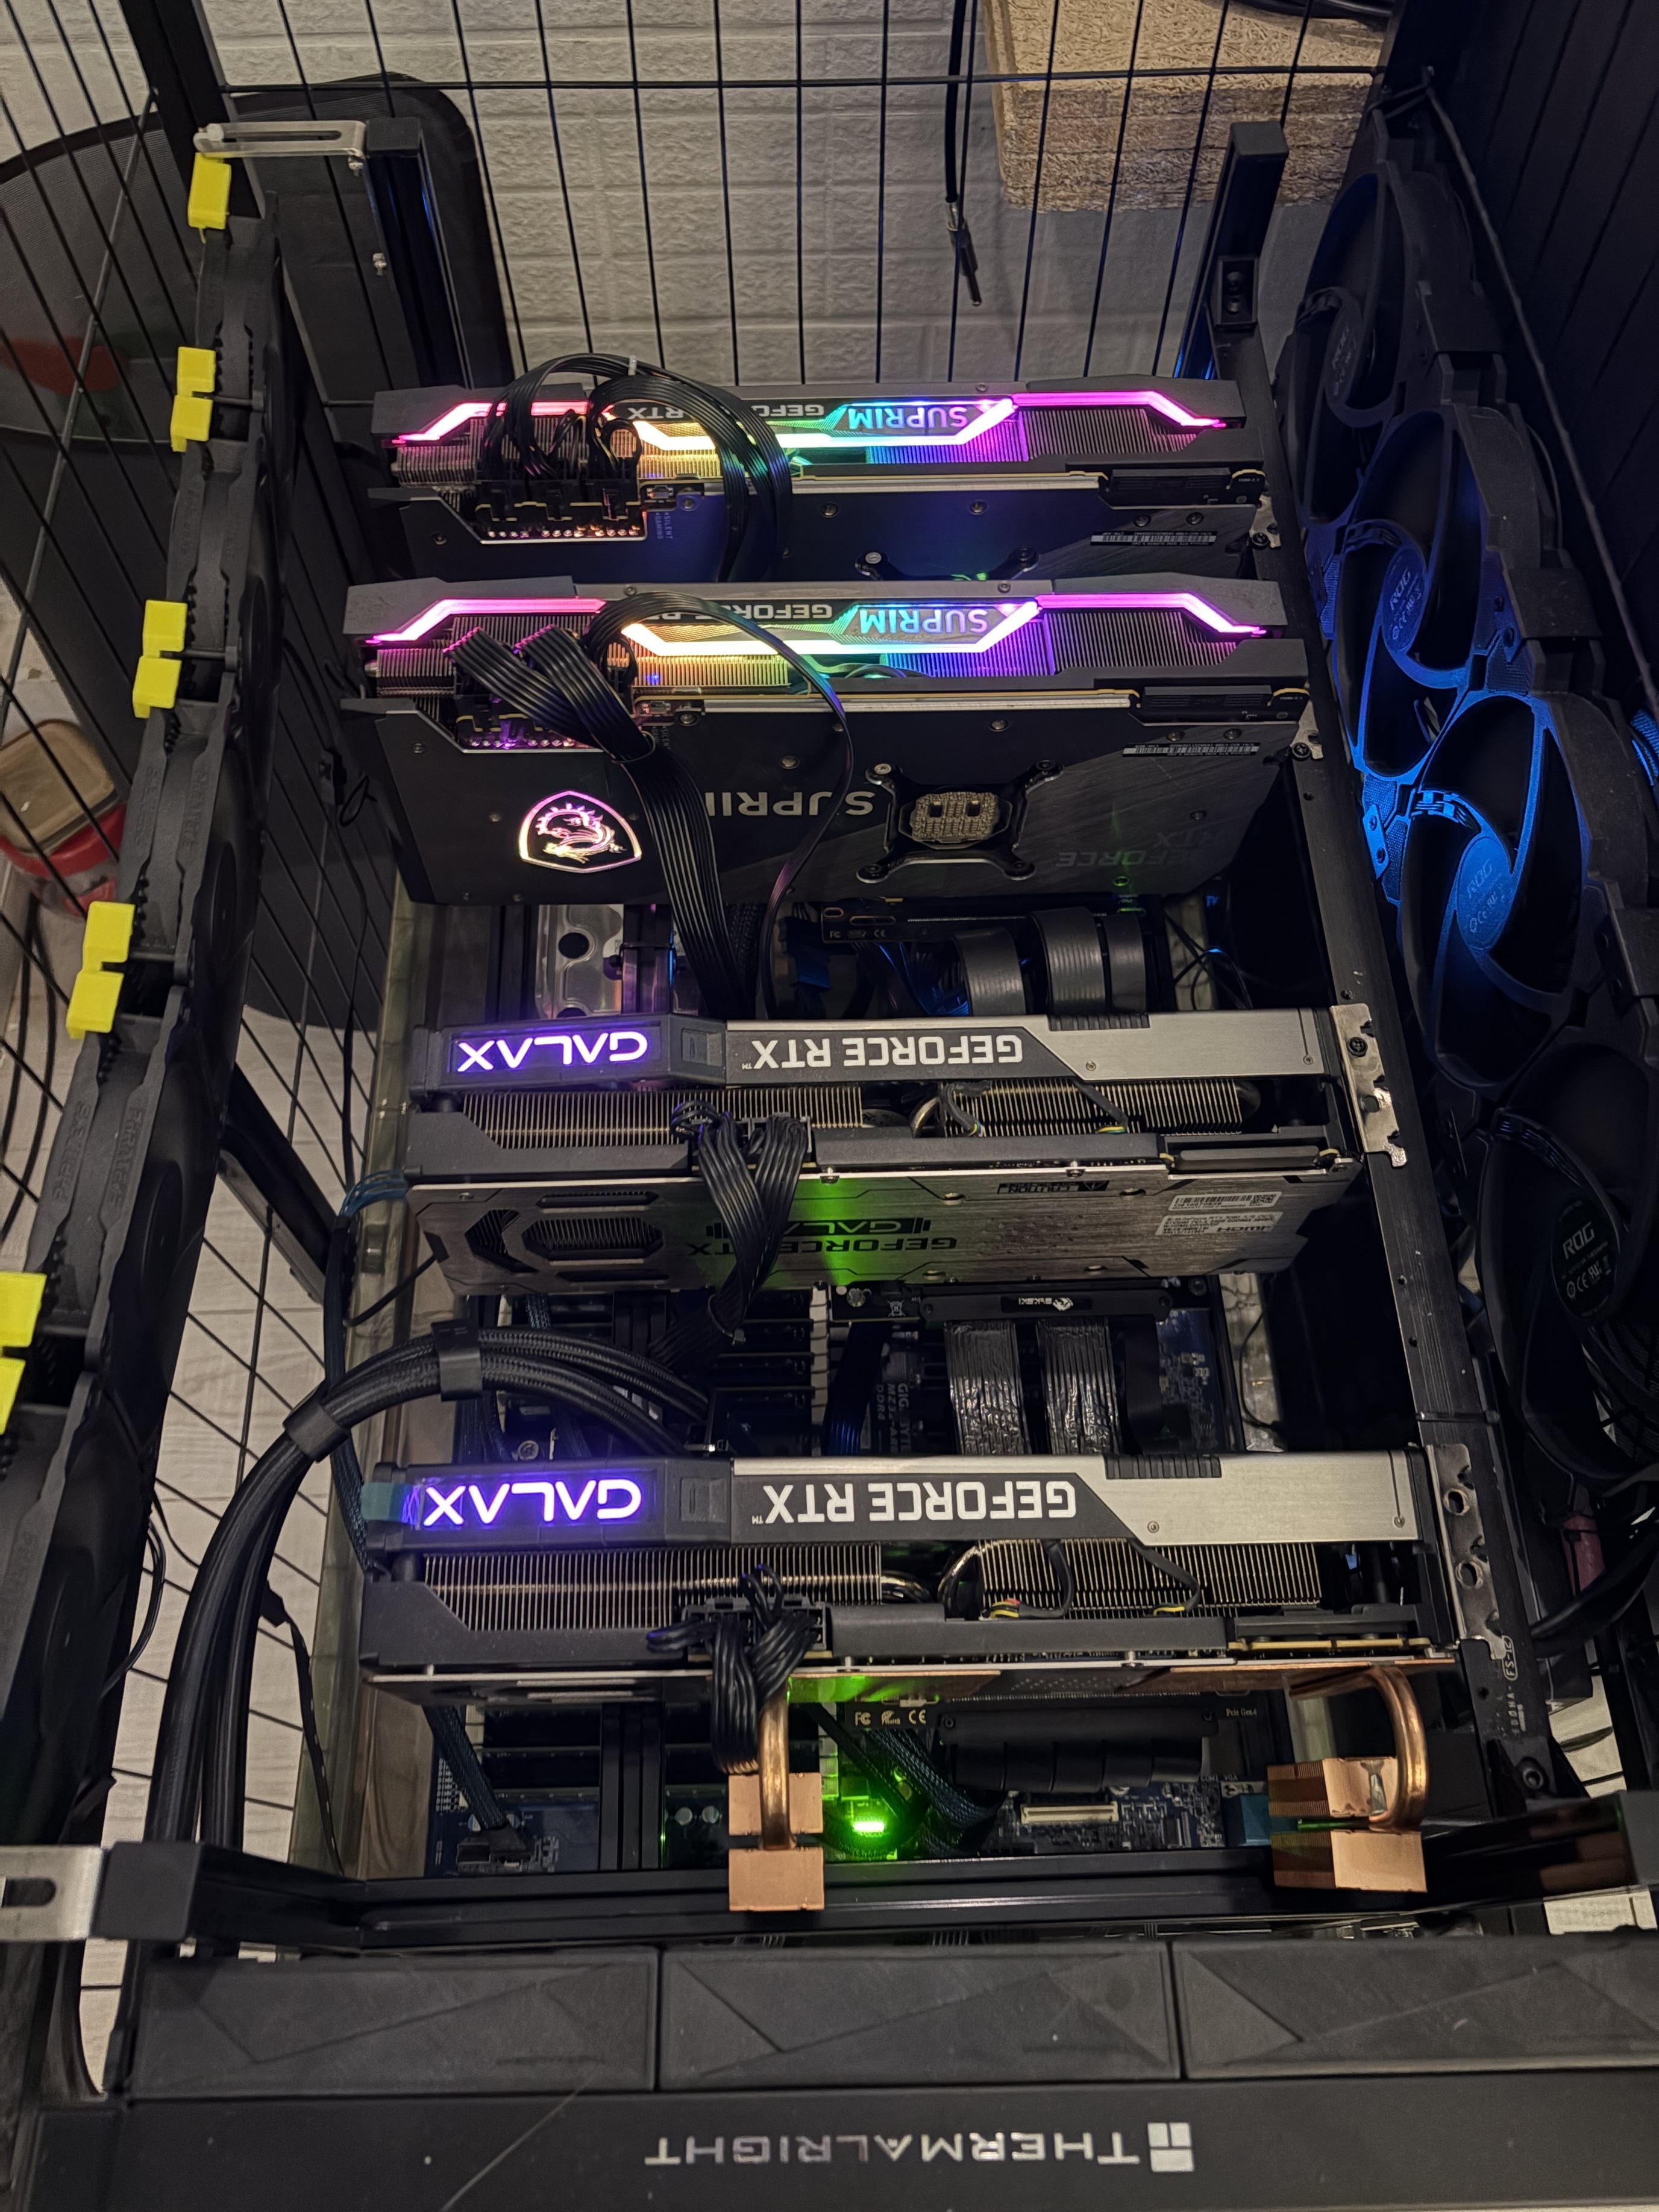
最近几天在自己的猫笼机箱+矿架 4×RTX 3090 24GB + EPYC 7R13 48C/96T + 256GB DDR4 平台上,集中折腾了一轮 Qwen3.8 Flash Next 这种 MoE 模型。
最近几天我在自己的机器上集中测试了一轮 Qwen3.8 Flash Next。
平台是 EPYC 7R13 48C/96T、256GB 八通道 DDR4 ECC、RTX 3090 24GB ×4,总显存 96GB,四张卡均为 PCIe 4.0 ×16。
这轮测试一开始的思路很简单:既然有 96GB VRAM,就尽量让四张 3090 一起工作。但实际测试下来,MoE 的表现和 Dense 模型差别很大。最后最快的配置,反而不是四卡、也不是三卡,而是单张 RTX 3090。
我主要走了四条路线:传统 llama.cpp 四卡 GPU split、
CPU-primary + 单3090、
Strata 三卡,
以及最后的 Strata custom fork + 单3090。下面把每一条路线以及不同 CTX 下的 Prefill、TTFT、Decode 和实际耗时分别整理出来。
【路线一:llama.cpp 四卡 GPU Layer Split】
这是最开始、也是最直觉的一条路线。
模型使用 Qwen3.8 Flash Next IQ4_XS,尽可能把模型放到四张 RTX 3090 上。GPU 中大约驻留 63.6GiB 权重。
这一阶段 Prefill 大约可以达到 700~1100 tok/s,但 Native Decode 只有约 6.5 tok/s。
如果固定输出 256 tokens:
256-token Decode 时间 ≈ 39.4 秒。
也就是说,这条路线的问题并不是“跑不起来”,而是生成阶段太慢。模型可以装进去,也可以处理长上下文,但四卡之间的 MoE Expert 调度、PCIe 通信和数据交换成本非常明显。
这是我后面整个探索的第一个重要结论:
MoE 模型里,“显存更多、GPU 更多”并不自动等于“生成更快”。【路线二:CPU-primary + 单张 RTX 3090】
接下来我反过来测试了一条看起来很不符合直觉的路线:让 EPYC 7R13 成为主要计算引擎,只开放一张 RTX 3090,把一部分 MoE 层放进 GPU。
最终比较好的配置大致是:
CUDA_VISIBLE_DEVICES=1
-ncmoe 34
-t 32
也就是大约 14 层 MoE 放在单张 3090 上。
这一条路线最有意思的是长上下文下 Decode 非常稳定。
32K CTX:Decode 32.04 tok/s;256-token Decode ≈ 7.99 秒。
64K CTX:Decode 31.59 tok/s;256-token Decode ≈ 8.10 秒。
128K CTX:Decode 30.00 tok/s;256-token Decode ≈ 8.53 秒。
262K CTX:Decode 29.00 tok/s;256-token Decode ≈ 8.83 秒。
另一轮固定 512-token 的稳态测试里,这个配置最高跑到了 35.05 tok/s。
几个非常关键的横向结果是:
CPU-primary、没有有效 GPU MoE 加速时约 24.52 tok/s。
CPU-primary + 单3090、ncmoe34 可以达到 35.05 tok/s。
但同样的思路,只要让两张 GPU 同时可见,性能反而掉到约 8.16 tok/s。
最早的传统四卡 split 更只有约 6.5 tok/s。
所以这一阶段可以非常明显地看到,问题并不是 GPU 算力不足,而是多卡参与以后,MoE 数据路径和调度开始成为主要瓶颈。
CPU-primary 还有一个很大的优势:CTX 从 32K 一直拉到 262K,Decode 只从约 32 tok/s 降到约 29 tok/s。
也就是说,长上下文对 Decode 的影响其实相当小。
遗憾的是,这个阶段我的测试重点主要放在 Expert placement、CPU/GPU 分工和 Decode 上,没有像后来的 Strata 测试一样完整记录每一个 CTX 的 Prefill / TTFT,所以这里不补估算数据。【路线三:Strata 三卡 IQ3_S】
随后我开始测试 Strata。
三卡比较好的早期配置中,GPU [0,1,2] 可以做到接近 100% Expert residency。
短 Prompt 下 Decode 为 77.65 tok/s。
约 28.5K 输入时 Decode 甚至达到 80.85 tok/s。
另一套 GPU [1,2,3] + layer_split 14,32 的配置,Short Decode 为 76.30 tok/s,约 28.5K 时为 72.10 tok/s。
这一阶段第一次让我看到:如果 MoE runtime 针对 Expert residency 和执行路径做得更激进,Decode 的确可以显著超过 llama.cpp CPU-primary。
但是当 CTX 继续变长以后,问题又出现了。
128K 附近,Decode 大约回落到 27.8~32.2 tok/s;不同缓存状态下 TTFT 大约在 12.2~27.7 秒之间。
200K 测试时,Decode 大约 34.9 tok/s,TTFT 约 45.9 秒;固定输出 256 tokens 时,Decode 阶段大约需要 7.34 秒。
256K 时 Decode 大约 28.5 tok/s。
开启 kv-resident 后,Expert residency 可以达到 24576 / 24576,并且 200K retrieval 做到了 5/5 PASS。
但问题在于,如果 128K~256K 最终仍然只有 30 tok/s 左右,那么它和 CPU-primary IQ4_XS 的性能差距已经不够大。
而我测试 Strata 的目的,本来就是希望得到明显更高的生成速度。
于是继续往下挖。【路线四:单3090 + Strata Custom Fork】
真正的性能转折点出现在这里。
后面发现,EPYC 7R13 这种高核心数 CPU 在 Strata 下并不是 worker 越多越快。默认开出大量 worker 后,线程同步和调度本身就可能制造非常严重的性能悬崖。
有一组对照里,Stock 配置大约 47 个 workers 时只有 19.55 tok/s。
明确限制线程池之后,直接回到约 78~92 tok/s。
最终我使用 custom fork @0bbd8f5,并把线程池控制到:
GPU3 only
pool-workers = 12
max-context = 200192
正式生产验证范围则控制在 128K 以内。
这一组也是目前我测试中数据最完整的一组。
所有下面的测试都是 Cold Prompt,也就是 reused = 0,并固定输出 256 tokens。
先看 Stock Strata 单3090。
Short:Prefill 138.5 tok/s;TTFT 1.04 秒;Decode 92.1 tok/s;256-token Decode 2.78 秒;估算 E2E ≈ 3.82 秒。
16K:Prefill 1923.6 tok/s;TTFT 8.73 秒;Decode 79.9 tok/s;256-token Decode 3.20 秒;估算 E2E ≈ 11.93 秒。
32K:Prefill 2236.3 tok/s;TTFT 14.88 秒;Decode 79.4 tok/s;256-token Decode 3.22 秒;估算 E2E ≈ 18.10 秒。
64K:Prefill 2166.2 tok/s;TTFT 30.58 秒;Decode 80.9 tok/s;256-token Decode 3.16 秒;估算 E2E ≈ 33.74 秒。
128K:Prefill 2008.6 tok/s;TTFT 65.85 秒;Decode 78.1 tok/s;256-token Decode 3.28 秒;估算 E2E ≈ 69.13 秒。
这里的 E2E 统一按照“TTFT + 256 / Decode”计算,只作为方便比较的近似值,并不是额外采集的独立 wall-clock 指标。
然后是 Custom Fork @0bbd8f5。
Short:Prefill 148.3 tok/s;TTFT 0.99 秒;Decode 116.5 tok/s;256-token Decode 2.20 秒;估算 E2E ≈ 3.19 秒。
16K:Prefill 1824.2 tok/s;TTFT 9.16 秒;Decode 103.7 tok/s;256-token Decode 2.47 秒;估算 E2E ≈ 11.63 秒。
32K:Prefill 2083.2 tok/s;TTFT 15.88 秒;Decode 107.0 tok/s;256-token Decode 2.39 秒;估算 E2E ≈ 18.27 秒。
64K:Prefill 2071.1 tok/s;TTFT 31.98 秒;Decode 95.3 tok/s;256-token Decode 2.69 秒;估算 E2E ≈ 34.67 秒。
128K:Prefill 2039.3 tok/s;TTFT 64.91 秒;Decode 96.8 tok/s;256-token Decode 2.64 秒;估算 E2E ≈ 67.55 秒。【Stock 和 Custom 到底差在哪里】
这组数据里有一个很重要的现象:Custom fork 并没有明显提高 Prefill。
以 32K 为例:
Stock:Prefill 2236.3 tok/s,TTFT 14.88 秒,Decode 79.4 tok/s。
Custom:Prefill 2083.2 tok/s,TTFT 15.88 秒,Decode 107.0 tok/s。
Decode 提升约 34.8%,但 Prefill 反而略低。
128K 也一样。
Stock:Prefill 2008.6 tok/s,TTFT 65.85 秒,Decode 78.1 tok/s。
Custom:Prefill 2039.3 tok/s,TTFT 64.91 秒,Decode 96.8 tok/s。
Decode 提升约 23.9%,Prefill 基本不变。
所以这个 fork 的性能提升,并不是简单意义上的“整个模型快了 30%”。
更准确的说法是:
它主要优化了 Decode / Expert execution,而没有大幅改变长 Prompt 的 Prefill 吞吐。【CTX 对实际体验的影响】
这一部分是我这轮测试里觉得最值得拿出来讨论的数据。
Custom Fork 下:
16K:TTFT 9.16 秒;Decode 103.7 tok/s;256-token Decode 2.47 秒。
32K:TTFT 15.88 秒;Decode 107.0 tok/s;256-token Decode 2.39 秒。
64K:TTFT 31.98 秒;Decode 95.3 tok/s;256-token Decode 2.69 秒。
128K:TTFT 64.91 秒;Decode 96.8 tok/s;256-token Decode 2.64 秒。
从 32K 增长到 128K:
Decode 从 107.0 tok/s 下降到 96.8 tok/s,只下降约 9.5%。
但是 TTFT 从 15.88 秒增加到 64.91 秒,变成约 4.1 倍。
也就是说,在这套配置里,CTX 增长以后真正明显恶化的不是 Decode,而是 Prefill / TTFT。
这是一个很容易被“100 tok/s”这种单一 benchmark 数字掩盖的问题。
128K Cold Prompt 虽然依然可以维持接近 100 tok/s 的生成速度,但你第一次看到模型输出之前,要先等大约 65 秒。
所以我现在认为,长上下文 benchmark 如果只公布 Decode tok/s,信息是不完整的。
至少应该同时公布:
Prompt Tokens、Prefill tok/s、TTFT、Decode tok/s,以及 Prefix Cache 是否命中。【Prefix Cache 命中之后】
最终 128K FAST profile 还做了一轮 45.29 分钟 soak test,总共 89 / 89 请求成功。
Short 的 Decode Median 为 100.6 tok/s,P10~P90 为 94.9~101.8 tok/s。
32K Cold 的 Decode Median 为 91.1 tok/s,P10~P90 为 85.0~104.8 tok/s。
128K Cold 的 Decode Median 为 89.9 tok/s,P10~P90 为 82.7~102.7 tok/s。
32K Prefix Hit 的 Decode Median 为 118.1 tok/s,P10~P90 为 112.4~121.8 tok/s。
128K Prefix Hit 的 Decode Median 为 109.1 tok/s,P10~P90 为 106.9~126.0 tok/s。
所以对于 Agent、多轮对话、固定 System Prompt、固定知识库等工作负载,Prefix Cache 是否命中会直接决定实际体验。
Cold benchmark 和真实多轮 Agent workload,其实应该分开讨论。【最终几条路线放在一起看】
最初的 llama.cpp 四卡 Layer Split:Prefill 约 700~1100 tok/s,Decode 约 6.5 tok/s,生成 256 tokens 约 39.4 秒。
CPU-primary + 单3090:32K 约 32.04 tok/s;64K 约 31.59 tok/s;128K 约 30.00 tok/s;262K 仍有约 29.00 tok/s。最佳稳态测试达到 35.05 tok/s。
早期 Strata 三卡:短上下文大约 75~80 tok/s,但进入 128K~256K 后,Decode 大体回落到约 28~35 tok/s。
最终 Strata Custom 单3090:32K 为 107.0 tok/s,64K 为 95.3 tok/s,128K 为 96.8 tok/s;128K Prefix Hit 的长期测试 Median 为 109.1 tok/s。
从最早的四卡 6.5 tok/s,到 CPU-primary + 单3090 的 35 tok/s,再到 Strata custom 单3090 的 100+ tok/s,这几步其实并不是简单地“换了一个 runtime”。
真正变化的是整个 MoE 数据路径。【我现在实际保留的两个 Profile】
日常 FAST 档使用单张 RTX 3090,Strata Custom Fork @0bbd8f5,pool-workers = 12,主要服务于 128K 及以下上下文。
实际 Decode 大致在 90~110+ tok/s。
LONG 档则保留 Stock Strata 0.1.30,使用三张 RTX 3090,GPU [3,1,2],layer_split = 14,32,pool-workers = 8,kv-resident = OFF,Context 设为 204800。
190K retrieval 已经做到了 3/3 PASS。
我最后没有继续追求 256K,因为对我的实际使用来说,200K 已经足够,而且 256K 带来的额外复杂度和性能损失不值得。【目前我的结论】
第一,MoE 的性能瓶颈绝对不能只看 GPU FLOPS 和总显存。四张 3090 有 96GB VRAM,不代表四张一起跑就是最快方案。
第二,CPU-primary 是一条非常值得重视的路线。EPYC 7R13 + 八通道内存在 MoE Expert streaming 里确实能发挥作用,而且 32K~262K 的 Decode 极其稳定。
第三,Strata 真正拉开差距的是 Decode。最终单3090在 32K 能到 107 tok/s,64K 约 95 tok/s,128K 仍然接近 97 tok/s。
第四,长 Context 最大的问题不是 Decode,而是 Prefill / TTFT。32K 到 128K,Decode 只下降约 9.5%,而 TTFT 从 15.88 秒增加到 64.91 秒。
第五,Prefix Cache 对真实工作负载非常重要。128K Prefix Hit 仍然可以做到 109.1 tok/s Median,所以 Cold Prompt benchmark 并不能完整代表 Agent 或多轮对话的实际体验。
最后一个,也是这轮测试最反直觉的结果:
我这台拥有 4×RTX 3090、总计 96GB VRAM 的机器,Qwen3.8 Flash Next 当前最快的日常配置,实际上只使用了其中一张 RTX 3090。
这几天折腾下来,我对 MoE 本地推理最大的理解变化是:
MoE 优化的核心不是“尽可能把模型塞进 GPU”。
而是要同时平衡 Expert residency、CPU 内存带宽、PCIe 数据移动、线程池、KV Cache、Prefill 和 Decode。
对于这种模型来说,数据怎么走,很多时候比“有多少张 GPU”更重要。 -
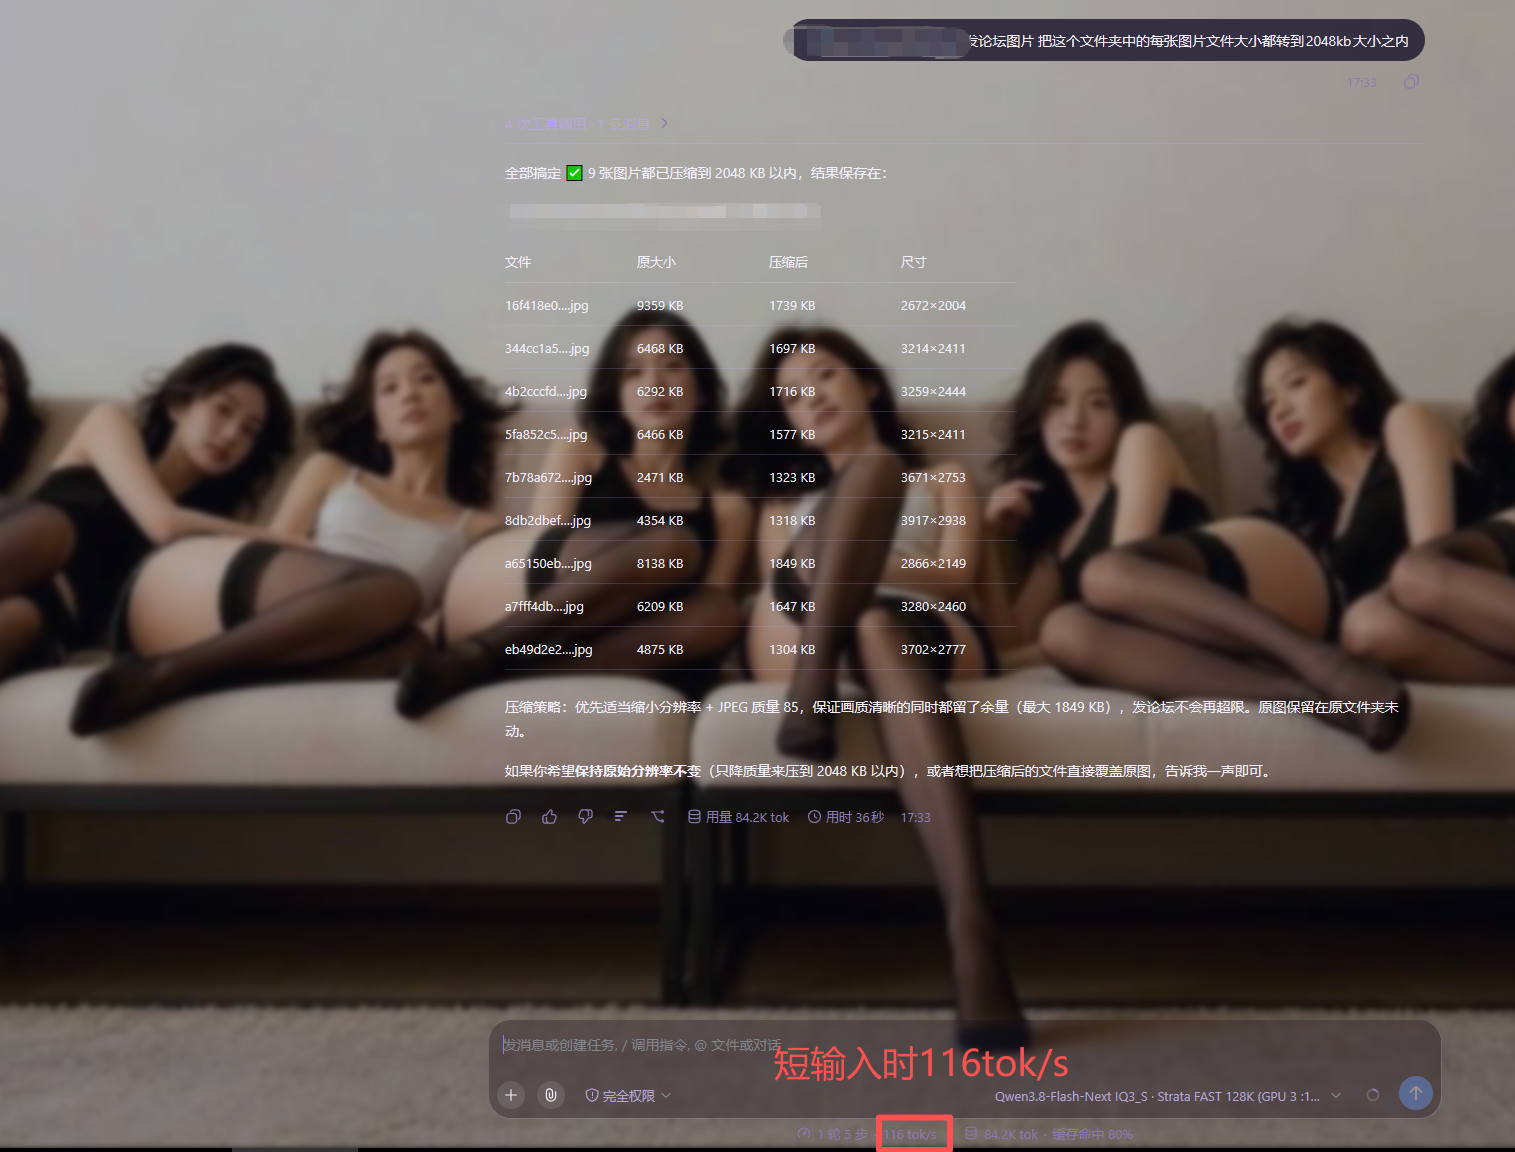
短输入时的速度 -
-
-
我觉得strata 这样engine 出来后4张3090 没有性价比了
@applejuice 确实,4卡反而更慢
-
-
,
 J JumpEggKiller 引用了 此主题
