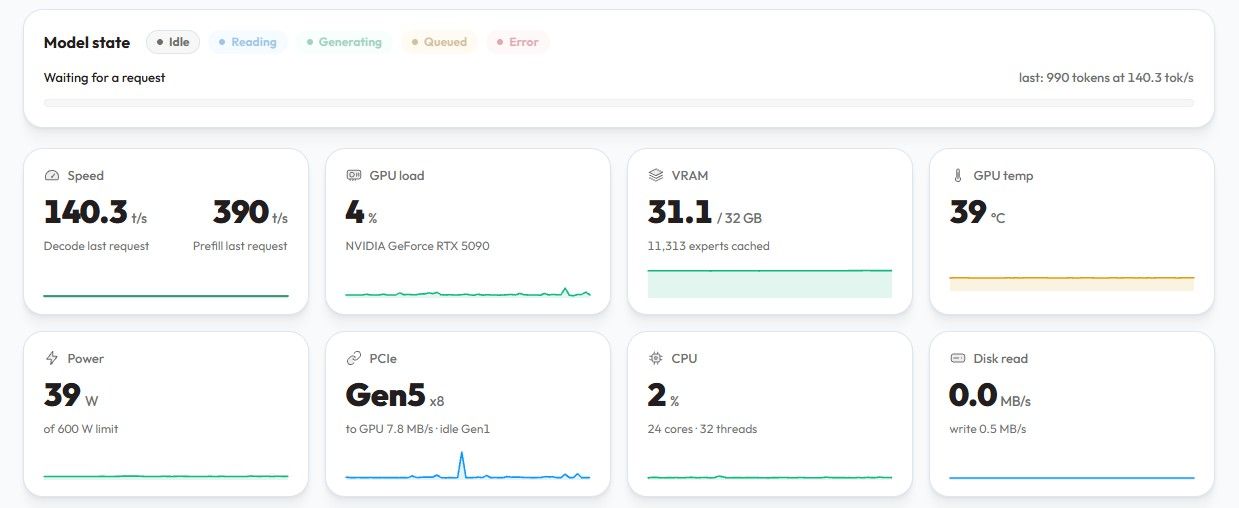
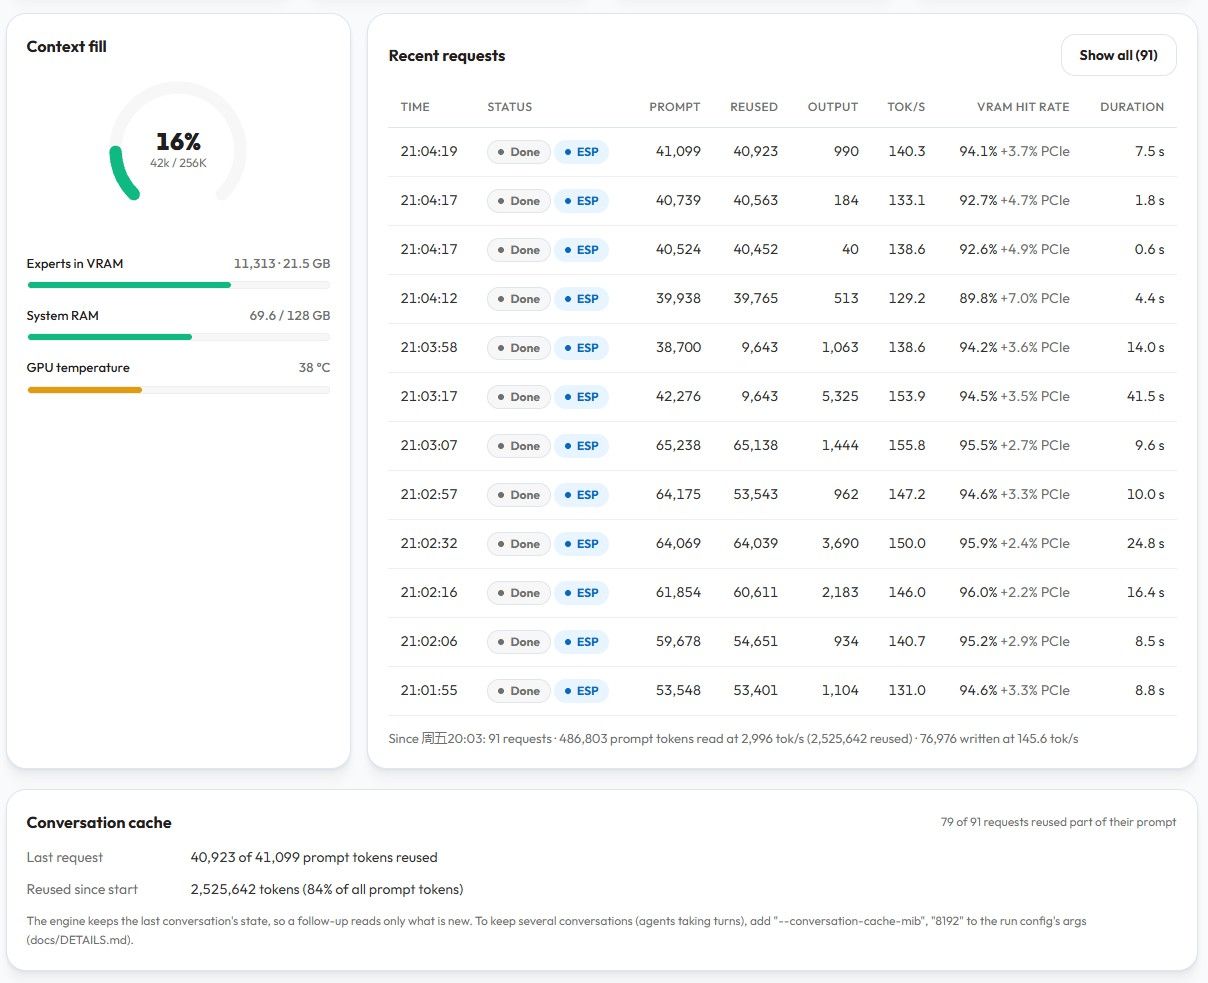
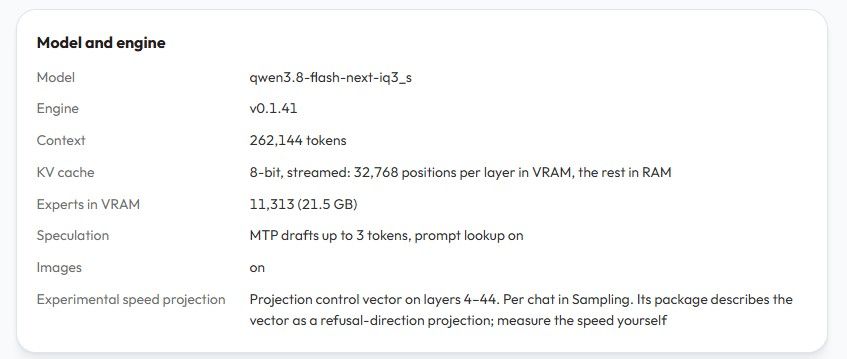
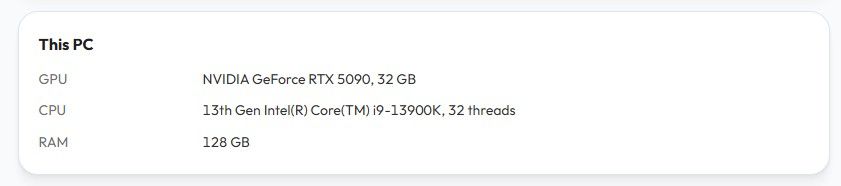
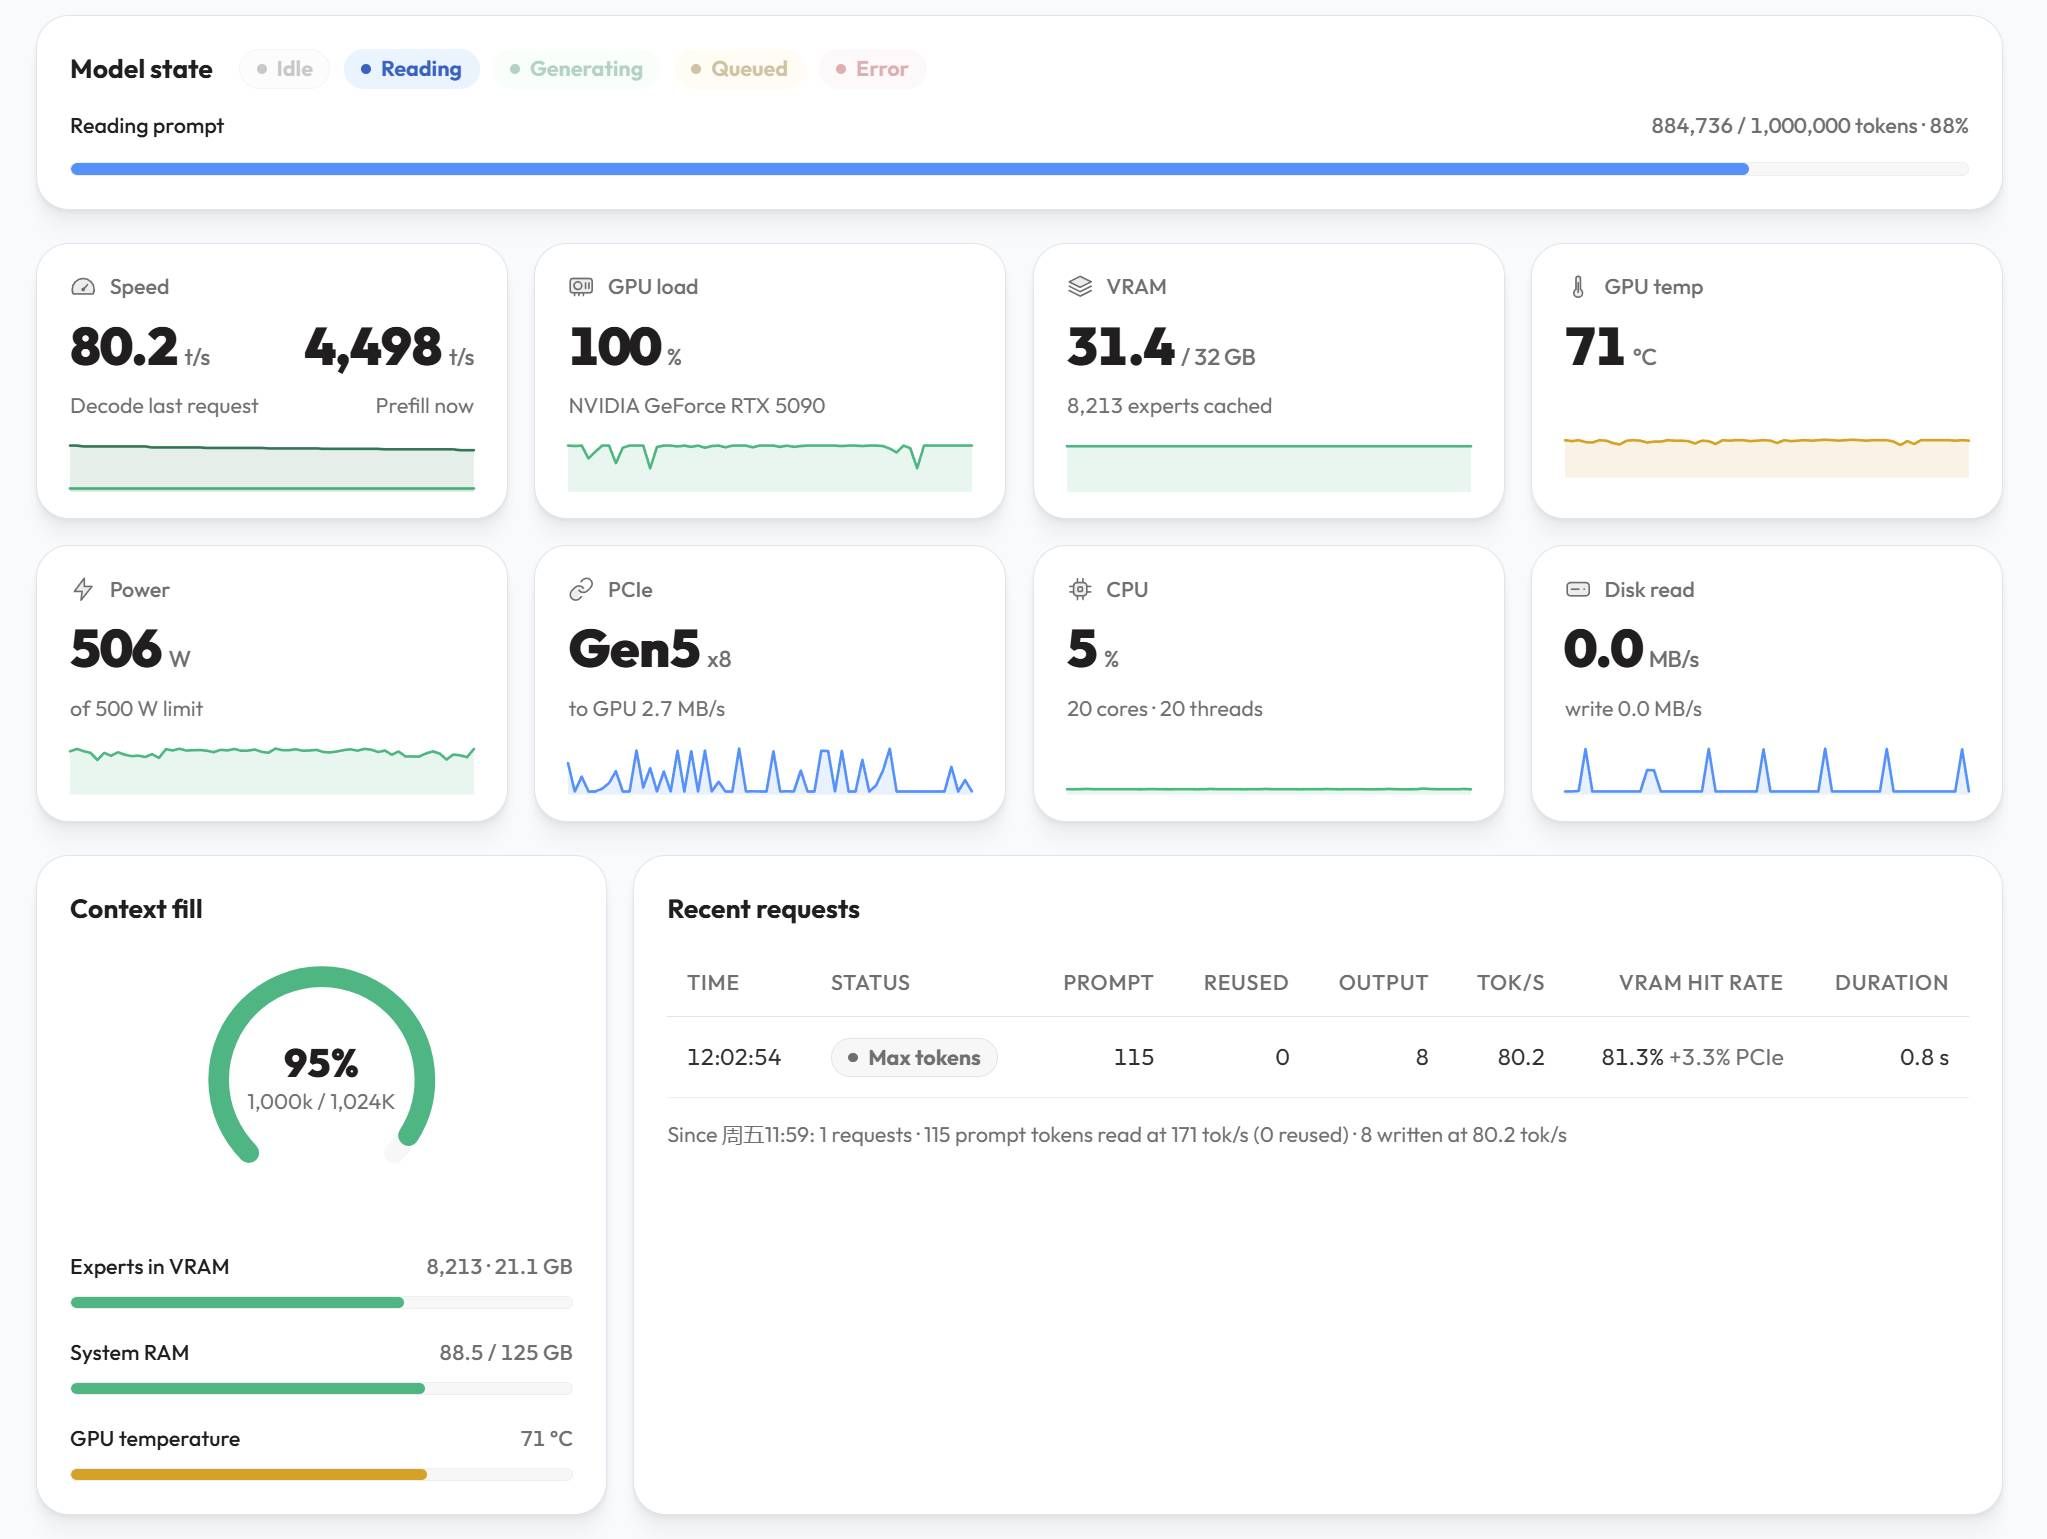
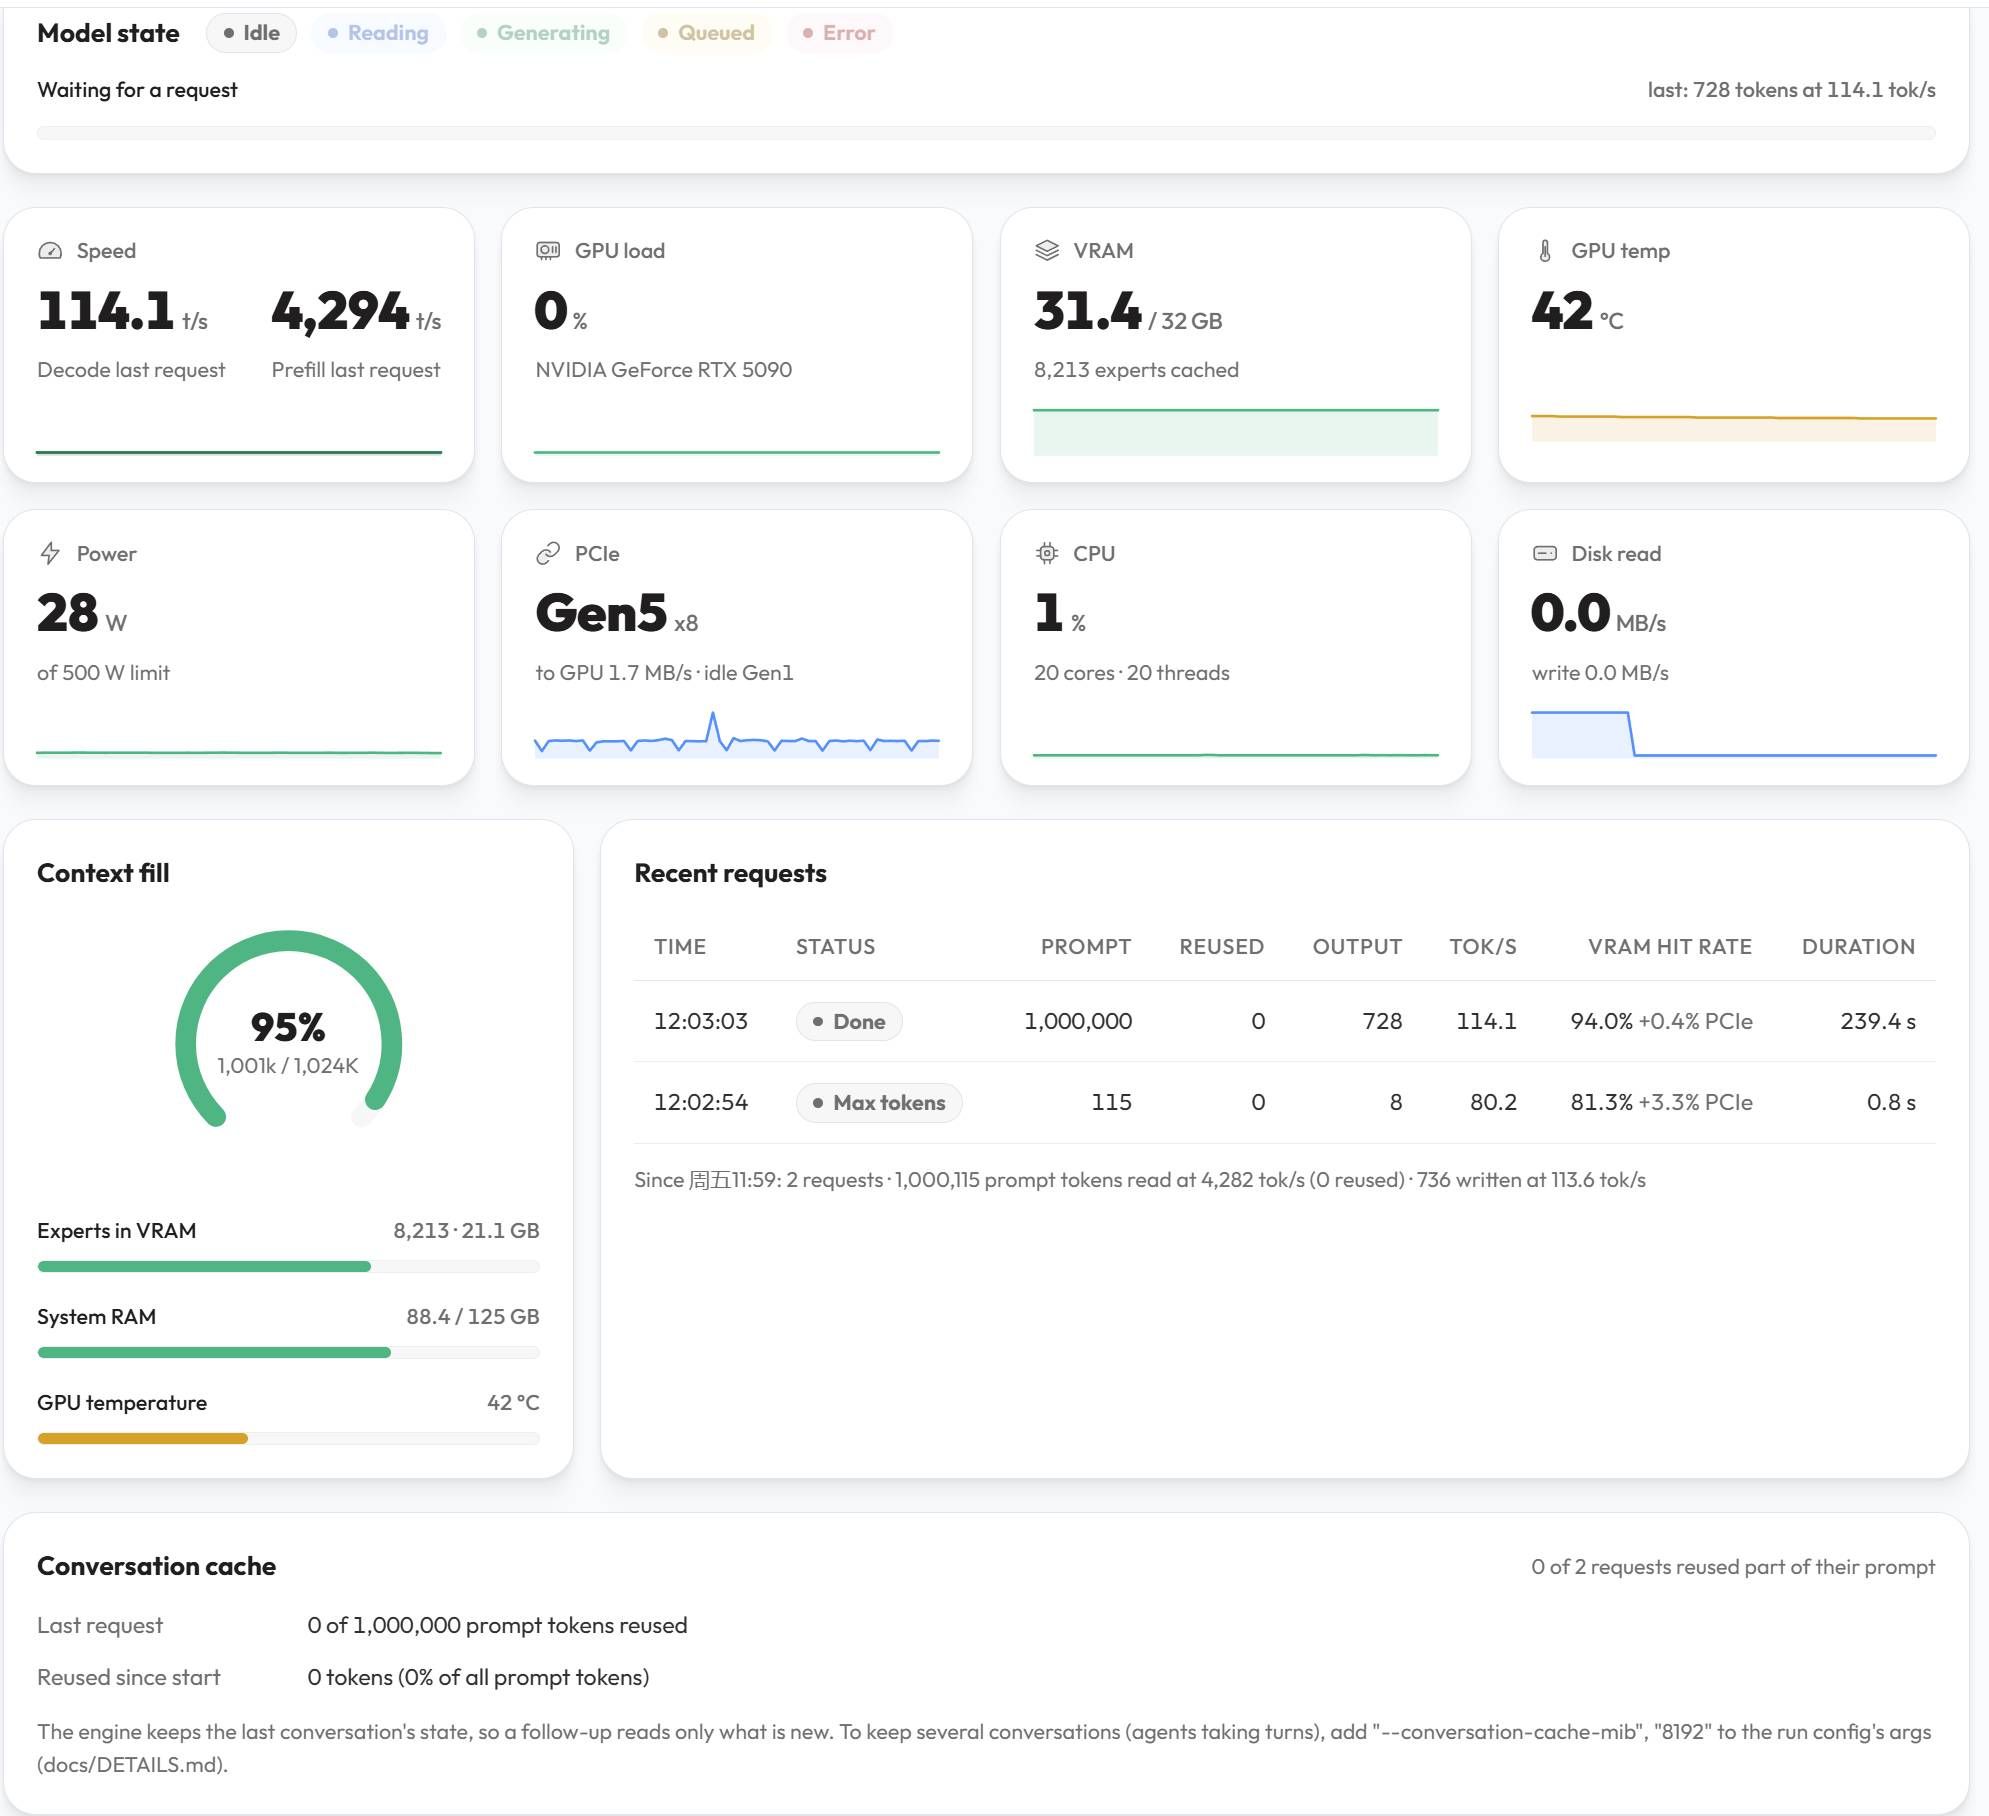
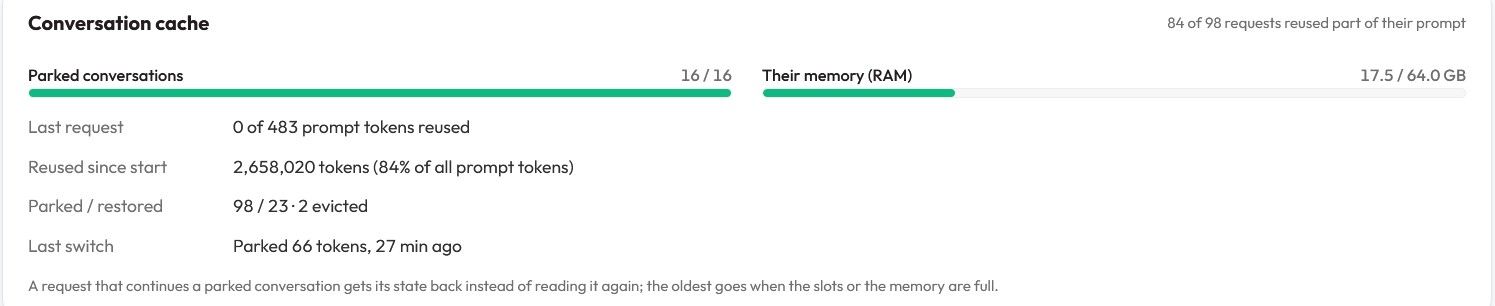
i9-13900K + 128G + RTX5090 + Strata + MTP 部署 Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF
-
-
-
-
@Marck-Wong 内存「吃满」本身不会让 token/s 变快,它决定的是「会不会因为换页/重算而掉速」。
拆开看:
- 5080 16G 跑 Flash-Next / Strata,权重放显存或内存按需过 PCIe;多出来的 64G 只让你能常驻更大的量化档/更多专家、避免落盘,但 CPU
 GPU 传输和 DDR5 双通道带宽仍是天花板。
- 每个 token 要过多少参数/专家,不因内存变大而减少;只有带宽变宽才会快。
- 64G→128G 只在两种情况值得:① 现在已经在 swap / 内存不足导致抖动;② 要把整模 Q8 / 更多专家常驻,减少磁盘 paging。否则纯推理速度基本不变。
先测再花钱:长上下文 + 长输出跑一遍,看
free -h的 available/swap 有没有掉,nvidia-smi dmon里 GPU 利用率有没有周期性掉到 0(在等数据)。有掉再换,没掉就把钱留给显卡。 - 5080 16G 跑 Flash-Next / Strata,权重放显存或内存按需过 PCIe;多出来的 64G 只让你能常驻更大的量化档/更多专家、避免落盘,但 CPU
-
感谢分享 我就好奇 能不能把内存吃满 会带来速度的提升?我现在是5080+64G 我在想要不要换128G内存 谢谢大佬
-
@Marck-Wong 我尝试过了 没提升 这个是 Strata 推理框架的问题吧 不然就用 其他模型和框架了
-
@Marck-Wong 我尝试过了 没提升 这个是 Strata 推理框架的问题吧 不然就用 其他模型和框架了
@matrix-0 谢谢大佬测试