跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 我的4×3090终于不再“绑在一起”:双卡200K MoE + 单卡Vision Sidecar,本地Agent开始Token自由

我的4×3090终于不再“绑在一起”:双卡200K MoE + 单卡Vision Sidecar,本地Agent开始Token自由

已定时 已固定 已锁定 已移动 LLM讨论区
rtx3090strata多卡部署
11 帖子 6 发布者 530 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • JumpEggKillerJ
    JumpEggKillerJ
    JumpEggKiller
    体面乡绅
    编写于 最后由 terry 编辑
    #1

    Qwen3.8 Flash Next 后续:双3090 + IQ4_XS + 200K Context,150K长会话稳定105–110 tok/s,8小时长任务无幻觉无循环,再加了一张3090做Vision Sidecar!

    主要是我的一些探索思路
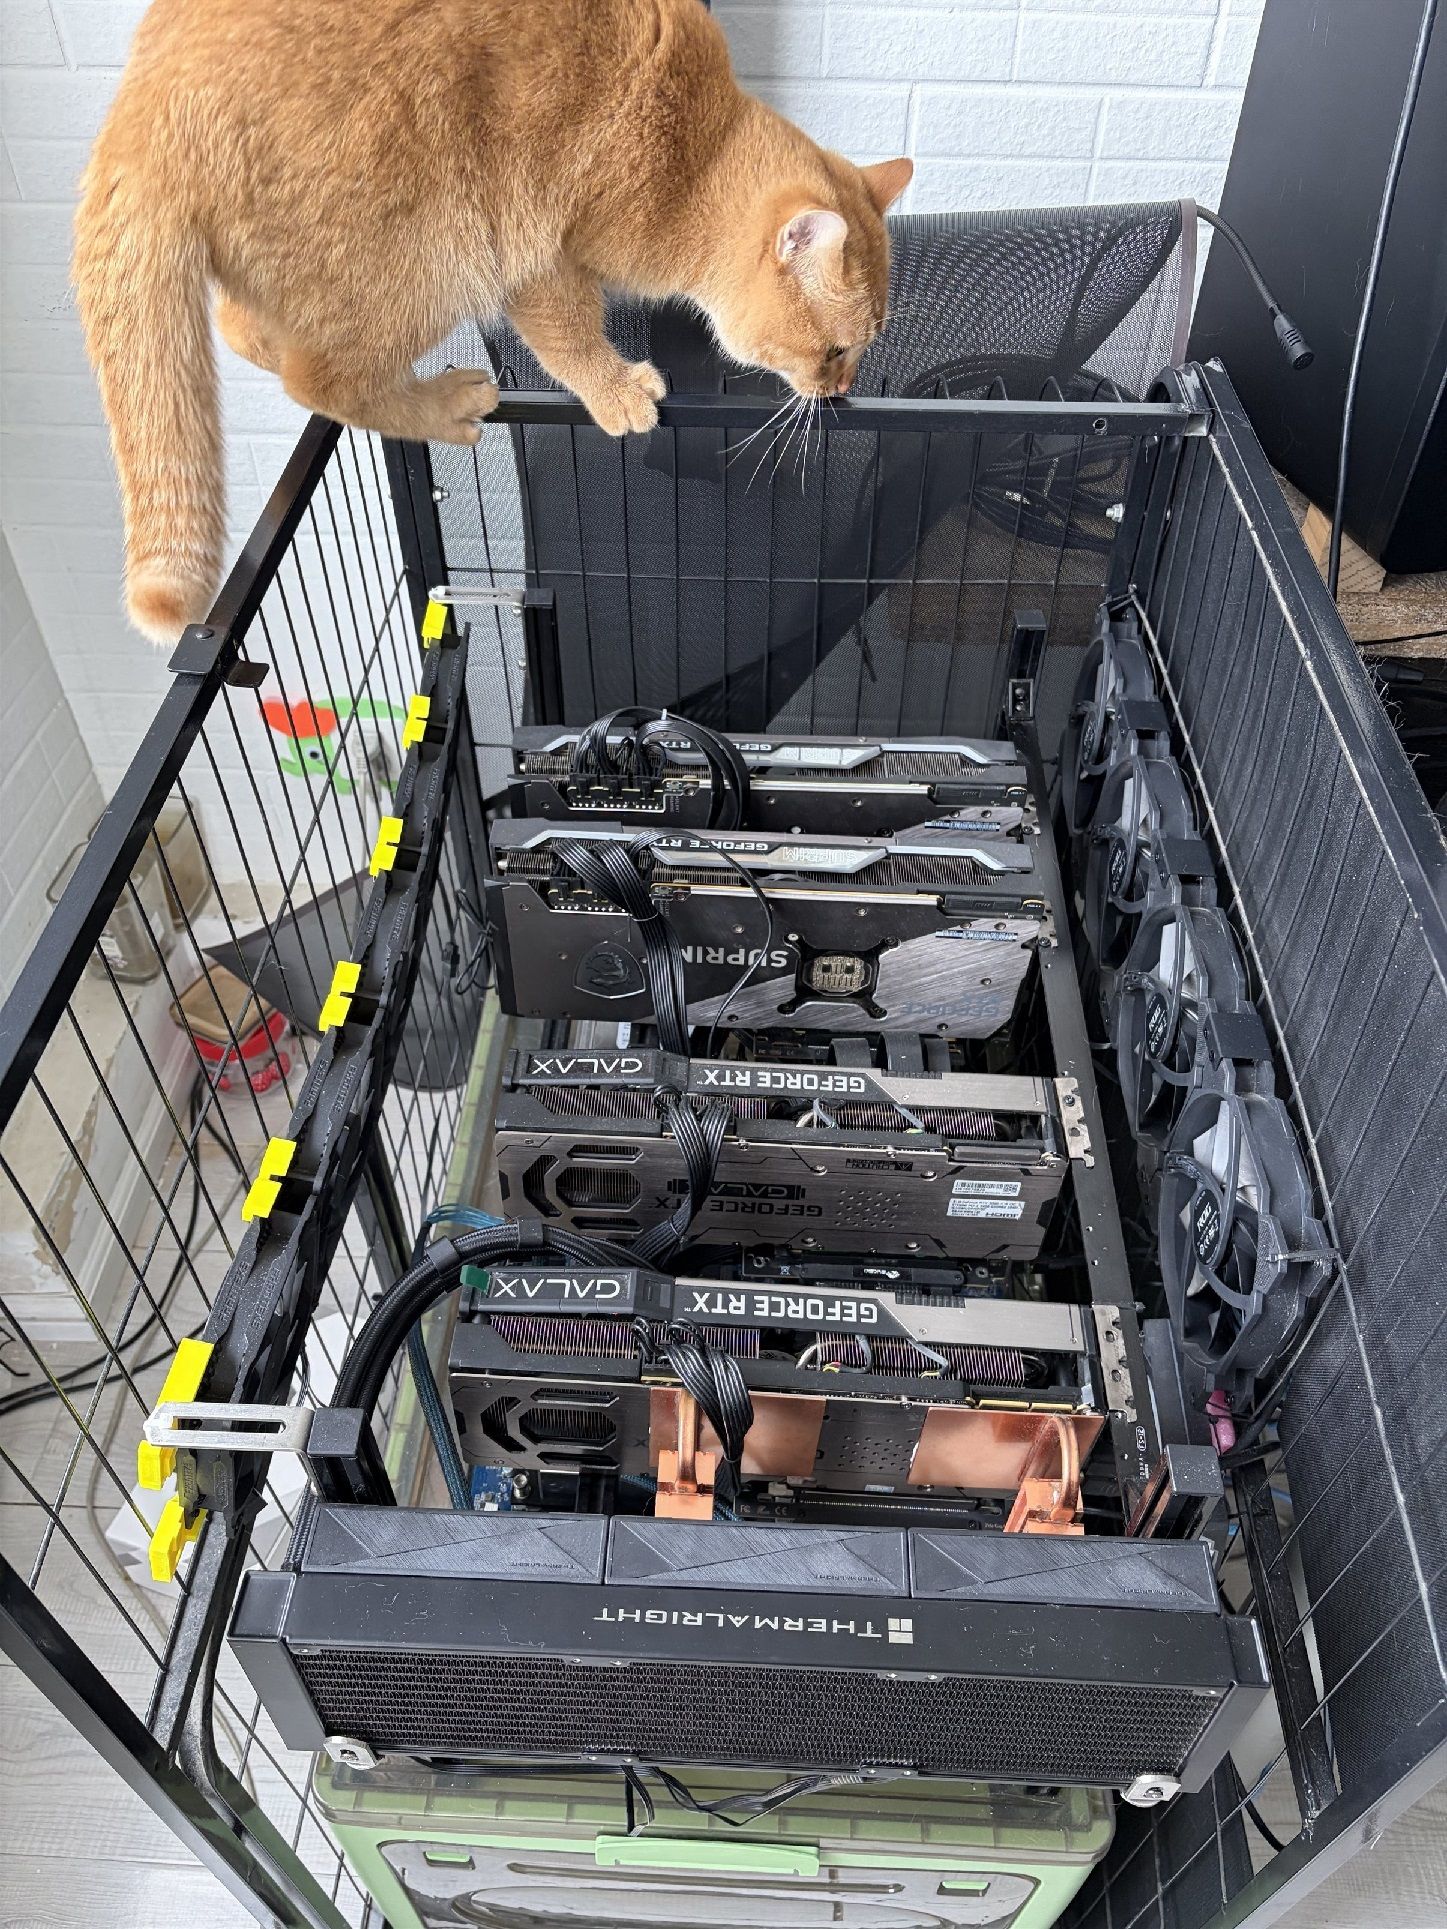
    344cc1a54207b8cb6fb4ec86fafda097.jpg
    分享,大家看看如果手里有3张显卡的情况下是否值得试试。
    a65150ebe6d18f3ae444918dd38bb11a.jpg

    前一阶段我已经分享过 Qwen3.8 Flash Next 从多卡低效一路优化到单卡 100+ tok/s 的过程:
    https://lcz.me/topic/2116

    这次不再重复前面的 benchmark。
    最近这一轮,我更关心的是另外三个问题:

    1. 能不能从 IQ3 升到质量更高的 IQ4_XS,同时维持高速?
    2. 能不能真正把 Context 拉到 200K,并在超长实际会话里持续工作?
    3. Vision 能不能不拖累主模型,而是独立拆出去?
      目前这三个问题基本都有答案了。

    现在我的主力配置已经变成:
    Niko1221/Strata v0.1.39:https://github.com/Niko1221/Strata/releases/tag/v0.1.39
    Qwen3.8 Flash Next IQ4_XS
    RTX 3090 ×2
    Max Context:200K
    文本模型不承担 Vision
    而真实使用中,一个已经增长到约 150K Context 的持续会话,Decode 长期保持在:
    105~110 tok/s
    同时我还完成了一次约 8 小时的连续实际任务。
    在这次长任务中:
    没有观察到明显幻觉恶化
    没有出现重复循环
    没有发生 Context 越长、输出越不稳定的现象
    这对我来说,比单次 benchmark 跑出一个很高的峰值更重要。

    一、从“单卡100+”转向“质量优先的双卡 IQ4_XS”
    上一阶段,我已经通过 Strata Custom Fork 把 Flash Next 做到了单3090、100+ tok/s。
    但那时候我真正担心的不是速度。
    而是:
    如果我要让这个模型长期承担 Agent、代码、文件分析、长任务甚至几个小时连续工作的主模型,低量化是不是还值得继续?
    所以后面我把目标改了。
    不再追求:
    “最低显存占用下的最高 tok/s”
    而是追求:
    “质量、上下文、速度、稳定性四项同时成立”。
    最终我切到了:
    Qwen3.8 Flash Next IQ4_XS
    Runtime:
    Niko1221/Strata v0.1.39
    GPU:
    RTX3090 ×2
    这一步最大的意义不是“又多用了一张3090”。
    而是我终于可以在自己愿意长期使用的量化质量下,同时保留:
    200K Context
    以及 100 tok/s 级别的真实生成性能。

    二、现在最让我满意的不是峰值,而是150K真实会话性能
    目前我实际使用中的一个会话已经累计到大约:
    150K Context
    而不是测试里临时塞进去一个 150K Prompt。
    也就是说,它是一个真正不断增长的工作 Session。
    当前这种情况下:
    平均 Decode ≈ 105~110 tok/s
    这个数据和单次 Cold benchmark 的意义完全不同。
    因为我真正想知道的是:
    模型聊了很久以后还快不快?
    Agent 做了大量工具调用以后还稳不稳?
    Context 已经十几万 token 后,Decode 会不会明显崩掉?
    目前答案都比我预期要好。
    在大约 150K Context 时,仍然能够长期维持三位数 tok/s。
    对我来说,这已经从“本地模型 benchmark”进入了“可以直接拿来干活”的阶段。

    三、200K Context 对我来说终于不再只是一个启动参数
    目前主模型的 Context 上限设为:
    200K
    这里我现在越来越在意一个区别:
    “能启动 200K”
    和
    “能在 200K Profile 下长期正常工作”
    完全不是一回事。
    很多长上下文配置可以成功启动,也可以完成一次 retrieval benchmark。
    但真正进入长期 Agent workload 后,可能出现:
    速度明显衰减
    重复
    循环
    逻辑稳定性下降
    长期任务后输出退化
    所以这次我没有只测短 benchmark。
    而是直接拿它跑真实任务。

    四、8小时连续实际任务:这是我现在最看重的一项测试
    目前已经完成过一次:
    约 8 小时连续实际任务
    不是简单地让模型无限生成文本。
    而是我平时真正会运行的长期工作流。
    结果是:
    整个过程中没有观察到明显幻觉
    没有 repetition loop
    没有出现输出逐渐陷入模板化循环
    没有因为 Context 持续增长而明显失控
    模型在长时间运行后的行为,和任务刚开始时基本保持一致。
    这里我不想说:
    “IQ4_XS 永远不会幻觉”。
    这显然不可能。
    更准确的结论是:
    在我这次约 8 小时的真实 workload 中,没有观察到因为长 Context 或长时间运行导致的异常幻觉、重复或循环问题。
    对我来说,这比单独一张:
    “峰值 120 tok/s”
    的截图有价值多了。

    五、为什么最后没有让 Flash Next 同时负责 Vision
    然后我又遇到另一个问题。
    我的实际工作并不只有文本。
    Hermes Local 和 DSH Local 平时还需要处理:
    截图
    图片
    界面
    文档中的视觉内容
    图片分析
    一些多模态 Agent 任务
    如果一定要求文本主模型自己支持 Vision,就会立刻多出一堆约束:
    模型选择受限
    Runtime 受限
    显存压力变大
    Context 管理更复杂
    文本性能可能受到影响
    更重要的是:
    为了偶尔看一张图片,让整个主模型长期背着 Vision 能力,并不一定合理。
    所以我后来换了一个思路:
    不要找一个什么都做的模型。
    直接拆。

    六、现在增加了一套独立 Vision Sidecar
    目前额外拿出一张 RTX3090。
    专门运行:
    vLLM
    Qwen3-VL-4B-Instruct
    BF16
    这张卡完全独立于 Flash Next 文本主模型。
    现在整个结构变成:
    文本:
    Qwen3.8 Flash Next IQ4_XS
    Strata v0.1.39
    RTX3090 ×2
    200K Context
    视觉:
    Qwen3-VL-4B-Instruct BF16
    vLLM
    RTX3090 ×1
    这样 Hermes Local 和 DSH Local 可以按照任务类型直接路由。
    普通文本、代码、Agent、长上下文:
    → Flash Next
    需要看图:
    → Vision Sidecar
    图片处理结束后:
    → 结果再交回文本主模型继续推理
    我现在反而觉得,这比强行追求一个“全能大模型”合理得多。

    七、为什么4B Vision反而非常适合做Sidecar
    这里我并不需要 Vision 模型承担复杂的主推理。
    主推理已经有 Flash Next。
    Vision Sidecar 更重要的是:
    看清楚
    识别正确
    输出结构化视觉信息
    速度够快
    占用显存合理
    所以 Qwen3-VL-4B-Instruct BF16 对这个位置其实很合适。
    而且我直接跑 BF16。
    不需要为了省显存再牺牲视觉模型质量。
    因为它有自己独占的一张 24GB 3090。
    这也是 Sidecar 架构一个很大的好处:
    每个模型都可以选自己最舒服的精度和 Runtime。
    文本模型不需要为了 Vision 妥协。
    Vision 模型也不用为了和大 MoE 抢显存而量化到很低。

    八、现在我的三张3090实际上形成了这种分工
    RTX3090 #1:
    Qwen3.8 Flash Next IQ4_XS
    RTX3090 #2:
    Qwen3.8 Flash Next IQ4_XS
    RTX3090 #3:
    Qwen3-VL-4B-Instruct BF16 / vLLM
    剩下的 GPU 资源还可以继续用于:
    实验
    生图
    其他 Sidecar
    备用 Runtime
    新的模型测试
    这和我之前“四张GPU一定要全部参与同一个模型”的思路已经完全不同。
    现在我更倾向于:
    把 GPU 当成一个本地 AI 资源池。
    而不是把所有 GPU 强行绑成一个超大推理实例。

    九、现在Hermes Local / DSH Local的使用体验
    这次升级对我来说最大的改变,其实不是 benchmark。
    而是日常工作方式。
    现在 Hermes Local 和 DSH Local 里:
    普通聊天
    代码
    Agent
    文件分析
    长文处理
    超长上下文
    图片理解
    截图分析
    视觉任务
    基本都可以在本机完成。
    文本走 Flash Next。
    图片走 VL Sidecar。
    上层 Agent 不需要关心底层到底调用了哪张 GPU。
    这才是我真正想要的体验。

    十、所谓“Token自由”是什么意思
    这里我说的 Token 自由,并不是模型计算不需要 token。
    而是:
    常规任务已经不再受外部 API 的 token 计费和额度约束。
    以前我跑一个几个小时的 Agent 任务,会自然考虑:
    用了多少百万 token?
    要花多少钱?
    上下文还能不能继续?
    是否需要为了 API 成本压缩历史记录?
    现在对于常规任务,这些顾虑基本消失了。
    如果一个任务需要跑:
    1小时
    3小时
    8小时
    或者持续积累十几万 Context
    主要成本已经变成:
    我自己的 GPU
    电费
    以及时间。
    而不是:
    每生成一个 token 都在增加 API 账单。
    这就是我这里所谓的:
    “常规任务 Token 自由”。

    十一、当前这套系统最关键的数据
    文本主模型:
    Qwen3.8 Flash Next IQ4_XS
    Runtime:
    Niko1221/Strata v0.1.39
    GPU:
    RTX3090 ×2
    最大 Context:
    200K
    Vision:
    关闭 / 独立 Sidecar
    实际长期会话:
    约 150K Context
    Decode:
    平均约 105~110 tok/s
    长期任务测试:
    约 8 小时
    结果:
    未观察到明显幻觉恶化
    未观察到 repetition loop
    未观察到长时间运行后的输出崩坏
    Vision Sidecar:
    Qwen3-VL-4B-Instruct
    BF16
    vLLM
    RTX3090 ×1
    上层:
    Hermes Local
    DSH Local

    十二、和我上一阶段最大的区别
    上一阶段我解决的是:
    “Qwen3.8 Flash Next 到底能不能在消费级3090上跑得很快?”
    答案已经是:
    可以。
    这一次解决的是:
    “跑得快以后,它能不能真正成为长期使用的主模型?”
    目前我的答案也开始变成:
    可以。
    而且我现在越来越觉得:
    本地 Agent 的最终形态可能根本不是一个“万能模型”。
    而是:
    一个强文本主脑

    多个专门的 Sidecar
    比如:
    Vision
    Embedding
    OCR
    Speech
    TTS
    Image Generation
    甚至 Router
    主模型只负责自己最擅长的推理和长 Context。
    其他能力按需调用。
    这样反而比试图把所有能力全部塞进一个模型,资源利用率更高,也更容易升级。

    最终架构
    现在我的实际结构可以简单写成:
    Hermes Local / DSH Local
    ↓
    任务路由
    ↓
    文本任务
    → Qwen3.8 Flash Next IQ4_XS
    → Strata v0.1.39
    → RTX3090 ×2
    → 200K Context
    → 150K Session ≈105~110 tok/s
    图片任务
    → Qwen3-VL-4B-Instruct BF16
    → vLLM
    → RTX3090 ×1
    ↓
    结果重新汇入 Agent 工作流

    现在这套东西对我而言已经不再只是:
    “4张3090可以跑什么大模型?”
    而开始变成:
    “4张3090如何组成一套真正长期可用的本地 AI 基础设施?”

    这是我觉得这一阶段最值得分享的变化。

    1 条回复 最后回复
    2
    • terryT
      terryT
      terry
      易有太极
      编写于 最后由 编辑
      #2

      太乱了我弟,你让AI整理成markdown啊。你还真弄了个猫,橘猫挺可爱的。

      油管:https://www.youtube.com/@抡锤者

      JumpEggKillerJ 1 条回复 最后回复
      0
      • terryT terry

        太乱了我弟,你让AI整理成markdown啊。你还真弄了个猫,橘猫挺可爱的。

        JumpEggKillerJ
        JumpEggKillerJ
        JumpEggKiller
        体面乡绅
        编写于 最后由 编辑
        #3

        @terry 好的,下次整markdown。这个猫笼机箱就是为了防它。哈哈哈

        1 条回复 最后回复
        0
        • johnnybegoodJ
          johnnybegoodJ
          johnnybegood
          王侯将相
          编写于 最后由 编辑
          #4

          橘猫AI手工作坊。

          JumpEggKillerJ 1 条回复 最后回复
          0
          • M
            M
            Michael Zhou
            体面乡绅
            编写于 最后由 编辑
            #5

            终于看到有人用单独的 vision 方案了,我一直这么用。

            JumpEggKillerJ 1 条回复 最后回复
            0
            • Queen LauraQ
              Queen LauraQ
              Queen Laura
              体面乡绅
              编写于 最后由 编辑
              #6

              很棒啊,这个多卡方案!

              JumpEggKillerJ 1 条回复 最后回复
              0
              • F
                F
                franklee006
                编写于 最后由 franklee006 编辑
                #7

                我也測試過雙卡用Q4,decode 是可以保持70%但prefill 掉很多只有原來2x%。最後用回q3_s

                1 条回复 最后回复
                0
                • JumpEggKillerJ
                  JumpEggKillerJ
                  JumpEggKiller
                  体面乡绅
                  编写于 最后由 编辑
                  #8

                  现在Strata更新支持了越来越多的老显卡,然后双卡也快很多,快更新试试

                  1 条回复 最后回复
                  0
                  • M Michael Zhou

                    终于看到有人用单独的 vision 方案了,我一直这么用。

                    JumpEggKillerJ
                    JumpEggKillerJ
                    JumpEggKiller
                    体面乡绅
                    编写于 最后由 编辑
                    #9

                    @Michael-Zhou 棒棒的

                    1 条回复 最后回复
                    0
                    • johnnybegoodJ johnnybegood

                      橘猫AI手工作坊。

                      JumpEggKillerJ
                      JumpEggKillerJ
                      JumpEggKiller
                      体面乡绅
                      编写于 最后由 编辑
                      #10

                      @johnnybegood 哈哈哈,天天跟三只猫斗智斗勇

                      1 条回复 最后回复
                      0
                      • Queen LauraQ Queen Laura

                        很棒啊,这个多卡方案!

                        JumpEggKillerJ
                        JumpEggKillerJ
                        JumpEggKiller
                        体面乡绅
                        编写于 最后由 编辑
                        #11

                        @Queen-Laura 666

                        1 条回复 最后回复
                        0

                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                        有了你的建议,这篇帖子会更精彩哦 💗

                        注册 登录
                        回复
                        • 在新帖中回复
                        登录后回复
                        • 从旧到新
                        • 从新到旧
                        • 最多赞同


                        • 登录

                        • 登录或注册以进行搜索。
                        • 第一个帖子
                          最后一个帖子
                        0
                        • 版块
                        • 最新
                        • 标签
                        • 热门
                        • 用户
                        • 群组