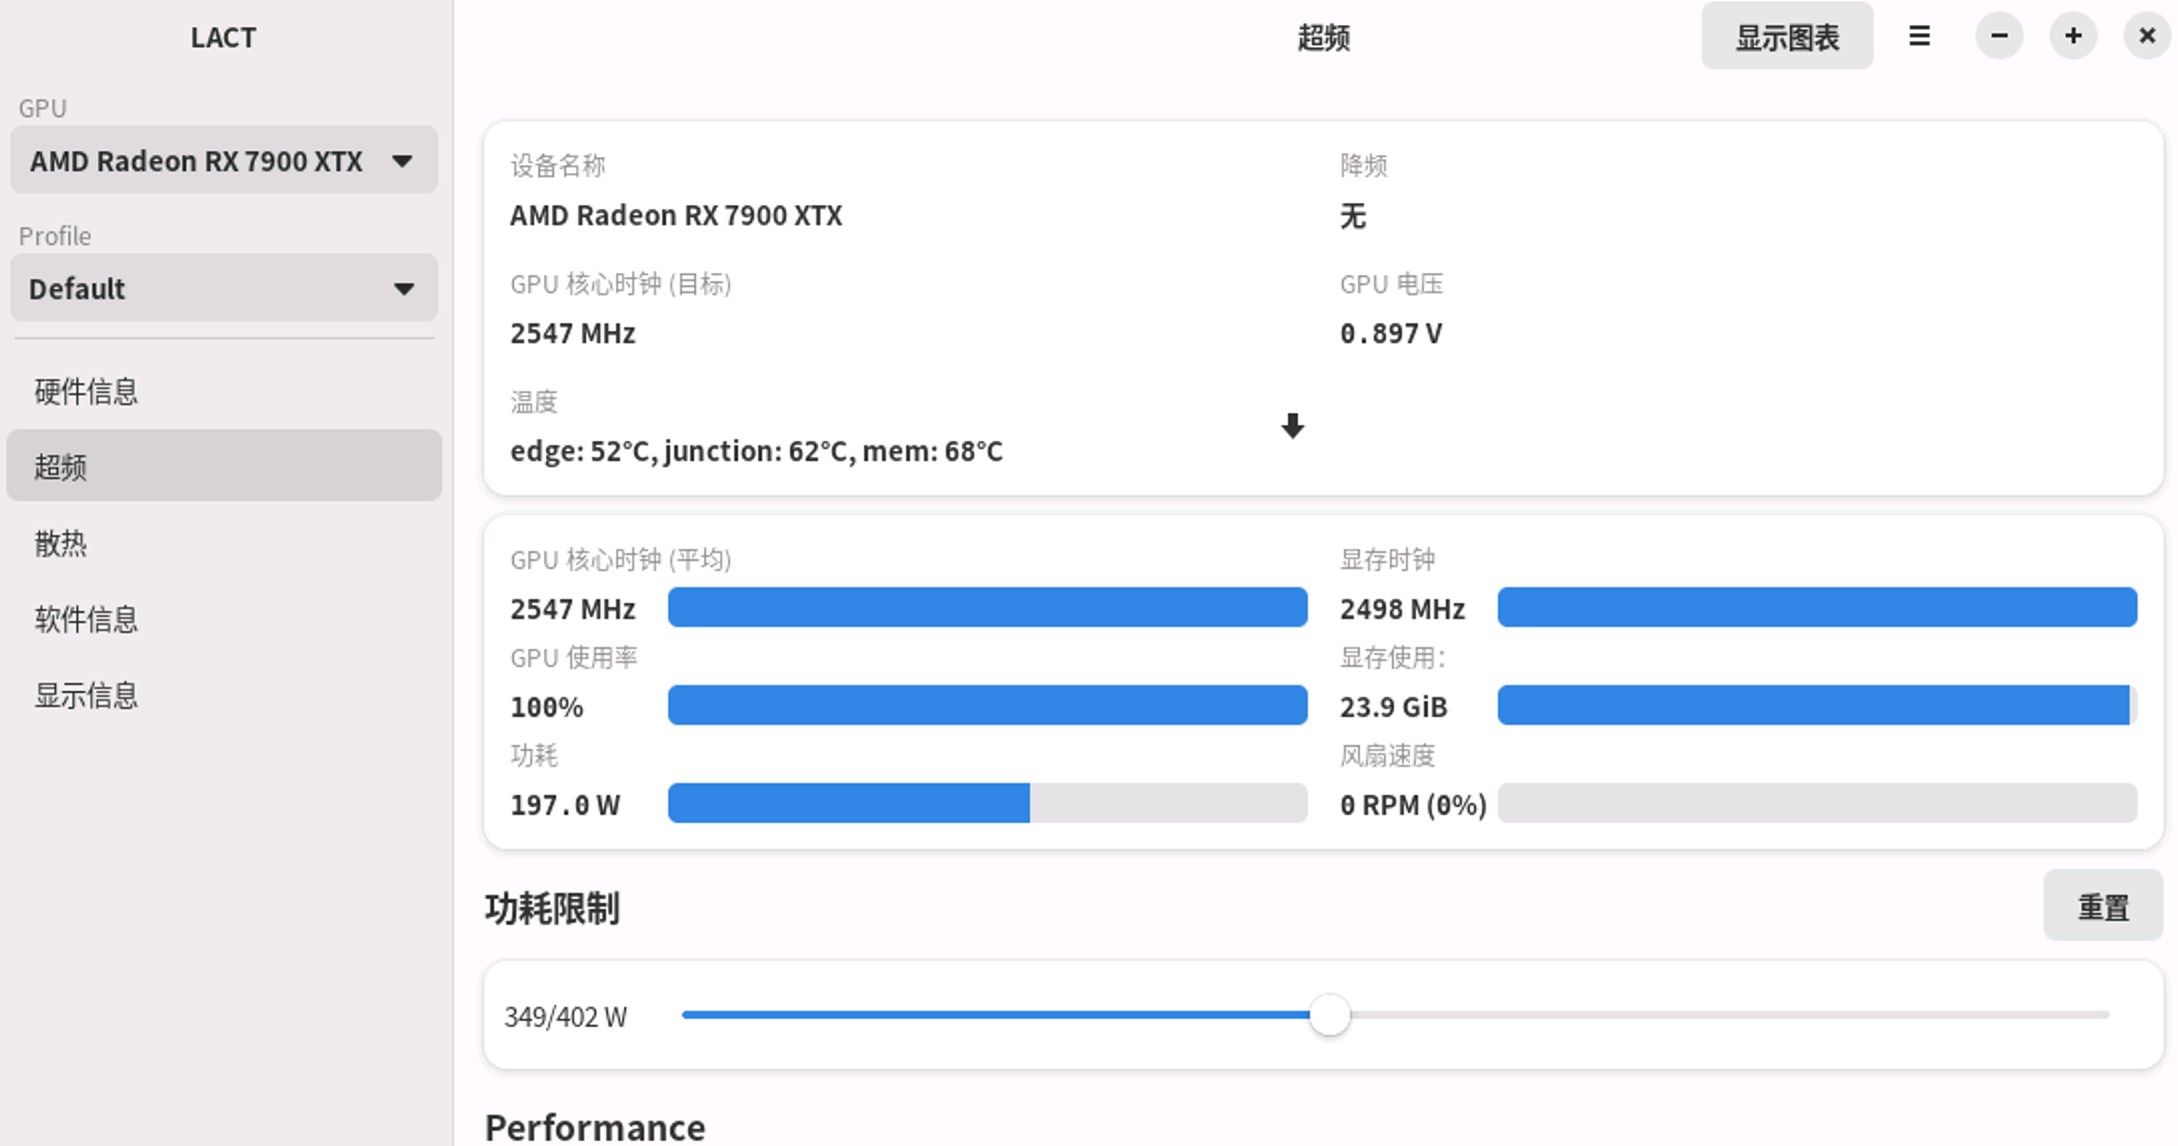
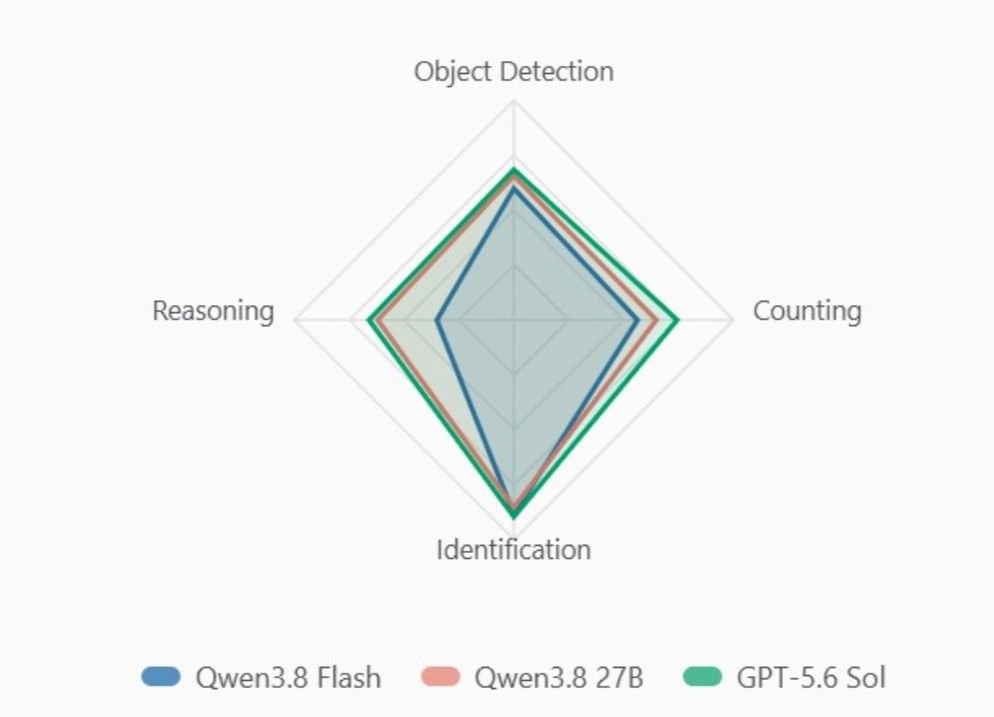
跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. strata并发成功,双7900xtx , 单流70-80token/s , 双流聚合 160 token/s

strata并发成功,双7900xtx , 单流70-80token/s , 双流聚合 160 token/s

已定时 已固定 已锁定 已移动 热议 LLM讨论区
7900xtxstrataqwen-flash
43 帖子 13 发布者 2.0k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 kos or 编辑
    #2

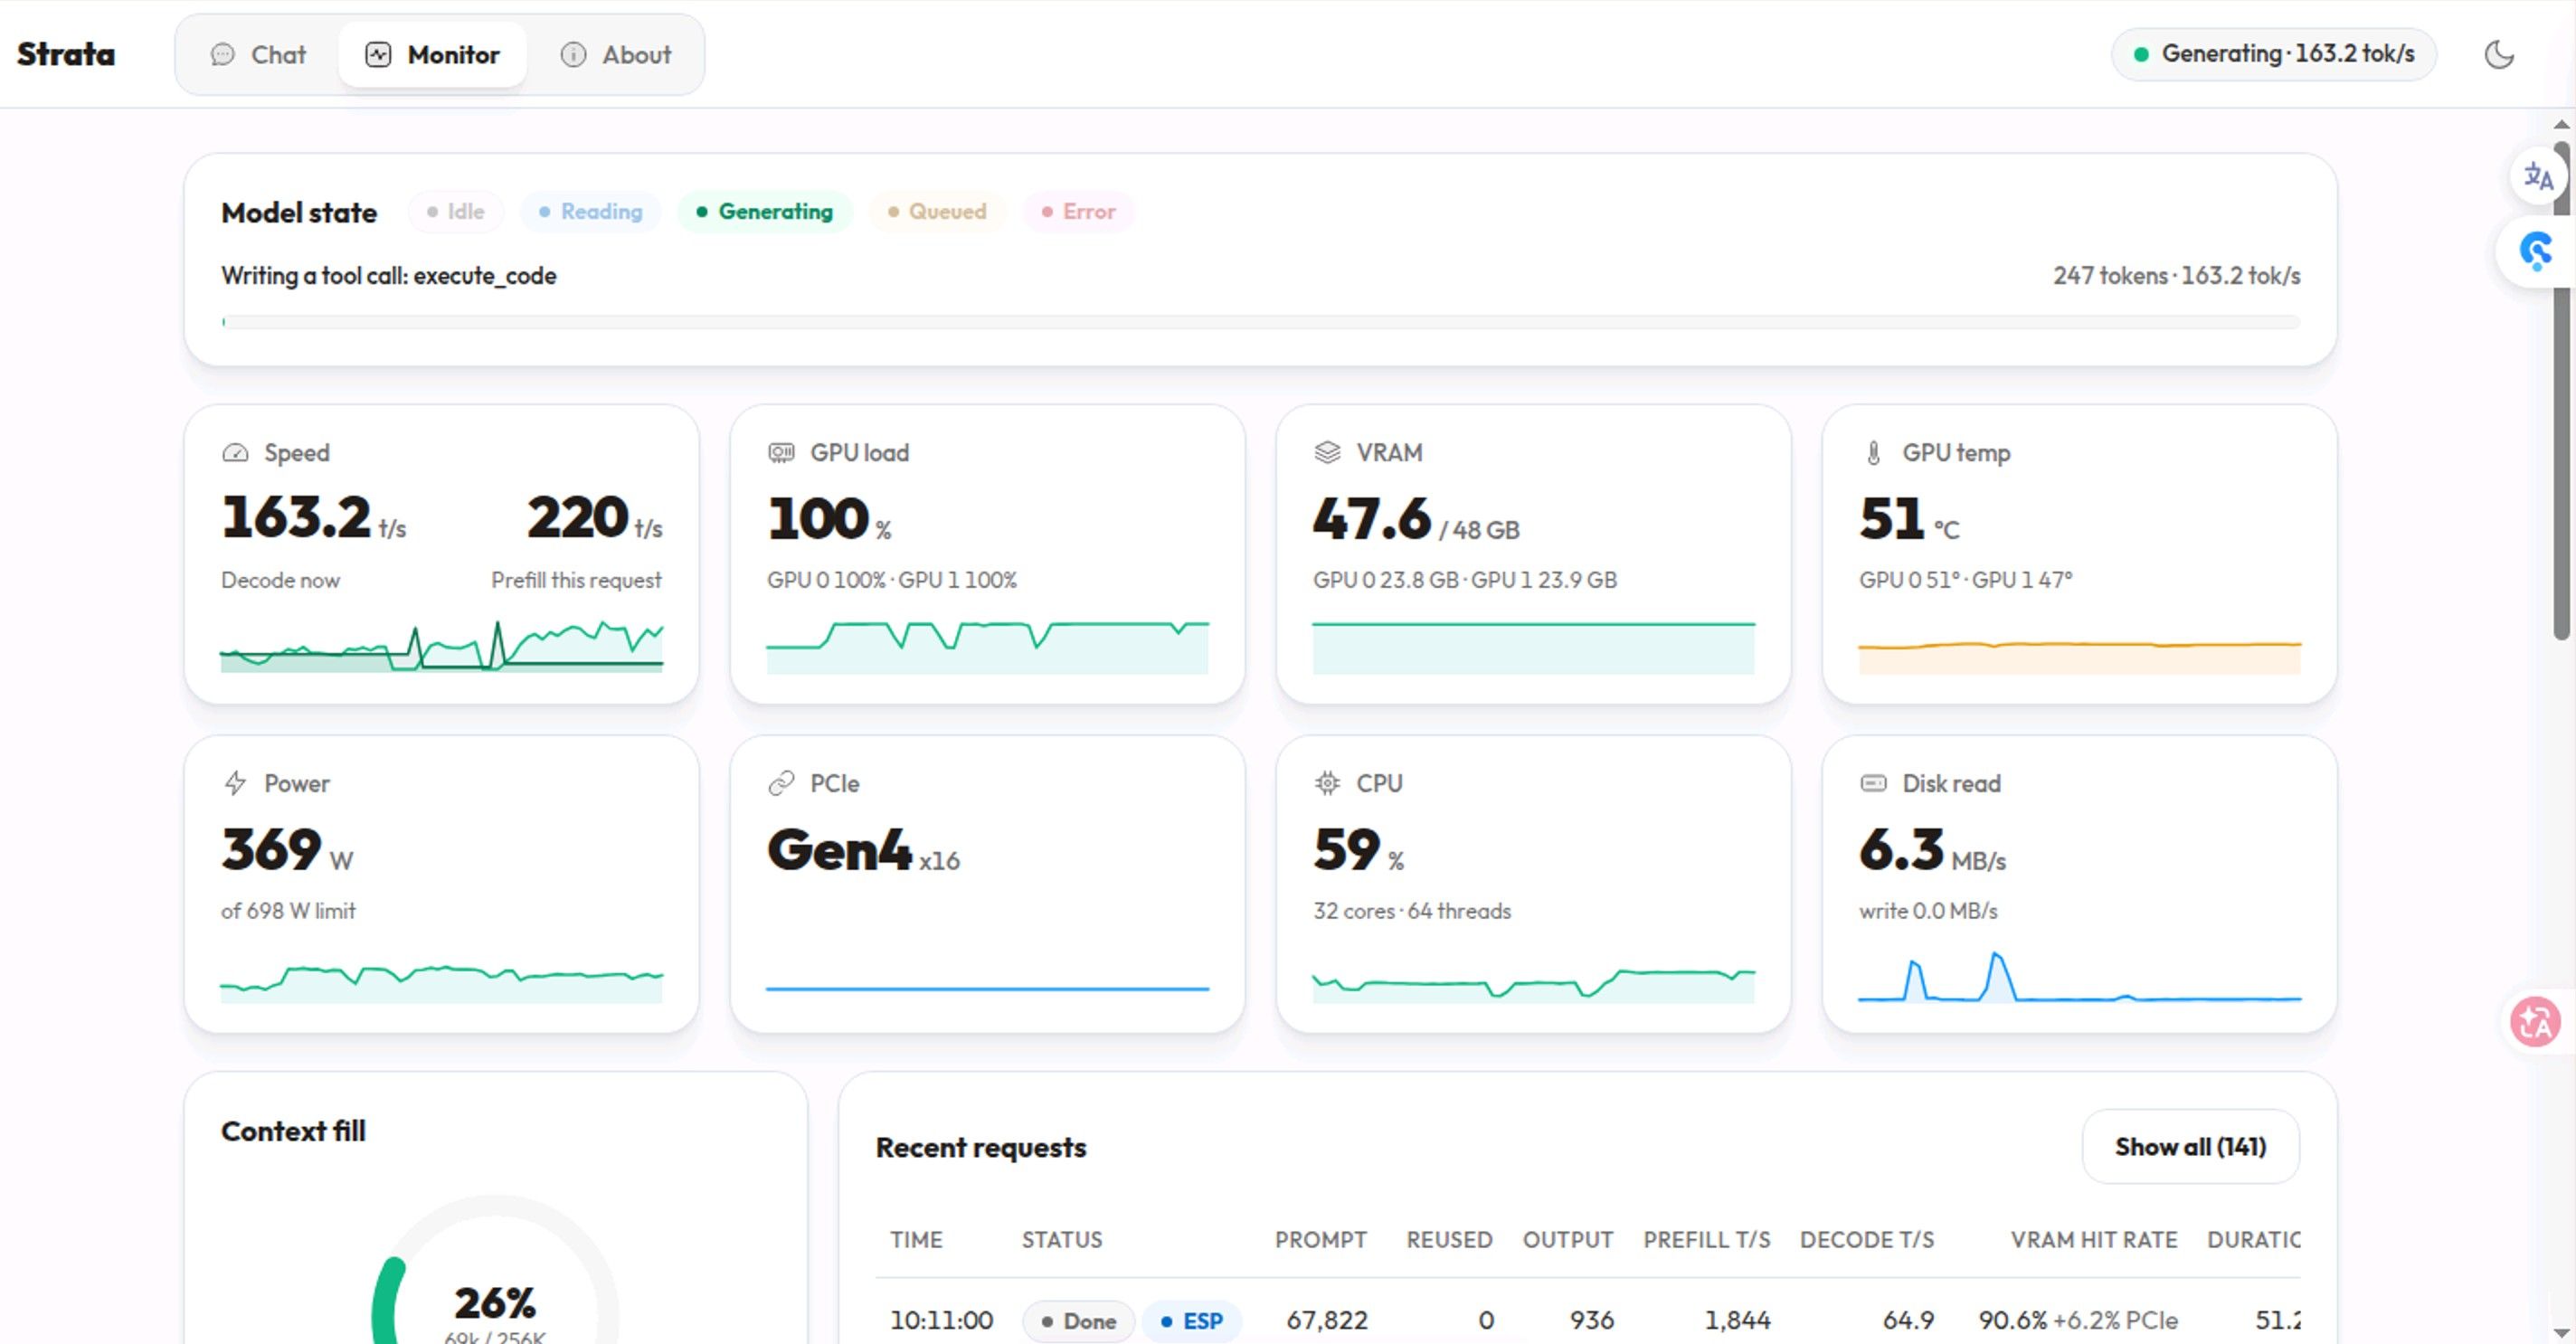
    太棒了 Strata 可以進行并发 concurrency了?請問Strata 版本是多少呢 (看到了Strata:v0.1.43)

    GPU溫度這麼低 對 RX 7900 XTX 是大利多
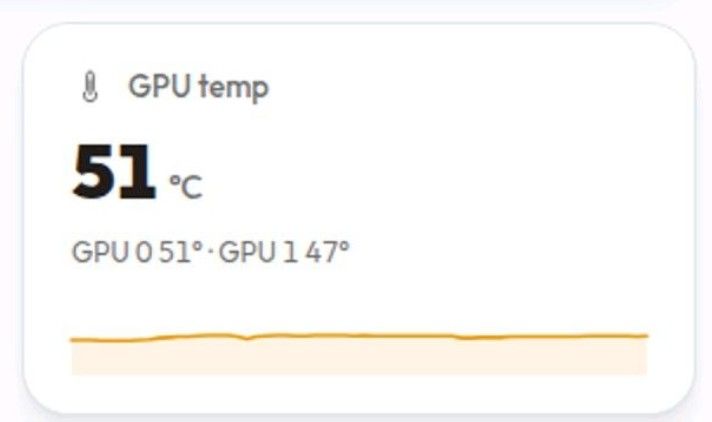
    image.jpeg

    farmer nodeF 2 条回复 最后回复
    2
    • kos orK kos or

      太棒了 Strata 可以進行并发 concurrency了?請問Strata 版本是多少呢 (看到了Strata:v0.1.43)

      GPU溫度這麼低 對 RX 7900 XTX 是大利多
      image.jpeg

      farmer nodeF
      farmer nodeF
      farmer node
      体面乡绅 硕果累累
      编写于 最后由 编辑
      #3

      @kos-or 对的,昨天升级的最新的v0.1.43,但是这里的并发有点类似DP2 的方式,但是用的是同一个 端口, 可以共享一部分内存,我得单流跑内存暂用是60G 左右, 2个实例是90G 左右,共享内存在16G 左右.

      kos orK 1 条回复 最后回复
      2
      • kos orK kos or

        太棒了 Strata 可以進行并发 concurrency了?請問Strata 版本是多少呢 (看到了Strata:v0.1.43)

        GPU溫度這麼低 對 RX 7900 XTX 是大利多
        image.jpeg

        farmer nodeF
        farmer nodeF
        farmer node
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #4

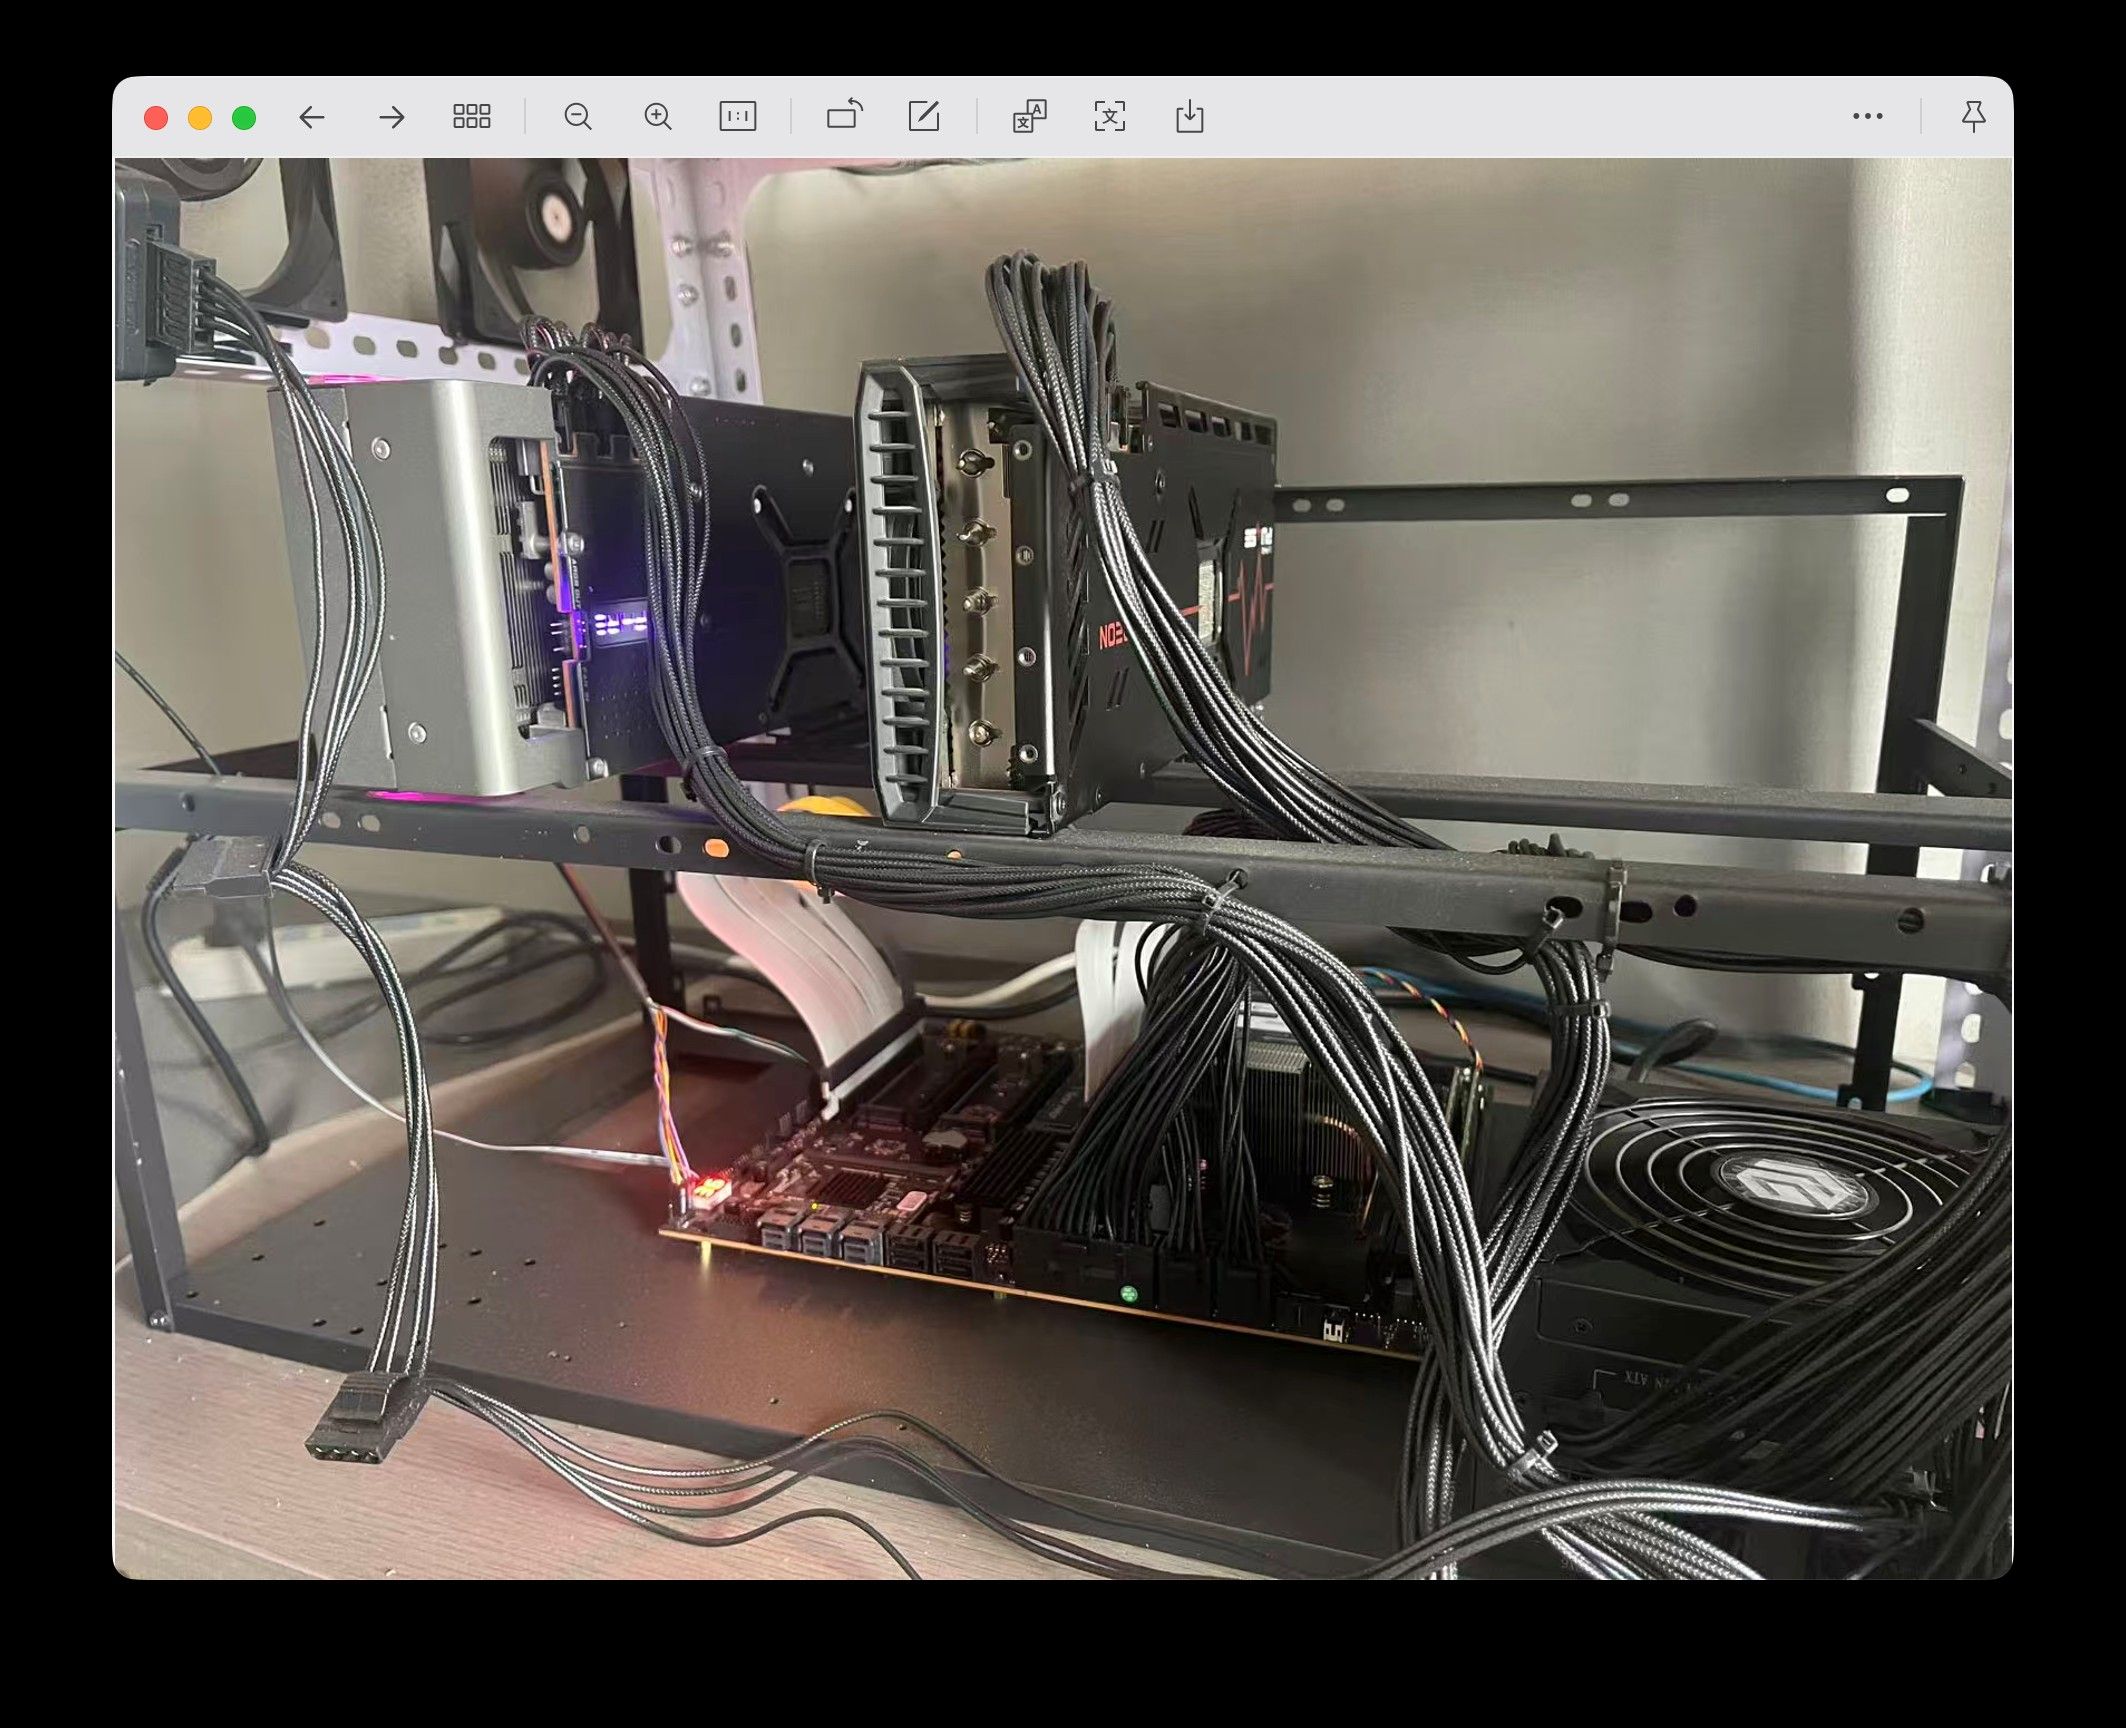
        @kos-or 我的是开放式机架,没有用机箱 。
        image.jpeg

        1 条回复 最后回复
        1
        • ,terryT terry 固定了此主题
        • terryT
          terryT
          terry
          易有太极
          编写于 最后由 编辑
          #5

          下次把硬件图放到文章里,一起啊。格式工整,双卡意义虽然不如SGLang那么关键,但是也为爽xtx提供了新的玩法。这张卡的性价比之王地位又加强了。

          油管:https://www.youtube.com/@抡锤者

          farmer nodeF 1 条回复 最后回复
          3
          • kos orK
            kos orK
            kos or
            至尊皇帝
            编写于 最后由 编辑
            #6

            這機制感覺很巧妙 希望能節省的RAM多一點, 否則開雙實例RAM壓力很大;

            并发方案:双单卡 replicas
            这次没有采用传统意义上的 TP2 或 layer split,而是使用 Strata 自带的 replicas 机制:
            replica 0 → GPU0
            replica 1 → GPU1

            共享专家 arena
            两个副本通过下面的文件共享主机侧专家 arena:

            共享 arena 可以避免两个副本把专家权重完整复制两份到主机内存。
            但是,共享 arena 不会共享以下内容:
            GPU expert cache;
            KV cache;
            MTP 草稿状态;
            会话状态;
            请求状态;
            每个副本的运行时工作集。

            farmer nodeF 1 条回复 最后回复
            2
            • terryT terry

              下次把硬件图放到文章里,一起啊。格式工整,双卡意义虽然不如SGLang那么关键,但是也为爽xtx提供了新的玩法。这张卡的性价比之王地位又加强了。

              farmer nodeF
              farmer nodeF
              farmer node
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #7

              @terry 好的,下次注意

              1 条回复 最后回复
              0
              • farmer nodeF farmer node

                @kos-or 对的,昨天升级的最新的v0.1.43,但是这里的并发有点类似DP2 的方式,但是用的是同一个 端口, 可以共享一部分内存,我得单流跑内存暂用是60G 左右, 2个实例是90G 左右,共享内存在16G 左右.

                kos orK
                kos orK
                kos or
                至尊皇帝
                编写于 最后由 编辑
                #8

                @farmer-node said:

                单流跑内存暂用是60G 左右, 2个实例是90G 左右,共享内存在16G 左右

                兩個實例 = 单流 60G x 2 = 原本佔用120G
                所以新的技術是節省了 120-90 = 30G RAM嗎?

                farmer nodeF 1 条回复 最后回复
                0
                • kos orK kos or

                  這機制感覺很巧妙 希望能節省的RAM多一點, 否則開雙實例RAM壓力很大;

                  并发方案:双单卡 replicas
                  这次没有采用传统意义上的 TP2 或 layer split,而是使用 Strata 自带的 replicas 机制:
                  replica 0 → GPU0
                  replica 1 → GPU1

                  共享专家 arena
                  两个副本通过下面的文件共享主机侧专家 arena:

                  共享 arena 可以避免两个副本把专家权重完整复制两份到主机内存。
                  但是,共享 arena 不会共享以下内容:
                  GPU expert cache;
                  KV cache;
                  MTP 草稿状态;
                  会话状态;
                  请求状态;
                  每个副本的运行时工作集。

                  farmer nodeF
                  farmer nodeF
                  farmer node
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #9

                  @kos-or 对呀,很神奇,而且端口统一,不用管任务调度的问题,也是第一次见到这种做法。

                  1 条回复 最后回复
                  1
                  • kos orK kos or

                    @farmer-node said:

                    单流跑内存暂用是60G 左右, 2个实例是90G 左右,共享内存在16G 左右

                    兩個實例 = 单流 60G x 2 = 原本佔用120G
                    所以新的技術是節省了 120-90 = 30G RAM嗎?

                    farmer nodeF
                    farmer nodeF
                    farmer node
                    体面乡绅 硕果累累
                    编写于 最后由 编辑
                    #10

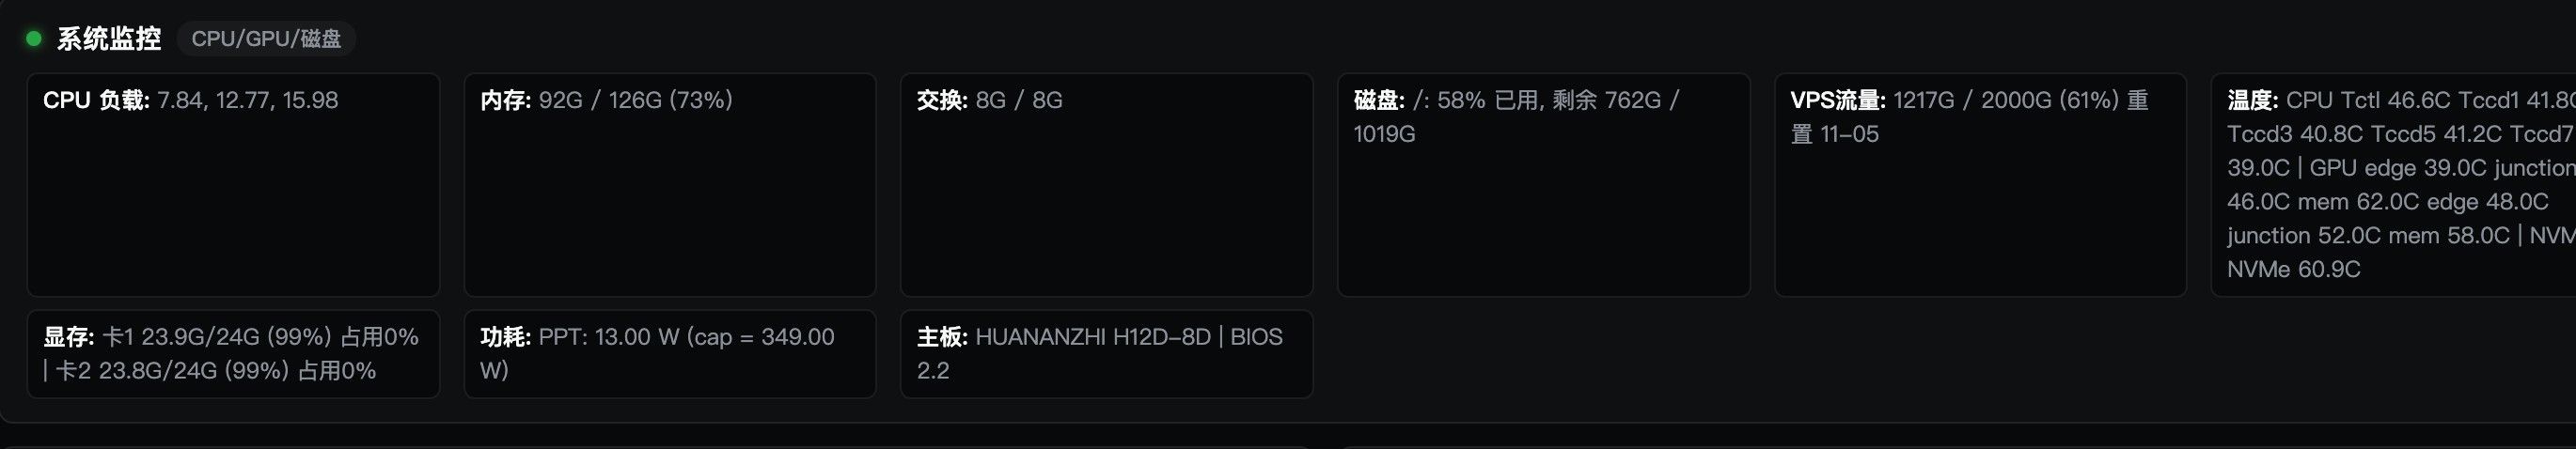
                    @kos-or 我现在内存暂用90G 左右
                    image.jpeg
                    image.jpeg

                    1 条回复 最后回复
                    1
                    • terryT
                      terryT
                      terry
                      易有太极
                      编写于 最后由 编辑
                      #11

                      可以,正好打算做视频,继续水下去,立刻给弄了个素材,说实话,论坛提供的素材都做不完。大家分享的很多东西都很有意义。

                      油管:https://www.youtube.com/@抡锤者

                      farmer nodeF 1 条回复 最后回复
                      2
                      • terryT terry

                        可以,正好打算做视频,继续水下去,立刻给弄了个素材,说实话,论坛提供的素材都做不完。大家分享的很多东西都很有意义。

                        farmer nodeF
                        farmer nodeF
                        farmer node
                        体面乡绅 硕果累累
                        编写于 最后由 编辑
                        #12

                        @terry 哈哈哈,被老特翻牌子也是我得荣幸,哈哈哈

                        1 条回复 最后回复
                        1
                        • 懒人烘培懒
                          懒人烘培懒
                          懒人烘培
                          体面乡绅 硕果累累
                          编写于 最后由 编辑
                          #13

                          看起来可以,找个时间测试一下~

                          双 7900 XTX:模型本地跑,Token 随便烧!

                          farmer nodeF 1 条回复 最后回复
                          1
                          • kos orK
                            kos orK
                            kos or
                            至尊皇帝
                            编写于 最后由 kos or 编辑
                            #14

                            @farmer-node
                            RX7900 XTX 雙卡大利多 :

                            1. RX 7900XTX 雙卡一次跑兩個QFN實例 節省約30G RAM
                            2. .GPU核心溫度50C (原本跑27B 都約在80C) , 顯存溫度約多少?大約60度嗎?
                            3. 雙卡消耗 400W 以內 平均一卡 200W以內
                            4. QFN_IQ3_S 单流70-80token/s , 双流聚合 160 token/s 速度上已經具有可用性了
                            5. Prefill (?) 方面之後看效率上是否能配合Decode
                            farmer nodeF 2 条回复 最后回复
                            0
                            • 懒人烘培懒 懒人烘培

                              看起来可以,找个时间测试一下~

                              farmer nodeF
                              farmer nodeF
                              farmer node
                              体面乡绅 硕果累累
                              编写于 最后由 编辑
                              #15

                              @懒人烘培 嗯,我也没跑多久,可能还有其他问题,大家可以一起测试,一起闭坑。

                              懒人烘培懒 1 条回复 最后回复
                              0
                              • kos orK kos or

                                @farmer-node
                                RX7900 XTX 雙卡大利多 :

                                1. RX 7900XTX 雙卡一次跑兩個QFN實例 節省約30G RAM
                                2. .GPU核心溫度50C (原本跑27B 都約在80C) , 顯存溫度約多少?大約60度嗎?
                                3. 雙卡消耗 400W 以內 平均一卡 200W以內
                                4. QFN_IQ3_S 单流70-80token/s , 双流聚合 160 token/s 速度上已經具有可用性了
                                5. Prefill (?) 方面之後看效率上是否能配合Decode
                                farmer nodeF
                                farmer nodeF
                                farmer node
                                体面乡绅 硕果累累
                                编写于 最后由 编辑
                                #16

                                @kos-or 最近天气凉快了不少,之前夏天的时候mem温度会到80 的,核心温度一般都是50左右,很稳定
                                image.jpeg

                                1 条回复 最后回复
                                0
                                • kos orK kos or

                                  @farmer-node
                                  RX7900 XTX 雙卡大利多 :

                                  1. RX 7900XTX 雙卡一次跑兩個QFN實例 節省約30G RAM
                                  2. .GPU核心溫度50C (原本跑27B 都約在80C) , 顯存溫度約多少?大約60度嗎?
                                  3. 雙卡消耗 400W 以內 平均一卡 200W以內
                                  4. QFN_IQ3_S 单流70-80token/s , 双流聚合 160 token/s 速度上已經具有可用性了
                                  5. Prefill (?) 方面之後看效率上是否能配合Decode
                                  farmer nodeF
                                  farmer nodeF
                                  farmer node
                                  体面乡绅 硕果累累
                                  编写于 最后由 编辑
                                  #17

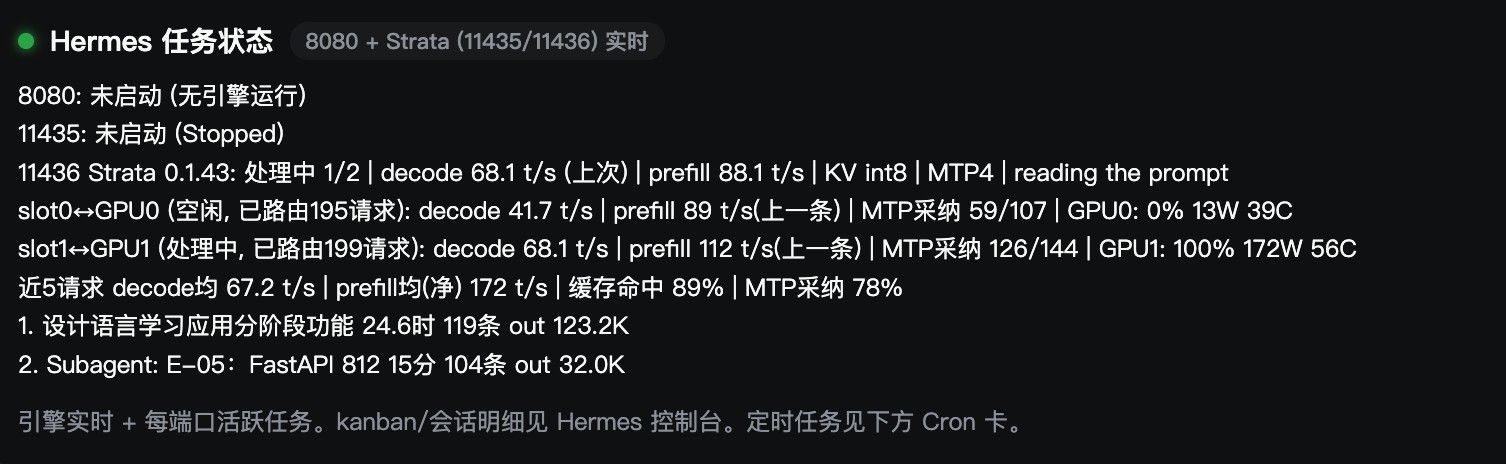
                                  @kos-or 功耗相比vllm 或是sglang 小很多,单卡不到200,prefill 最新版本有优化,单卡能跑到2000左右,很神奇。
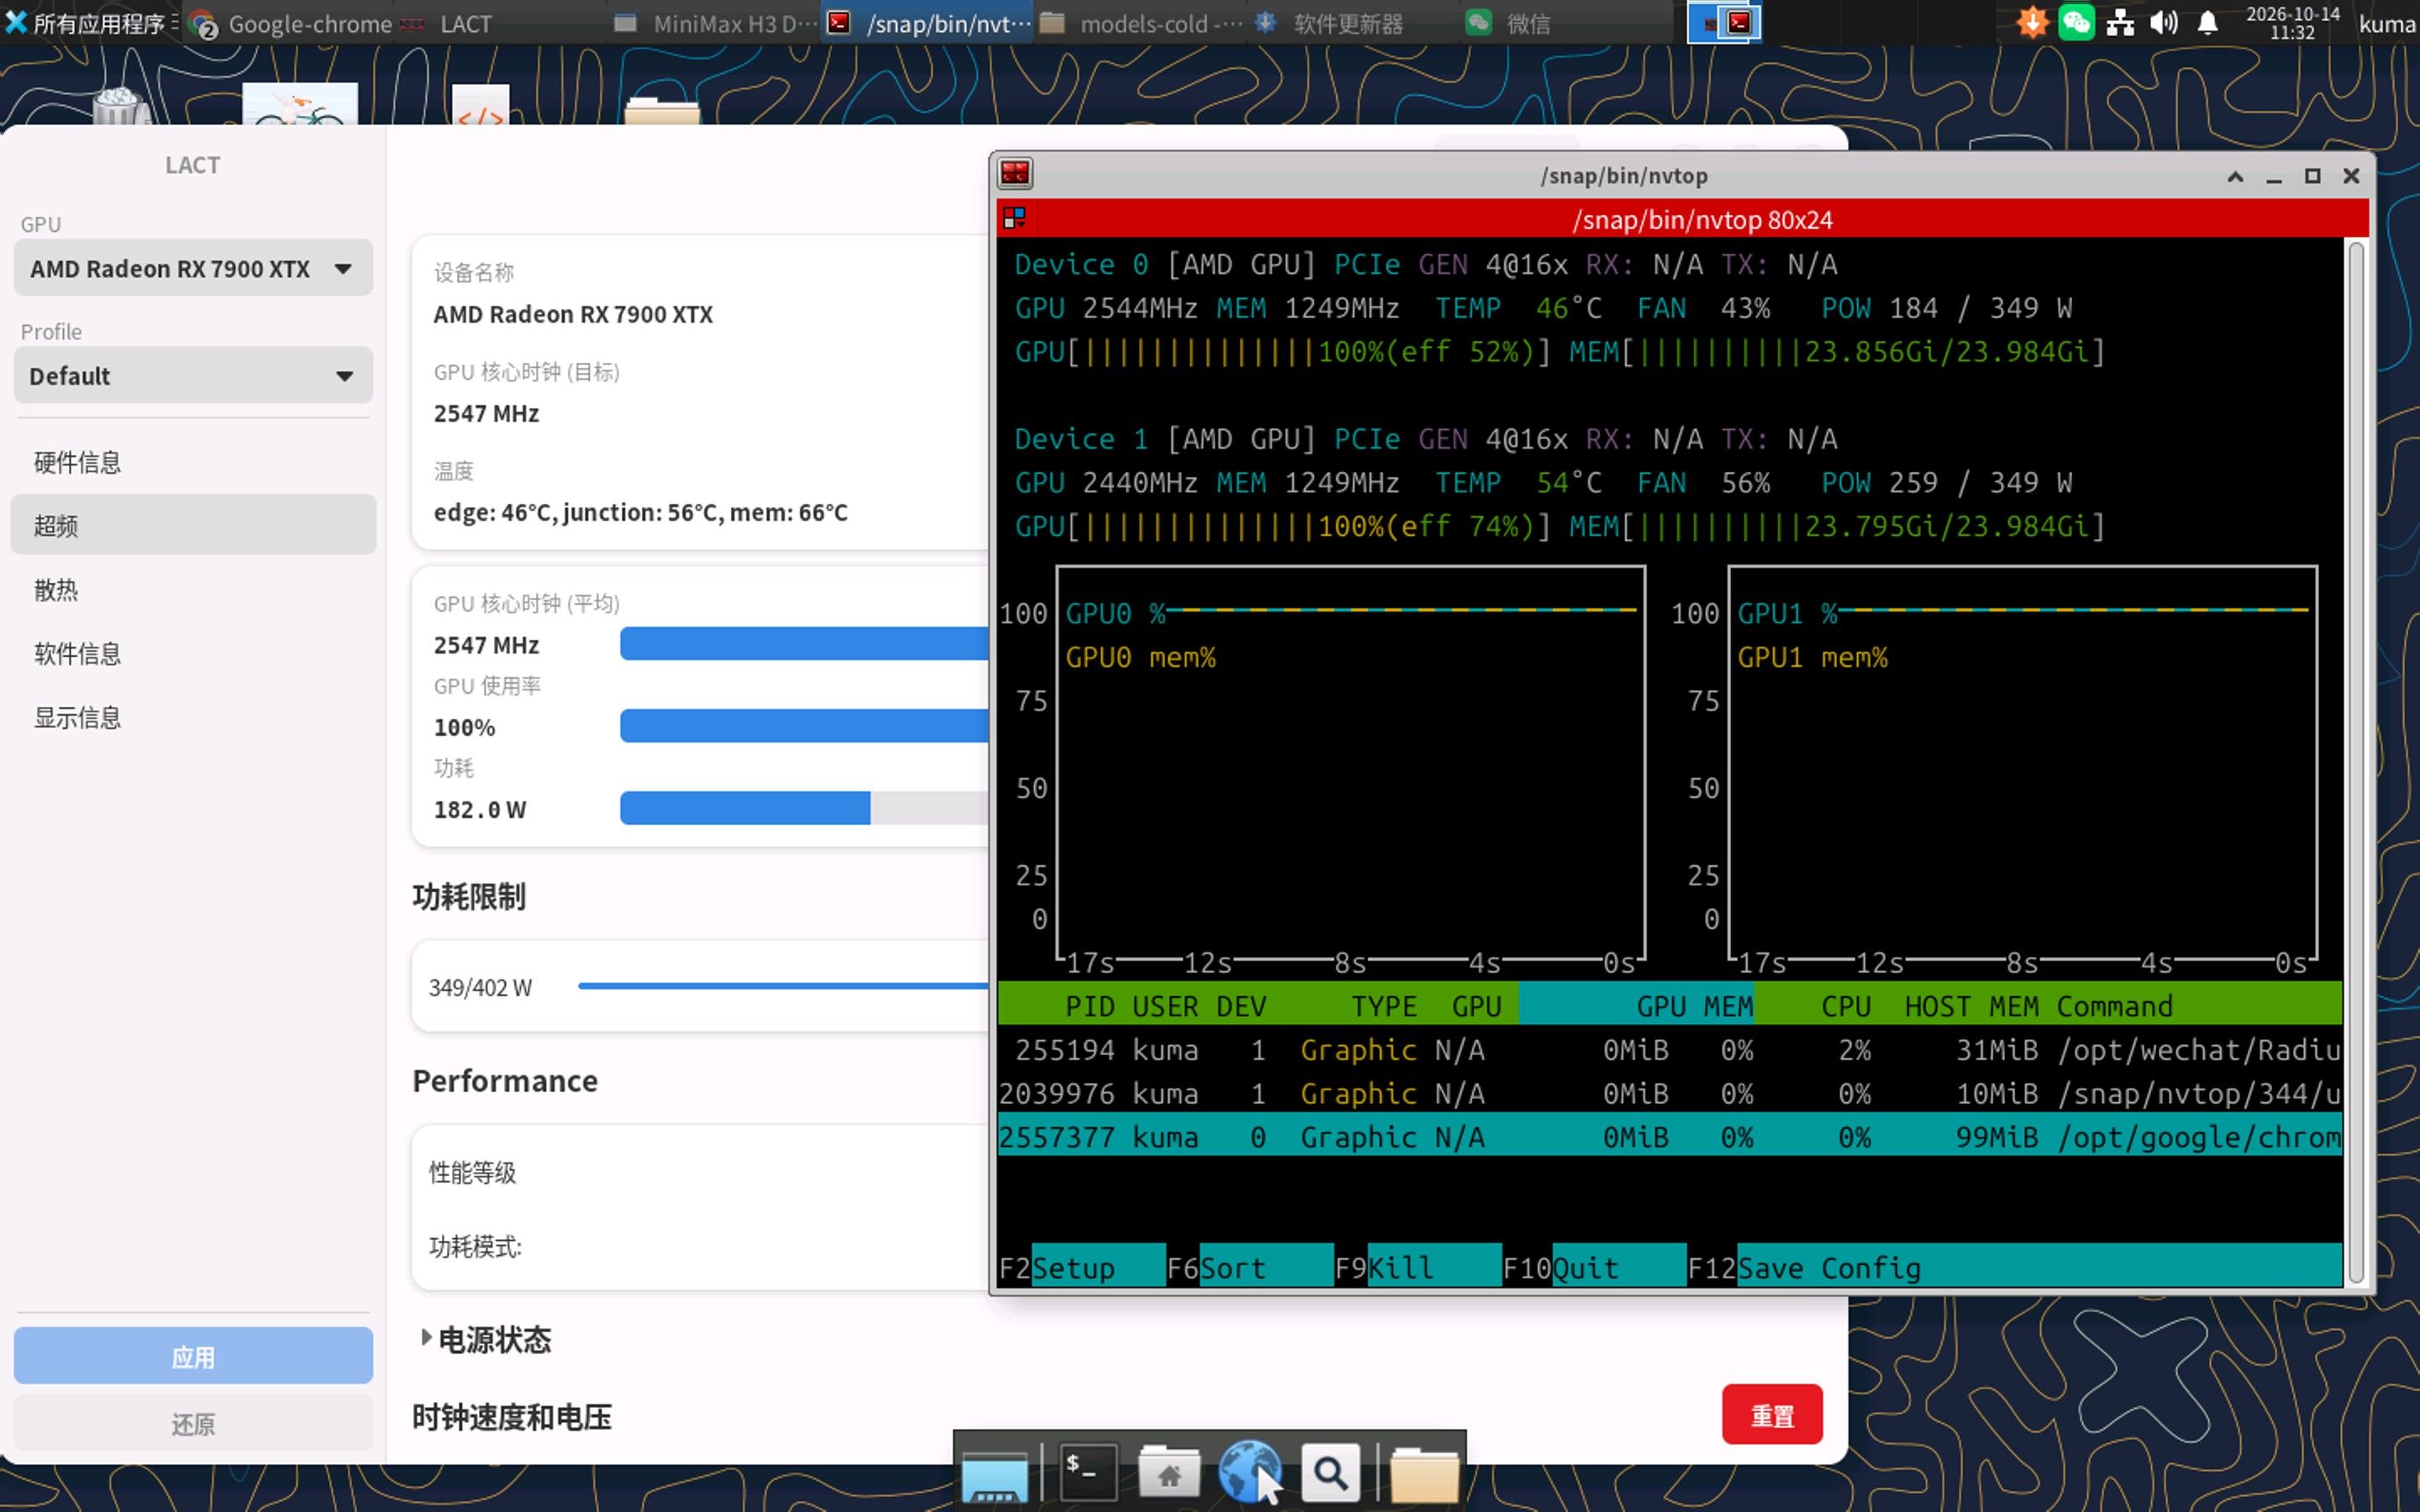
                                  image.jpeg

                                  kos orK 1 条回复 最后回复
                                  0
                                  • farmer nodeF farmer node

                                    @kos-or 功耗相比vllm 或是sglang 小很多,单卡不到200,prefill 最新版本有优化,单卡能跑到2000左右,很神奇。
                                    image.jpeg

                                    kos orK
                                    kos orK
                                    kos or
                                    至尊皇帝
                                    编写于 最后由 编辑
                                    #18

                                    @farmer-node said:

                                    功耗相比vllm 或是sglang 小很多,单卡不到200,prefill 最新版本有优化,单卡能跑到2000左右

                                    看來這是目前 雙卡RX7900 XTX的最佳配置了 Strata + 併行 Qwen Flash
                                    顯卡溫度低 + 功耗低 👍 👏

                                    A 1 条回复 最后回复
                                    1
                                    • kos orK kos or

                                      @farmer-node said:

                                      功耗相比vllm 或是sglang 小很多,单卡不到200,prefill 最新版本有优化,单卡能跑到2000左右

                                      看來這是目前 雙卡RX7900 XTX的最佳配置了 Strata + 併行 Qwen Flash
                                      顯卡溫度低 + 功耗低 👍 👏

                                      A
                                      A
                                      applejuice
                                      王侯将相
                                      编写于 最后由 编辑
                                      #19

                                      @kos-or
                                      我不做选择
                                      两个都要

                                      image.jpeg

                                      Ben LeeB 1 条回复 最后回复
                                      0
                                      • farmer nodeF farmer node

                                        先上图:
                                        image.jpeg

                                        硬件与模型

                                        硬件

                                        • CPU:AMD EPYC 7452
                                        • GPU:2 × AMD Radeon RX 7900 XTX
                                        • 显存:24GB × 2
                                        • 系统内存:约 125GiB
                                        • GPU 架构:gfx1100
                                        • 推理后端:ROCm / HIP
                                        • Strata:v0.1.43

                                        模型

                                        Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-proj
                                        

                                        模型相关文件:

                                        /work/packs/iq3_s
                                        
                                        /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
                                        /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf
                                        
                                        /work/mtp/rt
                                        

                                        并发方案:双单卡 replicas

                                        这次没有采用传统意义上的 TP2 或 layer split,而是使用 Strata 自带的 replicas 机制:

                                        replica 0 → GPU0
                                        replica 1 → GPU1
                                        

                                        配置结构:

                                        {
                                          "replicas": [
                                            {
                                              "gpus": [0]
                                            },
                                            {
                                              "gpus": [1]
                                            }
                                          ]
                                        }
                                        

                                        这个方案的特点:

                                        • 每张 GPU 运行一个独立模型副本;
                                        • 每个副本拥有独立的推理 engine;
                                        • 每个副本拥有独立的 KV、MTP 和会话状态;
                                        • 两个副本共享主机侧专家 arena;
                                        • 不是一个跨双卡切层的单实例;
                                        • 不是 batch;
                                        • 不是 batch-MTP;
                                        • 每个副本仍然运行 solo MTP;
                                        • 服务根据请求负载将请求路由到两个副本。

                                        当前配置

                                        模型与缓存

                                        --pack /work/packs/iq3_s
                                        
                                        --native /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
                                        --ple-gguf /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf
                                        
                                        --expert-profile /opt/strata/data/expert-profile.bin
                                        --expert-cache auto
                                        
                                        --max-context 262144
                                        --kv int8
                                        --kv-resident 32768
                                        
                                        --shared-expert-arena /dev/shm/strata-shared-arena.bin
                                        --conversation-cache-mib 8192
                                        

                                        Prefill 与 MTP

                                        --prefill auto:32768
                                        
                                        --spec 4
                                        --spec-min-p 0.5
                                        --mtp /work/mtp/rt
                                        --mtp-window 32768
                                        

                                        PLE 与视觉

                                        --ple-io direct
                                        --vision
                                        --vram-reserve-mib 700
                                        

                                        拒绝方向向量投影

                                        --control-vector-scaled /models/Huihui-Qwen3.8-Flash-Next-refusal-direction-r.gguf:1.0
                                        --control-vector-layer-range 4 44
                                        --cvec-mode project
                                        --cvec-dir per-layer
                                        

                                        环境变量

                                        STRATA_HIPBLASLT_TUNING=/opt/strata/tools/hip/gfx1100-hipblaslt-100202.txt
                                        STRATA_HIPBLASLT_VERBOSE=1
                                        STRATA_HIP_WMMA=1
                                        STRATA_STAGE_PIN=1
                                        STRATA_WATCHDOG_S=180
                                        

                                        配置文件:

                                        /home/kuma/projects/strata-docker/deploy-gsq-iq3s/config/config-iq3s-11436-replicas-opt.json
                                        

                                        共享专家 arena

                                        两个副本通过下面的文件共享主机侧专家 arena:

                                        /dev/shm/strata-shared-arena.bin
                                        

                                        当前大约占用:

                                        47.96GiB
                                        

                                        该文件位于 /dev/shm,属于 RAM-backed tmpfs,不是 SSD。

                                        共享 arena 可以避免两个副本把专家权重完整复制两份到主机内存。

                                        但是,共享 arena 不会共享以下内容:

                                        • GPU expert cache;
                                        • KV cache;
                                        • MTP 草稿状态;
                                        • 会话状态;
                                        • 请求状态;
                                        • 每个副本的运行时工作集。

                                        因此,replicas 可以减少部分 RAM 重复占用,但不会让两个副本只占一份完整运行内存。

                                        PLE 读取方式

                                        当前使用:

                                        --ple-io direct
                                        

                                        含义是:

                                        • PLE/n-gram 表不完整预读到 RAM;
                                        • 运行时按需从 NVMe SSD 随机读取;
                                        • 主要目标是节省主机内存。

                                        但是,PLE 的访问具有随机读取特征。长上下文 Prefill 时,如果 SSD 随机读取跟不上,会出现:

                                        threads waiting on the disk
                                        

                                        以及:

                                        no progress for 180 s during a request
                                        

                                        此时 GPU 可能处于低利用率甚至 0%,但请求不一定是真正死锁,而可能是卡在 PLE 的 SSD 随机读取阶段。

                                        因此:

                                        --ple-io direct
                                        

                                        优先解决的是内存容量问题,不保证解决长上下文首 token 延迟问题。

                                        并发指标

                                        Strata metrics 中常见字段:

                                        queued
                                        running
                                        outside_slots
                                        replicas[].alive
                                        replicas[].running
                                        replicas[].routed
                                        replicas[].batch
                                        

                                        含义:

                                        • queued:Strata 路由层队列;
                                        • running:当前承载的请求状态;
                                        • replicas[].running:某个副本当前承载的请求状态;
                                        • alive:副本 engine 是否在线;
                                        • routed:累计路由请求数量;
                                        • batch=0:当前没有使用 batch。

                                        注意:

                                        running 不等于 GPU 此刻正在计算
                                        

                                        当请求处于:

                                        reading the prompt
                                        

                                        或者正在等待 PLE/SSD 时,GPU 利用率可能暂时为 0%。

                                        一个请求一旦被分配到某个副本,不会因为另一张 GPU 空闲就自动迁移到另一个副本。replicas 是请求级路由,不是跨 GPU 的任务迁移机制。

                                        测试结果

                                        以下测试使用:

                                        temperature=0
                                        medium thinking
                                        

                                        这些结果只代表对应测试口径,不代表日常采样参数下的速度保证。

                                        双路 64K

                                        单请求:

                                        83.6~85.5 tok/s
                                        

                                        双请求共同窗口聚合:

                                        159.5~170.1 tok/s
                                        

                                        双路 128K

                                        双请求聚合:

                                        153.7 tok/s
                                        

                                        双路 240K

                                        实际每路输入约:

                                        245755 tokens
                                        

                                        双请求聚合:

                                        159.6 tok/s
                                        

                                        资源采样:

                                        最低 MemAvailable:约 32.8GiB
                                        Swap-out:0
                                        Full memory PSI avg10:最高 0%
                                        

                                        这些结果只能说明对应测试条件下双副本可以工作,不能直接外推:

                                        • 满 256K 长期稳定运行;
                                        • 无限会话停放;
                                        • 更高并发;
                                        • 所有请求都能稳定双卡分流;
                                        • dsh 多轮工具调用下的长期稳定性。

                                        batch-MTP 对照

                                        另外测试过两副本、每个副本 batch=2 的配置。

                                        四路请求聚合结果:

                                        开启 batch-MTP:151.4 tok/s
                                        关闭 batch-MTP:104.2 tok/s
                                        

                                        在当时的测试条件下,batch-MTP 有明显收益。

                                        但这个结果不能直接与双路 replicas 比较,因为两者的执行条件不同:

                                        • 请求数量不同;
                                        • 输出预算不同;
                                        • 执行机制不同;
                                        • 双路 replicas 使用每副本 solo MTP;
                                        • batch-MTP 使用另一套 batch 执行路径。

                                        当前采用:

                                        11436:双单卡 replicas + solo MTP
                                        不默认启用 batch-MTP
                                        
                                        johnnybegoodJ
                                        johnnybegoodJ
                                        johnnybegood
                                        王侯将相
                                        编写于 最后由 编辑
                                        #20

                                        @farmer-node 2x 3090 能用么?

                                        farmer nodeF 1 条回复 最后回复
                                        1
                                        • johnnybegoodJ johnnybegood

                                          @farmer-node 2x 3090 能用么?

                                          farmer nodeF
                                          farmer nodeF
                                          farmer node
                                          体面乡绅 硕果累累
                                          编写于 最后由 编辑
                                          #21

                                          @johnnybegood 可以的,不挑显卡,3090 单流可以到100token/s ,如果是双流应该可以上到200token/s

                                          johnnybegoodJ 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组