英伟达DGX Station 748G统一内存,10万美元售价打造本地AI算力王座。大多数程序员都无法对抗AI淘汰大潮,早做打算!
-
万恶的老黄发布了一款新的重磅产品,叫做 DGX Station,里面包含了一个 GB300 Grace Blackwell Ultra 这么一个 GPU。它的显存是 252GB HBM3e,还包含了一颗 Grace CPU,它的内存是 496G LPDDR5X,然后通过 NVLink C2C 统一寻址,合计是 252 加上 496 等于 748G 连贯内存、统一内存。2026 年 GTC 台北发布,Windows 版本 Q4 上市。桌面 AI 超算能够本地跑万亿参数的大模型,功耗仅仅 1600 瓦,OEM 由华硕、戴尔、技嘉、微星、超微做整机,就非常非常夸张。
我们这些屌丝老是在想,什么时候硬件涨价能成为过去?什么时候硬件会崩盘?我估计现在看来,崩盘是不可能的,可能缺货会越来越紧张。你看看,以前你说我们配一台电脑,你了不起能上个 128G 的内存就已经到天了,但是你看人家给你整个 496G 内存,显存给你整个 252G,你在过去敢想象吗?我们可能认为这些东西这么贵,谁会用?我跟你讲,只要一出来,我可以说,你不排队都买不到货。它现在虽然说官方预期价格大概是 9.5 万到 10 万美元,就是大概 64 万到 67 万人民币,就相当于奥迪 Q7 了。这个价格是非常夸张的,但是我可以说,这个价格只要出来,一定是卖爆,第一时间就会被买完。
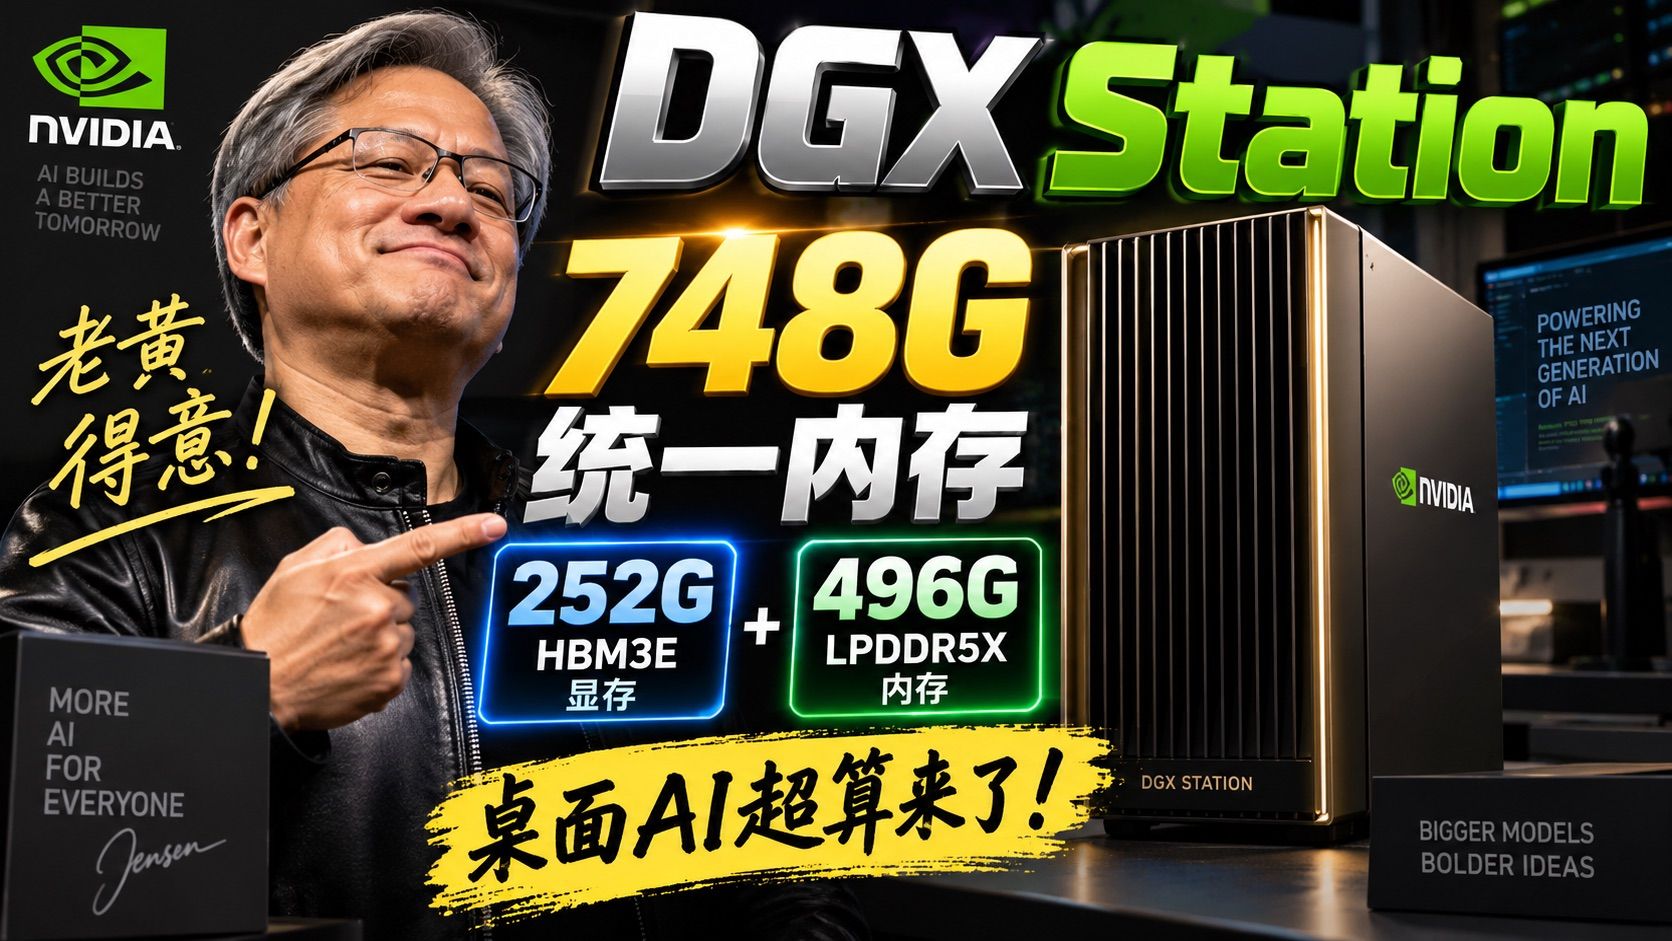
对于我们这些穷屌丝来说,买这样的设备可能太贵了,但是如果说你真的是有工作需求,你想一想它这个机器能干什么?它首先是 252G 的 HBM3e 显存,它能够干什么?能够载入全量的 MiniMax H3 这样的视频模型,并且它能多开。同时你剩下来的 496G 统一内存,搭配你残余的 HBM3e,你就可以构成一个高效的、本地跑 DeepSeek V4.1 Flash 这样生产力模型的生态。你在本地所有的数据不上云,不上第三方的服务,本身数据能够安全。你说这样的机器它能够赚钱吗?其实如果说你们去认真研究一下的话,现在那些批量搞视频的工厂,他们要么是在做一些工业广告,要么就是在做批量的短剧。但是必须说明,人家是有一整套产业链的,有一整套营销的渠道,是有整合的资源,这个东西的门槛是比较高的,我们这些屌丝是搞不定的。不过对于这些已经在疯狂生产的企业来讲,六七十万的价格真的对于他们来说只是毛毛雨,他们很有可能两到三个月就能回本,甚至如果说用得好的话,一个月就回本了,那剩下来的就是白赚嘛。
甚至说不好听的,这个玩意对于一些算力贩子都是非常有意义的,因为这个算力讲实话非常可观,而且这个架构设计得非常讨巧,非常适合当下的 AI,就是 MoE 大模型的推理。它能够支持的并发用户量应该是非常大的。当然了,如果说你是需要模型的微调、后训练,那你肯定还是买四张或者 6 卡、8 卡的 XTX Pro 6000,它可能更划算一点。但是对于一些主打推理的场景来说,这个机器简直就是神器。甚至对于一些中小企业来说,你一个公司可能买一台就够全公司用了。你全公司都在搞开发,用 DeepSeek V4.1 Flash 这样的 MoE 模型,那它部署好了之后,搞不好你一个公司就够了。那比起你去支付昂贵的 API 费用,你还要担心你的代码被偷掉,就前两天刚刚发生的事情嘛,就是智谱的 ZCode 偷盗用户的代码。那么如果说你在本地有一个这样的东西,它的价值真的确实很高。
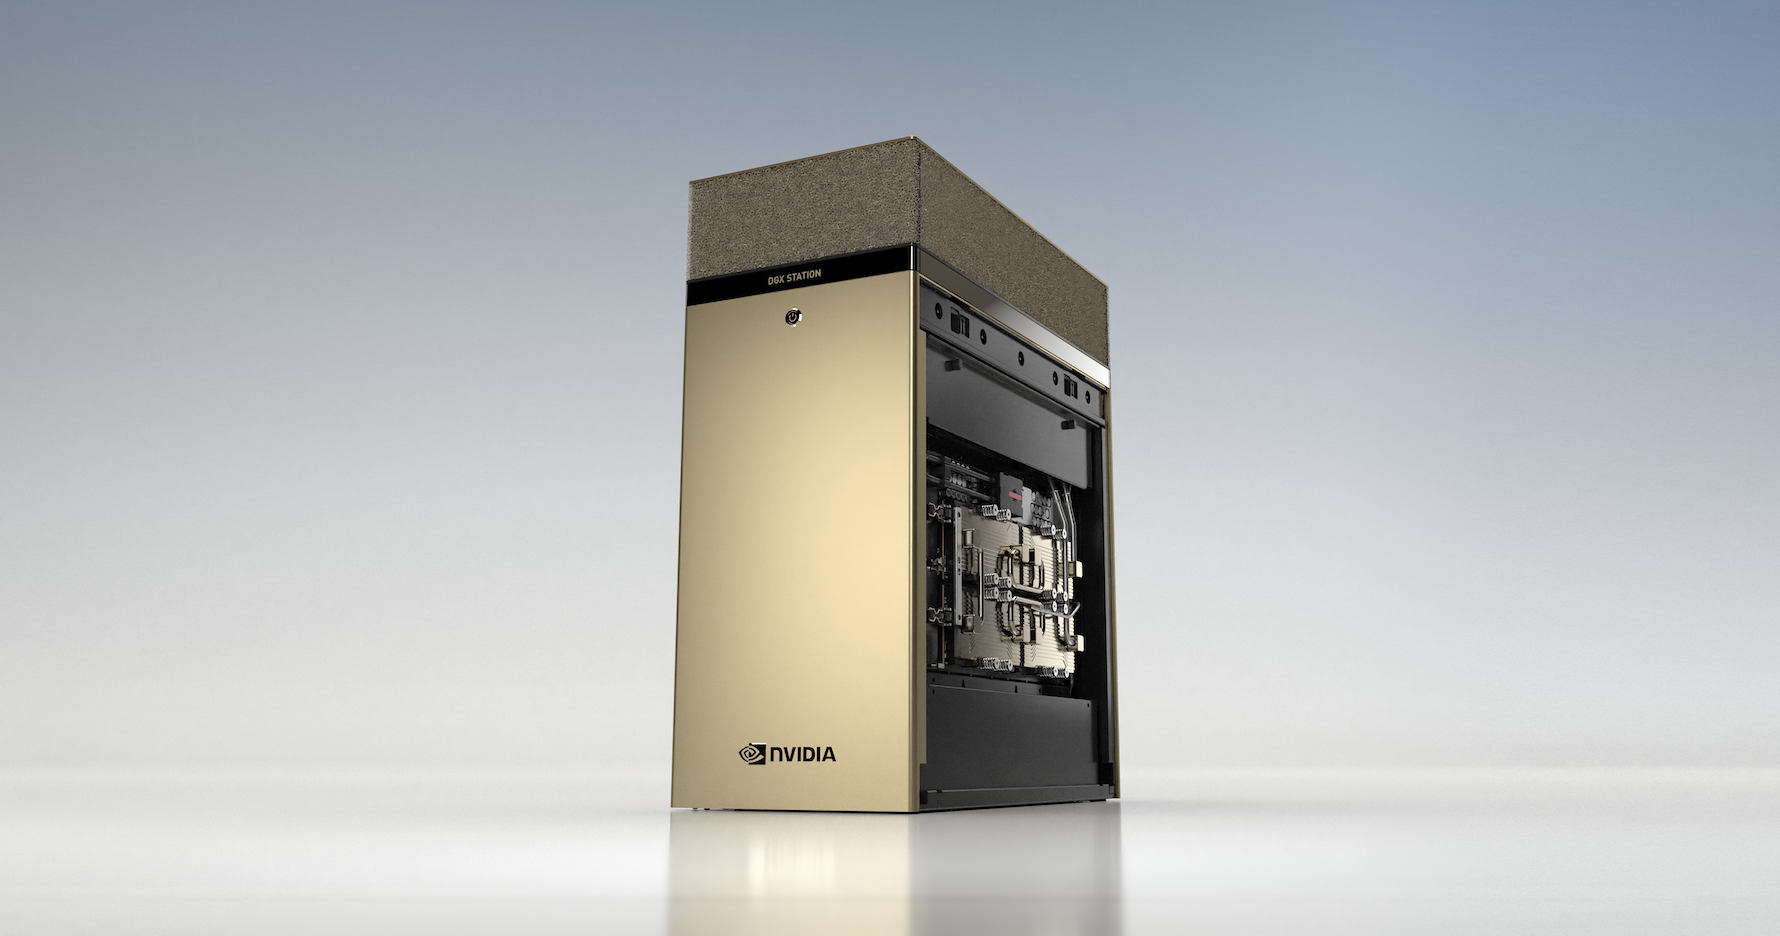
除了一些中小企业,像一些医院、银行、小的银行、村镇级别的银行,它可能要自己去买昂贵的机柜,那还真不划算。用这个玩意真的,你一个医院、一个银行,一台就够了,了不起你再买一台备份。这样的价格对于我们普通人来说非常昂贵,对于他们来说真的这就不叫个事情。而且我们要知道,我们中国是有很多有钱人的,包括全世界有钱人都很多。王思聪当年配了一台电脑不是 100 多万嘛,都多少年前配的。人家花 100 多万配个电脑,相当于我们花 100 块钱吃了个宵夜,一台用着,一台看着。就像我们炫富的方式是什么?买两碗米线,吃一碗倒一碗。那么我们又不得不谈,AI 大潮袭来,我们穷人到底是获得了更多的机会,还是说我们的剪刀差被拉得更大了?
其实对于有钱人来讲,他自己对商务方面的理解,对于整个生态、整个大的行业方向的理解,肯定是比我们普通人要有更加全面、更加有高度的看法。毕竟人家是掌握了很多的商业资源。而且就算他们的看法比我们稍稍落后,甚至不如我们,比我们差得只要不是很大,人家能够买得起机器,能够早投入生产,能够把商业模式立即变现,先赚一波,剩下来的就是纯盈利,那种心态肯定是跟我们不一样的。我们这些穷屌丝怎么办呢?说实话,凡是非常依赖算力、非常依赖资源的这些项目,我们就不要做了,因为我们是搞不过这些有钱人的。我们要做些什么项目呢?就是他们看不上的一些边角料。就像怎么样?你说你富豪,你这个生意做得再大,你不可能自己去修剪草坪吧?你总得需要保安,总得需要保洁,总得需要保镖,是不是?吉祥三宝。这些事情他们看不上,我们就给你做一做。
比如说像我现在做的这些事情,我就偶尔帮一些客户搞搞单子。其实客户自己用 AI 能不能搞定?能,人家只是不放心,也不愿意自己操那个心,就是愿意把这个单子交给我来做。可以,只要这个活比较轻松,不太影响我做频道,我偶尔也接一下,但是要熟人我才接单。然后我还有经营油管频道,来分享一下怎么配置 AI、怎么使用 AI、怎么用 AI 赚钱。甚至我这个频道本身就是个直播项目嘛。几个月之前开始的时候我就说了,我们预计什么时候实现什么样的目标。当初就是预期,到七八月份能够加入 YPP,能够实现盈利,实际上提前几个月就实现了。然后能够尽早实现每个月超过 1000 美金,起码一个月能够赚到一万多块钱人民币,能够赚到这么一个级别,其实也实现了。就赚点这种小钱,能够摆脱对于英语频道的这种单方面依赖。哪一天万一英语频道又收紧了,油管开始大规模打击 AI、打击不露脸的频道,那我失去所有的英语频道,我也能有一个基本的生活保障就可以了。然后另外就是像我做做网站、开发一下 APP,就这种事情,这些有钱人是不太愿意搞的,他们是不太愿意在这个小事情上浪费时间的,那么这些事情就由我们来做,也只能如此了。
然后我还是那句话,大家要放弃幻想。就说 AI 到底能不能替代人类?AI 是不能替代人类,但是 AI 能够替代你。我不知道你们能不能理解这其中的差距。就是每个公司最终都是需要程序员的,尤其是需要那些厉害的、有经验的、能够驾驭 AI 的程序员,但是那个人是不是你?我相信你究竟平时在公司是顶梁柱,是公司的定海神针,还是说你是个水货,别人不清楚,你自己应该是清楚的。如果说你真的是那个水货,你不想在中年失业之后立刻就进入什么铁人三项——快递、外卖、网约车,还想挣扎一下,那么现在开始多看看我的视频,多到我们这个论坛发发帖,可以提前开始一下你的个人创业小项目。
千万不要去好高骛远,出来之后又搞什么独立创业,搞什么跨境电商、炒股炒币,把自己的身家折腾得一干二净,最后再去铁人三项,到那个时候后悔就来不及了,没有必要。就是搞点这种需要花点脑子、少花点钱、少投入资源,最多是投入汗水、投入时间的这么一种小项目。AI 就是本地能部署就本地部署,本地部署不了的,舍不得花那个钱,就把 DeepSeek 给它用起来,花不了几个钱。多利用 AI 来干干活,抓紧把你的想法付诸实践。千万不要忘记,你的定位一定是不要跟有钱人、跟有资源的人去争什么依靠算力的这些项目,你一定要找一些他们看不上的、零零碎碎的小生意,就像我做的这些事情。
当然了,我并不是说所有的人最终都要来走做自媒体,或者走建网站、开发 APP 的这么一种无聊的套路上。因为这个讲实话,就是我是找不到其他的一些赚钱的方式,破产之后就只能靠这个东西来谋生。我其他的靠什么?我讲实话,我做时政、做科技的评论,我做英语视频,之前的早期视频大家可以翻一下,我视频的点赞率是相当高的。但是做这个东西,它比较累。另外又要防止平台对 AI 的过分打击,就是我的频道中用了太多的 AI 技术,AI 含量太高,我怕被封杀。就是做任何一行,你像我现在做这个项目、做这个频道,你说累不累?有的时候一天发两个视频,甚至我两个频道有时候发 3 个、4 个视频。如果说你感兴趣、你擅长,那就不累;如果说你不感兴趣,你仅仅是为了挣钱,那么就会很累。
但是我相信对于大多数人来说,你们的那个危机已经是迫在眉睫了。你们随时有可能失业,那就不要装逼了,就是什么行业能赚钱,你就先抓紧想一想。不要想我还跳槽了,你人到中年,你 35 岁之后被公司裁员,你还想跳槽去找一份体面的工作,那基本上是不可能的,难度很大。早一点放弃这个幻想,尤其是你做技术工作者,我们这个行业是第一个被 AI 重点突击的方向。这大部分的职能 AI 都能够替代,是第一个被 AI 淘汰的行业。自己早点放下幻想,早点做好这种准备,做好这个底线思维。
老黄这个奸商,我相信以后还会发布越来越多的产品。有些产品的价格我们可能就看不懂了,但是我们还是要去了解一下。为什么呢?因为我们知道,我们将来不是在跟某些具体的人竞争,我们是要跟掌握了这些生产力利器的人去竞争。你说实话,10 万美金、六七十万的价格,你能买这样一台生产力利器,你说它的入门门槛很高吗?我觉得不是特别的高。如果说你跟我一样,现在就是买不起这样的机器,那我们就要做好跟这些机器竞争的准备。你要打出差异化,或者说你要找到这些机器没有办法突击的领域,先找个落脚点,生存下来,然后再慢慢想出从困境中走出的办法,慢慢想出自救的办法,也只能如此了。
-
-
-
-
太穷了,已经跟不过富哥的节奏了
-
补充一个我觉得这台机器最有意思的地方:不只是内存容量大,而是它把 GPU、网卡和存储连起来的拓扑,很像把数据中心的一部分搬到了桌边。
拿技嘉这台 W775-V10-L01 来说,ConnectX-8 SuperNIC 不只是一张双 400G 网卡,它本身还集成了 PCIe Gen6 交换功能。
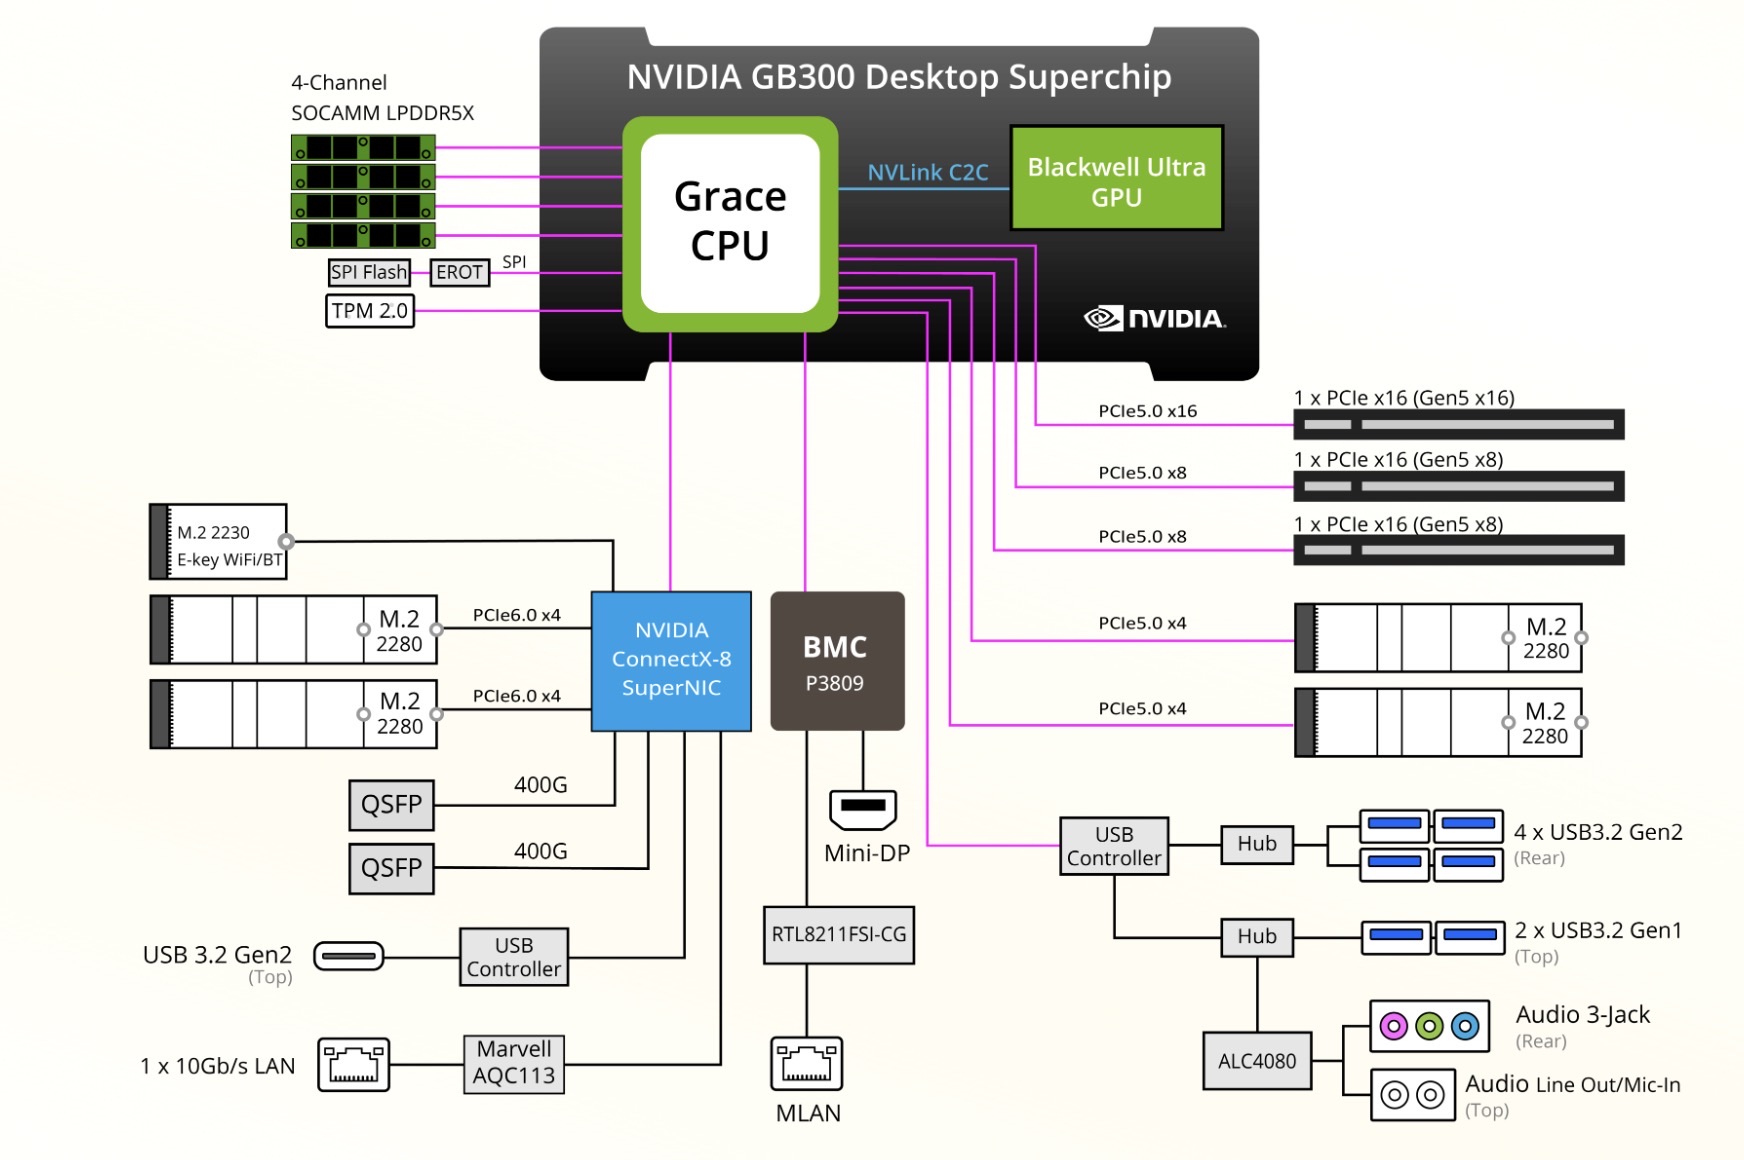
不过这张厂商简图没有明确画出 GPU 到 ConnectX-8 的连接,STH 的拓扑分析和实测补上了这一点。
这里有三条不同的路,不能混在一起看:
- Grace CPU
 Blackwell Ultra GPU:NVLink-C2C,负责本机 CPU/GPU 的一致性互联。
- GPU ConnectX-8:PCIe Gen6 x16,Data Direct 提供了 NIC 直接访问 GPU 的数据路径,配合 GPUDirect RDMA,不必先把传输数据搬到 CPU 内存中转。
- Grace CPU ConnectX-8:PCIe Gen5 x8,这条反而窄得多。
STH 实测两台 Station 用两条 400GbE 链路连接,GPU 到 GPU 的 RDMA payload 达到约 784.3 Gb/s,CPU 到 CPU 则只有约 229 Gb/s。前者折合约 98 GB/s,注意不是 784 GB/s。也就是说,“有 800G 网口”不等于机器里所有数据都能按 800G 往外搬,得看数据在哪里、实际走哪条路。
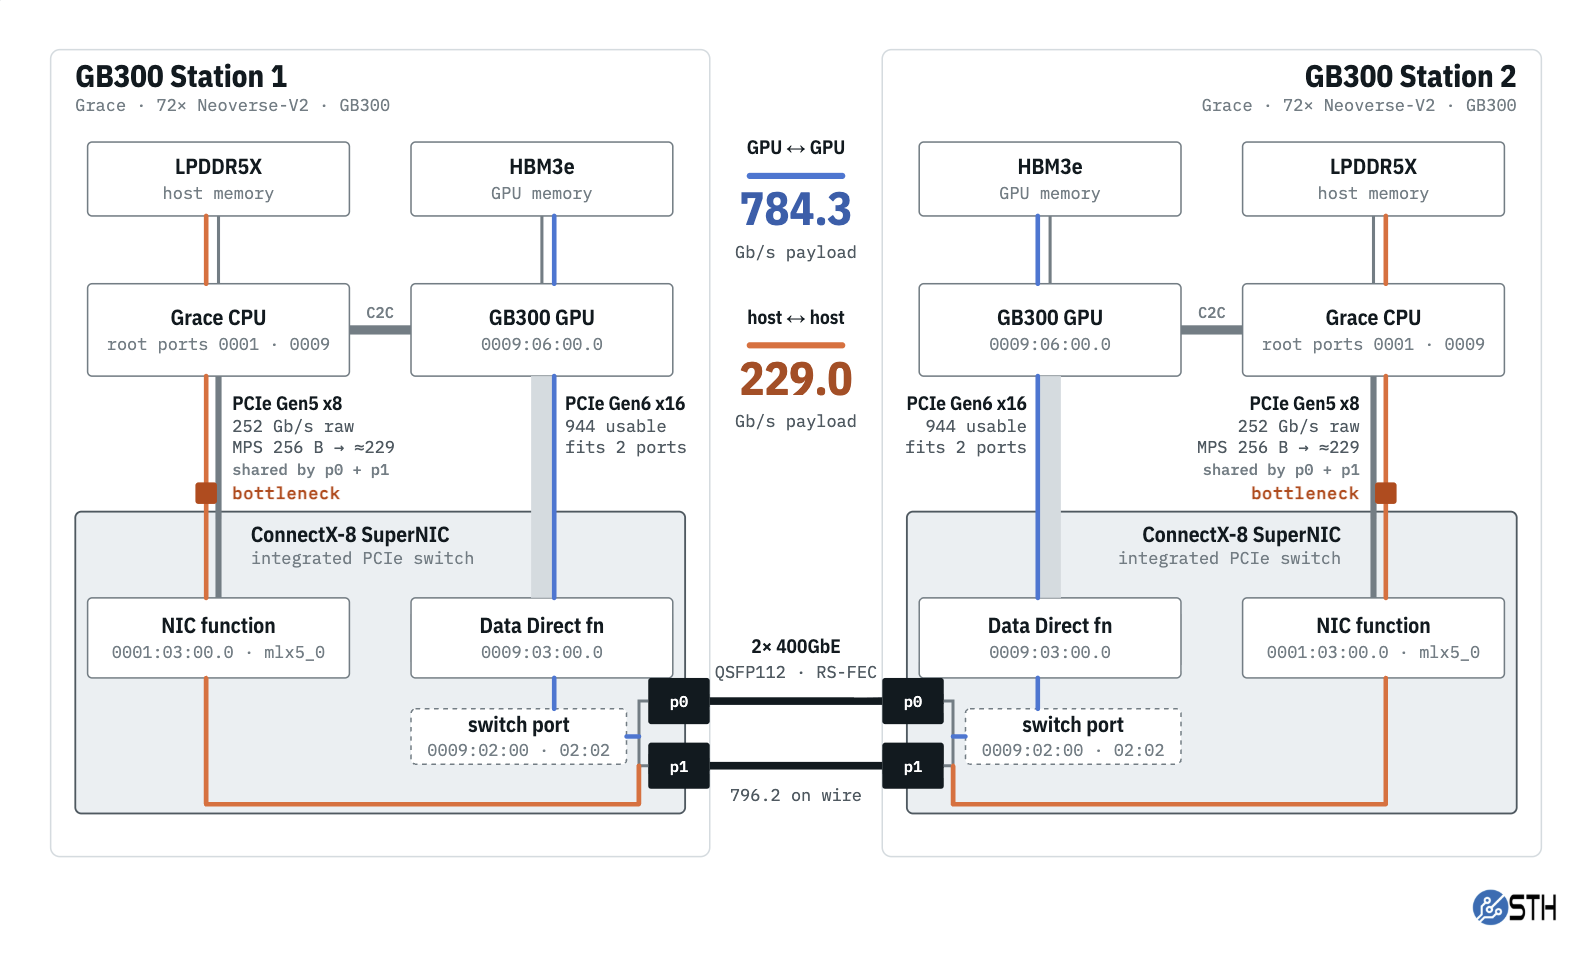
我感兴趣的是它对多节点推理、Prefill/Decode 分离的意义。 比如一台做 Prefill、处理输入,另一台做 Decode、持续生成 Token,中间要把 KV cache 传过去。这时候 GPU 显存之间能直接通过 RDMA 高速搬数据,就比只盯着单机算力和总内存容量更值得研究。
这里跨机器走的是 Ethernet/RDMA,不是把本机 NVLink-C2C 延伸到另一台,也不会自动把两台机器变成一块统一显存。真正做 P/D 分离,还需要 Dynamo、SGLang 等软件栈配合;能否抵消 KV 传输和调度开销,得看模型、上下文长度、并发和实际测试。上面的数字是网络传输测试,不是 P/D 分离加速的实测结果。
存储这边也有个细节:它的两条 Gen6 x4 M.2 插槽挂在 ConnectX-8 下面,另外两条 Gen5 x4 才挂在 Grace CPU 下面。连 SSD 放在哪个 PCIe 分支上都有区分,不是普通工作站插张大显卡、再插张高速网卡这么简单。
所以我觉得它有意思的地方,是桌面形态下也提供了围绕 GPU 数据路径设计的 scale-out 条件。不一定每个人都需要买两台,但如果想研究多机推理,这套拓扑本身就很值得看。
参考:
- STH:拓扑分析(第 3 页)、网络实测(第 7 页),图和测速来自其评测,不是我的实测。
- NVIDIA:Data Direct
- NVIDIA Dynamo:P/D 分离及 RDMA 传 KV cache
- Grace CPU
-
补充一个我觉得这台机器最有意思的地方:不只是内存容量大,而是它把 GPU、网卡和存储连起来的拓扑,很像把数据中心的一部分搬到了桌边。
拿技嘉这台 W775-V10-L01 来说,ConnectX-8 SuperNIC 不只是一张双 400G 网卡,它本身还集成了 PCIe Gen6 交换功能。
不过这张厂商简图没有明确画出 GPU 到 ConnectX-8 的连接,STH 的拓扑分析和实测补上了这一点。
这里有三条不同的路,不能混在一起看:
- Grace CPU Blackwell Ultra GPU:NVLink-C2C,负责本机 CPU/GPU 的一致性互联。
- GPU ConnectX-8:PCIe Gen6 x16,Data Direct 提供了 NIC 直接访问 GPU 的数据路径,配合 GPUDirect RDMA,不必先把传输数据搬到 CPU 内存中转。
- Grace CPU ConnectX-8:PCIe Gen5 x8,这条反而窄得多。
STH 实测两台 Station 用两条 400GbE 链路连接,GPU 到 GPU 的 RDMA payload 达到约 784.3 Gb/s,CPU 到 CPU 则只有约 229 Gb/s。前者折合约 98 GB/s,注意不是 784 GB/s。也就是说,“有 800G 网口”不等于机器里所有数据都能按 800G 往外搬,得看数据在哪里、实际走哪条路。
我感兴趣的是它对多节点推理、Prefill/Decode 分离的意义。 比如一台做 Prefill、处理输入,另一台做 Decode、持续生成 Token,中间要把 KV cache 传过去。这时候 GPU 显存之间能直接通过 RDMA 高速搬数据,就比只盯着单机算力和总内存容量更值得研究。
这里跨机器走的是 Ethernet/RDMA,不是把本机 NVLink-C2C 延伸到另一台,也不会自动把两台机器变成一块统一显存。真正做 P/D 分离,还需要 Dynamo、SGLang 等软件栈配合;能否抵消 KV 传输和调度开销,得看模型、上下文长度、并发和实际测试。上面的数字是网络传输测试,不是 P/D 分离加速的实测结果。
存储这边也有个细节:它的两条 Gen6 x4 M.2 插槽挂在 ConnectX-8 下面,另外两条 Gen5 x4 才挂在 Grace CPU 下面。连 SSD 放在哪个 PCIe 分支上都有区分,不是普通工作站插张大显卡、再插张高速网卡这么简单。
所以我觉得它有意思的地方,是桌面形态下也提供了围绕 GPU 数据路径设计的 scale-out 条件。不一定每个人都需要买两台,但如果想研究多机推理,这套拓扑本身就很值得看。
参考:
- STH:拓扑分析(第 3 页)、网络实测(第 7 页),图和测速来自其评测,不是我的实测。
- NVIDIA:Data Direct
- NVIDIA Dynamo:P/D 分离及 RDMA 传 KV cache
其实不是这样玩得。。。。
因为本身bg300并没有单卖,他一开始就是几十个gb300得rack...这源于我开始在网上咨询那些组装4x rtxpro 6000 得时候,我问过nvidia 怎样才可以买到gb300,他们说并没有单卖。。。
后来,他们可能看到越来越多ai业者去组装4x rtxpro 6000
后来,就冒出单卖得gb300 workstation了。。。
4x rtxpro6000 +套机等于10万美金,差不多也是gb300 workstation一开始nvidia 标出来得价格
当今一个rack里面最低可以组装得gb300 是2个,
GB300 Desktop Superchip,HGX B300
supermicro在卖着 - Grace CPU
-
其实不是这样玩得。。。。
因为本身bg300并没有单卖,他一开始就是几十个gb300得rack...这源于我开始在网上咨询那些组装4x rtxpro 6000 得时候,我问过nvidia 怎样才可以买到gb300,他们说并没有单卖。。。
后来,他们可能看到越来越多ai业者去组装4x rtxpro 6000
后来,就冒出单卖得gb300 workstation了。。。
4x rtxpro6000 +套机等于10万美金,差不多也是gb300 workstation一开始nvidia 标出来得价格
当今一个rack里面最低可以组装得gb300 是2个,
GB300 Desktop Superchip,HGX B300
supermicro在卖着@imbiplaza-ASUS 啊 4x RTX 6000 Pro 要10万刀的话 GB300 DGX Station不要太超值 算力甩8卡都几条街。
-
@imbiplaza-ASUS 啊 4x RTX 6000 Pro 要10万刀的话 GB300 DGX Station不要太超值 算力甩8卡都几条街。
-
gb300 单机版本肯定吃炒价
@imbiplaza-ASUS 但我看了下Alex Ziskind和Level1Techs他们实机测试 这个内部走线和配色实在是喜欢不起来(其实也是没钱)
-
@imbiplaza-ASUS 但我看了下Alex Ziskind和Level1Techs他们实机测试 这个内部走线和配色实在是喜欢不起来(其实也是没钱)
-
售卖得对象应该是那些每年产值6000万至1亿的小型企业
@imbiplaza-ASUS 我算了下这玩意儿一个20人团队用大概每人5000刀 绰绰有余。我们很多时候一个月就1000-2000刀token 虽然是SOTA但确实也是贵。
大部分任务开元模型都可以跑,这玩意儿5个月就回本了。 -
@imbiplaza-ASUS 我算了下这玩意儿一个20人团队用大概每人5000刀 绰绰有余。我们很多时候一个月就1000-2000刀token 虽然是SOTA但确实也是贵。
大部分任务开元模型都可以跑,这玩意儿5个月就回本了。好像可以顺便架设虚拟机。。。到时候,连电脑也省下了,人手一部最基础的苹果电脑就可以执行惯用的win 老程式
-
补充一个我觉得这台机器最有意思的地方:不只是内存容量大,而是它把 GPU、网卡和存储连起来的拓扑,很像把数据中心的一部分搬到了桌边。
拿技嘉这台 W775-V10-L01 来说,ConnectX-8 SuperNIC 不只是一张双 400G 网卡,它本身还集成了 PCIe Gen6 交换功能。
不过这张厂商简图没有明确画出 GPU 到 ConnectX-8 的连接,STH 的拓扑分析和实测补上了这一点。
这里有三条不同的路,不能混在一起看:
- Grace CPU Blackwell Ultra GPU:NVLink-C2C,负责本机 CPU/GPU 的一致性互联。
- GPU ConnectX-8:PCIe Gen6 x16,Data Direct 提供了 NIC 直接访问 GPU 的数据路径,配合 GPUDirect RDMA,不必先把传输数据搬到 CPU 内存中转。
- Grace CPU ConnectX-8:PCIe Gen5 x8,这条反而窄得多。
STH 实测两台 Station 用两条 400GbE 链路连接,GPU 到 GPU 的 RDMA payload 达到约 784.3 Gb/s,CPU 到 CPU 则只有约 229 Gb/s。前者折合约 98 GB/s,注意不是 784 GB/s。也就是说,“有 800G 网口”不等于机器里所有数据都能按 800G 往外搬,得看数据在哪里、实际走哪条路。
我感兴趣的是它对多节点推理、Prefill/Decode 分离的意义。 比如一台做 Prefill、处理输入,另一台做 Decode、持续生成 Token,中间要把 KV cache 传过去。这时候 GPU 显存之间能直接通过 RDMA 高速搬数据,就比只盯着单机算力和总内存容量更值得研究。
这里跨机器走的是 Ethernet/RDMA,不是把本机 NVLink-C2C 延伸到另一台,也不会自动把两台机器变成一块统一显存。真正做 P/D 分离,还需要 Dynamo、SGLang 等软件栈配合;能否抵消 KV 传输和调度开销,得看模型、上下文长度、并发和实际测试。上面的数字是网络传输测试,不是 P/D 分离加速的实测结果。
存储这边也有个细节:它的两条 Gen6 x4 M.2 插槽挂在 ConnectX-8 下面,另外两条 Gen5 x4 才挂在 Grace CPU 下面。连 SSD 放在哪个 PCIe 分支上都有区分,不是普通工作站插张大显卡、再插张高速网卡这么简单。
所以我觉得它有意思的地方,是桌面形态下也提供了围绕 GPU 数据路径设计的 scale-out 条件。不一定每个人都需要买两台,但如果想研究多机推理,这套拓扑本身就很值得看。
参考:
- STH:拓扑分析(第 3 页)、网络实测(第 7 页),图和测速来自其评测,不是我的实测。
- NVIDIA:Data Direct
- NVIDIA Dynamo:P/D 分离及 RDMA 传 KV cache
- Grace CPU



 只能学谷歌走手机版的算力集群了,等等把。类似于猫池一样的算力集群。坐等华强北的大佬开发