7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s
-
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s
前言/致谢
首先真心感谢 hipfire 团队为 AMD / RDNA 社区做出的贡献。(还有hipEngine,BridgeSpec,llama-cpp-rdna-boosts,KVMem,MoE4All,AMD-AIM / sglang-radeon,Paiton vLLM plugin,以及更多长期为 AMD 本地 AI 推理生态默默投入时间和精力的开发者、研究者和社区大神们)
项目地址:https://github.com/warpfront/hipfire
最近感受到了来自于N卡阵营满满的“敌意”
 ,尤其是类似于nInfer这类的定向优化让我“醋意满满”(其实我也有N卡,哈哈);甚至RDNA4 PRO R9700的优化也一日千里 —— 这个真么有,曾经买过一块又让我给退了,各种羡慕嫉妒恨。

昨天终于等到了 hipfire 的更新。连夜在单张 RX 7900 XTX 上测试 Qwen3.8-27B,hipfire DFlash 的表现惊艳,也让我感觉7900XTX终于又可以扬眉吐气,与时俱进了。

测试摘要
参考我之前关于本地模型测速口径的帖子:https://lcz.me/topic/2303
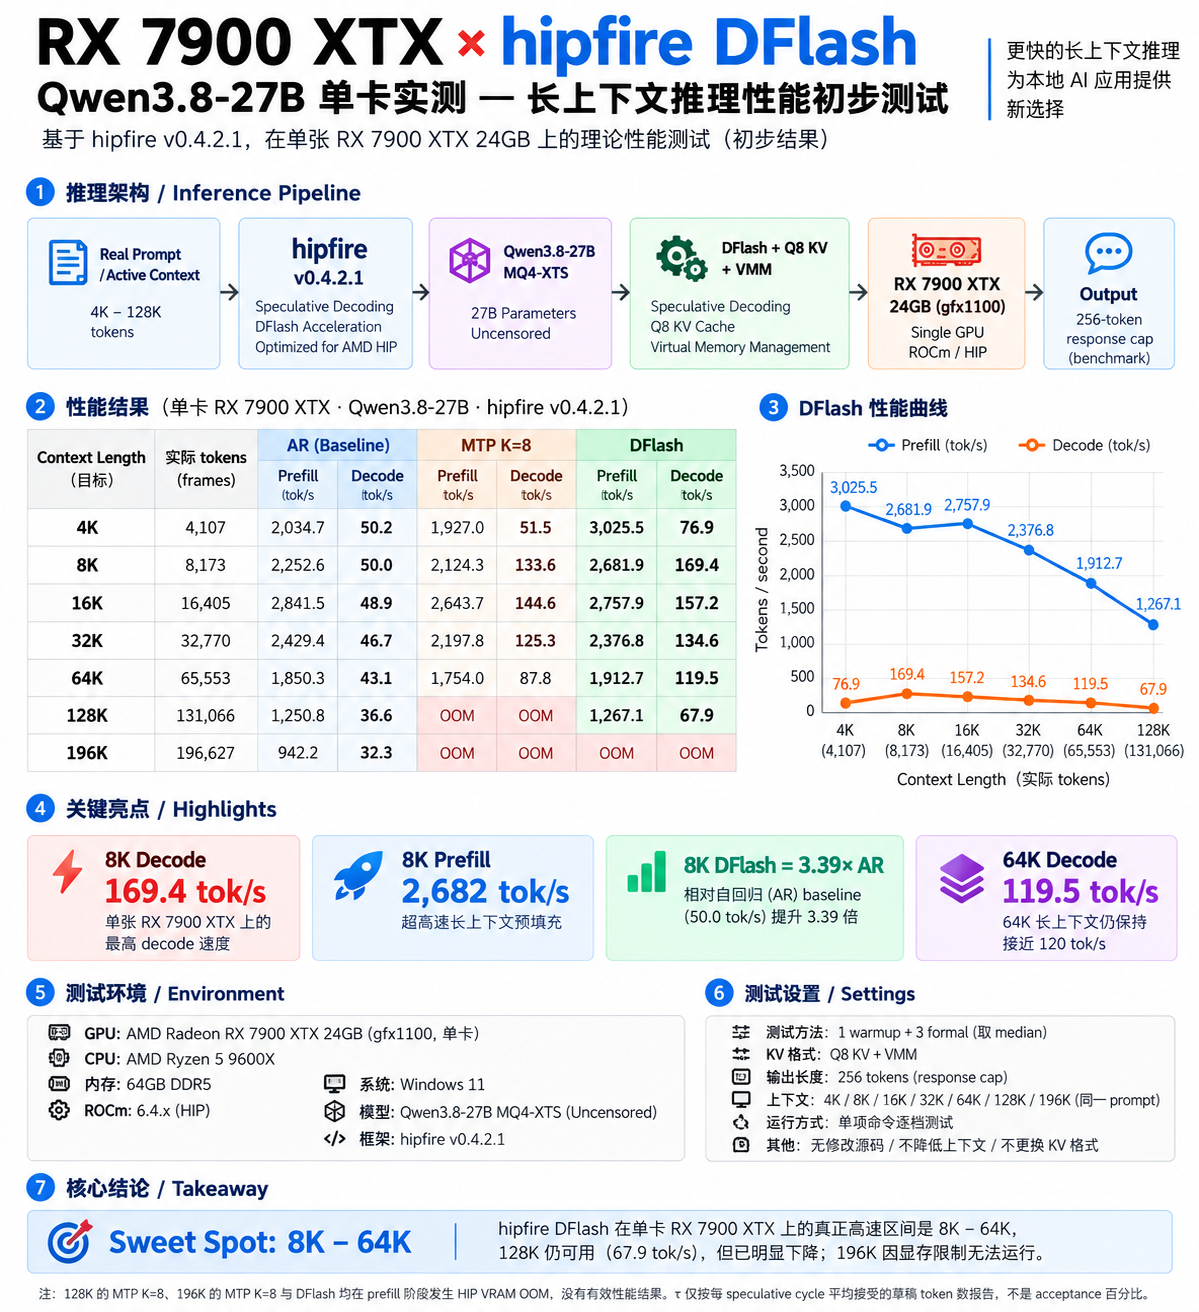
Model Quant Engine GPU Context Output C Cache Prefill TTFT Decode VRAM Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 4K 256 C1 Cold 3026 1.36s 76.9 ~17.5GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 8K 256 C1 Cold 2682 3.05s 169.4 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 16K 256 C1 Cold 2758 5.95s 157.2 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 32K 256 C1 Cold 2377 13.79s 134.6 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 64K 256 C1 Cold 1913 34.27s 119.5 ~17.7GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 128K 256 C1 Cold 1267 103.44s 67.9 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 196K 256 C1 Cold OOM OOM OOM OOM Highlights
- 8K:2682 tok/s Prefill + 169.4 tok/s Decode
- 32K:2377 tok/s Prefill + 134.6 tok/s Decode
- 64K:1913 tok/s Prefill + 119.5 tok/s Decode
- 8K DFlash 相对 AR:3.39×
- 高速甜点区:8K–64K
叠甲:本帖首先看的是推理引擎本身的 Cold Context 性能,不代表长期 Agent 的最终实际体验。实际 Agent 测试会另开一帖。
一、测试环境
项目 设置 GPU AMD Radeon RX 7900 XTX 24GB ×1 GPU Arch gfx1100 模型 Qwen3.8-27B Quant MQ4-XTS Engine hipfire v0.4.2.1 KV Cache Q8 VMM Enabled Speculative DFlash Output Length 256 tokens Concurrency C1 Cache Cold / 无跨请求 Prefix Cache 命中 Warm-up 1 Formal Runs 3 / 档 结果 Formal median 注:同一 Context 档三条路线使用完全相同的 Prompt;表中 Actual Prompt 为 hipfire daemon 最终报告的 framed prompt_tokens。
二、DFlash 单卡完整结果
Context Actual Prompt Prefill TTFT Decode τ¹ VRAM sampled peak 4K 4,107 3,025.5 tok/s 1.36 s 76.9 tok/s 6.00 约 17.5 GB 8K 8,173 2,681.9 tok/s 3.05 s 169.4 tok/s 8.80 约 17.9 GB 16K 16,405 2,757.9 tok/s 5.95 s 157.2 tok/s 8.80 约 17.6 GB 32K 32,770 2,376.8 tok/s 13.79 s 134.6 tok/s 8.80 约 17.6 GB 64K 65,553 1,912.7 tok/s 34.27 s 119.5 tok/s 11.25 约 17.7 GB 128K 131,066 1,267.1 tok/s 103.44 s 67.9 tok/s 8.80 约 17.9 GB 196K 196,627 OOM OOM OOM N/A N/A ¹ τ(tau)为 官方hipfire daemon 报告的“每个 speculative cycle 平均接受的草稿 token 数”。数值越高,通常表示 speculative decoding 一次能连续接受更多草稿 token,但它 不等同于 acceptance rate,也不是 acceptance 百分比。
三、AR / MTP / DFlash 横向对比
为了看清 speculative decode 到底带来了多少提升,我同时测试了普通 AR 和 Native MTP K=8。
Decode
Context AR Decode MTP K=8 Decode DFlash Decode 4K 50.2 51.5 76.9 8K 50.0 133.6 169.4 16K 48.9 144.6 157.2 32K 46.7 125.3 134.6 64K 43.1 87.8 119.5 128K 36.6 OOM 67.9 196K 32.3 OOM OOM Prefill
Context AR Prefill MTP K=8 Prefill DFlash Prefill 4K 2,034.7 1,927.0 3,025.5 8K 2,252.6 2,124.3 2,681.9 16K 2,841.5 2,643.7 2,757.9 32K 2,429.4 2,197.8 2,376.8 64K 1,850.3 1,754.0 1,912.7 128K 1,250.8 OOM 1,267.1 196K 942.2 OOM OOM 几个比较明显的现象:
- AR 的基础 Decode 随 Context 增长下降得比较平缓;
- MTP 在 128K 已经因为 VRAM OOM 无法完成;
- DFlash 在 128K 仍然能维持 67.9 tok/s;
- 到 196K,MTP 和 DFlash 都在 Prefill 阶段 OOM,只有 AR 仍能运行;
- DFlash 的优势最明显地集中在 8K–64K;
- Prefill 并不是所有档位都由 DFlash 领先,16K 和 32K 的 AR Prefill 略高,但 DFlash 的整体 Decode 优势非常明显。
四、长上下文表现
从实测来看,我会把这套 DFlash 的高速甜点区暂时定在:
8K–64K
其中:
- 8K:169.4 tok/s
- 16K:157.2 tok/s
- 32K:134.6 tok/s
- 64K:119.5 tok/s
尤其是 64K,单卡 RX 7900 XTX 仍然可以做到:
1913 tok/s Prefill + 119.5 tok/s Decode
我认为这一点比单纯的 8K 峰值更有意义。
128K 仍然可以正常运行:
1267 tok/s Prefill + 67.9 tok/s Decode
不过从 64K 到 128K 已经出现明显掉速。
196K 下 DFlash 在 Prefill 阶段发生 HIP VRAM OOM,因此没有有效性能结果。本轮也没有通过降低 KV 精度、修改量化格式或源码来进一步压缩显存。实际生产环境里,可以把 Agent 的最大上下文限制在一个低于 OOM 边界的值;目前已确认 128K 可以正常运行,128K–196K 之间的具体安全上限后续还可以继续摸索,配合合理的 Context 压缩机制即可避免 Agent 撞上显存墙。
五、关于 τ、VRAM 和测试口径
这里特别说明几个口径问题。
1. τ 不是 Acceptance Rate
hipfire daemon 报告的 τ 是:
每个 speculative cycle 平均接受的草稿 Token 数
它不是 Acceptance 百分比。
当前
hipfire bench汇总 JSON 没有提供 drafted / accepted 的原始总数,因此本文不推算 Acceptance Rate。2. VRAM 是采样参考值
本文 VRAM 来自 hipfire daemon 遥测采样中的最大值。
它可以作为不同配置之间的参考,但:
不是独立高频显存监控得到的绝对峰值。
3. 测试是 Cold Context
这次主要测试模型和推理引擎本身的性能。
没有依赖 Radix Cache、Prefix Cache 或类似 KVMem 的跨请求上下文复用机制。
因此这些结果更接近:
一次新的真实 Prompt 送进模型后,Engine 本身能够做到什么速度。
这一点对后续 Agent 实测非常重要。
因为真实长期 Agent 场景下,除了 Prefill 和 Decode,本质上还要看:
- Prefix reuse
- Cache hit
- 多轮历史复用
- Tool latency
- 整体任务 wall time
这也是我准备下一篇实际使用测试重点看的内容。
六、部署与启动参数
参见附件:
7900 XTX 的可能性探索 单卡篇(五) 之 部署与启动参数.md
七、最后的说明和一点个人感想
单张 RX 7900 XTX,在 hipfire 的专项优化下,Qwen3.8-27B 的跑分表现达到了我历次 7900 XTX 单卡测试中的新高度。
从 Benchmark 看,目前数字确实相当惊艳:
8K Decode 169.4 tok/s,64K 仍有 119.5 tok/s;8K Prefill 2682 tok/s。
不过 Benchmark 成绩当然不等于真实生产体验。
本帖首先测试的是 Cold Context 下推理引擎本身的性能。下一步我会把这套模型真正接入 Agent 工作流,再单独分享实际使用中的表现,包括:
- Tool Calling
- Coding / Debug
- 多轮任务
- 实际任务完成时间
- 长上下文下的响应体验
- Prefix / Cache 缺失对实际 Agent 的影响 (注:官方已经有 PR 在提升 Prefix/Cache)
- 与我目前另一套单卡 FN IQ3 Agent 方案进行 A/B 对比
到时候再继续更新。
个人一点感想
先看看 RX 7900 XTX 和 RTX 3090 的硬件底子:
规格 RX 7900 XTX RTX 3090 架构 RDNA 3 / Navi 31 Ampere / GA102 显存 24GB GDDR6 24GB GDDR6X 显存位宽 384-bit 384-bit 显存带宽 960 GB/s 936 GB/s FP32 约 61.4 TFLOPS 约 35.6 TFLOPS PCIe PCIe 4.0 ×16 PCIe 4.0 ×16 TBP / TGP 355W 350W AI 软件生态 ROCm / HIP CUDA 两张卡都有 24GB 显存、384-bit 总线、接近 1TB/s 的显存带宽,功耗也处于同一级别。
7900 XTX 的硬件规格本身一直不弱。过去在本地 AI 推理上的主要差距,更多来自 CUDA、Tensor Core,以及 NVIDIA 阵营长期积累的 AI kernel 和软件生态。
所以这次 hipfire 最让我欣慰的地方,是:
终于开始有软件真正把 RDNA3 本身的硬件潜力往 AI 推理方向挖出来。
Newegg 当前新卡价格参考
GPU Newegg 当前可见价格 备注 RX 7900 XTX 24GB 约 $1,399–$1,499 新卡 RTX 3090 24GB 约 $2,099–$2,399 多为老库存 / 第三方卖家 这里比较的是 当前 Newegg 新卡挂牌价,不能代表二手市场。
3090 有 NVLink 和成熟 CUDA 生态的天然优势;7900 XTX 则胜在仍有新卡保修、24GB 显存,以及相对更低的新卡价格。
而随着 Strata 的应运而生,以及 hipfire 这类面向 RDNA3 的专项优化逐渐成熟,7900 XTX 的 24GB 显存、接近 1TB/s 的显存带宽,也终于开始越来越充分地转化为实际的本地 AI 推理性能。
这也是我持续更新这个“7900 XTX 的可能性探索”系列的动力之一:把自己的折腾和测试结果分享出来,回报论坛和社区,也顺便看看这张卡的潜力究竟还能被挖到哪里。
无它,不是哥们买不起(

 ),而是折腾7900 XTX 更有性价比。
-
-
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s
前言/致谢
首先真心感谢 hipfire 团队为 AMD / RDNA 社区做出的贡献。(还有hipEngine,BridgeSpec,llama-cpp-rdna-boosts,KVMem,MoE4All,AMD-AIM / sglang-radeon,Paiton vLLM plugin,以及更多长期为 AMD 本地 AI 推理生态默默投入时间和精力的开发者、研究者和社区大神们)
项目地址:https://github.com/warpfront/hipfire
最近感受到了来自于N卡阵营满满的“敌意”
,尤其是类似于nInfer这类的定向优化让我“醋意满满”(其实我也有N卡,哈哈);甚至RDNA4 PRO R9700的优化也一日千里 —— 这个真么有,曾经买过一块又让我给退了,各种羡慕嫉妒恨。 昨天终于等到了 hipfire 的更新。连夜在单张 RX 7900 XTX 上测试 Qwen3.8-27B,hipfire DFlash 的表现惊艳,也让我感觉7900XTX终于又可以扬眉吐气,与时俱进了。
测试摘要
参考我之前关于本地模型测速口径的帖子:https://lcz.me/topic/2303
Model Quant Engine GPU Context Output C Cache Prefill TTFT Decode VRAM Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 4K 256 C1 Cold 3026 1.36s 76.9 ~17.5GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 8K 256 C1 Cold 2682 3.05s 169.4 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 16K 256 C1 Cold 2758 5.95s 157.2 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 32K 256 C1 Cold 2377 13.79s 134.6 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 64K 256 C1 Cold 1913 34.27s 119.5 ~17.7GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 128K 256 C1 Cold 1267 103.44s 67.9 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 196K 256 C1 Cold OOM OOM OOM OOM Highlights
- 8K:2682 tok/s Prefill + 169.4 tok/s Decode
- 32K:2377 tok/s Prefill + 134.6 tok/s Decode
- 64K:1913 tok/s Prefill + 119.5 tok/s Decode
- 8K DFlash 相对 AR:3.39×
- 高速甜点区:8K–64K
叠甲:本帖首先看的是推理引擎本身的 Cold Context 性能,不代表长期 Agent 的最终实际体验。实际 Agent 测试会另开一帖。
一、测试环境
项目 设置 GPU AMD Radeon RX 7900 XTX 24GB ×1 GPU Arch gfx1100 模型 Qwen3.8-27B Quant MQ4-XTS Engine hipfire v0.4.2.1 KV Cache Q8 VMM Enabled Speculative DFlash Output Length 256 tokens Concurrency C1 Cache Cold / 无跨请求 Prefix Cache 命中 Warm-up 1 Formal Runs 3 / 档 结果 Formal median 注:同一 Context 档三条路线使用完全相同的 Prompt;表中 Actual Prompt 为 hipfire daemon 最终报告的 framed prompt_tokens。
二、DFlash 单卡完整结果
Context Actual Prompt Prefill TTFT Decode τ¹ VRAM sampled peak 4K 4,107 3,025.5 tok/s 1.36 s 76.9 tok/s 6.00 约 17.5 GB 8K 8,173 2,681.9 tok/s 3.05 s 169.4 tok/s 8.80 约 17.9 GB 16K 16,405 2,757.9 tok/s 5.95 s 157.2 tok/s 8.80 约 17.6 GB 32K 32,770 2,376.8 tok/s 13.79 s 134.6 tok/s 8.80 约 17.6 GB 64K 65,553 1,912.7 tok/s 34.27 s 119.5 tok/s 11.25 约 17.7 GB 128K 131,066 1,267.1 tok/s 103.44 s 67.9 tok/s 8.80 约 17.9 GB 196K 196,627 OOM OOM OOM N/A N/A ¹ τ(tau)为 官方hipfire daemon 报告的“每个 speculative cycle 平均接受的草稿 token 数”。数值越高,通常表示 speculative decoding 一次能连续接受更多草稿 token,但它 不等同于 acceptance rate,也不是 acceptance 百分比。
三、AR / MTP / DFlash 横向对比
为了看清 speculative decode 到底带来了多少提升,我同时测试了普通 AR 和 Native MTP K=8。
Decode
Context AR Decode MTP K=8 Decode DFlash Decode 4K 50.2 51.5 76.9 8K 50.0 133.6 169.4 16K 48.9 144.6 157.2 32K 46.7 125.3 134.6 64K 43.1 87.8 119.5 128K 36.6 OOM 67.9 196K 32.3 OOM OOM Prefill
Context AR Prefill MTP K=8 Prefill DFlash Prefill 4K 2,034.7 1,927.0 3,025.5 8K 2,252.6 2,124.3 2,681.9 16K 2,841.5 2,643.7 2,757.9 32K 2,429.4 2,197.8 2,376.8 64K 1,850.3 1,754.0 1,912.7 128K 1,250.8 OOM 1,267.1 196K 942.2 OOM OOM 几个比较明显的现象:
- AR 的基础 Decode 随 Context 增长下降得比较平缓;
- MTP 在 128K 已经因为 VRAM OOM 无法完成;
- DFlash 在 128K 仍然能维持 67.9 tok/s;
- 到 196K,MTP 和 DFlash 都在 Prefill 阶段 OOM,只有 AR 仍能运行;
- DFlash 的优势最明显地集中在 8K–64K;
- Prefill 并不是所有档位都由 DFlash 领先,16K 和 32K 的 AR Prefill 略高,但 DFlash 的整体 Decode 优势非常明显。
四、长上下文表现
从实测来看,我会把这套 DFlash 的高速甜点区暂时定在:
8K–64K
其中:
- 8K:169.4 tok/s
- 16K:157.2 tok/s
- 32K:134.6 tok/s
- 64K:119.5 tok/s
尤其是 64K,单卡 RX 7900 XTX 仍然可以做到:
1913 tok/s Prefill + 119.5 tok/s Decode
我认为这一点比单纯的 8K 峰值更有意义。
128K 仍然可以正常运行:
1267 tok/s Prefill + 67.9 tok/s Decode
不过从 64K 到 128K 已经出现明显掉速。
196K 下 DFlash 在 Prefill 阶段发生 HIP VRAM OOM,因此没有有效性能结果。本轮也没有通过降低 KV 精度、修改量化格式或源码来进一步压缩显存。实际生产环境里,可以把 Agent 的最大上下文限制在一个低于 OOM 边界的值;目前已确认 128K 可以正常运行,128K–196K 之间的具体安全上限后续还可以继续摸索,配合合理的 Context 压缩机制即可避免 Agent 撞上显存墙。
五、关于 τ、VRAM 和测试口径
这里特别说明几个口径问题。
1. τ 不是 Acceptance Rate
hipfire daemon 报告的 τ 是:
每个 speculative cycle 平均接受的草稿 Token 数
它不是 Acceptance 百分比。
当前
hipfire bench汇总 JSON 没有提供 drafted / accepted 的原始总数,因此本文不推算 Acceptance Rate。2. VRAM 是采样参考值
本文 VRAM 来自 hipfire daemon 遥测采样中的最大值。
它可以作为不同配置之间的参考,但:
不是独立高频显存监控得到的绝对峰值。
3. 测试是 Cold Context
这次主要测试模型和推理引擎本身的性能。
没有依赖 Radix Cache、Prefix Cache 或类似 KVMem 的跨请求上下文复用机制。
因此这些结果更接近:
一次新的真实 Prompt 送进模型后,Engine 本身能够做到什么速度。
这一点对后续 Agent 实测非常重要。
因为真实长期 Agent 场景下,除了 Prefill 和 Decode,本质上还要看:
- Prefix reuse
- Cache hit
- 多轮历史复用
- Tool latency
- 整体任务 wall time
这也是我准备下一篇实际使用测试重点看的内容。
六、部署与启动参数
参见附件:
7900 XTX 的可能性探索 单卡篇(五) 之 部署与启动参数.md
七、最后的说明和一点个人感想
单张 RX 7900 XTX,在 hipfire 的专项优化下,Qwen3.8-27B 的跑分表现达到了我历次 7900 XTX 单卡测试中的新高度。
从 Benchmark 看,目前数字确实相当惊艳:
8K Decode 169.4 tok/s,64K 仍有 119.5 tok/s;8K Prefill 2682 tok/s。
不过 Benchmark 成绩当然不等于真实生产体验。
本帖首先测试的是 Cold Context 下推理引擎本身的性能。下一步我会把这套模型真正接入 Agent 工作流,再单独分享实际使用中的表现,包括:
- Tool Calling
- Coding / Debug
- 多轮任务
- 实际任务完成时间
- 长上下文下的响应体验
- Prefix / Cache 缺失对实际 Agent 的影响 (注:官方已经有 PR 在提升 Prefix/Cache)
- 与我目前另一套单卡 FN IQ3 Agent 方案进行 A/B 对比
到时候再继续更新。
个人一点感想
先看看 RX 7900 XTX 和 RTX 3090 的硬件底子:
规格 RX 7900 XTX RTX 3090 架构 RDNA 3 / Navi 31 Ampere / GA102 显存 24GB GDDR6 24GB GDDR6X 显存位宽 384-bit 384-bit 显存带宽 960 GB/s 936 GB/s FP32 约 61.4 TFLOPS 约 35.6 TFLOPS PCIe PCIe 4.0 ×16 PCIe 4.0 ×16 TBP / TGP 355W 350W AI 软件生态 ROCm / HIP CUDA 两张卡都有 24GB 显存、384-bit 总线、接近 1TB/s 的显存带宽,功耗也处于同一级别。
7900 XTX 的硬件规格本身一直不弱。过去在本地 AI 推理上的主要差距,更多来自 CUDA、Tensor Core,以及 NVIDIA 阵营长期积累的 AI kernel 和软件生态。
所以这次 hipfire 最让我欣慰的地方,是:
终于开始有软件真正把 RDNA3 本身的硬件潜力往 AI 推理方向挖出来。
Newegg 当前新卡价格参考
GPU Newegg 当前可见价格 备注 RX 7900 XTX 24GB 约 $1,399–$1,499 新卡 RTX 3090 24GB 约 $2,099–$2,399 多为老库存 / 第三方卖家 这里比较的是 当前 Newegg 新卡挂牌价,不能代表二手市场。
3090 有 NVLink 和成熟 CUDA 生态的天然优势;7900 XTX 则胜在仍有新卡保修、24GB 显存,以及相对更低的新卡价格。
而随着 Strata 的应运而生,以及 hipfire 这类面向 RDNA3 的专项优化逐渐成熟,7900 XTX 的 24GB 显存、接近 1TB/s 的显存带宽,也终于开始越来越充分地转化为实际的本地 AI 推理性能。
这也是我持续更新这个“7900 XTX 的可能性探索”系列的动力之一:把自己的折腾和测试结果分享出来,回报论坛和社区,也顺便看看这张卡的潜力究竟还能被挖到哪里。
无它,不是哥们买不起(
),而是折腾7900 XTX 更有性价比。而随着 Strata 的应运而生,以及 hipfire 这类面向 RDNA3 的专项优化逐渐成熟,7900 XTX 的 24GB 显存、接近 1TB/s 的显存带宽,也终于开始越来越充分地转化为实际的本地 AI 推理性能。
这也是我持续更新这个“7900 XTX 的可能性探索”系列的动力之一:把自己的折腾和测试结果分享出来,回报论坛和社区,也顺便看看这张卡的潜力究竟还能被挖到哪里。
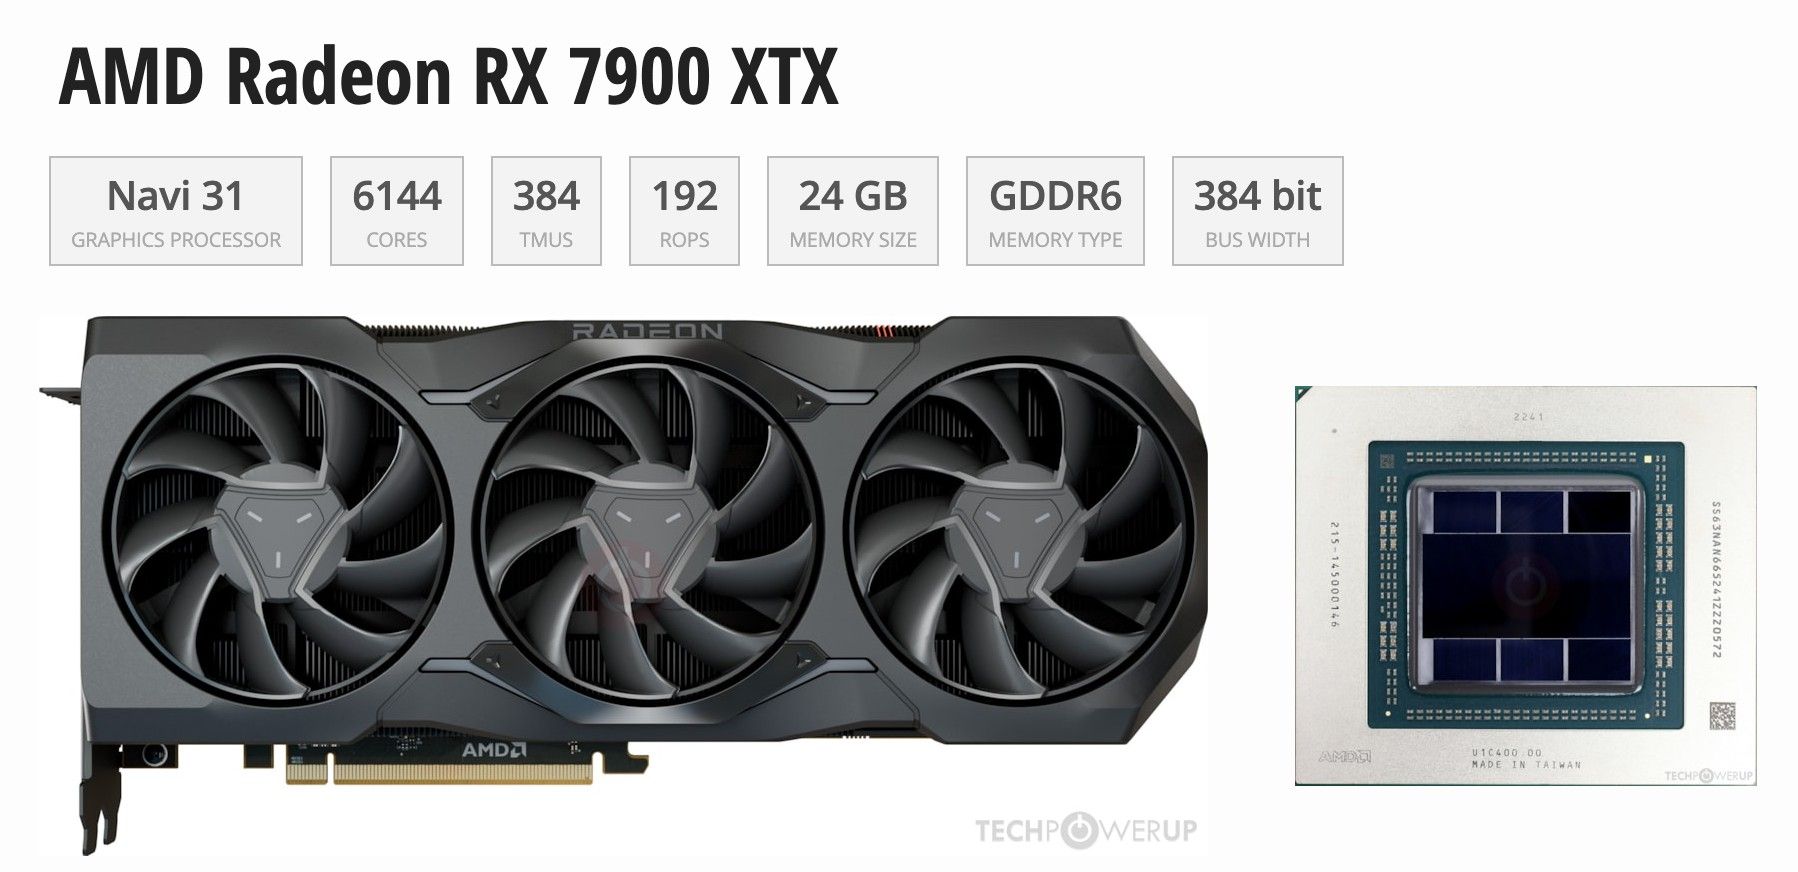
我有點好奇 AMD 是否還有在生產 Navi 31 GPU ? 畢竟現在半導體產能競爭激烈
新卡的貨源不知道是以前的庫存還是2026年生產的GPU Name : Navi 31
GPU Variant : Navi 31 XTX (215-145000146)
-
-
而随着 Strata 的应运而生,以及 hipfire 这类面向 RDNA3 的专项优化逐渐成熟,7900 XTX 的 24GB 显存、接近 1TB/s 的显存带宽,也终于开始越来越充分地转化为实际的本地 AI 推理性能。
这也是我持续更新这个“7900 XTX 的可能性探索”系列的动力之一:把自己的折腾和测试结果分享出来,回报论坛和社区,也顺便看看这张卡的潜力究竟还能被挖到哪里。
我有點好奇 AMD 是否還有在生產 Navi 31 GPU ? 畢竟現在半導體產能競爭激烈
新卡的貨源不知道是以前的庫存還是2026年生產的GPU Name : Navi 31
GPU Variant : Navi 31 XTX (215-145000146)
-
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s
前言/致谢
首先真心感谢 hipfire 团队为 AMD / RDNA 社区做出的贡献。(还有hipEngine,BridgeSpec,llama-cpp-rdna-boosts,KVMem,MoE4All,AMD-AIM / sglang-radeon,Paiton vLLM plugin,以及更多长期为 AMD 本地 AI 推理生态默默投入时间和精力的开发者、研究者和社区大神们)
项目地址:https://github.com/warpfront/hipfire
最近感受到了来自于N卡阵营满满的“敌意”
,尤其是类似于nInfer这类的定向优化让我“醋意满满”(其实我也有N卡,哈哈);甚至RDNA4 PRO R9700的优化也一日千里 —— 这个真么有,曾经买过一块又让我给退了,各种羡慕嫉妒恨。 昨天终于等到了 hipfire 的更新。连夜在单张 RX 7900 XTX 上测试 Qwen3.8-27B,hipfire DFlash 的表现惊艳,也让我感觉7900XTX终于又可以扬眉吐气,与时俱进了。
测试摘要
参考我之前关于本地模型测速口径的帖子:https://lcz.me/topic/2303
Model Quant Engine GPU Context Output C Cache Prefill TTFT Decode VRAM Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 4K 256 C1 Cold 3026 1.36s 76.9 ~17.5GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 8K 256 C1 Cold 2682 3.05s 169.4 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 16K 256 C1 Cold 2758 5.95s 157.2 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 32K 256 C1 Cold 2377 13.79s 134.6 ~17.6GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 64K 256 C1 Cold 1913 34.27s 119.5 ~17.7GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 128K 256 C1 Cold 1267 103.44s 67.9 ~17.9GB Qwen3.8-27B MQ4-XTS hipfire DFlash RX 7900 XTX ×1 196K 256 C1 Cold OOM OOM OOM OOM Highlights
- 8K:2682 tok/s Prefill + 169.4 tok/s Decode
- 32K:2377 tok/s Prefill + 134.6 tok/s Decode
- 64K:1913 tok/s Prefill + 119.5 tok/s Decode
- 8K DFlash 相对 AR:3.39×
- 高速甜点区:8K–64K
叠甲:本帖首先看的是推理引擎本身的 Cold Context 性能,不代表长期 Agent 的最终实际体验。实际 Agent 测试会另开一帖。
一、测试环境
项目 设置 GPU AMD Radeon RX 7900 XTX 24GB ×1 GPU Arch gfx1100 模型 Qwen3.8-27B Quant MQ4-XTS Engine hipfire v0.4.2.1 KV Cache Q8 VMM Enabled Speculative DFlash Output Length 256 tokens Concurrency C1 Cache Cold / 无跨请求 Prefix Cache 命中 Warm-up 1 Formal Runs 3 / 档 结果 Formal median 注:同一 Context 档三条路线使用完全相同的 Prompt;表中 Actual Prompt 为 hipfire daemon 最终报告的 framed prompt_tokens。
二、DFlash 单卡完整结果
Context Actual Prompt Prefill TTFT Decode τ¹ VRAM sampled peak 4K 4,107 3,025.5 tok/s 1.36 s 76.9 tok/s 6.00 约 17.5 GB 8K 8,173 2,681.9 tok/s 3.05 s 169.4 tok/s 8.80 约 17.9 GB 16K 16,405 2,757.9 tok/s 5.95 s 157.2 tok/s 8.80 约 17.6 GB 32K 32,770 2,376.8 tok/s 13.79 s 134.6 tok/s 8.80 约 17.6 GB 64K 65,553 1,912.7 tok/s 34.27 s 119.5 tok/s 11.25 约 17.7 GB 128K 131,066 1,267.1 tok/s 103.44 s 67.9 tok/s 8.80 约 17.9 GB 196K 196,627 OOM OOM OOM N/A N/A ¹ τ(tau)为 官方hipfire daemon 报告的“每个 speculative cycle 平均接受的草稿 token 数”。数值越高,通常表示 speculative decoding 一次能连续接受更多草稿 token,但它 不等同于 acceptance rate,也不是 acceptance 百分比。
三、AR / MTP / DFlash 横向对比
为了看清 speculative decode 到底带来了多少提升,我同时测试了普通 AR 和 Native MTP K=8。
Decode
Context AR Decode MTP K=8 Decode DFlash Decode 4K 50.2 51.5 76.9 8K 50.0 133.6 169.4 16K 48.9 144.6 157.2 32K 46.7 125.3 134.6 64K 43.1 87.8 119.5 128K 36.6 OOM 67.9 196K 32.3 OOM OOM Prefill
Context AR Prefill MTP K=8 Prefill DFlash Prefill 4K 2,034.7 1,927.0 3,025.5 8K 2,252.6 2,124.3 2,681.9 16K 2,841.5 2,643.7 2,757.9 32K 2,429.4 2,197.8 2,376.8 64K 1,850.3 1,754.0 1,912.7 128K 1,250.8 OOM 1,267.1 196K 942.2 OOM OOM 几个比较明显的现象:
- AR 的基础 Decode 随 Context 增长下降得比较平缓;
- MTP 在 128K 已经因为 VRAM OOM 无法完成;
- DFlash 在 128K 仍然能维持 67.9 tok/s;
- 到 196K,MTP 和 DFlash 都在 Prefill 阶段 OOM,只有 AR 仍能运行;
- DFlash 的优势最明显地集中在 8K–64K;
- Prefill 并不是所有档位都由 DFlash 领先,16K 和 32K 的 AR Prefill 略高,但 DFlash 的整体 Decode 优势非常明显。
四、长上下文表现
从实测来看,我会把这套 DFlash 的高速甜点区暂时定在:
8K–64K
其中:
- 8K:169.4 tok/s
- 16K:157.2 tok/s
- 32K:134.6 tok/s
- 64K:119.5 tok/s
尤其是 64K,单卡 RX 7900 XTX 仍然可以做到:
1913 tok/s Prefill + 119.5 tok/s Decode
我认为这一点比单纯的 8K 峰值更有意义。
128K 仍然可以正常运行:
1267 tok/s Prefill + 67.9 tok/s Decode
不过从 64K 到 128K 已经出现明显掉速。
196K 下 DFlash 在 Prefill 阶段发生 HIP VRAM OOM,因此没有有效性能结果。本轮也没有通过降低 KV 精度、修改量化格式或源码来进一步压缩显存。实际生产环境里,可以把 Agent 的最大上下文限制在一个低于 OOM 边界的值;目前已确认 128K 可以正常运行,128K–196K 之间的具体安全上限后续还可以继续摸索,配合合理的 Context 压缩机制即可避免 Agent 撞上显存墙。
五、关于 τ、VRAM 和测试口径
这里特别说明几个口径问题。
1. τ 不是 Acceptance Rate
hipfire daemon 报告的 τ 是:
每个 speculative cycle 平均接受的草稿 Token 数
它不是 Acceptance 百分比。
当前
hipfire bench汇总 JSON 没有提供 drafted / accepted 的原始总数,因此本文不推算 Acceptance Rate。2. VRAM 是采样参考值
本文 VRAM 来自 hipfire daemon 遥测采样中的最大值。
它可以作为不同配置之间的参考,但:
不是独立高频显存监控得到的绝对峰值。
3. 测试是 Cold Context
这次主要测试模型和推理引擎本身的性能。
没有依赖 Radix Cache、Prefix Cache 或类似 KVMem 的跨请求上下文复用机制。
因此这些结果更接近:
一次新的真实 Prompt 送进模型后,Engine 本身能够做到什么速度。
这一点对后续 Agent 实测非常重要。
因为真实长期 Agent 场景下,除了 Prefill 和 Decode,本质上还要看:
- Prefix reuse
- Cache hit
- 多轮历史复用
- Tool latency
- 整体任务 wall time
这也是我准备下一篇实际使用测试重点看的内容。
六、部署与启动参数
参见附件:
7900 XTX 的可能性探索 单卡篇(五) 之 部署与启动参数.md
七、最后的说明和一点个人感想
单张 RX 7900 XTX,在 hipfire 的专项优化下,Qwen3.8-27B 的跑分表现达到了我历次 7900 XTX 单卡测试中的新高度。
从 Benchmark 看,目前数字确实相当惊艳:
8K Decode 169.4 tok/s,64K 仍有 119.5 tok/s;8K Prefill 2682 tok/s。
不过 Benchmark 成绩当然不等于真实生产体验。
本帖首先测试的是 Cold Context 下推理引擎本身的性能。下一步我会把这套模型真正接入 Agent 工作流,再单独分享实际使用中的表现,包括:
- Tool Calling
- Coding / Debug
- 多轮任务
- 实际任务完成时间
- 长上下文下的响应体验
- Prefix / Cache 缺失对实际 Agent 的影响 (注:官方已经有 PR 在提升 Prefix/Cache)
- 与我目前另一套单卡 FN IQ3 Agent 方案进行 A/B 对比
到时候再继续更新。
个人一点感想
先看看 RX 7900 XTX 和 RTX 3090 的硬件底子:
规格 RX 7900 XTX RTX 3090 架构 RDNA 3 / Navi 31 Ampere / GA102 显存 24GB GDDR6 24GB GDDR6X 显存位宽 384-bit 384-bit 显存带宽 960 GB/s 936 GB/s FP32 约 61.4 TFLOPS 约 35.6 TFLOPS PCIe PCIe 4.0 ×16 PCIe 4.0 ×16 TBP / TGP 355W 350W AI 软件生态 ROCm / HIP CUDA 两张卡都有 24GB 显存、384-bit 总线、接近 1TB/s 的显存带宽,功耗也处于同一级别。
7900 XTX 的硬件规格本身一直不弱。过去在本地 AI 推理上的主要差距,更多来自 CUDA、Tensor Core,以及 NVIDIA 阵营长期积累的 AI kernel 和软件生态。
所以这次 hipfire 最让我欣慰的地方,是:
终于开始有软件真正把 RDNA3 本身的硬件潜力往 AI 推理方向挖出来。
Newegg 当前新卡价格参考
GPU Newegg 当前可见价格 备注 RX 7900 XTX 24GB 约 $1,399–$1,499 新卡 RTX 3090 24GB 约 $2,099–$2,399 多为老库存 / 第三方卖家 这里比较的是 当前 Newegg 新卡挂牌价,不能代表二手市场。
3090 有 NVLink 和成熟 CUDA 生态的天然优势;7900 XTX 则胜在仍有新卡保修、24GB 显存,以及相对更低的新卡价格。
而随着 Strata 的应运而生,以及 hipfire 这类面向 RDNA3 的专项优化逐渐成熟,7900 XTX 的 24GB 显存、接近 1TB/s 的显存带宽,也终于开始越来越充分地转化为实际的本地 AI 推理性能。
这也是我持续更新这个“7900 XTX 的可能性探索”系列的动力之一:把自己的折腾和测试结果分享出来,回报论坛和社区,也顺便看看这张卡的潜力究竟还能被挖到哪里。
无它,不是哥们买不起(
),而是折腾7900 XTX 更有性价比。 -
-
-
-
,
 T terry 固定了此主题
-
,系统 取消固定了此主题