跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
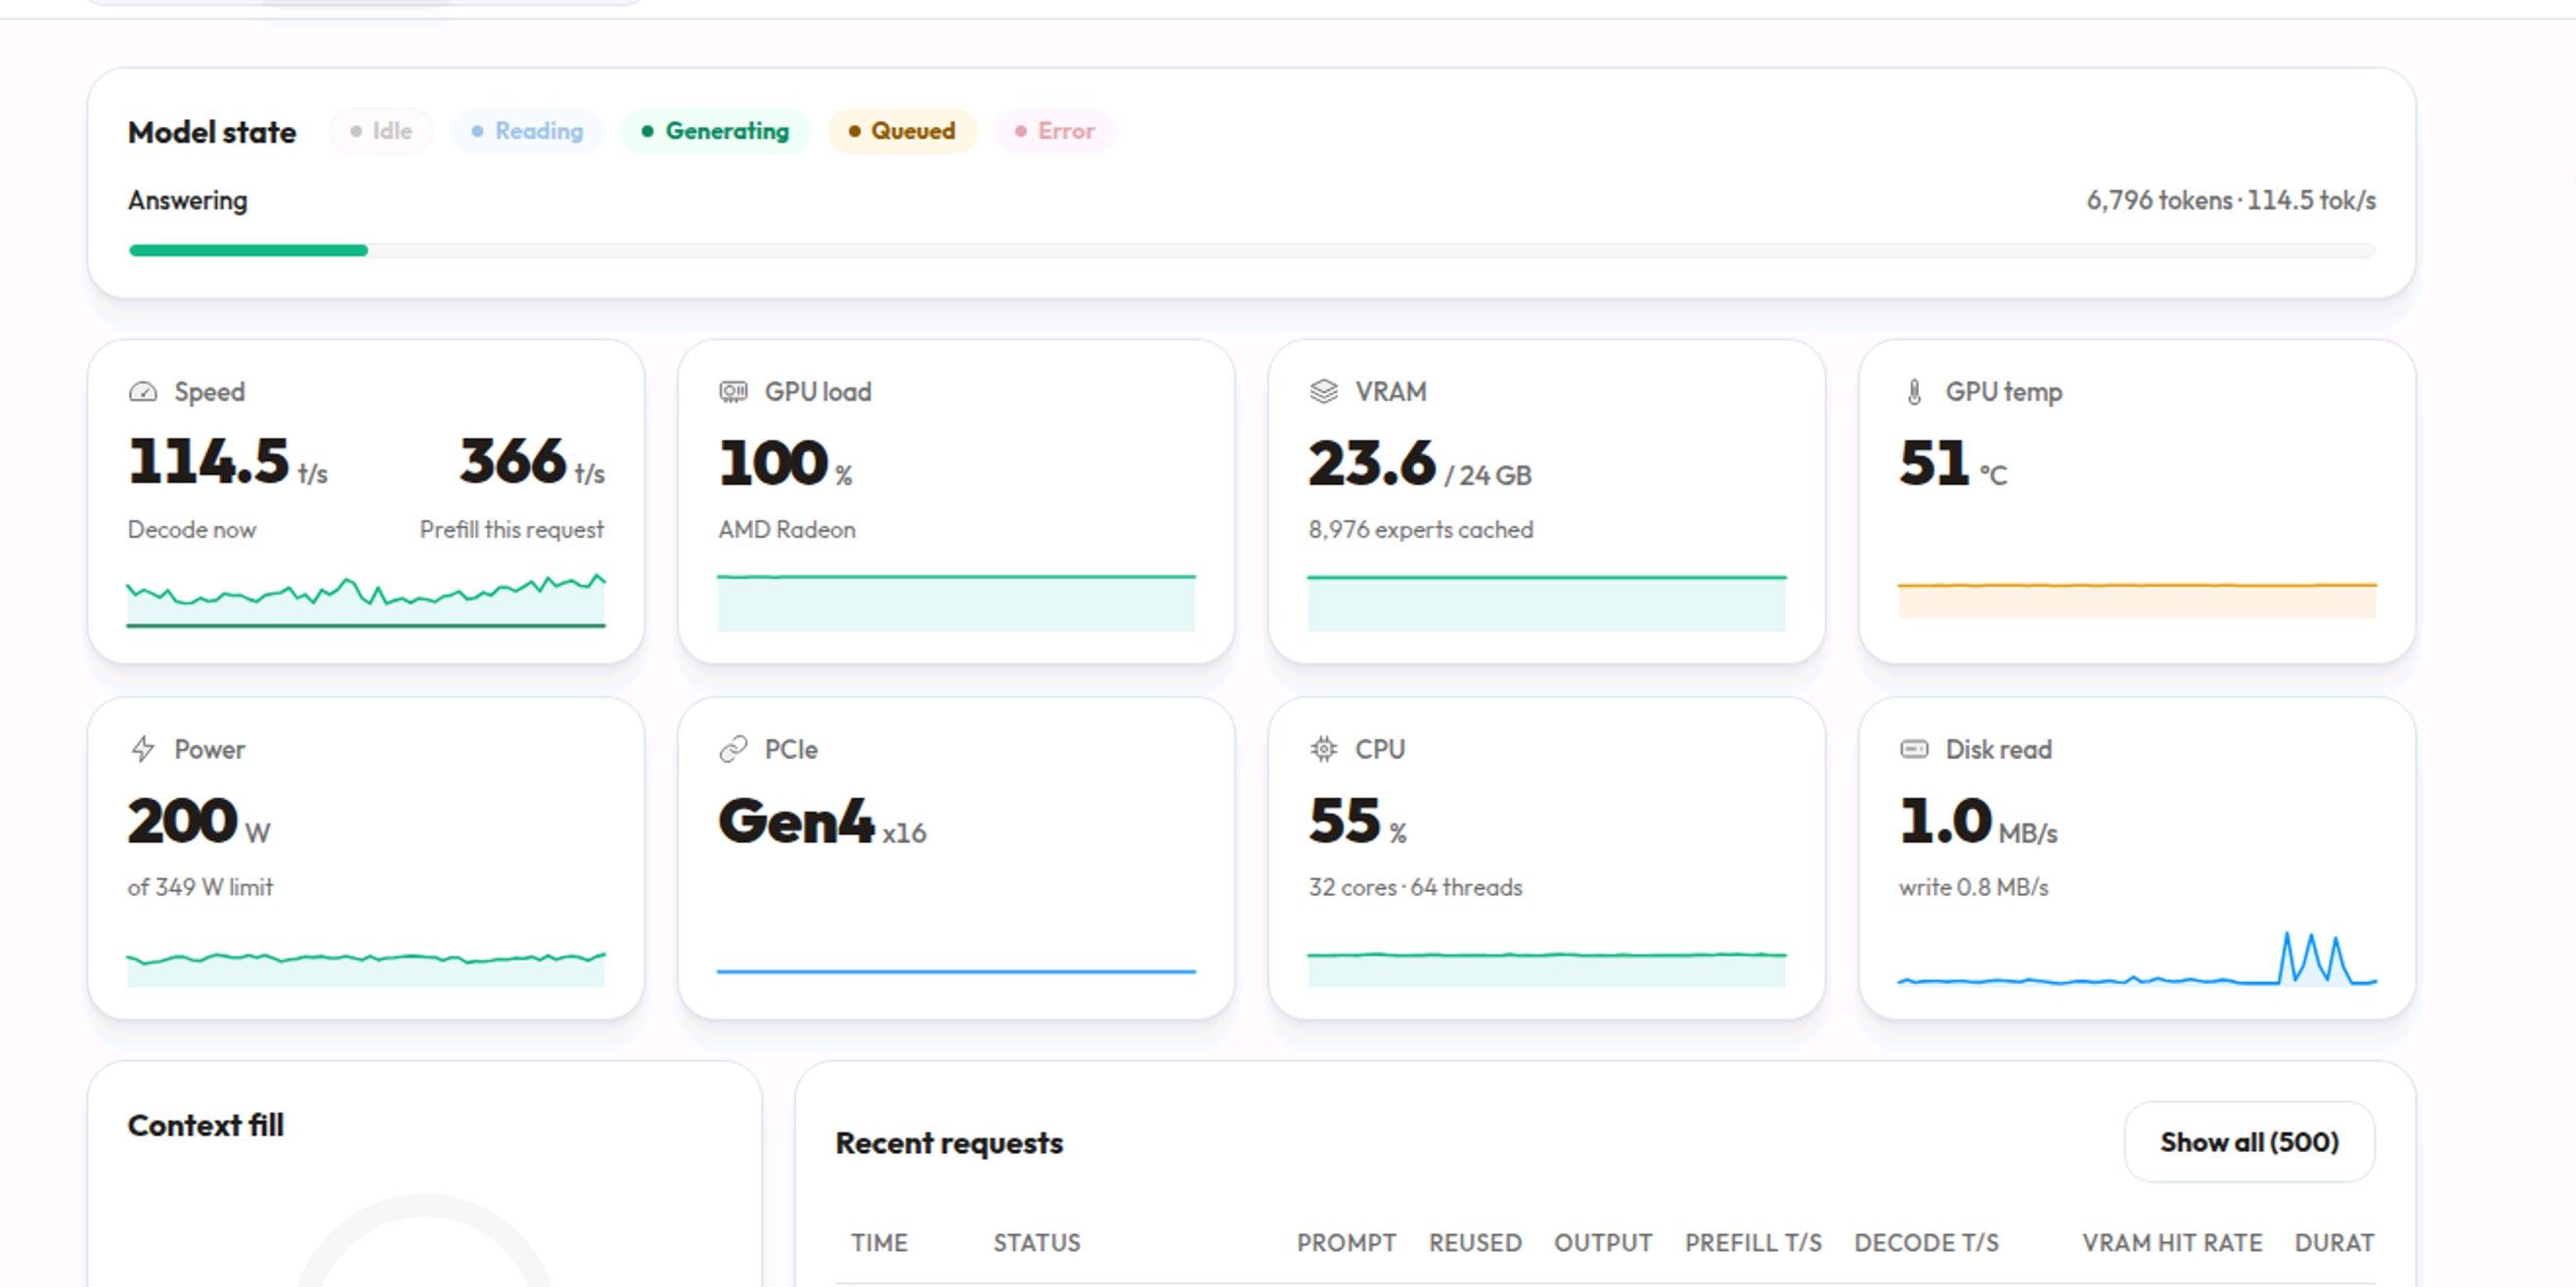
  4. 升级后单卡7900xtx,strata 可以跑 100token/s 了!!

升级后单卡7900xtx,strata 可以跑 100token/s 了!!

已定时 已固定 已锁定 已移动 LLM讨论区
7900xtxstrata
27 帖子 9 发布者 1.5k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • farmer nodeF farmer node

    如图:
    image.jpeg
    image.jpeg

    刚升级了最新的 rom 10.1 ,strata 版本 v0.1.44 , 一起升级的,这是什么奇妙的化学反应!!!

    J Z 0J
    J Z 0J
    J Z 0
    体面乡绅
    编写于 最后由 编辑
    #12

    @farmer-node 我也升了, 速度没升也没降, 但SSD疯狂读盘, 只要agent干活, 就在读ssd。 好奇怪, 我看你的ssd几乎是不动的

    farmer nodeF 1 条回复 最后回复
    1
    • 9
      9
      909
      编写于 最后由 编辑
      #13

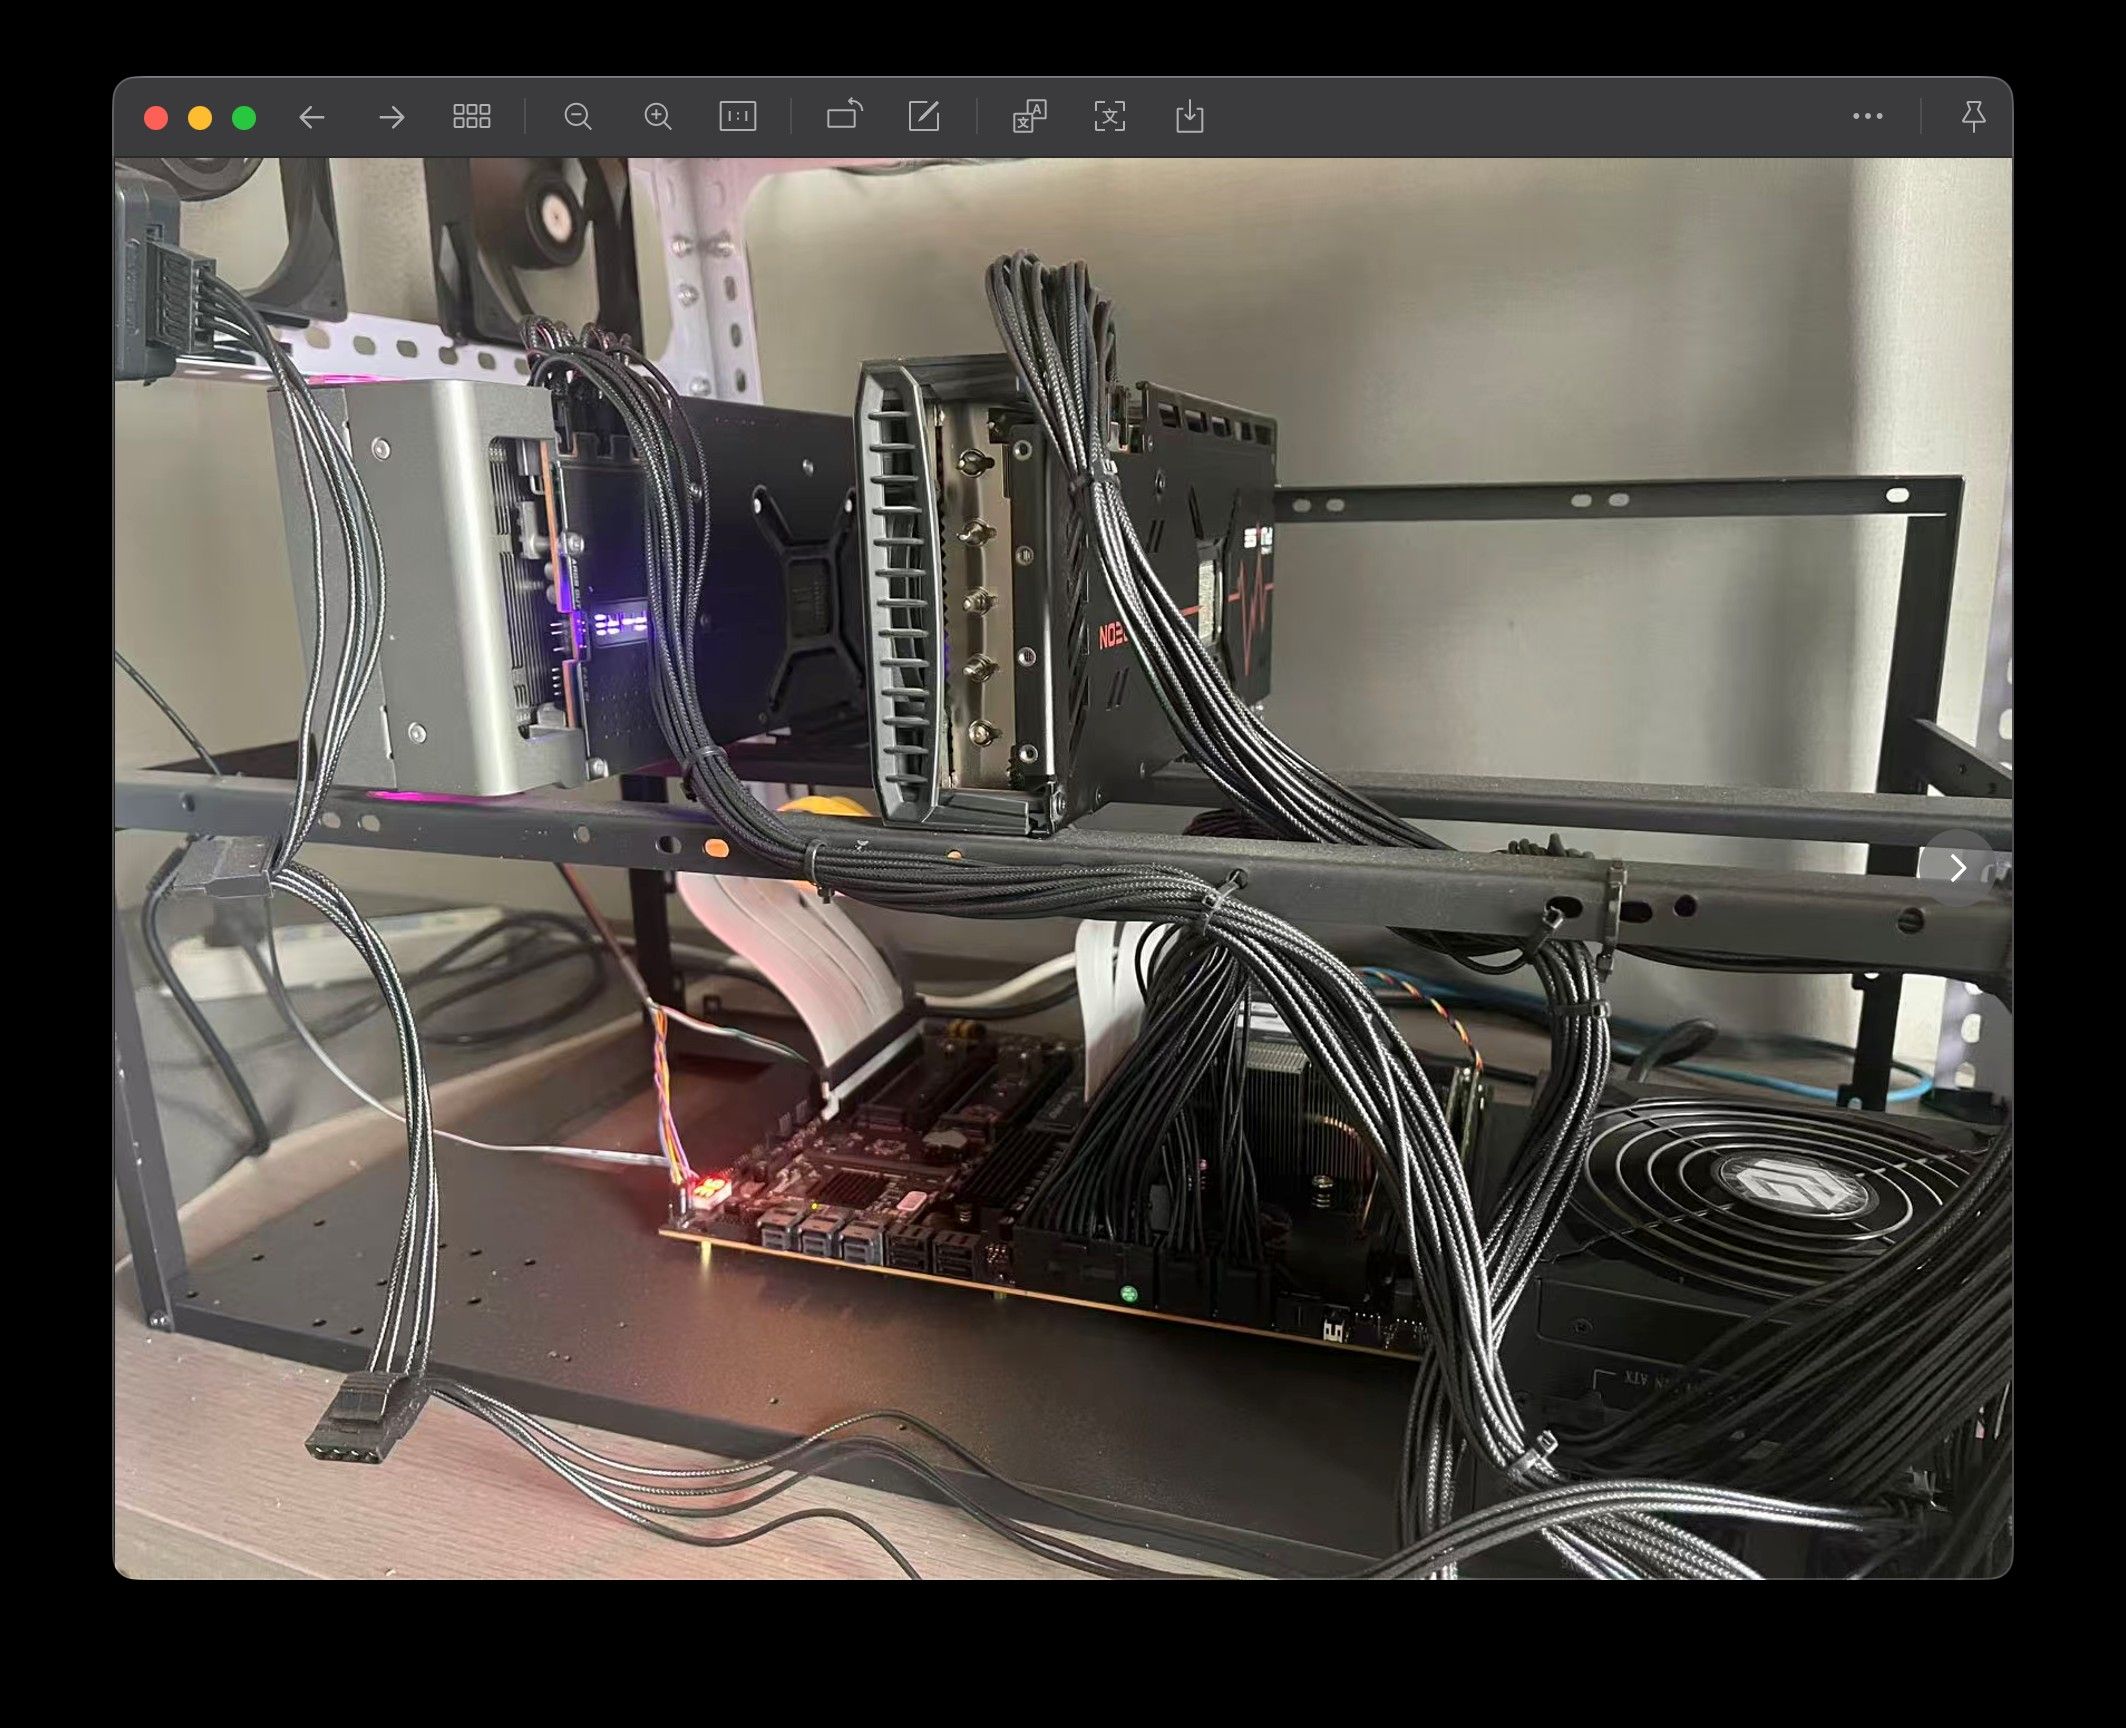
      我很好奇你的显卡电源线怎么这么少,我得7900xtx 每个要插3个8pin,6跟线一堆乱麻

      farmer nodeF 1 条回复 最后回复
      0
      • C
        C
        coin1860
        编写于 最后由 编辑
        #14

        楼主用的什么量化的模型iq3 s 还是xss , 我用iq3 s pp 1800 , tg 75 左右, 根本没有100 +

        farmer nodeF 1 条回复 最后回复
        0
        • J Z 0J J Z 0

          @farmer-node 我也升了, 速度没升也没降, 但SSD疯狂读盘, 只要agent干活, 就在读ssd。 好奇怪, 我看你的ssd几乎是不动的

          farmer nodeF
          farmer nodeF
          farmer node
          体面乡绅 硕果累累
          编写于 最后由 编辑
          #15

          @J-Z-0 https://lcz.me/topic/2317/33 , 这个是我设备的硬件,我想的是之前贴了,这里就不贴了,EYPC 的平台, 参数这里都有, 唯一改了的就是 这个参数 --ple-io mmap

          J Z 0J 1 条回复 最后回复
          1
          • C coin1860

            楼主用的什么量化的模型iq3 s 还是xss , 我用iq3 s pp 1800 , tg 75 左右, 根本没有100 +

            farmer nodeF
            farmer nodeF
            farmer node
            体面乡绅 硕果累累
            编写于 最后由 编辑
            #16

            @coin1860 https://lcz.me/topic/2317 这个帖子有详细参数信息,
            唯一改了的就是 这个参数 --ple-io mmap,模型用的Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-proj

            1 条回复 最后回复
            0
            • 9 909

              我很好奇你的显卡电源线怎么这么少,我得7900xtx 每个要插3个8pin,6跟线一堆乱麻

              farmer nodeF
              farmer nodeF
              farmer node
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #17

              @909 3个8 PIN 线就是你看到的,下面一个PCIE 延长线连起来就好了呀

              1 条回复 最后回复
              0
              • Hackner WeinlandH Hackner Weinland

                prefill有多少?

                farmer nodeF
                farmer nodeF
                farmer node
                体面乡绅 硕果累累
                编写于 最后由 编辑
                #18

                @Hackner-Weinland 最高2000左右,单卡

                1 条回复 最后回复
                1
                • farmer nodeF farmer node

                  @J-Z-0 https://lcz.me/topic/2317/33 , 这个是我设备的硬件,我想的是之前贴了,这里就不贴了,EYPC 的平台, 参数这里都有, 唯一改了的就是 这个参数 --ple-io mmap

                  J Z 0J
                  J Z 0J
                  J Z 0
                  体面乡绅
                  编写于 最后由 编辑
                  #19

                  @farmer-node 我在另一个帖子贴了我的问题, 44和43的某些行为肯定不一样, 但我不明白为什么。 打算换个nvme硬盘, 然后再试试

                  farmer nodeF 1 条回复 最后回复
                  0
                  • J Z 0J J Z 0

                    @farmer-node 我在另一个帖子贴了我的问题, 44和43的某些行为肯定不一样, 但我不明白为什么。 打算换个nvme硬盘, 然后再试试

                    farmer nodeF
                    farmer nodeF
                    farmer node
                    体面乡绅 硕果累累
                    编写于 最后由 编辑
                    #20

                    @J-Z-0 嗯,我在那边恢复你了,你 --ple-io ram 这个设置错了, 要设置 --ple-io mmap

                    J Z 0J 1 条回复 最后回复
                    0
                    • E exllm

                      估计是rocm10.1的功劳,我rocm10.0.0 strata 1.44.1 没到100t/s

                      farmer nodeF
                      farmer nodeF
                      farmer node
                      体面乡绅 硕果累累
                      编写于 最后由 编辑
                      #21

                      @exllm 峰值是100+ , 平时还是在80左右。

                      1 条回复 最后回复
                      0
                      • K kenshin

                        模型量化版本是什么?IQ3_S?

                        farmer nodeF
                        farmer nodeF
                        farmer node
                        体面乡绅 硕果累累
                        编写于 最后由 编辑
                        #22

                        @kenshin 对的, GSQ 的IQ3_S

                        1 条回复 最后回复
                        0
                        • farmer nodeF farmer node

                          @J-Z-0 嗯,我在那边恢复你了,你 --ple-io ram 这个设置错了, 要设置 --ple-io mmap

                          J Z 0J
                          J Z 0J
                          J Z 0
                          体面乡绅
                          编写于 最后由 编辑
                          #23

                          @farmer-node 一开始默认是mmap, 但ssd太慢了,吐字速度只有10几tks/s,所以把ngram塞进ram。不过不重要了,我买了个杂牌nvme,周末到了试试

                          farmer nodeF 1 条回复 最后回复
                          0
                          • J Z 0J J Z 0

                            @farmer-node 一开始默认是mmap, 但ssd太慢了,吐字速度只有10几tks/s,所以把ngram塞进ram。不过不重要了,我买了个杂牌nvme,周末到了试试

                            farmer nodeF
                            farmer nodeF
                            farmer node
                            体面乡绅 硕果累累
                            编写于 最后由 编辑
                            #24

                            @J-Z-0 你这个ssd ,怎么会速度这么低呢? 我这边ngram 冷专家 ,也就5M/s 到 1M/s 在波动,应该一般ssd 都能正常才对。

                            1 条回复 最后回复
                            0
                            • K
                              K
                              kenshin
                              体面乡绅
                              编写于 最后由 编辑
                              #25

                              我是让Hermes抄作业。调优出答案是tier自适应后提速了。但我的是pcie3,达不到楼主的100t/s。

                              改完并验证,保留这个配置(效果明显,不改回去)。
                              
                                 改动:--adapt-every 0 → --adapt-every 2,加 --adapt-async 1(原配置备份在
                                 strata-orca-iq3_xxs.json.bak-pre-adapt)
                              
                                     指标                 改前         改后
                                     解码显存命中率        35.8%       93.6-94.3%
                                     2K/1024 解码         41.0 tok/s  66.5-67.7 tok/s   (+63%)
                                     9.3K 提示词解码        42.2        58.0 冷 / 78.4 热
                                     端到端(含预填充)       37.0        66-67
                                     预填充 15K           1476.5      1632.9            (没受损,略快)
                                     常驻/显存余量         30.18 GiB / 902 MiB  不变
                              
                                 引擎自己确认自适应已生效:
                              
                                     adaptive swaps exchange them with the GPU cache (no file reads)
                                     adaptive tier asynchronous (--adapt-async 1): up to 96 swaps per round, a round every 2
                                 windows
                                     asynchronous adaptive tier: 430 rounds, 17745 experts swapped in, ~101 ms per round
                              
                                 每轮 ~100ms 跑在解码窗口之间,所以预填充没被拖累。热得很快 —— 重启后第一个请求就
                                 90.6%,不需要预热跑一堆。
                              
                                 还差的一段
                                 他要 100+,我们在 67。剩下的差距不在 ROCm、也不在这个开关了,主要是:他的 pack
                                 量化档(专家更小 → 24G 装得下更多,我们只有 8780/24576 = 35.7% 能进显存)、以及 host
                                 内存带宽/CPU。我们的 24G 卡在这套 IQ3_S 上,67 tok/s 已经接近这套配置的天花板。
                              
                                 一个可选小改进
                                 加 --expert-profile-save,把学到的路由频次存下来,以后重启直接从你的真实流量热启动(现在重启
                                 后会退回仓库自带那个不匹配的 profile,第一请求 60.6 而不是
                                 67)。要的话我加上,需要再重启一次。
                              
                                 顺带:这个坑和官方文档推荐的 7900 XTX 配置(写的是 --adapt-every 0)是冲突的 —— 已写进 strata
                                 skill,附带诊断方法(看 decode expert cache hit rate 是否≈显存槽位占比)。
                              
                              farmer nodeF 1 条回复 最后回复
                              2
                              • K kenshin

                                我是让Hermes抄作业。调优出答案是tier自适应后提速了。但我的是pcie3,达不到楼主的100t/s。

                                改完并验证,保留这个配置(效果明显,不改回去)。
                                
                                   改动:--adapt-every 0 → --adapt-every 2,加 --adapt-async 1(原配置备份在
                                   strata-orca-iq3_xxs.json.bak-pre-adapt)
                                
                                       指标                 改前         改后
                                       解码显存命中率        35.8%       93.6-94.3%
                                       2K/1024 解码         41.0 tok/s  66.5-67.7 tok/s   (+63%)
                                       9.3K 提示词解码        42.2        58.0 冷 / 78.4 热
                                       端到端(含预填充)       37.0        66-67
                                       预填充 15K           1476.5      1632.9            (没受损,略快)
                                       常驻/显存余量         30.18 GiB / 902 MiB  不变
                                
                                   引擎自己确认自适应已生效:
                                
                                       adaptive swaps exchange them with the GPU cache (no file reads)
                                       adaptive tier asynchronous (--adapt-async 1): up to 96 swaps per round, a round every 2
                                   windows
                                       asynchronous adaptive tier: 430 rounds, 17745 experts swapped in, ~101 ms per round
                                
                                   每轮 ~100ms 跑在解码窗口之间,所以预填充没被拖累。热得很快 —— 重启后第一个请求就
                                   90.6%,不需要预热跑一堆。
                                
                                   还差的一段
                                   他要 100+,我们在 67。剩下的差距不在 ROCm、也不在这个开关了,主要是:他的 pack
                                   量化档(专家更小 → 24G 装得下更多,我们只有 8780/24576 = 35.7% 能进显存)、以及 host
                                   内存带宽/CPU。我们的 24G 卡在这套 IQ3_S 上,67 tok/s 已经接近这套配置的天花板。
                                
                                   一个可选小改进
                                   加 --expert-profile-save,把学到的路由频次存下来,以后重启直接从你的真实流量热启动(现在重启
                                   后会退回仓库自带那个不匹配的 profile,第一请求 60.6 而不是
                                   67)。要的话我加上,需要再重启一次。
                                
                                   顺带:这个坑和官方文档推荐的 7900 XTX 配置(写的是 --adapt-every 0)是冲突的 —— 已写进 strata
                                   skill,附带诊断方法(看 decode expert cache hit rate 是否≈显存槽位占比)。
                                
                                farmer nodeF
                                farmer nodeF
                                farmer node
                                体面乡绅 硕果累累
                                编写于 最后由 编辑
                                #26

                                @kenshin 可以呀, 60-70 token/s 已经非常可用了,这个模型智商现在,做执行子agent 能完成的很好

                                K 1 条回复 最后回复
                                1
                                • farmer nodeF farmer node

                                  @kenshin 可以呀, 60-70 token/s 已经非常可用了,这个模型智商现在,做执行子agent 能完成的很好

                                  K
                                  K
                                  kenshin
                                  体面乡绅
                                  编写于 最后由 编辑
                                  #27

                                  @farmer-node对,停了27B,切换到IQ3_S了。暂时够用了。

                                  1 条回复 最后回复
                                  1

                                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                  有了你的建议,这篇帖子会更精彩哦 💗

                                  注册 登录
                                  回复
                                  • 在新帖中回复
                                  登录后回复
                                  • 从旧到新
                                  • 从新到旧
                                  • 最多赞同


                                  • 登录

                                  • 登录或注册以进行搜索。
                                  • 第一个帖子
                                    最后一个帖子
                                  0
                                  • 版块
                                  • 最新
                                  • 标签
                                  • 热门
                                  • 用户
                                  • 群组