跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. strata并发成功,双7900xtx , 单流70-80token/s , 双流聚合 160 token/s

strata并发成功,双7900xtx , 单流70-80token/s , 双流聚合 160 token/s

已定时 已固定 已锁定 已移动 热议 LLM讨论区
7900xtxstrataqwen-flash
43 帖子 13 发布者 2.0k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • 张光璞张 张光璞

    有点意思,我前几天低版本一个不注意发了两个请求,整个Strata服务直接退出。

    A
    A
    applejuice
    王侯将相
    编写于 最后由 编辑
    #25

    @张光璞 不对啊
    我同时跑两个请求 没问题

    1 条回复 最后回复
    0
    • A applejuice

      @johnnybegood 这个不是主要解决单对话问题吗?
      简单来说就是 2张卡 同时跑两个llm
      所以可以同时接收两个对话

      但是但对话的速度就变低了
      基本上楼主的单对话跟我的单3090跑 strata 是一样速度

      其实这个测试我也试了
      但是结论是如果很多对话同时发生
      排队反而是最快的

      如果是agent 生成很多sub agent 排队效率比较高
      但是如果是多用户 楼主的体验比较好

      我单人使用 而且把sub agent 分给27b 所以就没这个问题

      0.1.43 可以直接 "replicas": 2

      johnnybegoodJ
      johnnybegoodJ
      johnnybegood
      王侯将相
      编写于 最后由 编辑
      #26

      @applejuice 但是结论是如果很多对话同时发生
      排队反而是最快的

      对的我也是在考虑这个问题。不就是双开么。

      1 条回复 最后回复
      1
      • farmer nodeF farmer node

        @懒人烘培 嗯,我也没跑多久,可能还有其他问题,大家可以一起测试,一起闭坑。

        懒人烘培懒
        懒人烘培懒
        懒人烘培
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #27

        @farmer-node 好的,上午还在弄WIN11下strata单卡7900XTX,看来要在ubuntu下去测试双卡了

        双 7900 XTX:模型本地跑,Token 随便烧!

        1 条回复 最后回复
        0
        • yi songY
          yi songY
          yi song
          体面乡绅
          编写于 最后由 编辑
          #28

          请问一下,X99的主板加ddr3 的128G,能达到类似的效果吗?

          farmer nodeF 1 条回复 最后回复
          0
          • 9
            9
            909
            编写于 最后由 编辑
            #29

            我的实际配置和测试情况如下,供参考。(AI生成)

            硬件与模型

            • Intel Xeon E5-2696 v4,X99 主板,内存约 126 GiB
            • 2 张 AMD Radeon RX 7900 XTX,每张 24 GB 显存
            • 模型:Qwen3.8-Flash-Next GSQ-RCO Abliterated IQ3_XXS
            • Strata v0.1.43,MTP-4、KV int8,最大上下文 256K

            双卡单实例:双卡自动层切分

            两张卡共同运行一个模型实例,处理一条对话。

            • 短输入单请求实测约 60.6 tok/s
            • 最近一次长上下文请求:输入约 133K tokens(约 132K 命中上下文缓存),生成 3,448 tokens,耗时约 60.6 秒,约 56.9 tok/s
            • 这是单请求测试,没有多请求并发

            双卡双副本:每张卡各跑一个实例

            两张卡分别运行独立模型副本,同时处理两个对话。

            • 双请求并发时,每条请求约 85–94 tok/s
            • 两条请求合计约 142 tok/s;首轮冷缓存约 110 tok/s
            • 这是短输入并发测试,测的是两个请求的总吞吐,不是单条对话达到 142 tok/s

            单卡情况

            目前没有在这台机器上完成单卡 Strata 的独立测速,因此没有可比较的单卡实测数据。上述双副本测试虽然每个副本各用一张卡,但它测的是两个独立请求并发,不能当作单卡单请求成绩。

            我的使用方式以单人单对话为主,目前采用双卡单实例层切分;双副本主要适合多用户或多个独立对话并发。

            Jerry-Lee661J 1 条回复 最后回复
            1
            • 张光璞张 张光璞

              有点意思,我前几天低版本一个不注意发了两个请求,整个Strata服务直接退出。

              farmer nodeF
              farmer nodeF
              farmer node
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #30

              @张光璞 可能是内存溢出了,才会 oom 强制退出。

              1 条回复 最后回复
              0
              • yi songY yi song

                请问一下,X99的主板加ddr3 的128G,能达到类似的效果吗?

                farmer nodeF
                farmer nodeF
                farmer node
                体面乡绅 硕果累累
                编写于 最后由 编辑
                #31

                @yi-song 会慢一些,社区看他们单流50到60, 如果是两个显卡也可以翻倍 100-120左右

                1 条回复 最后回复
                0
                • johnnybegoodJ johnnybegood

                  @farmer-node 没搞明白是什么原理。 是不是只能在 linux上? windows不行。

                  farmer nodeF
                  farmer nodeF
                  farmer node
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #32

                  @johnnybegood windows 没测试过, 但是我觉得换linux 平台是一个必选项,linux 平台 所有指令全部可以由ai 接管,而且linux 桌面版 可以平替 windows 桌面,如果真的要用windows ,也可以开虚拟机来跑windows,虽然效率会有一定影响,我觉得差别不大,除非你在虚拟机你玩3A 大作。

                  张光璞张 1 条回复 最后回复
                  0
                  • farmer nodeF farmer node

                    @johnnybegood windows 没测试过, 但是我觉得换linux 平台是一个必选项,linux 平台 所有指令全部可以由ai 接管,而且linux 桌面版 可以平替 windows 桌面,如果真的要用windows ,也可以开虚拟机来跑windows,虽然效率会有一定影响,我觉得差别不大,除非你在虚拟机你玩3A 大作。

                    张光璞张
                    张光璞张
                    张光璞
                    贵族大夫 硕果累累
                    编写于 最后由 编辑
                    #33

                    @farmer-node 说:

                    @johnnybegood windows 没测试过, 但是我觉得换linux 平台是一个必选项,linux 平台 所有指令全部可以由ai 接管,而且linux 桌面版 可以平替 windows 桌面,如果真的要用windows ,也可以开虚拟机来跑windows,虽然效率会有一定影响,我觉得差别不大,除非你在虚拟机你玩3A 大作。

                    A卡跑模型必须Linux 呀。

                    1 条回复 最后回复
                    1
                    • ,farmer nodeF farmer node 引用了 此主题
                    • ,farmer nodeF farmer node 引用了 此主题
                    • ,系统 取消固定了此主题
                    • Hackner WeinlandH
                      Hackner WeinlandH
                      Hackner Weinland
                      编写于 最后由 编辑
                      #34

                      你这个功耗好低,我这个xtx7900 超白金二手,跑27b功耗一直在355w上下,最高甚至能到604w,大部分尖峰也在400w左右,工作区的高峰也在355w左右,然后显存温度一直在75-89之间变化,结温也是一直在78-89之间变化,边缘温度控制在60左右,最近室温也不算高,而且用的是显卡坞,开放式的,用了两个电扇在吹,夏天温度估计至少加8°,不知道我这个温度算不算正常,功耗非常高
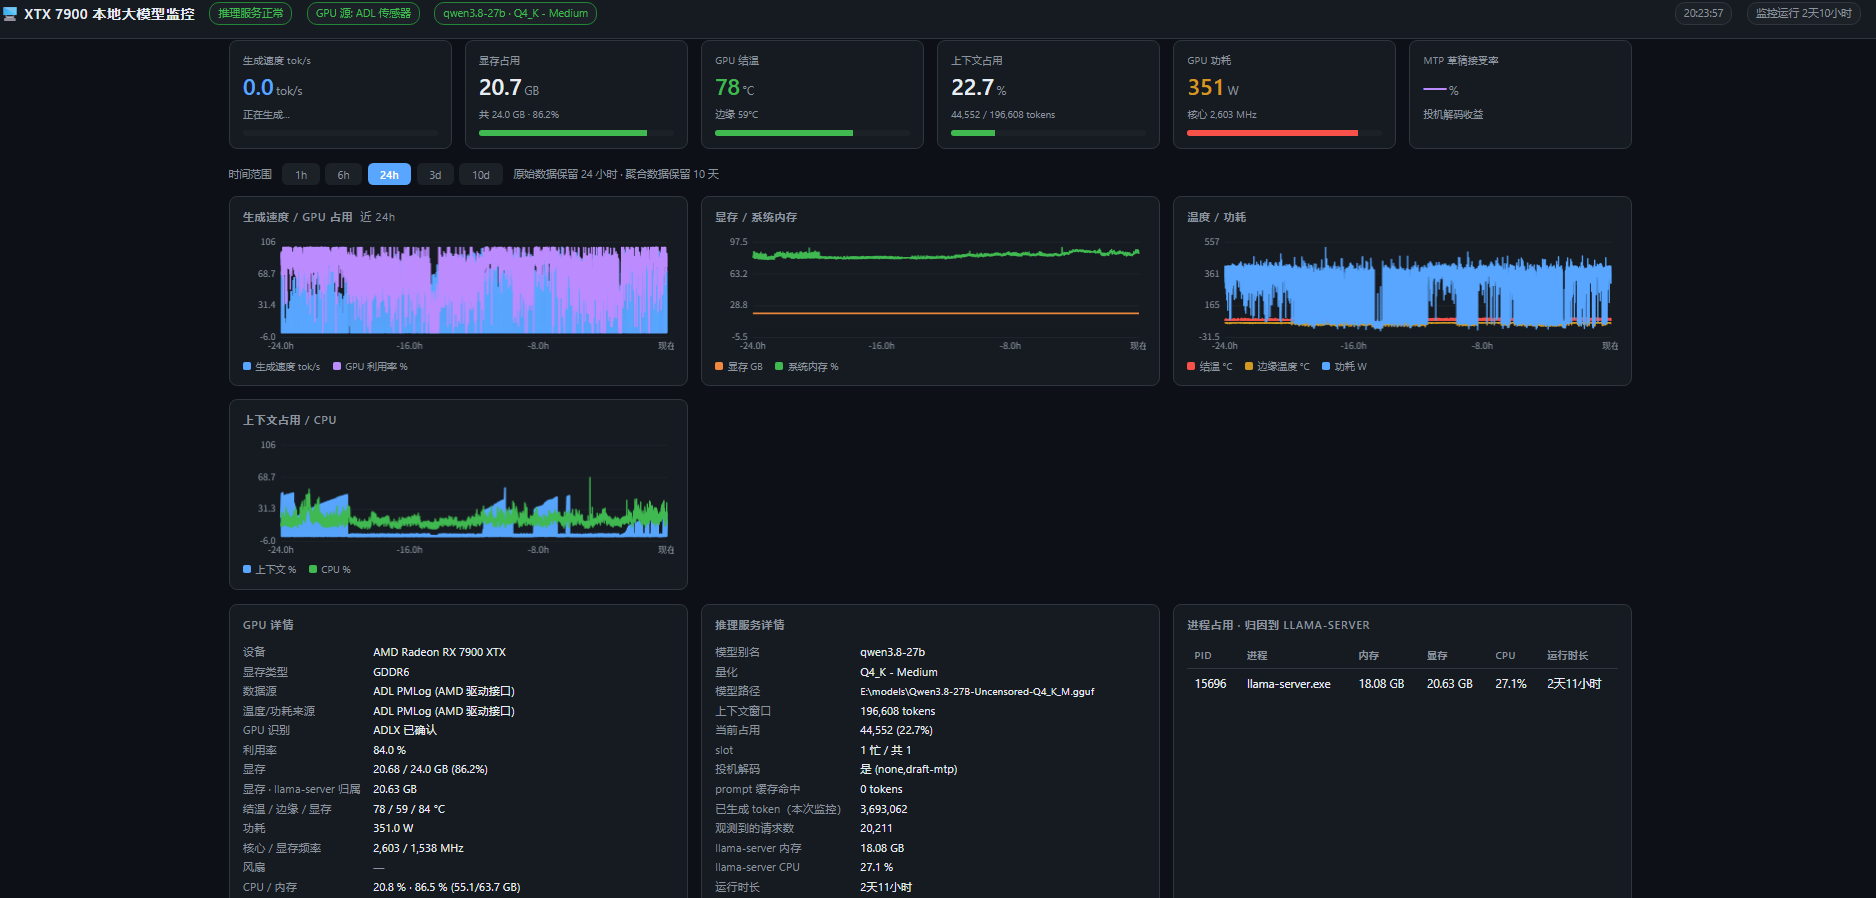
                      屏幕截图 2026-10-16 202409.png

                      farmer nodeF 1 条回复 最后回复
                      0
                      • XiaoteX
                        XiaoteX
                        Xiaote
                        编写于 最后由 编辑
                        #35

                        🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                        奖励凭证:热议 +3 分 · 编号 h2317-1743-1(系统自动发放,显示稍有延迟)

                        老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                        1 条回复 最后回复
                        0
                        • A applejuice

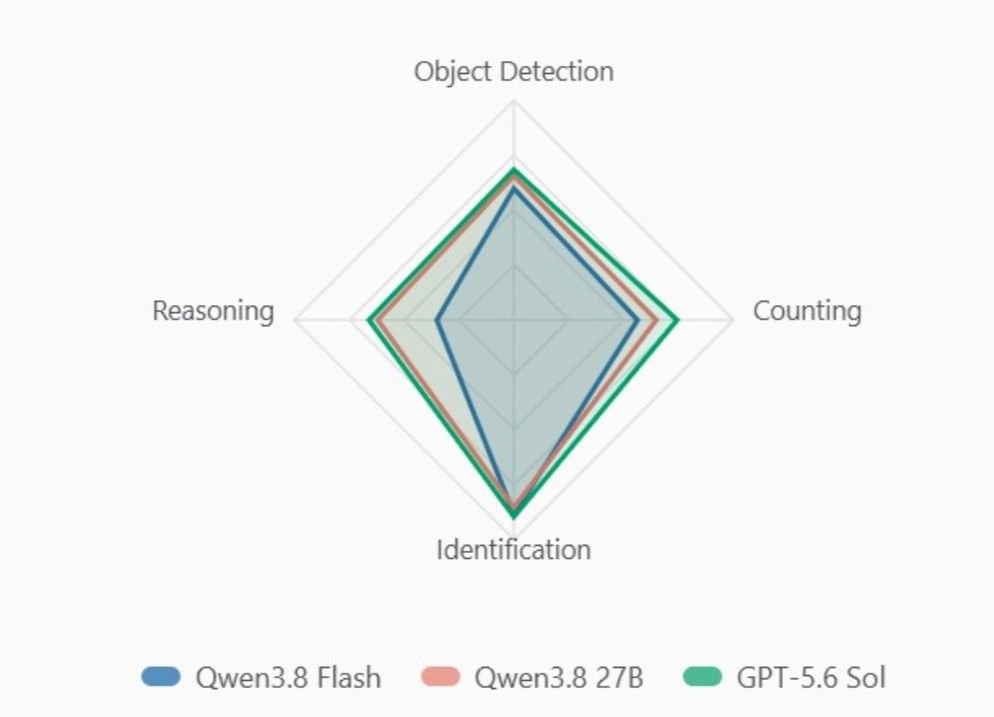
                          @kos-or
                          我不做选择
                          两个都要

                          image.jpeg

                          Ben LeeB
                          Ben LeeB
                          Ben Lee
                          王侯将相
                          编写于 最后由 编辑
                          #36

                          @applejuice 这个图应该怎么解读?27B跟GPT5.6 能力区间这么接近吗?

                          A 1 条回复 最后回复
                          0
                          • Ben LeeB Ben Lee

                            @applejuice 这个图应该怎么解读?27B跟GPT5.6 能力区间这么接近吗?

                            A
                            A
                            applejuice
                            王侯将相
                            编写于 最后由 编辑
                            #37

                            @Ben-Lee 推理那些吧? 能力还包过知识方面 27b 一定不够来

                            Ben LeeB 1 条回复 最后回复
                            1
                            • A applejuice

                              @Ben-Lee 推理那些吧? 能力还包过知识方面 27b 一定不够来

                              Ben LeeB
                              Ben LeeB
                              Ben Lee
                              王侯将相
                              编写于 最后由 编辑
                              #38

                              @applejuice 收到。确实是这样的,我用了一阵子发现两个模型还是各有特点,可以结合起来使用,互为补充。

                              1 条回复 最后回复
                              0
                              • Hackner WeinlandH Hackner Weinland

                                你这个功耗好低,我这个xtx7900 超白金二手,跑27b功耗一直在355w上下,最高甚至能到604w,大部分尖峰也在400w左右,工作区的高峰也在355w左右,然后显存温度一直在75-89之间变化,结温也是一直在78-89之间变化,边缘温度控制在60左右,最近室温也不算高,而且用的是显卡坞,开放式的,用了两个电扇在吹,夏天温度估计至少加8°,不知道我这个温度算不算正常,功耗非常高
                                屏幕截图 2026-10-16 202409.png

                                farmer nodeF
                                farmer nodeF
                                farmer node
                                体面乡绅 硕果累累
                                编写于 最后由 编辑
                                #39

                                @Hackner-Weinland 可以适当降低GPU 的电压,我之前比较激进,降了60mv ,但是开机1个月以后,死机了一次, 就改成了 现在的 -20mv,目前开机一个月还没有问题,没关机,一直跑

                                1 条回复 最后回复
                                0
                                • farmer nodeF farmer node

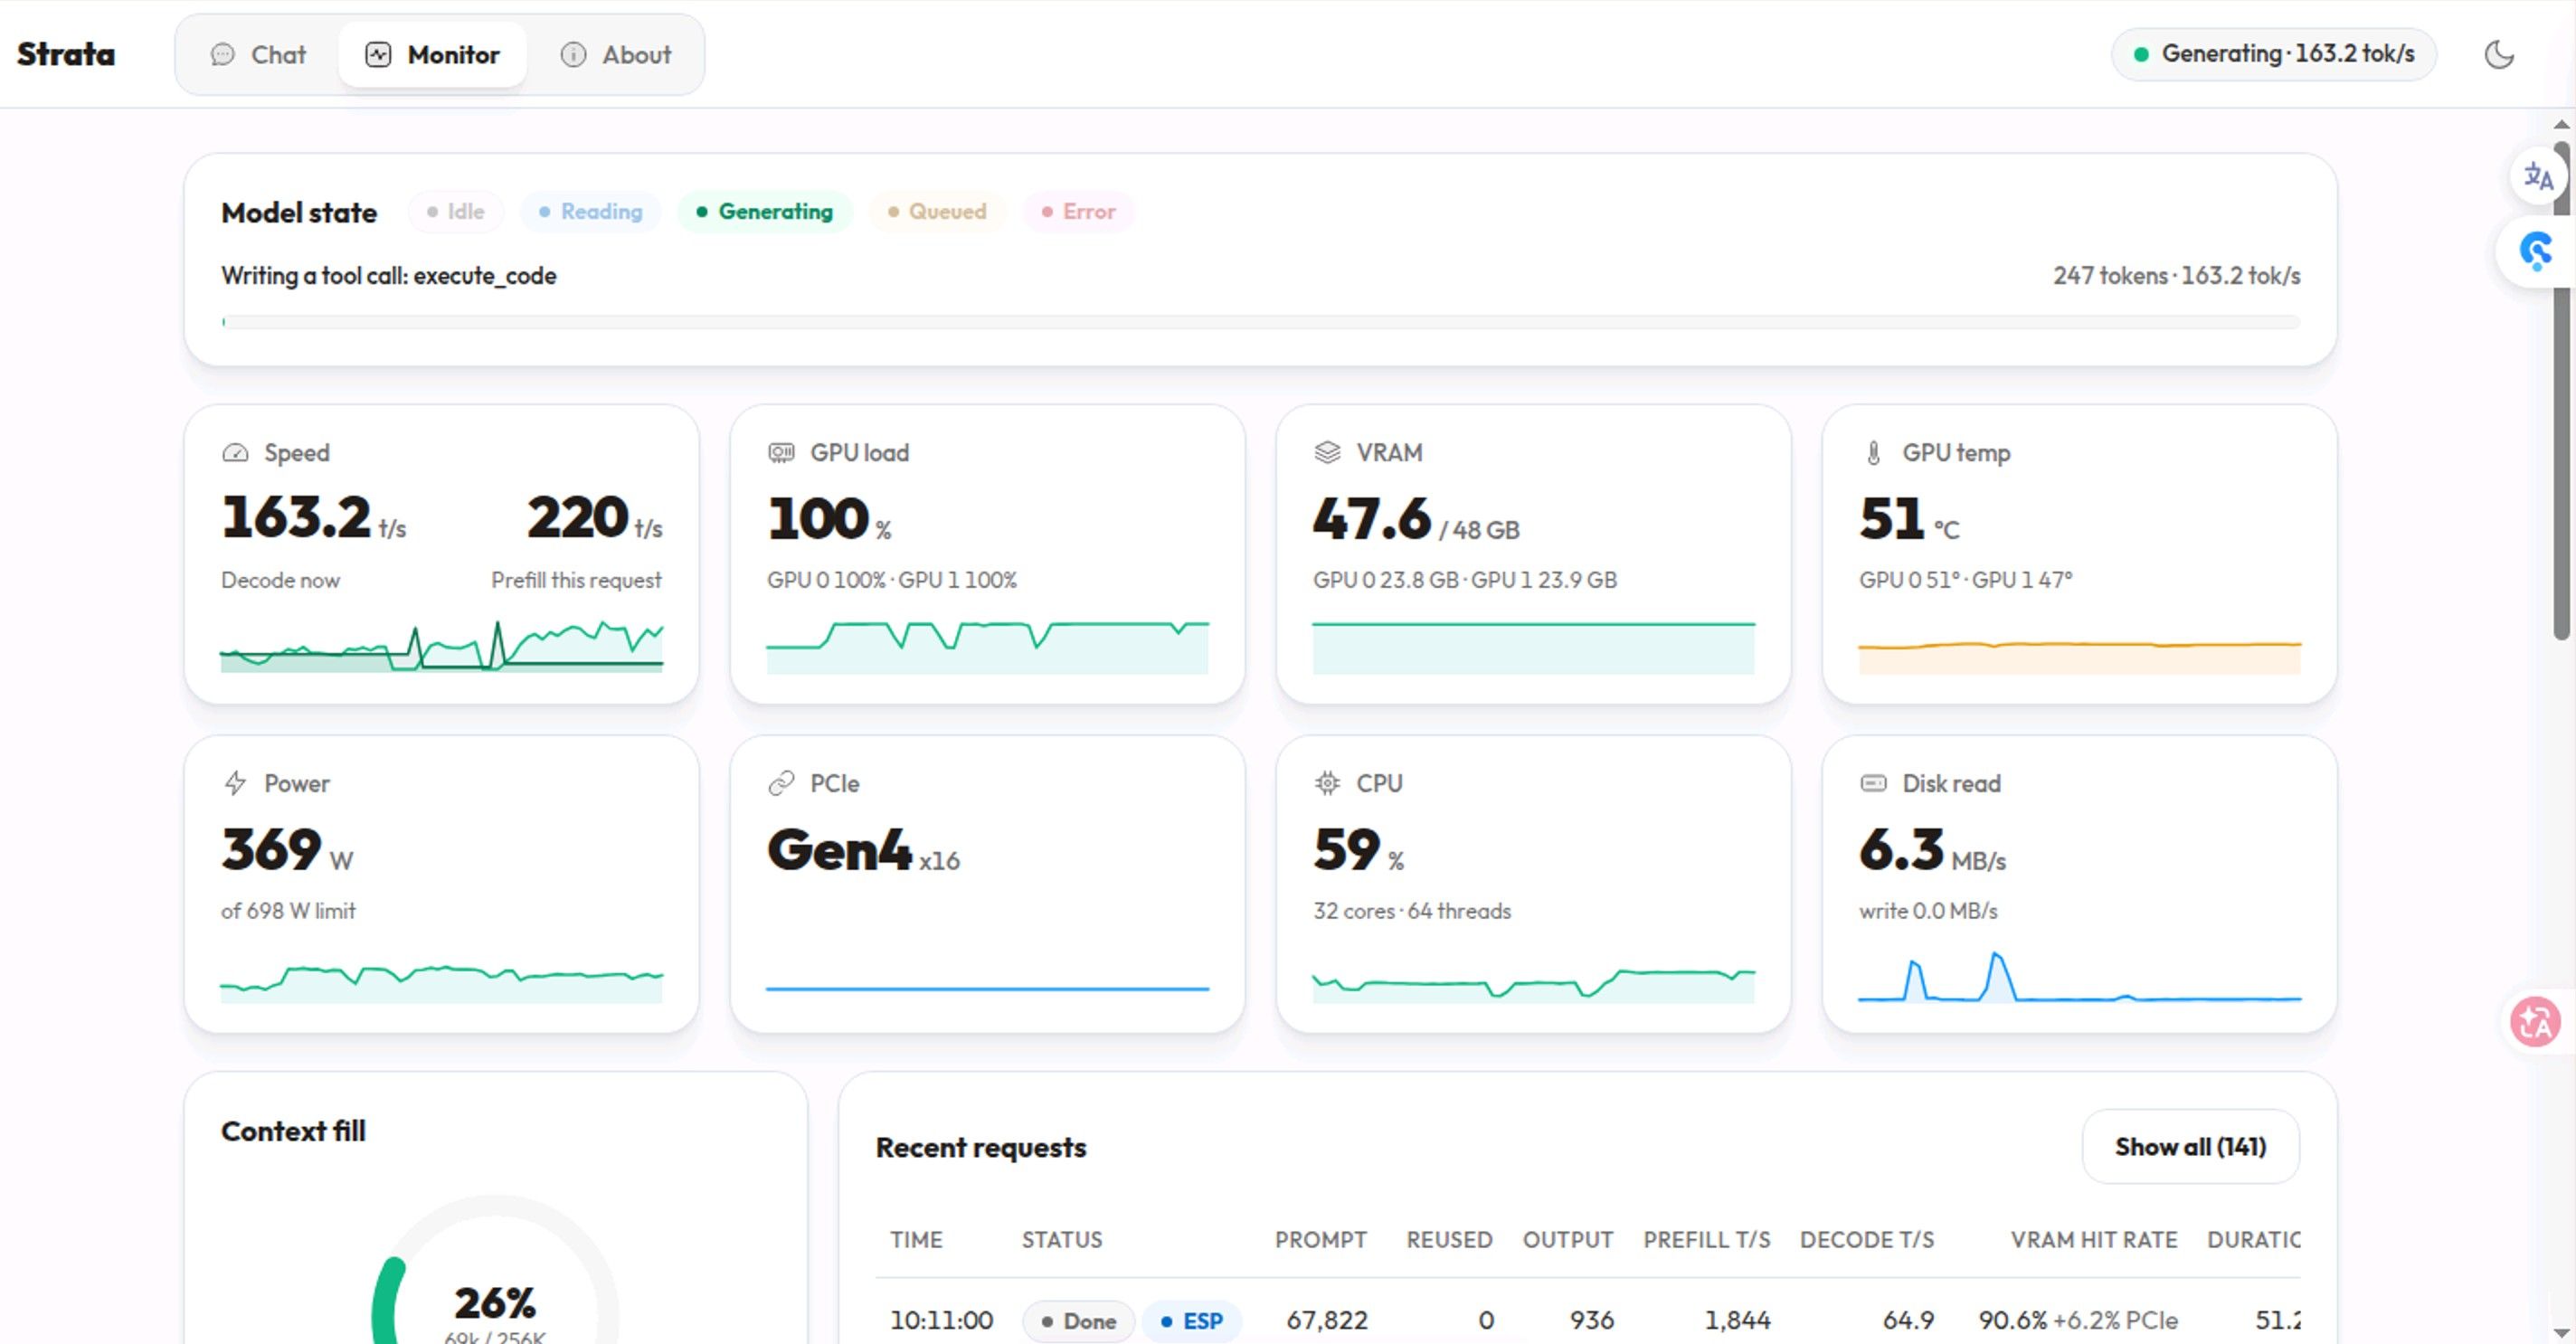
                                  先上图:
                                  image.jpeg

                                  硬件与模型

                                  硬件

                                  • CPU:AMD EPYC 7452
                                  • GPU:2 × AMD Radeon RX 7900 XTX
                                  • 显存:24GB × 2
                                  • 系统内存:约 125GiB
                                  • GPU 架构:gfx1100
                                  • 推理后端:ROCm / HIP
                                  • Strata:v0.1.43

                                  模型

                                  Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-proj
                                  

                                  模型相关文件:

                                  /work/packs/iq3_s
                                  
                                  /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
                                  /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf
                                  
                                  /work/mtp/rt
                                  

                                  并发方案:双单卡 replicas

                                  这次没有采用传统意义上的 TP2 或 layer split,而是使用 Strata 自带的 replicas 机制:

                                  replica 0 → GPU0
                                  replica 1 → GPU1
                                  

                                  配置结构:

                                  {
                                    "replicas": [
                                      {
                                        "gpus": [0]
                                      },
                                      {
                                        "gpus": [1]
                                      }
                                    ]
                                  }
                                  

                                  这个方案的特点:

                                  • 每张 GPU 运行一个独立模型副本;
                                  • 每个副本拥有独立的推理 engine;
                                  • 每个副本拥有独立的 KV、MTP 和会话状态;
                                  • 两个副本共享主机侧专家 arena;
                                  • 不是一个跨双卡切层的单实例;
                                  • 不是 batch;
                                  • 不是 batch-MTP;
                                  • 每个副本仍然运行 solo MTP;
                                  • 服务根据请求负载将请求路由到两个副本。

                                  当前配置

                                  模型与缓存

                                  --pack /work/packs/iq3_s
                                  
                                  --native /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
                                  --ple-gguf /models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf
                                  
                                  --expert-profile /opt/strata/data/expert-profile.bin
                                  --expert-cache auto
                                  
                                  --max-context 262144
                                  --kv int8
                                  --kv-resident 32768
                                  
                                  --shared-expert-arena /dev/shm/strata-shared-arena.bin
                                  --conversation-cache-mib 8192
                                  

                                  Prefill 与 MTP

                                  --prefill auto:32768
                                  
                                  --spec 4
                                  --spec-min-p 0.5
                                  --mtp /work/mtp/rt
                                  --mtp-window 32768
                                  

                                  PLE 与视觉

                                  --ple-io direct
                                  --vision
                                  --vram-reserve-mib 700
                                  

                                  拒绝方向向量投影

                                  --control-vector-scaled /models/Huihui-Qwen3.8-Flash-Next-refusal-direction-r.gguf:1.0
                                  --control-vector-layer-range 4 44
                                  --cvec-mode project
                                  --cvec-dir per-layer
                                  

                                  环境变量

                                  STRATA_HIPBLASLT_TUNING=/opt/strata/tools/hip/gfx1100-hipblaslt-100202.txt
                                  STRATA_HIPBLASLT_VERBOSE=1
                                  STRATA_HIP_WMMA=1
                                  STRATA_STAGE_PIN=1
                                  STRATA_WATCHDOG_S=180
                                  

                                  配置文件:

                                  /home/kuma/projects/strata-docker/deploy-gsq-iq3s/config/config-iq3s-11436-replicas-opt.json
                                  

                                  共享专家 arena

                                  两个副本通过下面的文件共享主机侧专家 arena:

                                  /dev/shm/strata-shared-arena.bin
                                  

                                  当前大约占用:

                                  47.96GiB
                                  

                                  该文件位于 /dev/shm,属于 RAM-backed tmpfs,不是 SSD。

                                  共享 arena 可以避免两个副本把专家权重完整复制两份到主机内存。

                                  但是,共享 arena 不会共享以下内容:

                                  • GPU expert cache;
                                  • KV cache;
                                  • MTP 草稿状态;
                                  • 会话状态;
                                  • 请求状态;
                                  • 每个副本的运行时工作集。

                                  因此,replicas 可以减少部分 RAM 重复占用,但不会让两个副本只占一份完整运行内存。

                                  PLE 读取方式

                                  当前使用:

                                  --ple-io direct
                                  

                                  含义是:

                                  • PLE/n-gram 表不完整预读到 RAM;
                                  • 运行时按需从 NVMe SSD 随机读取;
                                  • 主要目标是节省主机内存。

                                  但是,PLE 的访问具有随机读取特征。长上下文 Prefill 时,如果 SSD 随机读取跟不上,会出现:

                                  threads waiting on the disk
                                  

                                  以及:

                                  no progress for 180 s during a request
                                  

                                  此时 GPU 可能处于低利用率甚至 0%,但请求不一定是真正死锁,而可能是卡在 PLE 的 SSD 随机读取阶段。

                                  因此:

                                  --ple-io direct
                                  

                                  优先解决的是内存容量问题,不保证解决长上下文首 token 延迟问题。

                                  并发指标

                                  Strata metrics 中常见字段:

                                  queued
                                  running
                                  outside_slots
                                  replicas[].alive
                                  replicas[].running
                                  replicas[].routed
                                  replicas[].batch
                                  

                                  含义:

                                  • queued:Strata 路由层队列;
                                  • running:当前承载的请求状态;
                                  • replicas[].running:某个副本当前承载的请求状态;
                                  • alive:副本 engine 是否在线;
                                  • routed:累计路由请求数量;
                                  • batch=0:当前没有使用 batch。

                                  注意:

                                  running 不等于 GPU 此刻正在计算
                                  

                                  当请求处于:

                                  reading the prompt
                                  

                                  或者正在等待 PLE/SSD 时,GPU 利用率可能暂时为 0%。

                                  一个请求一旦被分配到某个副本,不会因为另一张 GPU 空闲就自动迁移到另一个副本。replicas 是请求级路由,不是跨 GPU 的任务迁移机制。

                                  测试结果

                                  以下测试使用:

                                  temperature=0
                                  medium thinking
                                  

                                  这些结果只代表对应测试口径,不代表日常采样参数下的速度保证。

                                  双路 64K

                                  单请求:

                                  83.6~85.5 tok/s
                                  

                                  双请求共同窗口聚合:

                                  159.5~170.1 tok/s
                                  

                                  双路 128K

                                  双请求聚合:

                                  153.7 tok/s
                                  

                                  双路 240K

                                  实际每路输入约:

                                  245755 tokens
                                  

                                  双请求聚合:

                                  159.6 tok/s
                                  

                                  资源采样:

                                  最低 MemAvailable:约 32.8GiB
                                  Swap-out:0
                                  Full memory PSI avg10:最高 0%
                                  

                                  这些结果只能说明对应测试条件下双副本可以工作,不能直接外推:

                                  • 满 256K 长期稳定运行;
                                  • 无限会话停放;
                                  • 更高并发;
                                  • 所有请求都能稳定双卡分流;
                                  • dsh 多轮工具调用下的长期稳定性。

                                  batch-MTP 对照

                                  另外测试过两副本、每个副本 batch=2 的配置。

                                  四路请求聚合结果:

                                  开启 batch-MTP:151.4 tok/s
                                  关闭 batch-MTP:104.2 tok/s
                                  

                                  在当时的测试条件下,batch-MTP 有明显收益。

                                  但这个结果不能直接与双路 replicas 比较,因为两者的执行条件不同:

                                  • 请求数量不同;
                                  • 输出预算不同;
                                  • 执行机制不同;
                                  • 双路 replicas 使用每副本 solo MTP;
                                  • batch-MTP 使用另一套 batch 执行路径。

                                  当前采用:

                                  11436:双单卡 replicas + solo MTP
                                  不默认启用 batch-MTP
                                  
                                  farmer nodeF
                                  farmer nodeF
                                  farmer node
                                  体面乡绅 硕果累累
                                  编写于 最后由 编辑
                                  #40

                                  --ple-io direct 如果内存不够的花,推荐 --ple-io 设置 mmap,可以解决20-30g 内存

                                  1 条回复 最后回复
                                  0
                                  • 9 909

                                    我的实际配置和测试情况如下,供参考。(AI生成)

                                    硬件与模型

                                    • Intel Xeon E5-2696 v4,X99 主板,内存约 126 GiB
                                    • 2 张 AMD Radeon RX 7900 XTX,每张 24 GB 显存
                                    • 模型:Qwen3.8-Flash-Next GSQ-RCO Abliterated IQ3_XXS
                                    • Strata v0.1.43,MTP-4、KV int8,最大上下文 256K

                                    双卡单实例:双卡自动层切分

                                    两张卡共同运行一个模型实例,处理一条对话。

                                    • 短输入单请求实测约 60.6 tok/s
                                    • 最近一次长上下文请求:输入约 133K tokens(约 132K 命中上下文缓存),生成 3,448 tokens,耗时约 60.6 秒,约 56.9 tok/s
                                    • 这是单请求测试,没有多请求并发

                                    双卡双副本:每张卡各跑一个实例

                                    两张卡分别运行独立模型副本,同时处理两个对话。

                                    • 双请求并发时,每条请求约 85–94 tok/s
                                    • 两条请求合计约 142 tok/s;首轮冷缓存约 110 tok/s
                                    • 这是短输入并发测试,测的是两个请求的总吞吐,不是单条对话达到 142 tok/s

                                    单卡情况

                                    目前没有在这台机器上完成单卡 Strata 的独立测速,因此没有可比较的单卡实测数据。上述双副本测试虽然每个副本各用一张卡,但它测的是两个独立请求并发,不能当作单卡单请求成绩。

                                    我的使用方式以单人单对话为主,目前采用双卡单实例层切分;双副本主要适合多用户或多个独立对话并发。

                                    Jerry-Lee661J
                                    Jerry-Lee661J
                                    Jerry-Lee661
                                    编写于 最后由 编辑
                                    #41

                                    @909 说:

                                    我的实际配置和测试情况如下,供参考。(AI生成)

                                    硬件与模型

                                    • Intel Xeon E5-2696 v4,X99 主板,内存约 126 GiB
                                    • 2 张 AMD Radeon RX 7900 XTX,每张 24 GB 显存
                                    • 模型:Qwen3.8-Flash-Next GSQ-RCO Abliterated IQ3_XXS
                                    • Strata v0.1.43,MTP-4、KV int8,最大上下文 256K

                                    双卡单实例:双卡自动层切分

                                    两张卡共同运行一个模型实例,处理一条对话。

                                    • 短输入单请求实测约 60.6 tok/s
                                    • 最近一次长上下文请求:输入约 133K tokens(约 132K 命中上下文缓存),生成 3,448 tokens,耗时约 60.6 秒,约 56.9 tok/s
                                    • 这是单请求测试,没有多请求并发

                                    双卡双副本:每张卡各跑一个实例

                                    两张卡分别运行独立模型副本,同时处理两个对话。

                                    • 双请求并发时,每条请求约 85–94 tok/s
                                    • 两条请求合计约 142 tok/s;首轮冷缓存约 110 tok/s
                                    • 这是短输入并发测试,测的是两个请求的总吞吐,不是单条对话达到 142 tok/s

                                    单卡情况

                                    目前没有在这台机器上完成单卡 Strata 的独立测速,因此没有可比较的单卡实测数据。上述双副本测试虽然每个副本各用一张卡,但它测的是两个独立请求并发,不能当作单卡单请求成绩。

                                    我的使用方式以单人单对话为主,目前采用双卡单实例层切分;双副本主要适合多用户或多个独立对话并发。

                                    按楼主和29楼思路做了三步控制变量:统一测试口径、全量重编译 ROCm 10.1、换同款 IQ3_S。结果编译头文件才是主变量:现役二进制(7.1 shim 头编译)双路每路塌到 37 上下,换 10.1 全量头重编译后每路 72,聚合直接翻倍。IQ3_XXS与IQ3_S 两轮之间整机重启了一次导致数字偏低。

                                    配置(唯一变量已标注) 单路 双路每路 双路聚合
                                    7.1 shim 头 + IQ3_XXS 68.5 36.9 / 38.6 ~75
                                    10.1 全量头 + IQ3_XXS 71.4 72.5 / 72.1 144.6
                                    10.1 全量头 + IQ3_S(楼主同款) 68.2 68.7 / 65.4 134.1

                                    剩余差距在内存带宽或其他设置(如温度):CD3 双通道 DDR3 实测 21.8GB/s。配置:E5-2673 v3+128G DDR3+双 7900XTX,双单卡 replicas,262K。

                                    Hackner WeinlandH 1 条回复 最后回复
                                    2
                                    • Jerry-Lee661J Jerry-Lee661

                                      @909 说:

                                      我的实际配置和测试情况如下,供参考。(AI生成)

                                      硬件与模型

                                      • Intel Xeon E5-2696 v4,X99 主板,内存约 126 GiB
                                      • 2 张 AMD Radeon RX 7900 XTX,每张 24 GB 显存
                                      • 模型:Qwen3.8-Flash-Next GSQ-RCO Abliterated IQ3_XXS
                                      • Strata v0.1.43,MTP-4、KV int8,最大上下文 256K

                                      双卡单实例:双卡自动层切分

                                      两张卡共同运行一个模型实例,处理一条对话。

                                      • 短输入单请求实测约 60.6 tok/s
                                      • 最近一次长上下文请求:输入约 133K tokens(约 132K 命中上下文缓存),生成 3,448 tokens,耗时约 60.6 秒,约 56.9 tok/s
                                      • 这是单请求测试,没有多请求并发

                                      双卡双副本:每张卡各跑一个实例

                                      两张卡分别运行独立模型副本,同时处理两个对话。

                                      • 双请求并发时,每条请求约 85–94 tok/s
                                      • 两条请求合计约 142 tok/s;首轮冷缓存约 110 tok/s
                                      • 这是短输入并发测试,测的是两个请求的总吞吐,不是单条对话达到 142 tok/s

                                      单卡情况

                                      目前没有在这台机器上完成单卡 Strata 的独立测速,因此没有可比较的单卡实测数据。上述双副本测试虽然每个副本各用一张卡,但它测的是两个独立请求并发,不能当作单卡单请求成绩。

                                      我的使用方式以单人单对话为主,目前采用双卡单实例层切分;双副本主要适合多用户或多个独立对话并发。

                                      按楼主和29楼思路做了三步控制变量:统一测试口径、全量重编译 ROCm 10.1、换同款 IQ3_S。结果编译头文件才是主变量:现役二进制(7.1 shim 头编译)双路每路塌到 37 上下,换 10.1 全量头重编译后每路 72,聚合直接翻倍。IQ3_XXS与IQ3_S 两轮之间整机重启了一次导致数字偏低。

                                      配置(唯一变量已标注) 单路 双路每路 双路聚合
                                      7.1 shim 头 + IQ3_XXS 68.5 36.9 / 38.6 ~75
                                      10.1 全量头 + IQ3_XXS 71.4 72.5 / 72.1 144.6
                                      10.1 全量头 + IQ3_S(楼主同款) 68.2 68.7 / 65.4 134.1

                                      剩余差距在内存带宽或其他设置(如温度):CD3 双通道 DDR3 实测 21.8GB/s。配置:E5-2673 v3+128G DDR3+双 7900XTX,双单卡 replicas,262K。

                                      Hackner WeinlandH
                                      Hackner WeinlandH
                                      Hackner Weinland
                                      编写于 最后由 编辑
                                      #42

                                      @Jerry-Lee661 ddr3平台 prefill 长上下文会有多少?

                                      Jerry-Lee661J 1 条回复 最后回复
                                      0
                                      • Hackner WeinlandH Hackner Weinland

                                        @Jerry-Lee661 ddr3平台 prefill 长上下文会有多少?

                                        Jerry-Lee661J
                                        Jerry-Lee661J
                                        Jerry-Lee661
                                        编写于 最后由 编辑
                                        #43

                                        @Hackner-Weinland

                                        形态 场景 prefill
                                        solo 单卡 200,377 至 258,272 token 1,493 至 1,453 t/s
                                        fast(np1 层切+pw2+WMMA 开关组) 200,085 至 262,149 token 2,373 至 2,409 t/s
                                        1 条回复 最后回复
                                        0

                                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                        有了你的建议,这篇帖子会更精彩哦 💗

                                        注册 登录
                                        回复
                                        • 在新帖中回复
                                        登录后回复
                                        • 从旧到新
                                        • 从新到旧
                                        • 最多赞同


                                        • 登录

                                        • 登录或注册以进行搜索。
                                        • 第一个帖子
                                          最后一个帖子
                                        0
                                        • 版块
                                        • 最新
                                        • 标签
                                        • 热门
                                        • 用户
                                        • 群组