跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 双 RTX 3090 上的三个 Strata 引擎实测:官方版 vs sergqwer 分支 vs eddoursul 分支(Qwen3.8-Flash-Next,UD-Q4_K_XL)

双 RTX 3090 上的三个 Strata 引擎实测:官方版 vs sergqwer 分支 vs eddoursul 分支(Qwen3.8-Flash-Next,UD-Q4_K_XL)

已定时 已固定 已锁定 已移动 LLM讨论区
rtx3090strataqwen-flash
8 帖子 4 发布者 499 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • A
    A
    applejuice
    王侯将相
    编写于 最后由 applejuice 编辑
    #1

    这 eddoursul 分支 暂时对我就是最完美状态
    感觉27b让本地llm开始可以用
    strata QFN 开始让llm 可以代替线上模型

    在同一台机器上连续测完,用同一套模型文件。只换引擎和各自推荐的参数,其他都一样。

    机器

    部件 配置
    CPU AMD EPYC 7452,32 核(Zen 2,AVX2)
    内存 256 GB DDR4-2666 ECC RDIMM,8 通道(约 139 GB/s)
    显卡 2 × NVIDIA RTX 3090 24 GB,每张限 250 W,各自 PCIe 4.0 x16,没有 NVLink
    系统 / 驱动 Ubuntu 24.04,内核 6.8,NVIDIA 610.57.04

    测试方法

    • Prefill: 冷启动,每次加不同前缀保证不命中缓存,max_tokens=1,测首 token 时间。
    • Decode: 4 个固定题(中文散文、中文日常对话、英文技术、写代码),取 3 次中位数。
    • 功能检查: 一次工具调用、一张图片(红/蓝颜色测试)、12 道简单题 ×2(默认强度)、16 道数学和代码题(强度 high)。全部单请求。
    • 长上下文(仅 eddoursul 512K): 一次约 300K token 的大海捞针,超过模型原生的 262K。

    结果

    Prefill(token/s)

    提示长度 官方版(512K) sergqwer(512K) eddoursul(200K) eddoursul(512K,YaRN ×2)
    19K 2,044 2,278 2,489 2,474
    43K 2,511 2,794 3,164 3,144
    89K 2,851 3,016 3,168 3,148
    123K 2,850 3,191 3,176 3,145
    约 300K(捞针用的提示) - - - 约 2,530(298,935 token,118 秒)

    Decode(token/s,中位数)

    题目 官方版 sergqwer eddoursul(200K) eddoursul(512K) eddoursul 512K 对比 sergqwer
    中文散文 95.7 93.9 84.1 84.8 −10%
    中文日常对话 90.2 92.0 83.3 85.9 −7%
    英文技术 95.8 93.7 107.0 108.7 +16%
    写代码 131.3 133.7 167.3 167.0 +25%

    功能检查与内存

    官方版 sergqwer eddoursul(200K) eddoursul(512K)
    工具调用 / 图片 通过 / 通过 通过 / 通过 通过 / 通过 通过 / 通过
    简单题(24) 24/24 24/24 24/24 24/24
    难题(16,强度 high) 16/16 16/16 16/16 16/16
    约 300K 捞针 - - - 找到
    Strata 占用内存 约 90 GiB 约 91 GiB 约 78 GiB 约 77 GiB
    启动时显存里的专家数 约 10,400(按层切分) 约 10,400(按层切分) 12,477(5,297 + 7,180) 12,472(5,292 + 7,180)
    1 条回复 最后回复
    1
    • terryT
      terryT
      terry
      易有太极
      编写于 最后由 编辑
      #2

      CPU内存主板等详细配置呢

      油管:https://www.youtube.com/@抡锤者

      A 1 条回复 最后回复
      0
      • terryT terry

        CPU内存主板等详细配置呢

        A
        A
        applejuice
        王侯将相
        编写于 最后由 编辑
        #3

        @terry 感觉太长 不重要所以拿掉了

        改回了

        terryT 1 条回复 最后回复
        0
        • A applejuice

          @terry 感觉太长 不重要所以拿掉了

          改回了

          terryT
          terryT
          terry
          易有太极
          编写于 最后由 terry 编辑
          #4

          @applejuice 你这数据一般人很难参考,内存配置很高,带宽拉满,然后双3090。根本不需要NVLink,没有什么瓶颈,各个指标拉满了,跑LLM顶配,跑ComfyUI也不差。

          油管:https://www.youtube.com/@抡锤者

          1 条回复 最后回复
          0
          • stxpnetS
            stxpnetS
            stxpnet
            王侯将相
            编写于 最后由 stxpnet 编辑
            #5

            image.jpeg
            官方最新版,配置和你差不多(MZ32-AR0 + 7B13 CPU 64核128线程,分48核给STARTA ),我让HERMES测过了8通道DDR4 2133(16条16G) 只有83G/S。
            双RTX 3090 华硕白猛 禽,无NVLINK,P2P破解驱动,P2P测试单向23G/S,双向34G/S,限制240瓦 ,1680MHZ. 这种小批量任务比较容易冲到峰值TOKEN。 轻度使用了半小时。15000个左右的专家在显卡
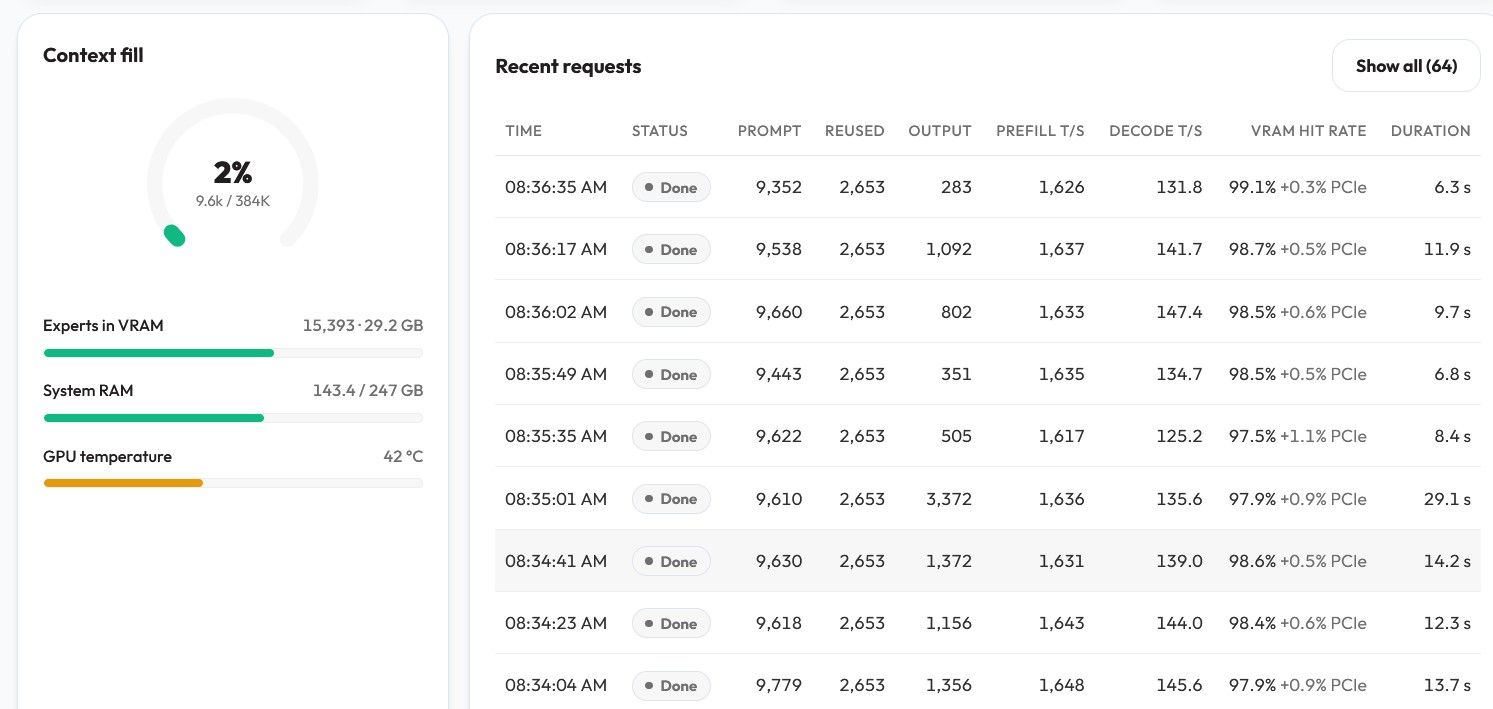
            image.jpeg

            分了80G内存做会话缓存,一般3-4轮满上下文对话就会占满。

            IQ 3S那个模型,两个393K上下文的槽子。 晚点有空了测一下夜间任务的实际表现(夜间爱惜显卡一点,空调 开24度对显卡进行重度编程任务调用 )

            双卡3090 PCIE 4.0 16X/16X

            白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
            夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
            1 条回复 最后回复
            0
            • stxpnetS
              stxpnetS
              stxpnet
              王侯将相
              编写于 最后由 编辑
              #6

              等大神弄出并行的吧,他在X上预告了,会给整并行,你看我发的图,每个显卡都 只出50%的,出到90%就 是另一片天地了。

              双卡3090 PCIE 4.0 16X/16X

              白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
              夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
              A Eric SuE 2 条回复 最后回复
              0
              • stxpnetS stxpnet

                等大神弄出并行的吧,他在X上预告了,会给整并行,你看我发的图,每个显卡都 只出50%的,出到90%就 是另一片天地了。

                A
                A
                applejuice
                王侯将相
                编写于 最后由 编辑
                #7

                @stxpnet 我跑的是 UD-Q4_K_XL
                想着如果prefill decode 可以接受就尽量用比较高精度的

                Prefill (tokens/s)

                Prompt 19K 43K 89K 123K
                Now 2,243 2,792 3,130 3,190

                Decode

                Prompt Chinese prose Chinese chat English technical Code
                Now 96.1 98.8 96.3 161.4
                1 条回复 最后回复
                0
                • stxpnetS stxpnet

                  等大神弄出并行的吧,他在X上预告了,会给整并行,你看我发的图,每个显卡都 只出50%的,出到90%就 是另一片天地了。

                  Eric SuE
                  Eric SuE
                  Eric Su
                  编写于 最后由 编辑
                  #8

                  @stxpnet 就是在等這個替換掉SGLang,看著各種火力展示,最重要的這需求等好久一直沒什麼進展...

                  1 条回复 最后回复
                  0

                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                  有了你的建议,这篇帖子会更精彩哦 💗

                  注册 登录
                  回复
                  • 在新帖中回复
                  登录后回复
                  • 从旧到新
                  • 从新到旧
                  • 最多赞同


                  • 登录

                  • 登录或注册以进行搜索。
                  • 第一个帖子
                    最后一个帖子
                  0
                  • 版块
                  • 最新
                  • 标签
                  • 热门
                  • 用户
                  • 群组