本地模型已經能取代雲端?我讓 Qwen3.8 flash next 和 GPT 玩同一款遊戲,終於知道 Benchmark 為什麼不能全信了
-
在筆者的Mac Studio 把本地模型架設好跑過各種測試後已經快樂的做起正事了,但除了工作以外還是想找點有趣的事情讓它做。
社群有很多測試模型能力的題目,例如版主常用的畫八卦或是通用的「鵜鶘騎腳踏車」、生成 SVG、做一些推理題或程式題。雖然作品確實能看出差別但沒有綜合能力複雜或是真實工作的差距可以比較。
在瀏覽了許多youtuber的影片後決定讓Agent來玩看看《Inscryption》,這款遊戲目前沒看到有人拿來執行過,也不是個需要即時快速反應的遊戲(卡牌遊戲)。
隨著觀察不同模型來玩遊戲的過程就會發現:為什麼這些模型的 Benchmark 看起來沒有差到非常誇張,實際讓它們自己做事情,體感卻差這麼多?
先放圖
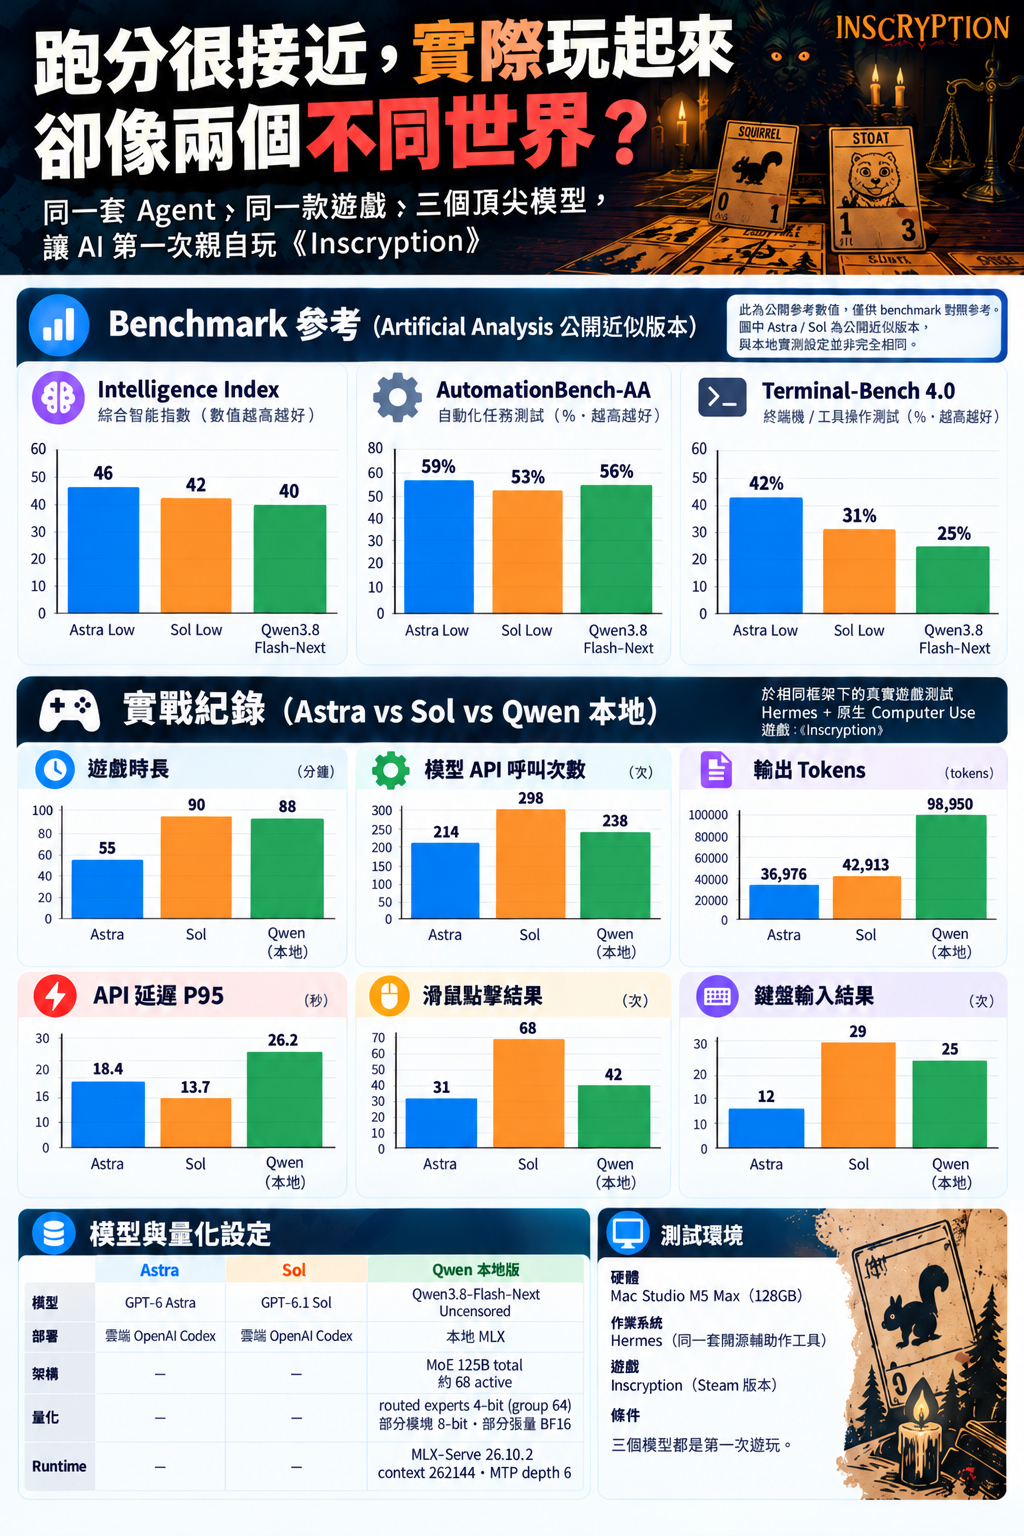
實驗怎麼進行
使用 Hermes Agent,透過原生 Computer Use 操作遊戲,讓模型自己看畫面、移動滑鼠、按鍵盤、探索規則。
使用 Astra、Qwen 3.8 flash next、Sol 6.1 三個模型接手游戲,每個模型都是第一次親自玩《Inscryption》。
玩起來到底差在哪?
最難以理解的,是 Qwen 在遊戲裡的表現。
它能看懂遊戲內機制、能完成實際操作,打贏過戰鬥。
但他會無視畫面的提醒,例如遊戲內出現一直閃爍的W鍵,就是希望玩家按 W 進行下一步。
人類看到這種提示就會去按W鍵,但 Qwen 卻可能在畫面裡反覆分析其他東西,就是不去按W,必須要筆者送出prompt要求他,他才願意做。
另一個問題是出牌。
《Inscryption》有獻祭機制,某些卡牌需要犧牲其他生物才能上場。Qwen 已經學過,也實際操作過,但後來又忘記了。
最慘的一次是它選了卡、嘗試獻祭、準備出牌,最後直接結束回合(WTF??)
結果當然是被電腦爆打一頓...我觀察了整個過程包含他鬼打牆似的內心戲,結果就這樣?再來是關卡可以選牌帶走,三張覆蓋的牌可以選一張拿走,正常來說我們會三張都看完後選擇,但他它只看了其中一張,就直接做出決定。我忍不住下prompt提醒,Qwen才意識到自己漏掉了重要資訊。
類似的狀況還有很多,滑鼠點偏了卻一直分析為什麼遊戲沒反應、忽略敵方的特殊能力、沒有查看完整盤面、已經學會的操作換個場景又得重新摸索。
它明明能做很複雜的推理跑分也很好看,卻常常漏掉遊戲裡很基本的事情。
換成雲端模型繼續測試
遊戲本身有不少需要探索的地方,還有視角切換、動畫、特殊事件等問題。Sol 甚至也花了不少時間研究怎麼查看遊戲資訊,我需要介入提醒但次數不多。不過Astra就蠻神奇的,過程中我完全沒有介入,他就能自己完成其他模型需要反覆試錯的項目,貴有貴的道理?
換模型確實能感受到不同模型的差異。Sol遇到陌生東西,會比較積極地尋找線索;Qwen會在同一個問題上反覆來回折磨自己(不能關掉思考,關掉之後無法完成任何一個關卡)。這些很難在Benchmark上看出差異。
目前只能確認本地 Qwen 需要生成大量內容,才能逐步推進任務。但多花時間思考,並不保證下一步就比較正確。
上面的實戰紀錄就是從 Hermes 的 Session 與 API Log 提取的。
當然,模型輸出的 Token 數量與思考品質沒有直接對應關係,不同模型的 Token 計量也可能有差異。這次的紀錄還不足以計算公平的模型勝率,只能先分享我實際觀察到的情況。
Benchmark 能代表模型能力嗎?
Artificial Analysis 上有 Intelligence Index、AutomationBench-AA、Terminal-Bench 等測試,有參考價值。
但真正讓 AI 長時間操作遊戲後,筆者覺得目前還有一些很重要的能力,不容易從常見跑分裡看出來。
例如:
- 進入陌生環境後,能多快搞懂基本操作?
- 遇到不認識的東西,會不會主動找線索?
- 明明已經有經驗了,能不能在下一個場景正確使用?
- 操作失敗後,多久能發現問題並修正?
- 沒有人告訴它下一步要做什麼時,能不能持續推進?
目前也還沒有一個很綜合的評分可以把一串不同類型的任務放在一起同時比較
當然,玩得好不代表寫程式、做研究或處理工程問題就一定強。只是對於「自主探索」這件事,遊戲似乎很適合拿來觀察。
想聽聽大家的看法
目前我最想知道的是,有沒有人遇過類似情況?
筆者使用本地模型來coding目前在短任務上沒有明顯差異,但未來真的讓它連續操作電腦,可能就像玩遊戲一樣出現大量重複思考、忘記操作方式、判斷失誤等問題。
這究竟是模型本身能力還不夠,還是 Harness架構沒有把模型的能力發揮出來?
這次玩遊戲的測試都是用同一個Harness環境,應該還算有可比性。如果有人測過本地 Qwen、DeepSeek、GLM 或其他模型長時間自主操作的表現,歡迎分享。
尤其想知道,有沒有人成功讓本地模型在沒有人工一直提醒的情況下,自己探索陌生環境,而且能越做越熟練?
喔,其實我有測試Gemini 4 Argon,我只能說他真的是跑分滿分實作零分,他連遊戲怎麼開始就花了一小時還沒進入遊戲,因此就不放上來了...
-
在筆者的Mac Studio 把本地模型架設好跑過各種測試後已經快樂的做起正事了,但除了工作以外還是想找點有趣的事情讓它做。
社群有很多測試模型能力的題目,例如版主常用的畫八卦或是通用的「鵜鶘騎腳踏車」、生成 SVG、做一些推理題或程式題。雖然作品確實能看出差別但沒有綜合能力複雜或是真實工作的差距可以比較。
在瀏覽了許多youtuber的影片後決定讓Agent來玩看看《Inscryption》,這款遊戲目前沒看到有人拿來執行過,也不是個需要即時快速反應的遊戲(卡牌遊戲)。
隨著觀察不同模型來玩遊戲的過程就會發現:為什麼這些模型的 Benchmark 看起來沒有差到非常誇張,實際讓它們自己做事情,體感卻差這麼多?
先放圖
實驗怎麼進行
使用 Hermes Agent,透過原生 Computer Use 操作遊戲,讓模型自己看畫面、移動滑鼠、按鍵盤、探索規則。
使用 Astra、Qwen 3.8 flash next、Sol 6.1 三個模型接手游戲,每個模型都是第一次親自玩《Inscryption》。
玩起來到底差在哪?
最難以理解的,是 Qwen 在遊戲裡的表現。
它能看懂遊戲內機制、能完成實際操作,打贏過戰鬥。
但他會無視畫面的提醒,例如遊戲內出現一直閃爍的W鍵,就是希望玩家按 W 進行下一步。
人類看到這種提示就會去按W鍵,但 Qwen 卻可能在畫面裡反覆分析其他東西,就是不去按W,必須要筆者送出prompt要求他,他才願意做。
另一個問題是出牌。
《Inscryption》有獻祭機制,某些卡牌需要犧牲其他生物才能上場。Qwen 已經學過,也實際操作過,但後來又忘記了。
最慘的一次是它選了卡、嘗試獻祭、準備出牌,最後直接結束回合(WTF??)
結果當然是被電腦爆打一頓...我觀察了整個過程包含他鬼打牆似的內心戲,結果就這樣?再來是關卡可以選牌帶走,三張覆蓋的牌可以選一張拿走,正常來說我們會三張都看完後選擇,但他它只看了其中一張,就直接做出決定。我忍不住下prompt提醒,Qwen才意識到自己漏掉了重要資訊。
類似的狀況還有很多,滑鼠點偏了卻一直分析為什麼遊戲沒反應、忽略敵方的特殊能力、沒有查看完整盤面、已經學會的操作換個場景又得重新摸索。
它明明能做很複雜的推理跑分也很好看,卻常常漏掉遊戲裡很基本的事情。
換成雲端模型繼續測試
遊戲本身有不少需要探索的地方,還有視角切換、動畫、特殊事件等問題。Sol 甚至也花了不少時間研究怎麼查看遊戲資訊,我需要介入提醒但次數不多。不過Astra就蠻神奇的,過程中我完全沒有介入,他就能自己完成其他模型需要反覆試錯的項目,貴有貴的道理?
換模型確實能感受到不同模型的差異。Sol遇到陌生東西,會比較積極地尋找線索;Qwen會在同一個問題上反覆來回折磨自己(不能關掉思考,關掉之後無法完成任何一個關卡)。這些很難在Benchmark上看出差異。
目前只能確認本地 Qwen 需要生成大量內容,才能逐步推進任務。但多花時間思考,並不保證下一步就比較正確。
上面的實戰紀錄就是從 Hermes 的 Session 與 API Log 提取的。
當然,模型輸出的 Token 數量與思考品質沒有直接對應關係,不同模型的 Token 計量也可能有差異。這次的紀錄還不足以計算公平的模型勝率,只能先分享我實際觀察到的情況。
Benchmark 能代表模型能力嗎?
Artificial Analysis 上有 Intelligence Index、AutomationBench-AA、Terminal-Bench 等測試,有參考價值。
但真正讓 AI 長時間操作遊戲後,筆者覺得目前還有一些很重要的能力,不容易從常見跑分裡看出來。
例如:
- 進入陌生環境後,能多快搞懂基本操作?
- 遇到不認識的東西,會不會主動找線索?
- 明明已經有經驗了,能不能在下一個場景正確使用?
- 操作失敗後,多久能發現問題並修正?
- 沒有人告訴它下一步要做什麼時,能不能持續推進?
目前也還沒有一個很綜合的評分可以把一串不同類型的任務放在一起同時比較
當然,玩得好不代表寫程式、做研究或處理工程問題就一定強。只是對於「自主探索」這件事,遊戲似乎很適合拿來觀察。
想聽聽大家的看法
目前我最想知道的是,有沒有人遇過類似情況?
筆者使用本地模型來coding目前在短任務上沒有明顯差異,但未來真的讓它連續操作電腦,可能就像玩遊戲一樣出現大量重複思考、忘記操作方式、判斷失誤等問題。
這究竟是模型本身能力還不夠,還是 Harness架構沒有把模型的能力發揮出來?
這次玩遊戲的測試都是用同一個Harness環境,應該還算有可比性。如果有人測過本地 Qwen、DeepSeek、GLM 或其他模型長時間自主操作的表現,歡迎分享。
尤其想知道,有沒有人成功讓本地模型在沒有人工一直提醒的情況下,自己探索陌生環境,而且能越做越熟練?
喔,其實我有測試Gemini 4 Argon,我只能說他真的是跑分滿分實作零分,他連遊戲怎麼開始就花了一小時還沒進入遊戲,因此就不放上來了...
-
尤其想知道,有沒有人成功讓本地模型在沒有人工一直提醒的情況下,自己探索陌生環境,而且能越做越熟練?
这就是人工智能追求的目标,别说本地模型了,云端大模型都还做不到。
-
-
-
-
自己探索陌生環境,而且能越做越熟練?
ARC AGI 的測試題目好像就是這種類型, GPT Astra拿到非常高的分數
理論上是做得到的,但要非常強大的硬體設備和多個Agents當後援在周遭配合,頂尖實驗室應該就有這樣的配置 -
这需要你的耐心,8岁小孩的智力你能接受的话,你要等八年。 那为什么希望ai能在8分钟就那么聪明呢
我懂您的意思
但有個智商很高的教授(Gemini 4)連進入遊戲都有問題,讓我非常困惑
Qwen 3.8 flash next關閉思考後,他會拿著手牌操作一個小時都無法正確地把牌丟出去,可能等不到他真的打完一小關了吧
-
-
-
-
等我们得空,大家一起用agent连线,打counter strike,我们放置电脑直播,看看ai怎样操作
-
@imbiplaza-ASUS 我打cs还得过wcg的奖项哦,嘿嘿
-
我打cs 还可以追到年轻美眉呢
@imbiplaza-ASUS 我输了

-
這是新領域 你這樣的測試很好
不然其實大部分的模型在過去的領域都已經是拿著答案在做題目了
真的碰到陌生任務誰幹活代價低 誰就能勝出不知道Harness對模型能力的影響有多少?
例如改用Codex或是Deepseek Harness來執行,結果會變好還是變差?!
光想就很有趣
但去測花的時間比單純跑幾張SVG還有解數學題還要麻煩
遊戲無法背景執行,因此畫面就要給LLM霸佔了
-
不知道Harness對模型能力的影響有多少?
例如改用Codex或是Deepseek Harness來執行,結果會變好還是變差?!
光想就很有趣
但去測花的時間比單純跑幾張SVG還有解數學題還要麻煩
遊戲無法背景執行,因此畫面就要給LLM霸佔了
@fanweng-code agent影響任務下限 而模型影響的是上限
智商的地板被harness影響
智商的天花板是LLM模型決定 -
不知道Harness對模型能力的影響有多少?
例如改用Codex或是Deepseek Harness來執行,結果會變好還是變差?!
光想就很有趣
但去測花的時間比單純跑幾張SVG還有解數學題還要麻煩
遊戲無法背景執行,因此畫面就要給LLM霸佔了
-
例如改用Codex或是Deepseek Harness來執行,結果會變好還是變差?!
看任務類型
需要創意的話 不要限制LLM太多 給LLM自由發揮的空間
需要穩定的話 不誤刪除檔案 就要有嚴格的邊界限制 (設下各種規定 這不能做 那不能做)我的Hermes 就被設限了許多邊界,所以跑起來一開始會比較吃力(system prompt大)
我比較喜歡Codex循規蹈矩的辦事風格 所以Hermes 是由Codex設定的Codex講求穩定, DSH比較像快刀手, 感覺效率比較高
-
-
好喔 我再學學來硬的
plug in