【實測】4× RTX PRO 6000:DeepSeek V4.1 Flash 原版 vs 1017,單人生成提升約 51%
-
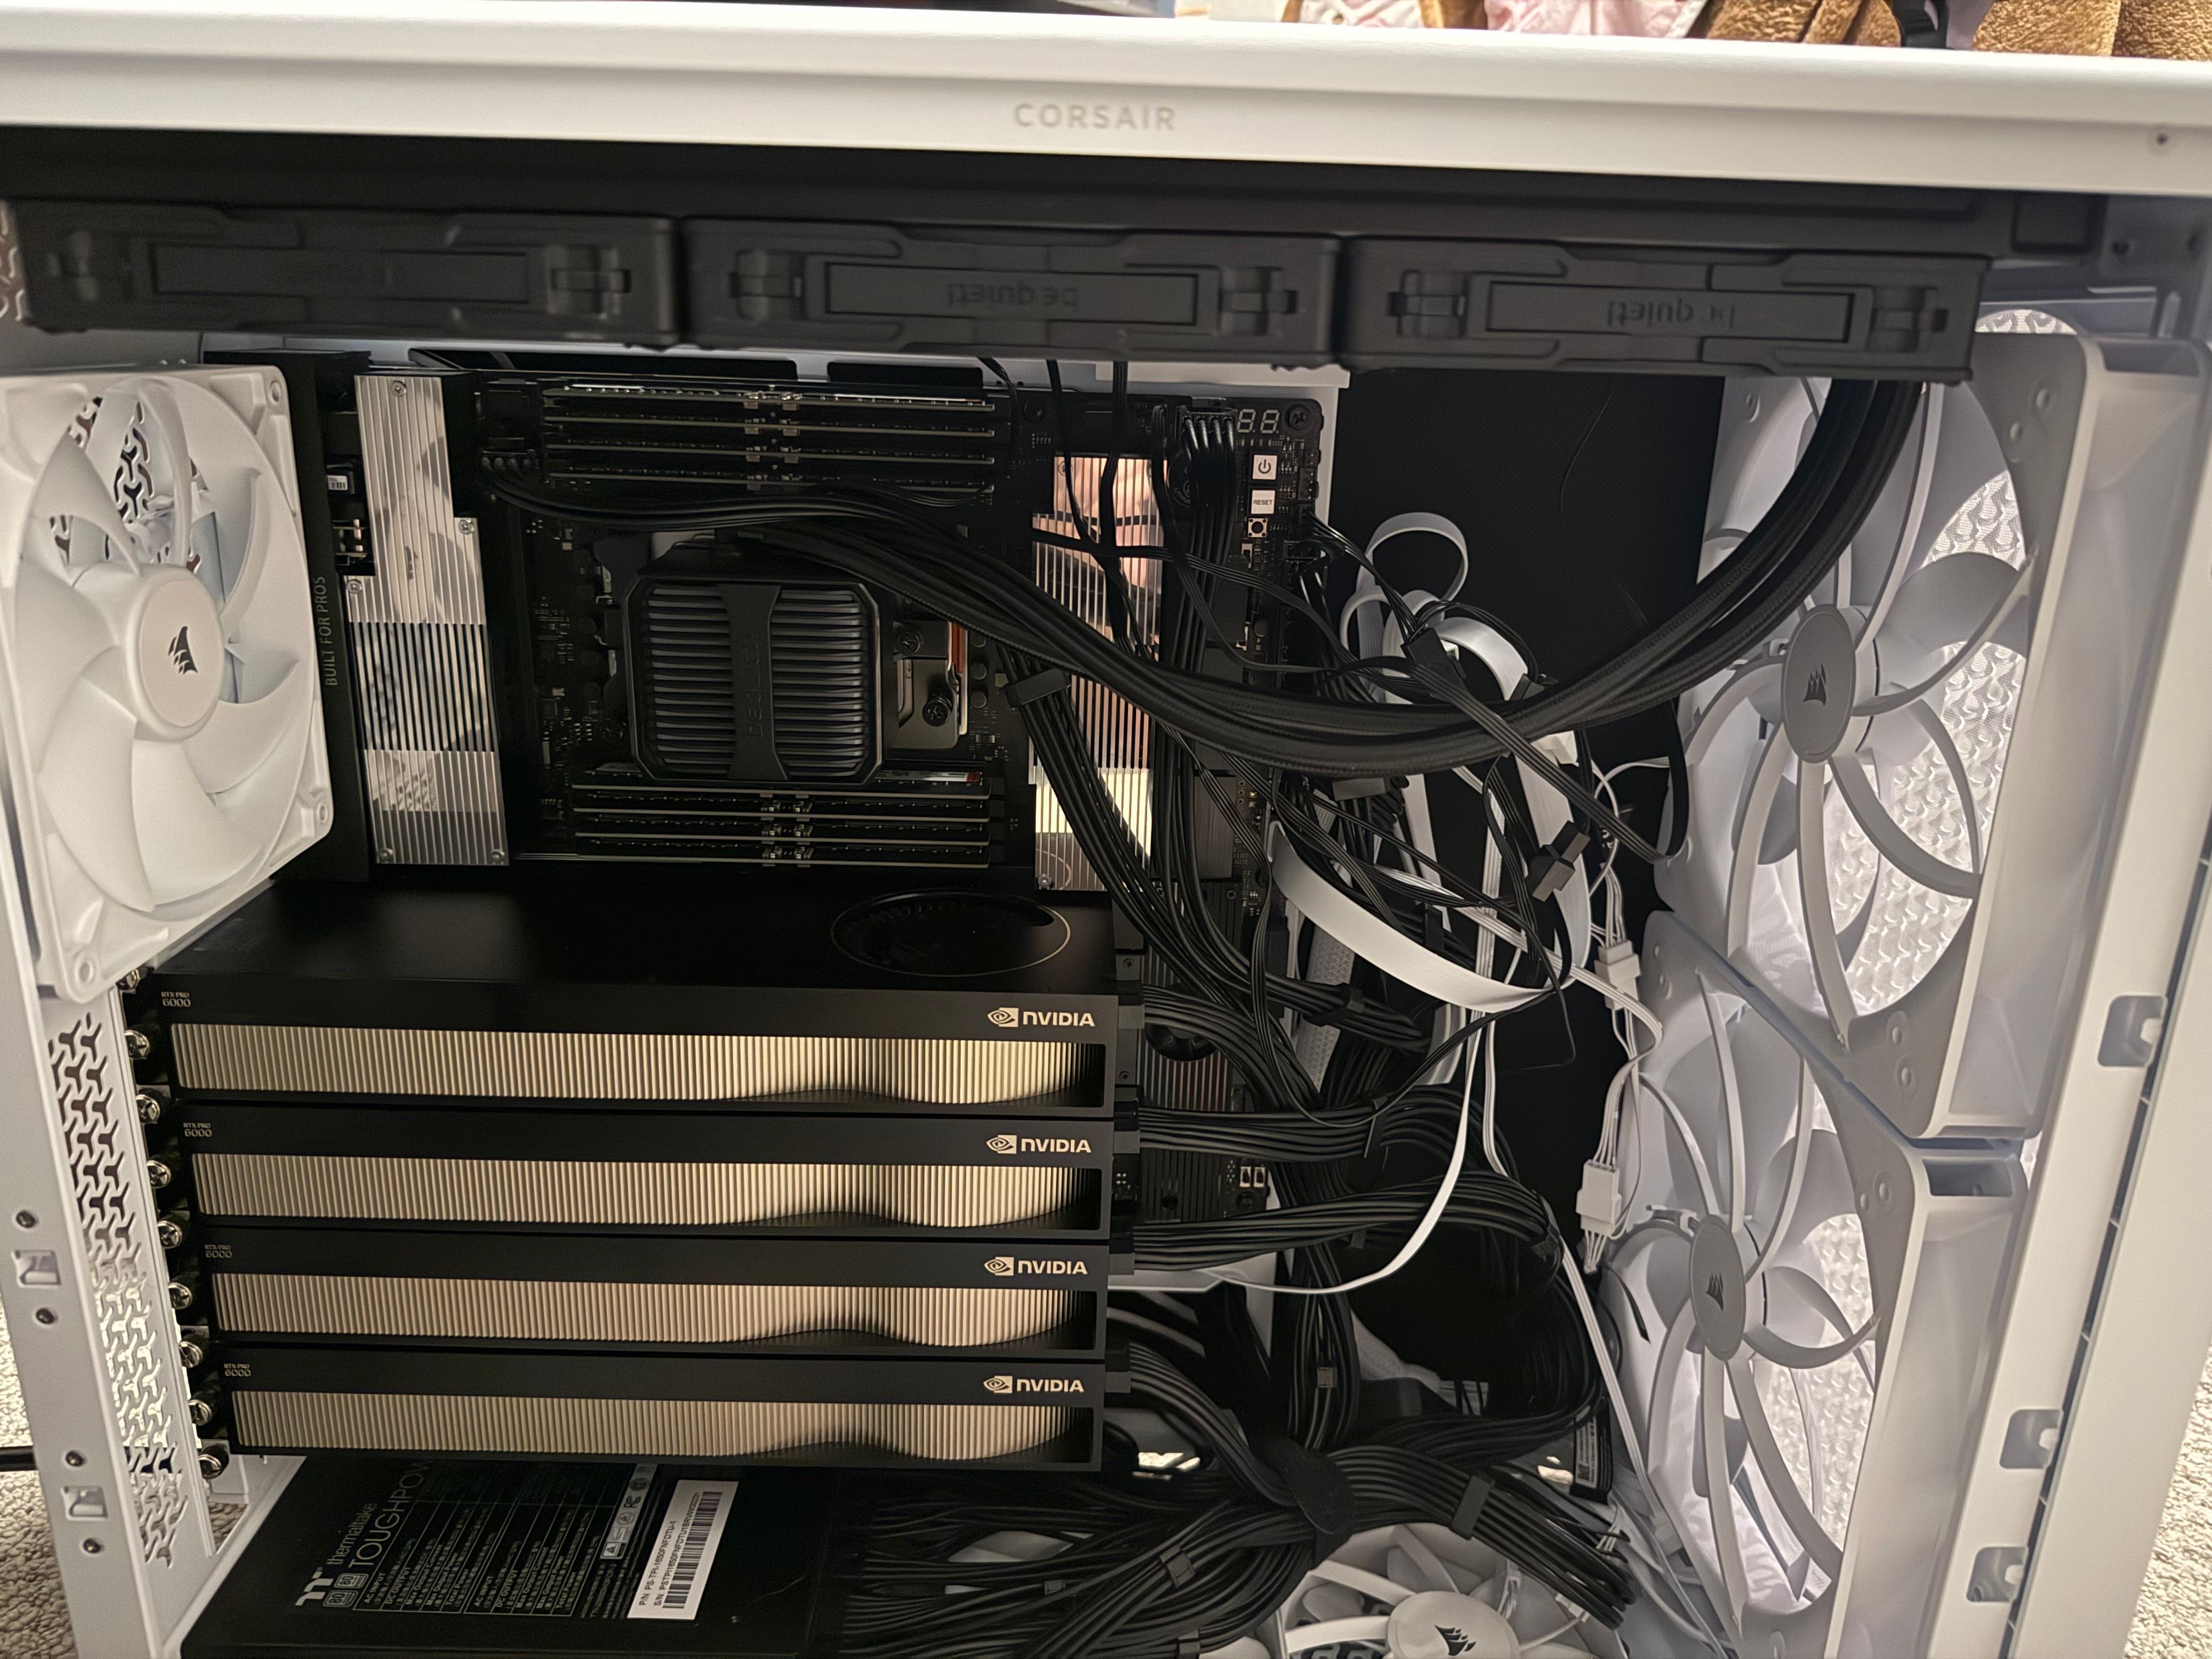
前陣子比較忙 ,換了一個機殼,而且抽空來做昨天更新的deep seek v4.1 flash 跟舊版本的差別。
同一台電腦、相同 SGLang 部署設定,比較 DeepSeek V4.1 Flash 原版與 1017 更新版。
本輪結果:1017 單人生成約快 51%,8 人整批吞吐約高 36%;長文有效 Prefill 約提升 3~4%。1. 比較的是哪兩個版本?
版本 官方發布日期 模型倉庫 本次權重修訂 V4.1 Flash 原版 2026/09/10 deepseek-ai/DeepSeek-V4.1-Flashfb2764aV4.1 Flash 1017 2026/10/17 deepseek-ai/DeepSeek-V4.1-Flash-10171bae0e1「原版」指 1017 更新前的 V4.1 Flash,不是 V4 Flash,也不是舊版 SGLang。日期依官方更新日誌,修訂碼則對應本次實際測試檔案,不表示是發布當天的第一版權重。
2. 軟硬體配置
項目 配置 CPU AMD Threadripper PRO 9975WX,32 核心 GPU 4× RTX PRO 6000 Blackwell Max-Q,96GB/張 RAM/儲存 256GB/本機 NVMe SSD 作業系統 Ubuntu 推論引擎 Docker+SGLang,套件版本標記 0.0.0.dev0SGLang 基底映像 固定映像摘要 c4ca651192e5…,兩版相同權重格式 官方原生 FP4 專家+FP8/BF16 混合精度,約 510GB 平行/推測解碼 TP4/EP4、DSPARK block 5 記憶體配置 NVMe Engram 卸載、64GiB Engram 快取預算 服務設定 上下文 409,600 Token、最多 8 個同時請求、顯存配置比例 0.85 3. 測試方式
直接透過本機 SGLang API 測試,繞過 Harness 介面。先暖機,temperature=0、Thinking 關閉;速度項目固定輸出長度。
項目 輸入/輸出條件 時間/版本 單人生成 約 1K 輸入/2K 輸出 5 分鐘 長文輸入 約 8K、32K、128K 輸入/128 輸出 合計 6 分鐘 併發測試 約 1K 輸入/1K 輸出,1/4/8 人併發 各 3 分鐘 基本正確性 6 道簡單題循環測試 5 分鐘 每版約 26 分鐘,先測 1017,再切換原版。英文合成輸入每次加入隨機識別前綴;實際輸入比表列目標多約 30 Token。
4. 生成速度與吞吐結果
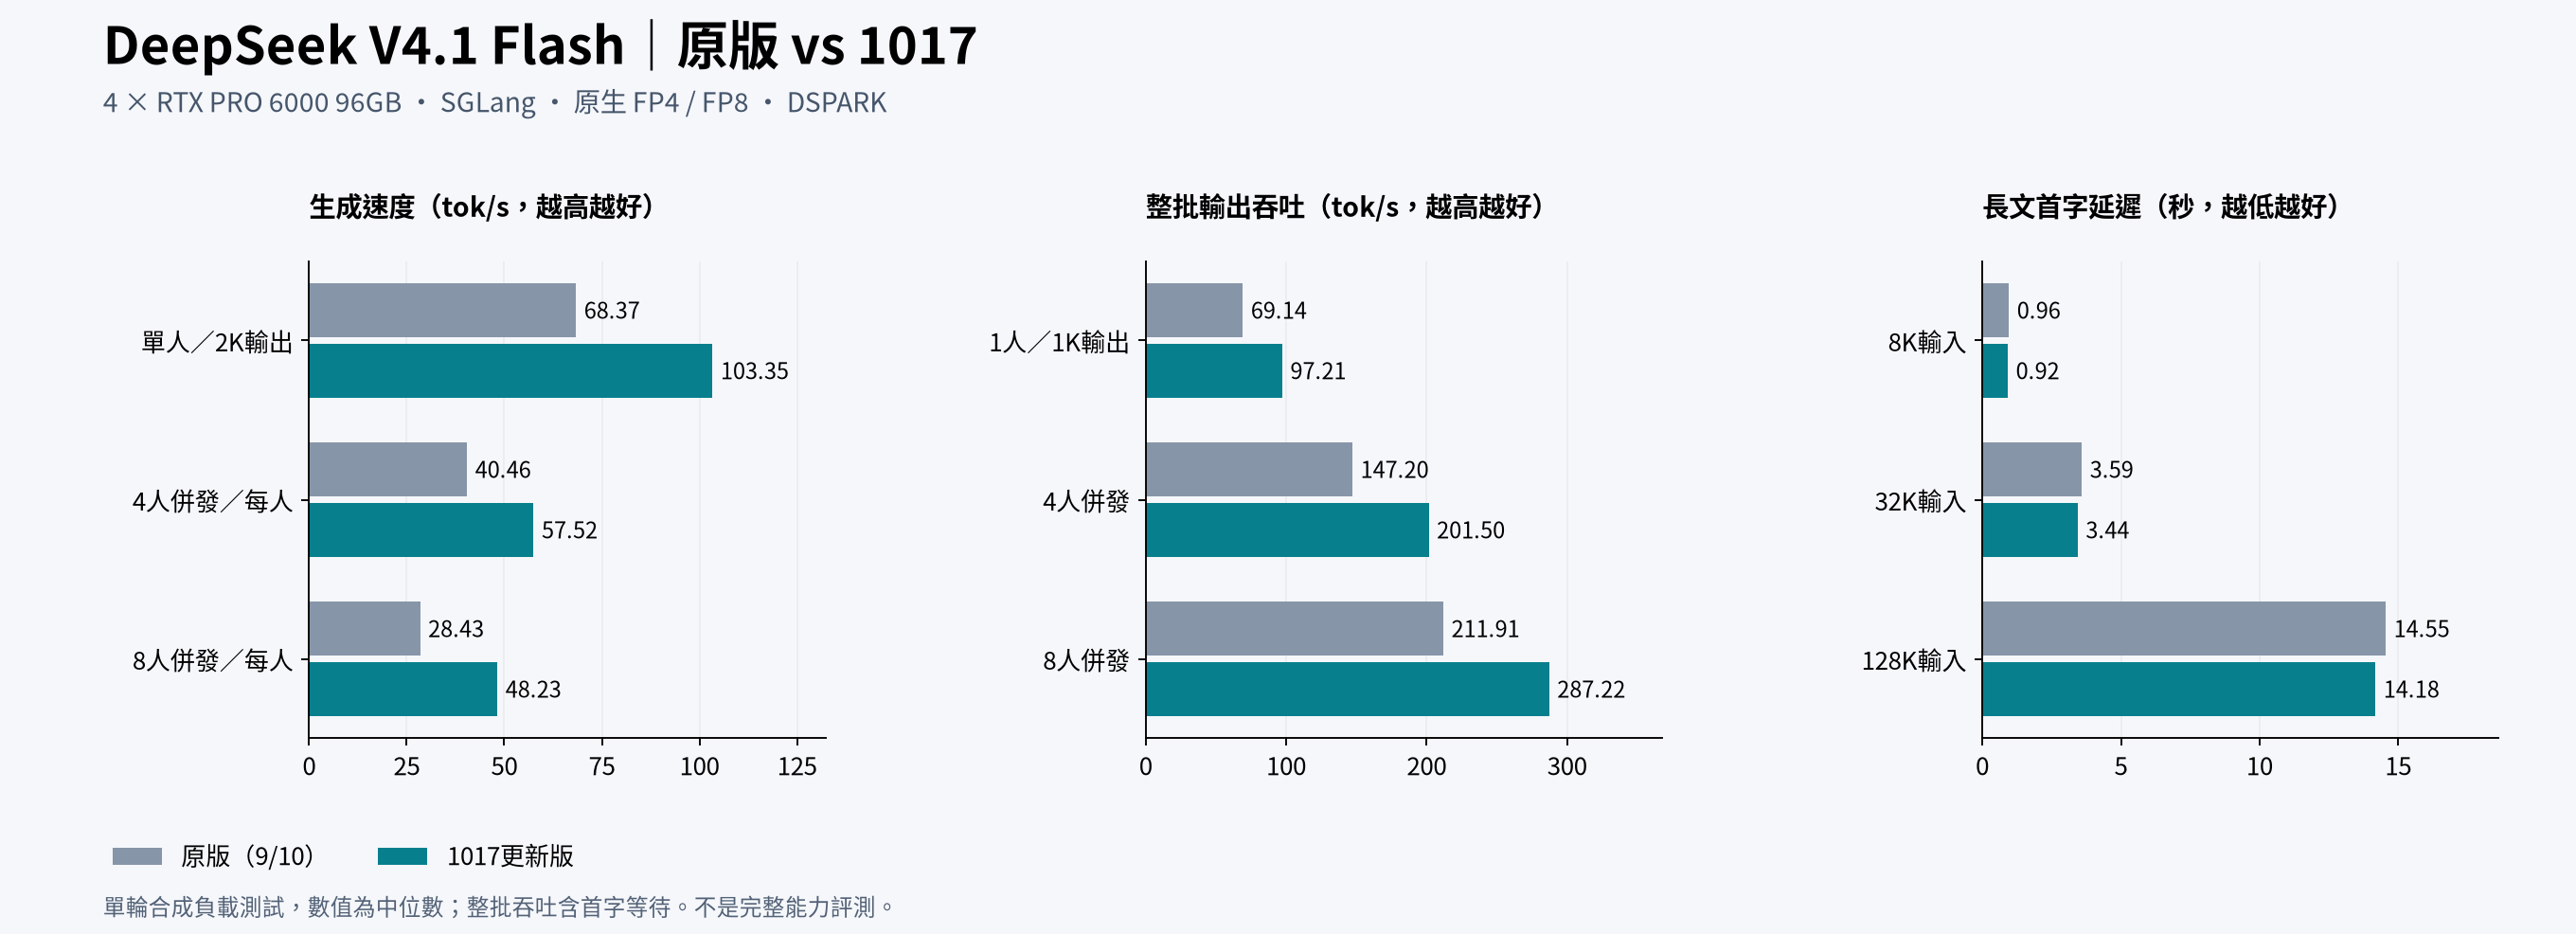
速度單位為 tok/s,以下取中位數,越高越好。
測試情境 原版:每人 Decode 1017:每人 Decode 原版:整批吞吐 1017:整批 吞吐 單人,1K→2K 68.37 103.35 67.96 102.47 1 人併發,1K→1K 69.96 98.82 69.14 97.21 4 人併發,1K→1K 40.46 57.52 147.20 201.50 8 人併發,1K→1K 28.43 48.23 211.91 287.22 重點指標 1017 相對原版 --- ---: 單人生成,2K 輸出 +51.2% 4 人併發,每人生成 +42.2% 8 人併發,每人生成 +69.7% 4 人整批吞吐 +36.9% 8 人整批吞吐 +35.5% 「每人 Decode」估算首字之後的生成速度;「整批吞吐」以整批輸出 Token 除以完整耗時,包含首字等待與輸入處理,兩者不能直接相乘換算。
5. 長文輸入結果
輸入長度 原版:有效 Prefill 1017:有效 Prefill 原版:Decode 1017:Decode 原版:整批吞吐 1017:整批吞吐 8K 8,574.15 8,920.68 73.25 82.98 47.19 51.94 32K 9,128.07 9,528.06 75.17 96.31 24.06 26.54 128K 9,009.65 9,244.69 69.38 94.75 7.67 8.06 單位均為 tok/s。長文項目只輸出 128 Token,完整耗時主要受輸入處理影響,因此整批輸出吞吐較低。
有效 Prefill=輸入 Token ÷ 首字等待時間,包含排程與首字運算,不是純 GPU Prefill。
6. 首字延遲與請求成功數
延遲單位為秒,越低越好。P50 為中位數,P95 表示約 95% 的請求落在該延遲以內。
情境 原版 P50 1017 P50 原版 P95 1017 P95 成功數:原版/1017 單人,1K→2K 0.20 0.18 0.26 0.24 11/11 / 16/16 長文 8K→128 0.96 0.92 1.03 1.01 15/15 / 16/16 長文 32K→128 3.59 3.44 3.67 3.51 15/15 / 16/16 長文 128K→128 14.55 14.18 14.90 14.59 15/15 / 16/16 1 人併發,1K→1K 0.19 0.18 0.20 0.19 14/14 / 18/18 4 人併發,1K→1K 0.63 0.59 0.65 0.63 28/28 / 36/36 8 人併發,1K→1K 1.02 0.96 1.26 1.19 40/40 / 56/56 固定測試時間內,速度不同會產生不同樣本數。
7. 基本正確性
題組包含乘法、加法、JSON、短文代碼擷取、Python
len()與繁中文字串遵循。項目 原版 1017 基本題組答對數 270/270 271/271 題組首字延遲 P50/P95 0.08/0.09 秒 0.08/0.09 秒 全部正式請求成功數 408/408 445/445 這是 6 道簡單題的重複測試,用途是檢查基本輸出與穩定性,不能代表寫作、程式修錯、複雜推理或工具使用能力。
8. 結論與限制
本輪測試中,1017 的主要優勢在生成速度與併發吞吐;長文首字等待與有效 Prefill 有改善,但幅度較小。基本題組兩版均全對,沒有請求失敗。
本次使用自製測試程式,並非 Local Inference Lab 官方 benchmark。兩版各跑一輪,未交錯重測、未嚴格清除前綴快取,也未記錄每輪功耗、溫度及 GPU/RAM 峰值。DSPARK 會分批送出 Token,Decode 是客戶端估算值。因此,上述差異應視為這台機器、這組合成負載下的觀察結果,不能直接當作新版在所有任務中的固定提升。
最近meta 也出了一款開源的模型,但是依官方要求,需要6張RTX pro 6000 但是智商好像也不太行。我配對了一下,但是tps掉太多,感覺也不是真正適合拿來生產的工具,等有更好的模型出來,再來分享結果...
-
-
-
,
 T terry 固定了此主题
-
-
-
-
-
-
-
这机箱,这风扇,真好看
謝謝 主要是之前那個真的太重了....
-
太強了,這論壇已經從,小打小鬧,升級到企業方案級別的測試了

純分享 說不定可以幫版主水一期視頻 哈哈
-
太壕了!!!!!!
純軟件比較 哈哈
-
-
-
-
-
-
羡慕了 两张pro6000跑不了

對.. 做了一些研究
兩張很適合 例如一張卡跑影片模型 一張卡跑LLM
三張 可以讓兩張跑300B左右的模型 一張跑影片 或是小模型一張卡 另外兩張跑影片 增加throughput
如果三張 也可以免強跑得起來 利用CPU offload 但是tps會掉很嚴重 可能long term 不是一個很舒服的position...
四張 個人認為 是現階段家裡硬件的天花板了
以現在的DDR5 的 RAM 要8張插滿64G 價錢會比單張RTX pro 還貴..
如果要在進階 就只能去升級成水冷 去解放GPU的厚度
不然就是真的在家放個rack 現階段暫時也不考慮... -
-
-
,系统 取消固定了此主题







 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!