把 Strata+qwen3.8-flash-next-unsloth-ud-q4_k_xl 接进 Claude Code的五个坑
-
把 Strata+qwen3.8-flash-next-unsloth-ud-q4_k_xl 模型(262,144 上下文),通过 CC Switch 接进 Claude Code 当日常 coding 的模型。
连通本身没什么难度,
claude -p第一次就出结果。麻烦全在后面,一个坑接一个坑。五个坑里四个是上下文的问题。下面按踩到的顺序记。
接入
Claude Code 插件通过 CC Switch 接入:
字段 值 请求地址 http://<推理机>:18090,只填基址,不带路径上游格式 Anthropic Messages(原生) 认证字段 ANTHROPIC_AUTH_TOKEN(默认)
坑 1:「获取模型列表」失败,可以无视
点那个按钮一直失败。为了确认是客户端还是服务端的问题,DSH在本机起了个探针服务,把地址指过去:
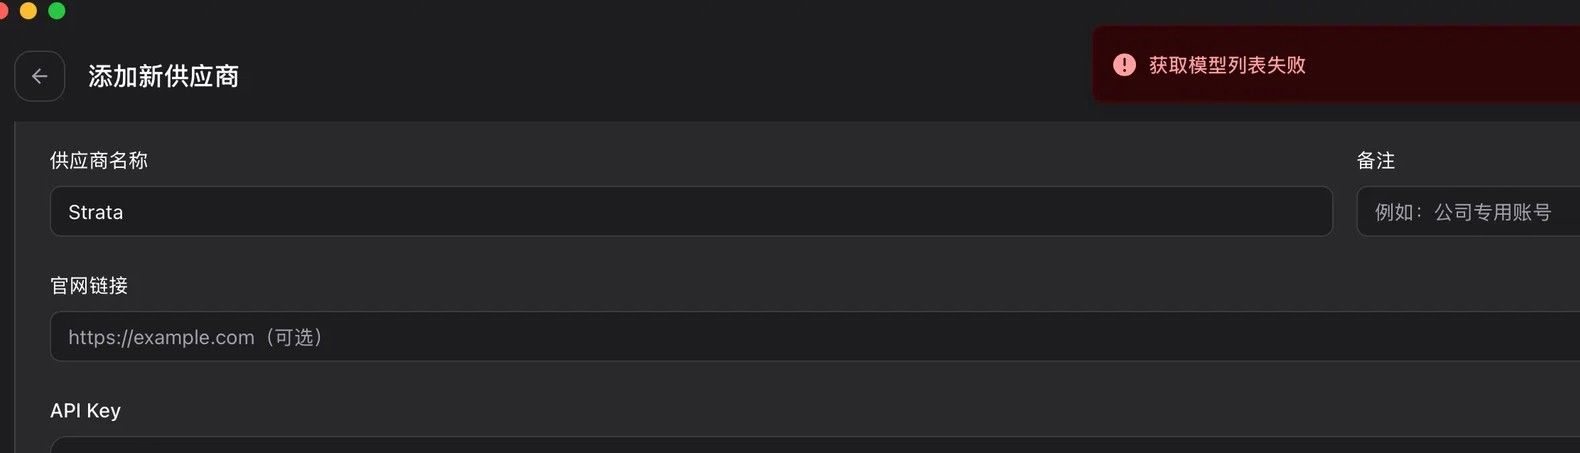
探针一条记录都没收到。查数据库、应用日志、活动连接,结论一致:那个按钮根本没发出 HTTP 请求,在客户端就失败了。
它只是个自动填模型名的便利功能。Strata 不校验模型名,手填
qwen3.8-flash-next-unsloth-ud-q4_k_xl直接保存就行。在这个按钮上耗掉的时间,比全篇其他坑加起来还多。
坑 2:
[1m]不是 CC Switch 加的第一次跑通后,输出里带着一条:
[claude-code:unrecognized_model] {"model":"qwen3.8-flash-next-unsloth-ud-q4_k_xl[1m]"}CC Switch 表单里确实有个「声明支持 1M」的勾,但没选中。数据库和
settings.json里的模型名都是干净的:ANTHROPIC_DEFAULT_SONNET_MODEL = 'qwen3.8-flash-next-unsloth-ud-q4_k_xl'[1m]是 Claude Code 自己的 1M 上下文标记,官方文档里的模型别名就有sonnet[1m]/opus[1m]。
坑 3:这个标记会导致 400
带上之后,Claude Code 认为窗口是 100 万,于是请求
max_tokens: 300000,Strata 直接拒绝: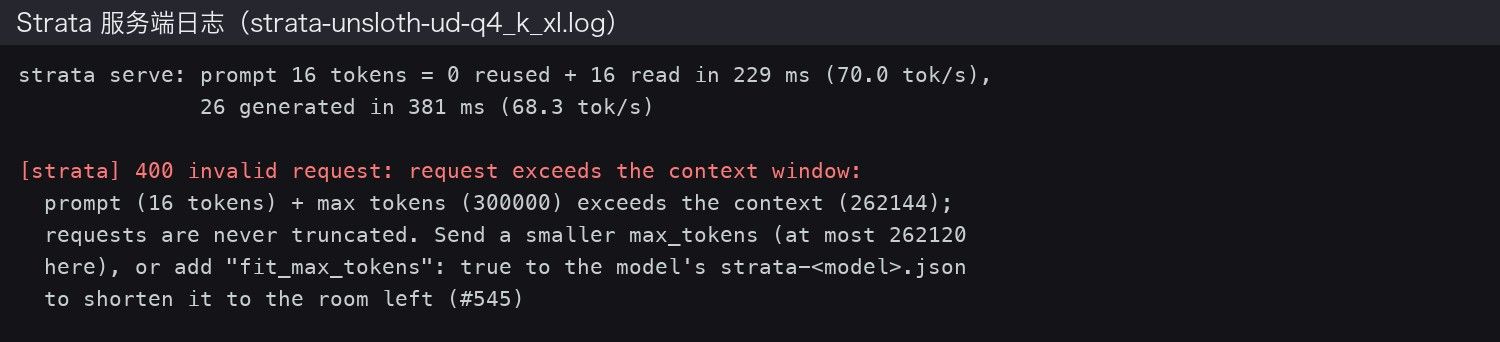
图里它自己把解法写出来了。
坑 4:200k 兜底,以及修它时会踩的第二个坑
没设变量时,Claude Code 会提示:
 Model "qwen3.8-flash-next-unsloth-ud-q4_k_xl" isn't recognized · context assumed to be 200k tokens
这不是提示,是客户端会真执行:到 20 万就 auto-compact,对着 262,144 的上限白白丢掉六万 token。兜底值高了同样有害,会一路撞到网关硬限制才报错。
正确做法是显式声明窗口。但官方文档里这节有个前提:
If ... the ID contains
[1m], in any casing, Claude Code assumes a 1M window for it and the variable doesn't apply on its own. To correct the window while keeping proactive compaction, also setCLAUDE_CODE_DISABLE_1M_CONTEXT=1.也就是说,模型 ID 里带着
[1m]时,声明窗口的变量单独失效。要么同时加CLAUDE_CODE_DISABLE_1M_CONTEXT=1,要么把模型名弄干净。我用的后者,只留一条 Haiku 映射加
model: haiku,变量就生效了:"env": { "CLAUDE_CODE_MAX_CONTEXT_TOKENS": "262144" }重启后
/context从200k变成 262.1k: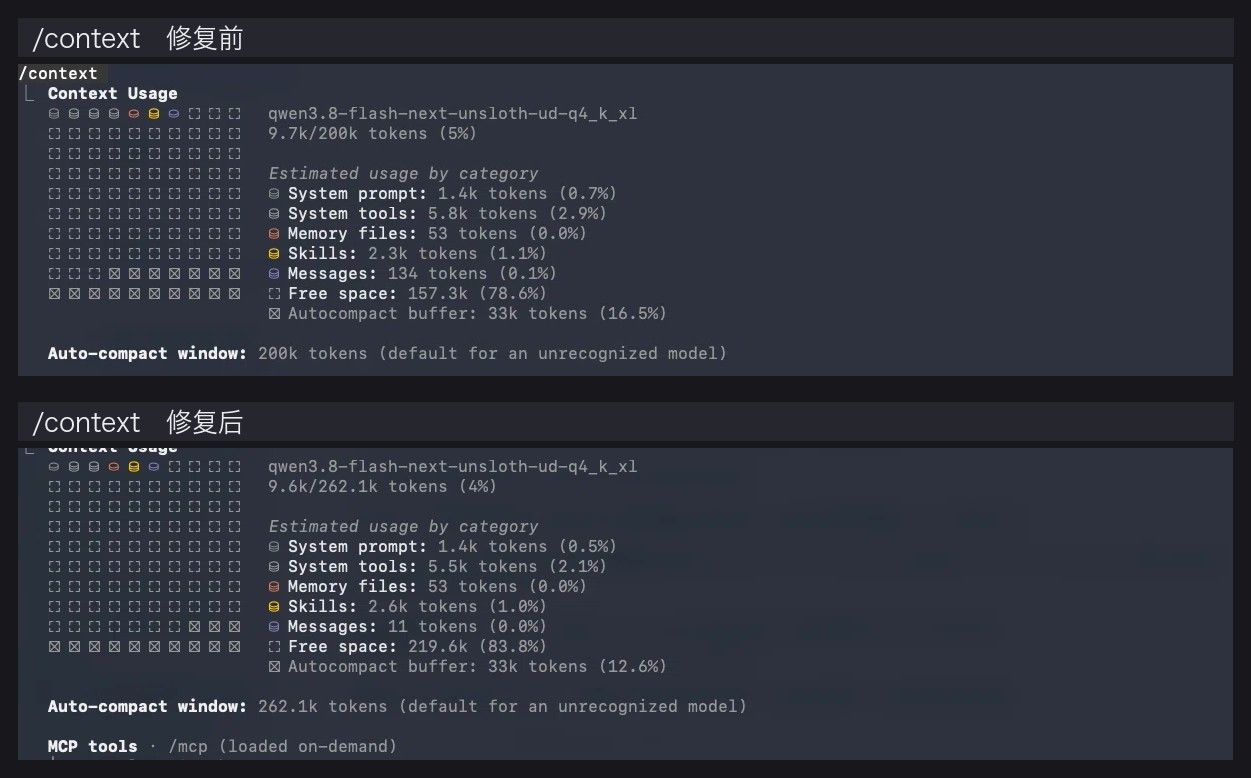
坑 5:把压缩点设成 200,000,窗口也跟着变成 200k
窗口修好之后我又想"再稳一点":声明 262,144,把压缩点压到 200,000,留六万富余。于是用
/autocompact设了autoCompactWindow: 200000。重启,
/context变成9.6k/200k——它把 200k 当成了窗口本身: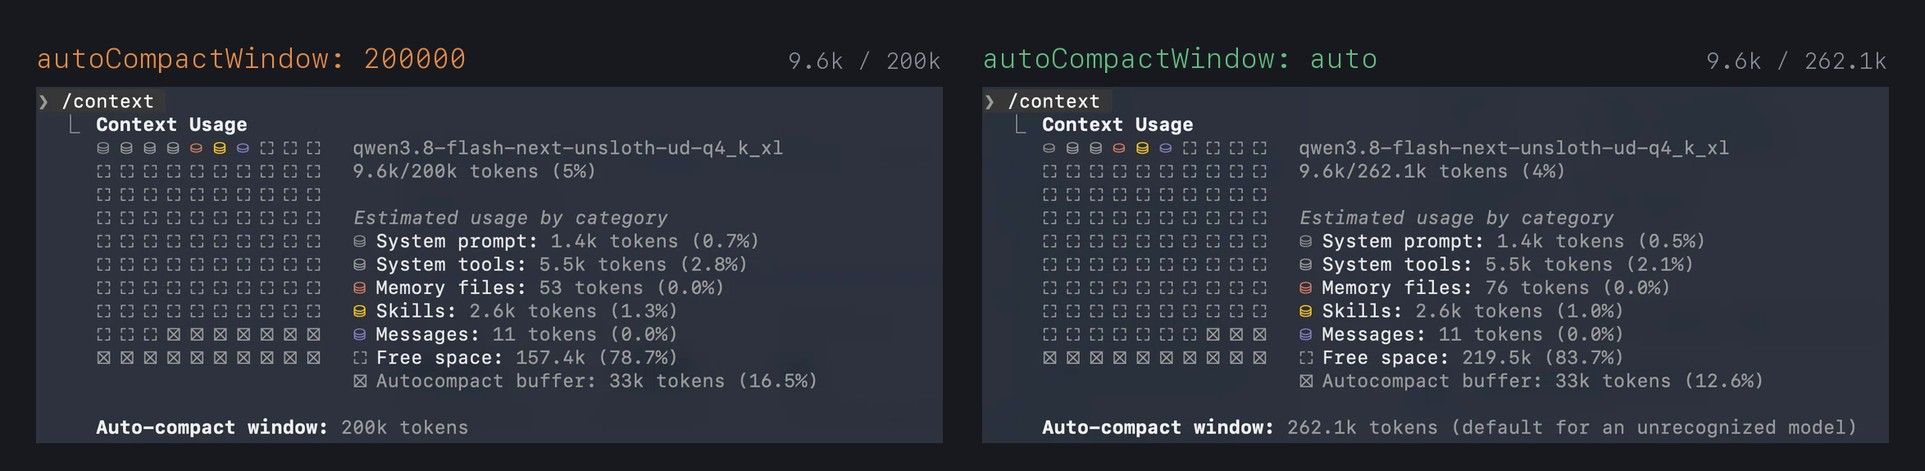
翻 CLI 的代码才明白语义:
if (window <= b) return y; // 配置值 ≥ 声明窗口 → 用声明值 return { window: Math.min(s, b), configured: b, source: "settings" } // 否则用配置值autoCompactWindow给工作窗口设上限,不是设压缩阈值。阈值是从这个上限往下扣出来的:声明窗口 262,144 → min(262144, 200000) = 200,000 → 减输出预留 → 再减 33k buffer → 压缩点约 167k所以实际能用的是 167k 左右,不是 200k,比我以为的少了一大截。想"留六万富余",结果扔了将近十万。
改回
auto之后恢复成262.1k,buffer 33k,可用约 229k,重启后不变:"modelSettings": { "qwen3.8-flash-next-unsloth-ud-q4_k_xl": { "effortLevel": "low", "autoCompactWindow": "auto" } }这个键要么留
auto,要么设一个不小于声明窗口的值(等于没设)。别拿它来留余量——余量是从窗口里扣的,不是从阈值里扣的。
两层防护
客户端这边折腾完之后,服务端还应该有一层兜底。
层 配置 负责 客户端 声明真实窗口 262,144,压缩点留 auto在到顶前主动压缩对话 服务端 fit_max_tokens: true兜住客户端超额的单次输出请求 服务端那项加完之后,用之前必然报 400 的参数实测:
之前: 400 prompt (16 tokens) + max tokens (300000) exceeds the context (262144)
现在: reply 'FIT OK'   stop_reason: end_turn
日志里
400 invalid request的总数没有增加。**客户端管对话别太长,服务端管单次输出别要太多。**只配一边,另一边迟早撞墙。顺带一提,服务端这个变量还解决了一类更普遍的毛病:agent 客户端普遍把输出上限按上下文满额来要,不加就只能靠客户端自觉。
小结
五个坑里,除了第一个是客户端按钮的问题,其余四个都指向同一件事:客户端不知道这个模型有多大,于是自己编了一套答案。
编的方式有三种。写小了,客户端提前压缩,安静地扔掉一半上下文;写大了,一路灌到服务端才 400,报错还跟真正的原因隔着一层。第三种是我自己造的——为了留点余量去设压缩点,结果把工作窗口一起改小了,而
/context显示出来的数字看着都正常。最后一条是这次最贵的教训。
autoCompactWindow这个名字听着就是"到多大开始压缩",谁也想不到它会把工作窗口本身也一起改小。 -
-
-
我是小白 請教一下。接入 Claude Code 有什麼特別嗎? 接入Codex 的效果 會有什麼差別嗎?
-
@charly-cheng
OpenAI已经全面改为Responses格式,目前主流的开放模型虽然都宣称支持该格式,但是我个人实际体验来说兼容性不好,尤其是在Codex里接入本地模型后,工具调用时体验较差,长任务过程中会有多次中断。有很多路由转换的工具,包括CC Switch的新版也加入了聚合模式,简化了将本地模型整合入Codex的过程,但是具体使用过程中仍然不如官方模型那么丝滑。而Claude Code就没有这些问题,主流模型都支持Anthropic messages格式,通过CC Switch接入后,无论是线上模型还是本地模型接入后都能很顺利的工作。推荐使用Deepseek Harness,灵活、方便、功能强大。 -
-
好的 感謝解答 我也來試一試。