
7900XTX 双卡并行跑Strata,驱动Qwen 3.8 Flash Next,多会话长上下文流畅驱动Agent!Qwen 4.0 会带来更好体验!
-
昨天在视频中我就谈到说,Strata这个架构它目前呢是比较新,有些用户反映呢,说它在多会话切换的时候,尤其在长上下文的情况下,它有可能多个slot之间的切换有bug,就没有办法载入已经计算过的缓存,要重新prefill,那种体验就非常慢,就不爽嘛。但是我也说了,我说这个架构本身进化得很快,每天都会有更新,就你要跟这个最新的版本。
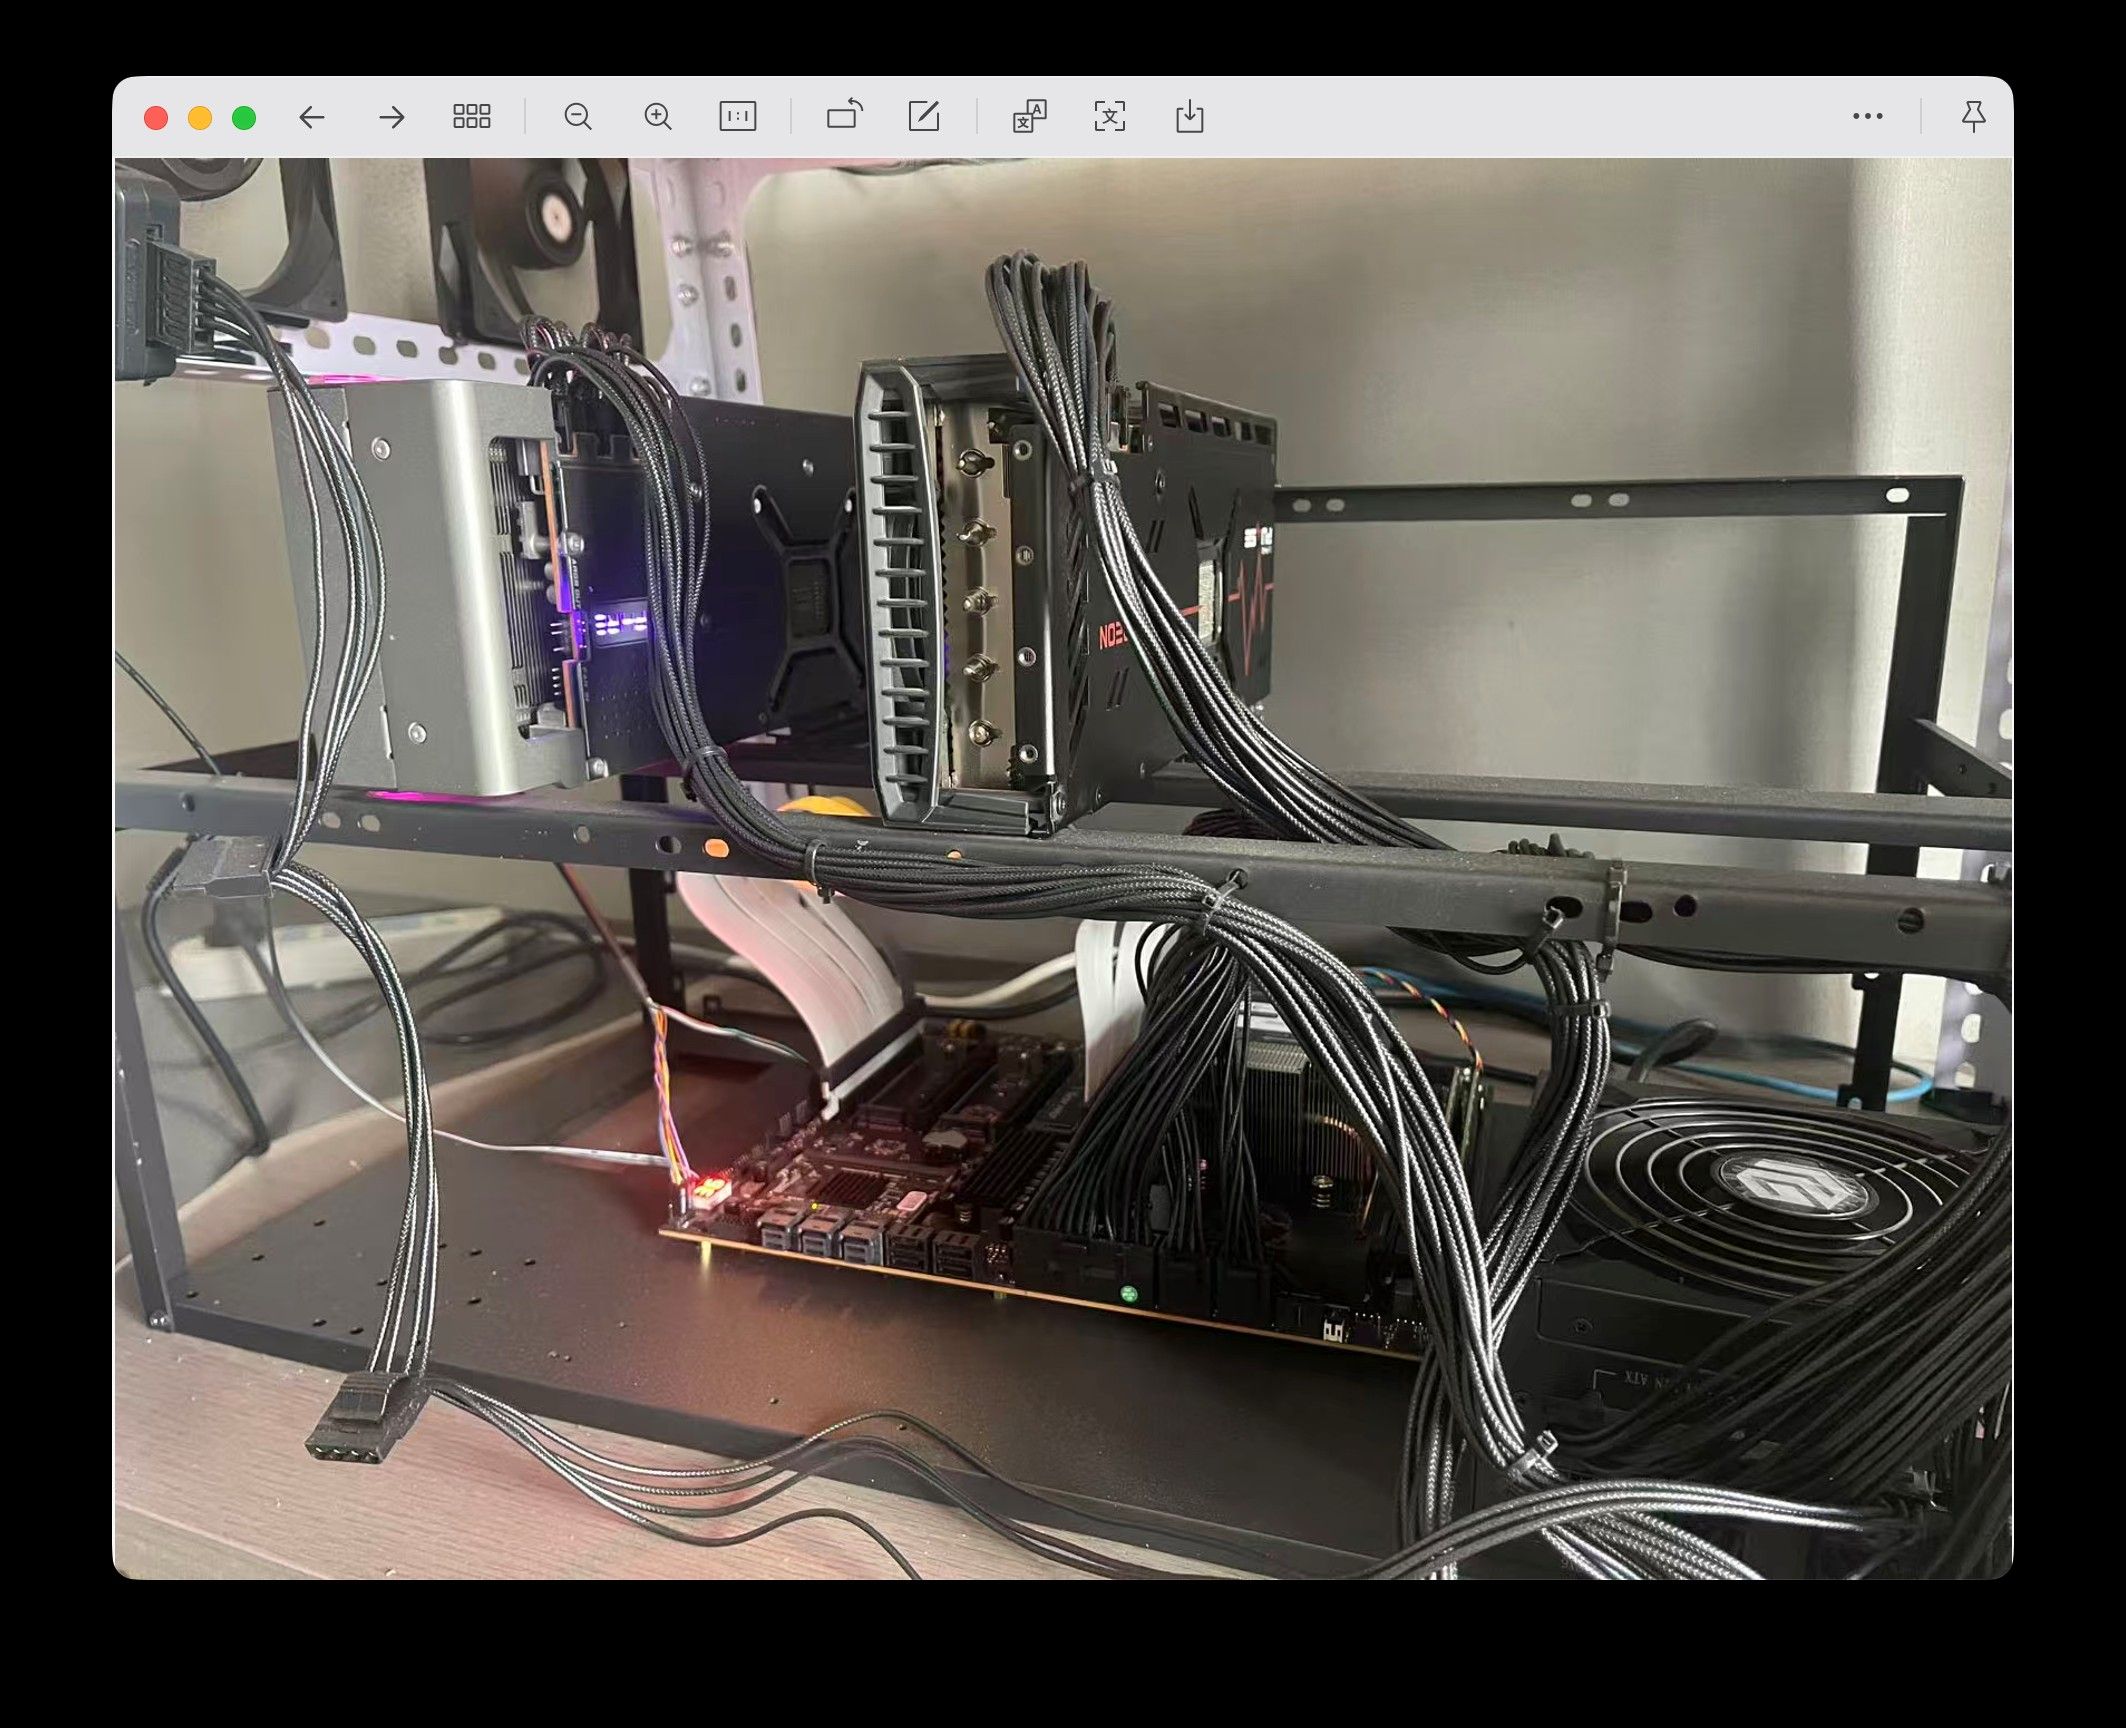
今天就有用户用这个7900 XTX,我们论坛的AI神卡,也是我认为性价比最高的一张卡,当下啊。他这个双卡TP,说能做到单流七八十 tokens/s,双流160 tokens/s。然后它的硬件配置是AMD EPYC 7452,就7xxx系列都可以啊。这个GPU就是显卡是两张7900 XTX,显存就48G嘛,内存是125G,应该128G吧,可能说这个有些损耗啊,正常的。它这个推理后端使用的是ROCm,框架是Strata V0.1.43,这些参数都是有的,包括他跑的这个模型权重IQ3S啊,大家都可以看一下。然后他测试就是双会话长上下文,能够开到双路240K,并且它的总decode速度能够达到160 tokens/s,还是相当不错了。然后呢他后来又做了更高的并发,包括接入DeepSeek Harness,进行多轮工具调用,测试它的稳定性。然后它的请求都是能够稳定在双卡之间分流的。
这个Strata,用户测试用到它的双卡TP方案跟传统的TP方案还不一样。传统的是把这个模型权重给裁切,对半分到两张显卡中去。它这个方案呢,是在每个GPU中运行一个独立的模型副本,然后每个副本有自己独立的推理引擎,并且有独立的KV缓存、MTP会话状态。但是呢两个副本的共享专家,就是怎么讲呢,这是一种,你可以把它理解为稍微打折一点的,就是它的共享资源没那么彻底的这种双卡TP方案,就半TP方案嘛。然后他也是加了MTP进去啊,而且是每张卡单独有自己的MTP。总之这个方案挺新奇的,就是能够节约一部分资源,但是又不如传统的双卡TP那么节约资源。不过据他测试,效果是非常稳定的,而且温度很低。
哦对了,关于这个温度,就有很多人说他们用SGLang配置的,那个功耗就高,怎么怎么样,温度就高。就包括这个测试的贴主,他也是这么说的,Farm Node,Farm Node啊,就是他也是这么说的啊。但是呢我跟大家讲,就是我还是基本上什么框架我都配过啊,我也都实测过。就是你们如果配置SGLang,你们这个什么涡轮卡的风扇一直响,那是你们没有配对。就最起码我知道的方案,我使用这个DFlash2,然后使用这个草稿小模型来打草稿,让这个主模型来验证。是吧,我是多会话、长上下文都测过,只有偶尔一开始能启动的时候,那个涡轮卡的风扇会响,其他时候它的功耗也很低,响应也非常快,而且我是长上下文长期工作。这个如果说你们没有做到类似的效果,如果你们的显卡风扇一直响、一直嗡嗡作响,那你们要检查下自己的配置。这个绝对是配置的问题,不是框架本身的问题。就SGLang它在跑27B的时候,它的效果绝对是要比其他的框架更好的、更牛逼的。它的Radix缓存树的优势,那种及时响应的优势,跨会话共享KV缓存这种能力,怎么说呢,你硬件越强,它的优势越大。就哪怕是你上了4090 48G这种只能说相对稍微有那么一点点高端的卡,比如说RTX Pro 5000以上,你尤其是双卡的话,那你跑SGLang,其他的所有框架那绝对是望尘莫及。你如果四卡八卡就更不用说了。
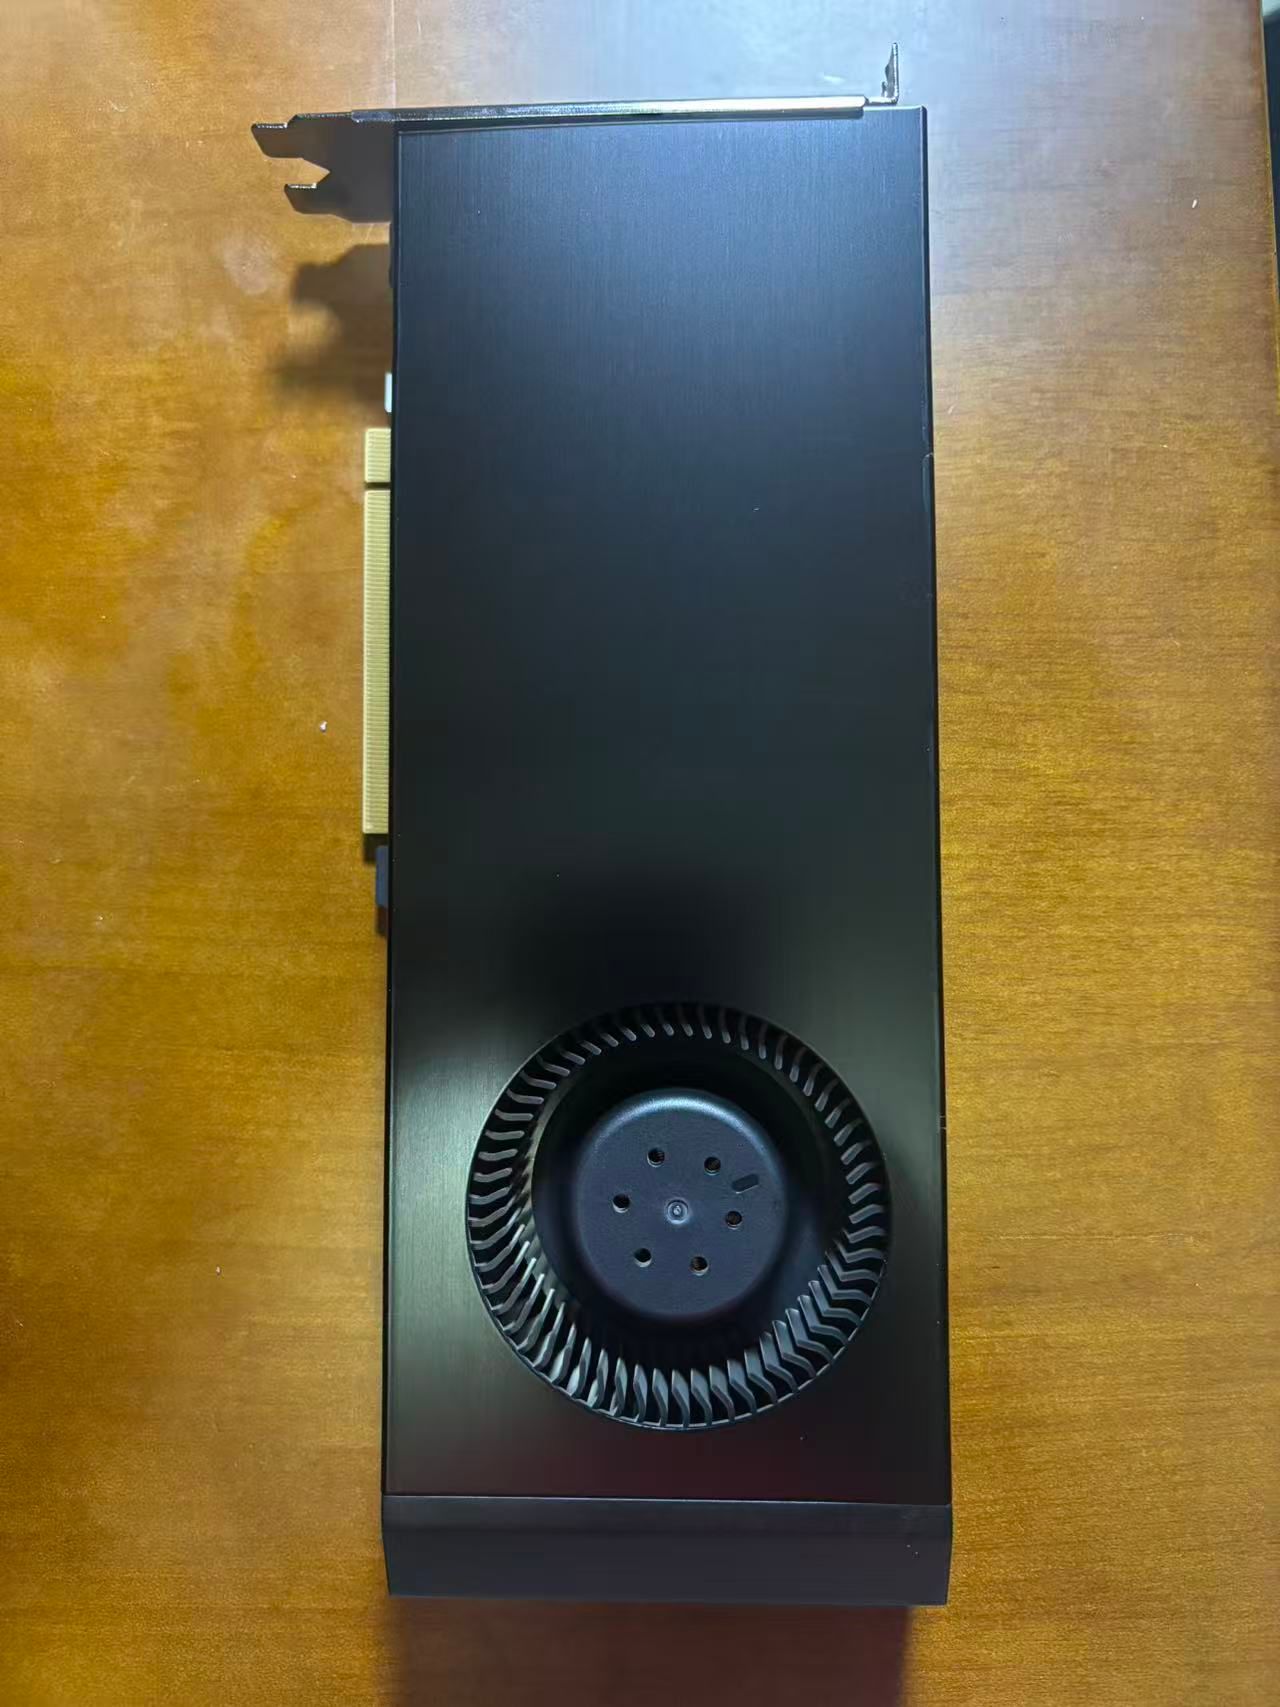
然后就再谈谈7900 XTX这张卡。就是我之前不是一直说嘛,我说有一段时间,一开始我是推荐把它作为AI神卡,是吧,后来呢又由于它是AMD的卡,生态不好,然后我又推荐大家去买这个3090,这个都是春节前后的事情啊。并且当时我推荐一共就是四张卡,其实到目前为止,我推荐最多的就四张卡,就是7900 XTX、3090、AI Pro R9700跟4080S 32G魔改卡。我的意思就是说,想折腾硬件的,你就去买3090、买这个4080S;就是想折腾软件的,你就去买这个7900 XTX或者AI Pro R9700。那么这四张卡其实从年初到现在涨幅都比较大,也确实是我们论坛部署最多的。4080S还是少一点,其他三张像这个什么3090啊、7900 XTX跟AI Pro R9700,它们都是论坛的神卡啊,大量的人部署、大量的教程、各种分享。无论是跑ComfyUI、MiniMax H3、LTX,还是说跑这个大模型千问27B,或者现在流行的Strata驱动千问Flash Next,这几张卡的表现都是相当牛逼的,而且它们都有单卡双卡的方案。这里不是有这个标签嘛,你们就去找对应的卡啊,这里面都有,或者你在这个地方搜索,就是它单卡双卡跑这个什么千问27B,跑这个Strata加千问Flash,或者说是它们单卡跑这个ComfyUI,啊都有。就完全不用你去考虑怎么去指挥AI,你就直接让AI把这个什么地址复制给它,然后让AI去抄作业就行了。就包括这个帖子,如果说你有类似的硬件,让它抄作业就行了。
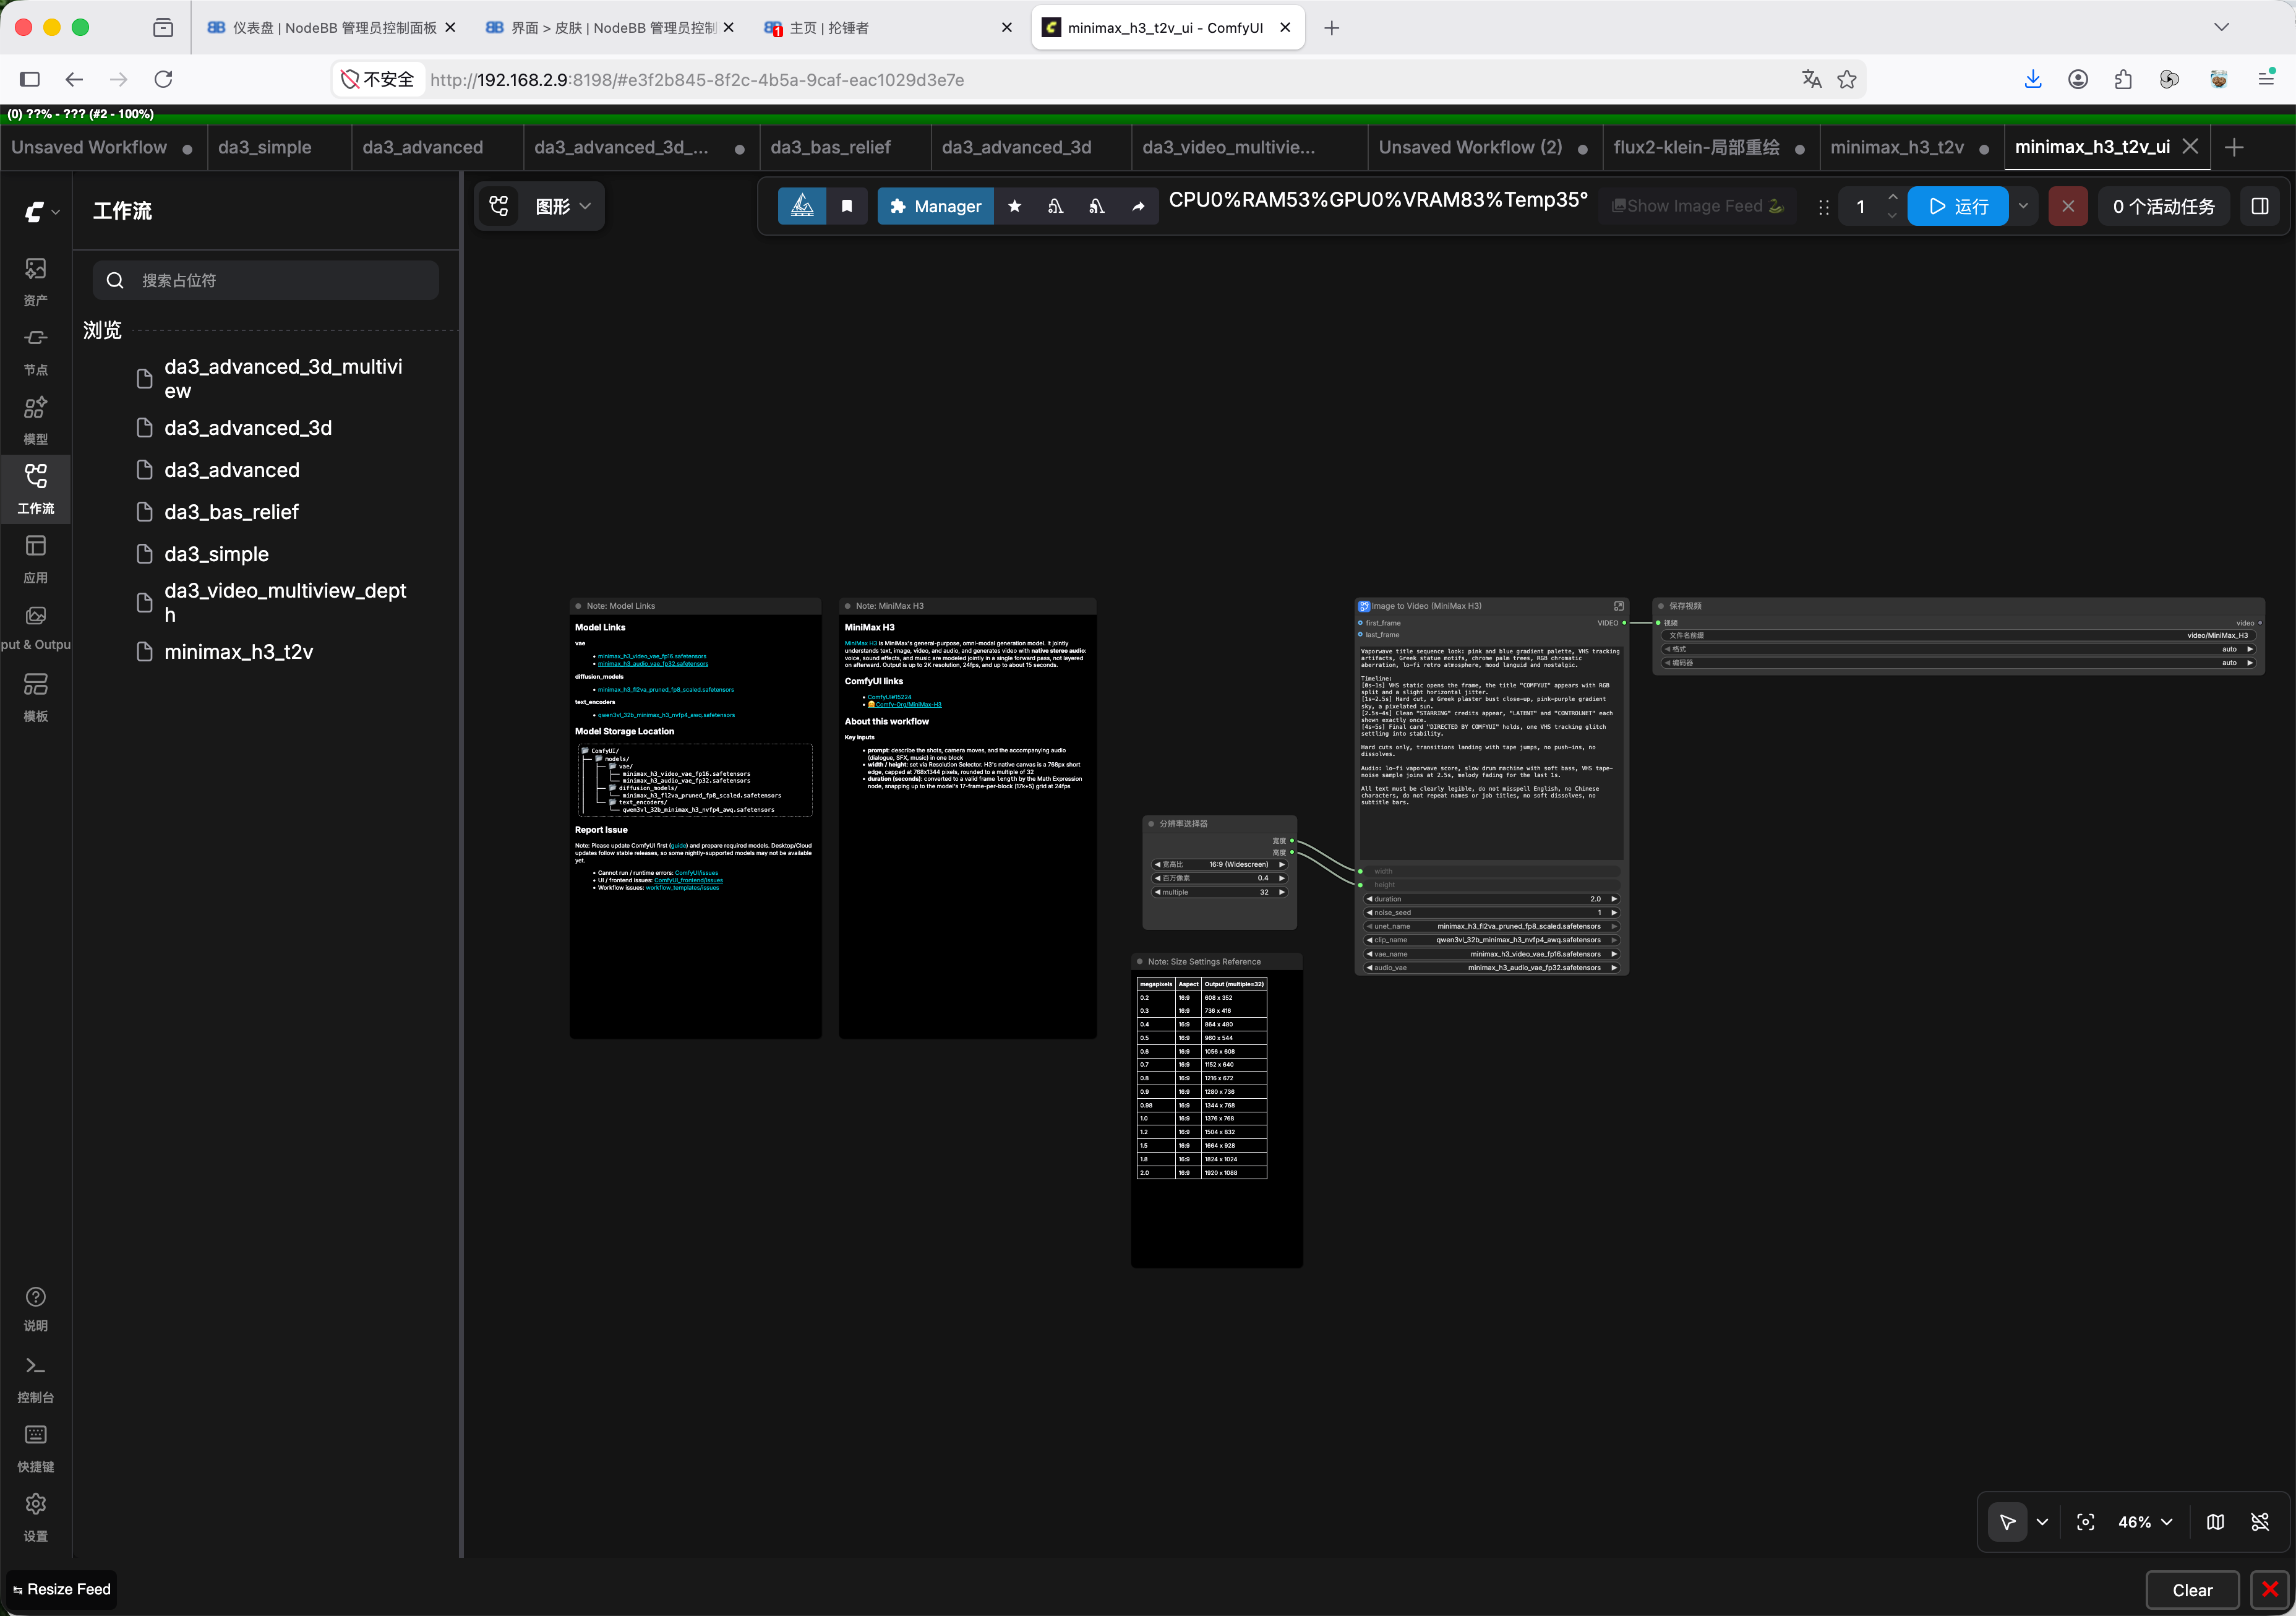
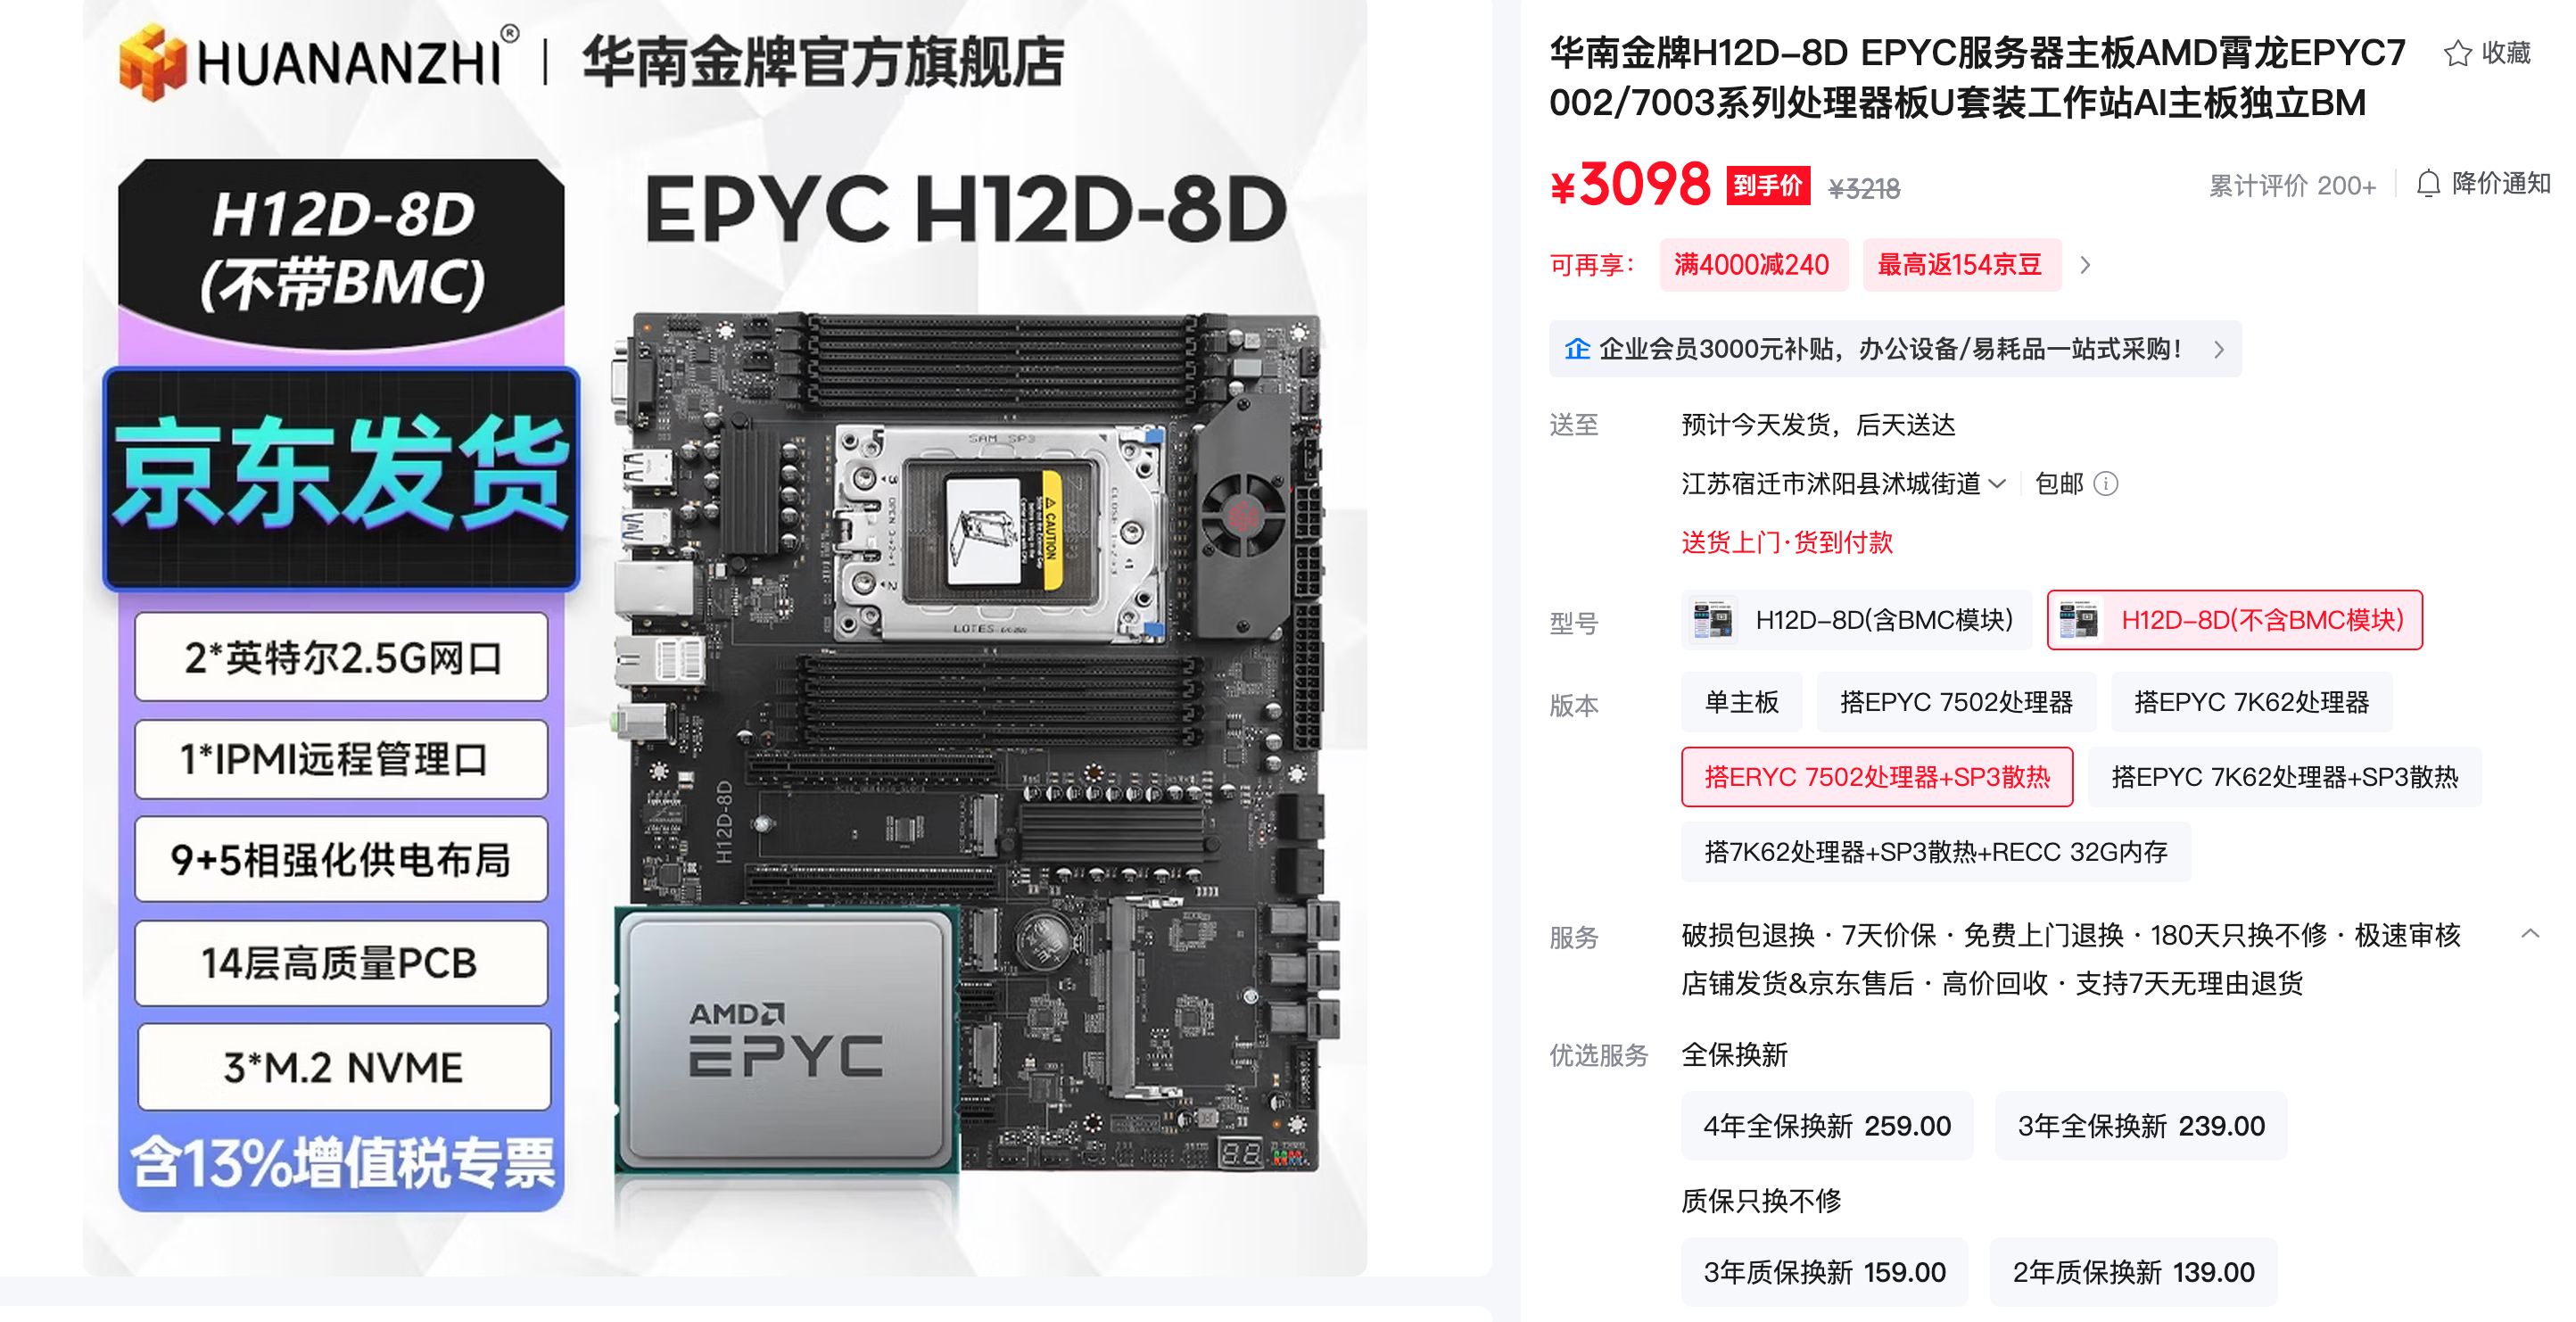
哦对了,还要说一下,就是关于CPU的配置。就是过往呢,怎么讲,像我们跑这个千问27B的时候,其实CPU的参与度是非常低的。那么以后如果说你要跑更大规模的MoE模型,CPU的重要性也是要稍微往上提一提的啊。就我用的是E5-2666 v3,是DDR3平台的。内存的影响经过论坛实测啊,这个都有实测的啊,影响是不那么大的。就你DDR3的、PCIe 3.0 x16的接口,这种显卡啊都够了。主板跟显卡你的这个什么,只要能有PCIe 3.0 x16的带宽,然后你有这个DDR3,最好是四通道,内存其实你的这个带宽都是够的。然后CPU像我的这个什么E5-2666 v3是够的。但是如果说你以后要跑这个多卡,跑这种多用户长上下文,你使用DDR4平台的这个EPYC洋垃圾,其实像以前搞这个什么X99的,像华南金牌、像精粤,他们都有这个EPYC的配套主板,这些U也都不贵。我这个两个月之前我好像是看了一下,好像价格就3,000块钱套装,现在好像是涨了还是怎么样,反正这个价格应该不会太贵。当然了,它配的U也不一样了,就七零零几的肯定会便宜一点啊,但是性能也是绝对够了啊。
还有呢,就是关于千问4.0即将发布。就还是那句话,推荐大家关注这个千问27B,它的旗舰模型性能。讲实话,一直以来我都不太推荐大家使用阿里巴巴官方的这个API,因为它的性价比我有点看不懂啊,它的这个销售方案就非常奇葩,有点不太理解他们的市场竞争策略。但是阿里巴巴对于开源社区的贡献应该说是毋庸置疑的啊。你说这个什么Strata这么流行,是吧,这个千问3.8 Flash Next的模型这么火,阿里巴巴的贡献是毫无疑问的,是吧?没有这个模型就没有Strata这个架构。当然了,我们也要提一下DeepSeek,是吧,吃水不忘挖井人。这里面的核心技术就是什么分层Ngram算法,这个算法是DeepSeek开源的啊。而且DeepSeek开源这个技术的时候我就说了,我说这个会极大地改变本地AI部署的生态。其实回想一下,我当初做那个视频的时候,到现在已经有小半年时间了,是吧?小半年之前,我在这些生态还没有起来的时候,那个时候只能说凭借自己的经验,凭借自己粗浅的理解,是吧,做一个预测。其实我在AI方面很多预测最终都是被证实了的啊,大家可以翻看我早期的视频,虽然制作水平比较粗糙,啊现在其实也不太精细,这个水平也还是相对偏低啊。但是呢我的预测,大的方向上的预测,基本上是没有错过的。
-
-
-


