AMD3700X+X570+RTX 5060 Ti 16G ×2(PCIe 4.0 x8)跑 Strata+无审查版Qwen3.8-Flash-Next IQ3_S 128K上下文
-
RTX 5060 Ti 16G ×2(PCIe 4.0 x8)跑 无审查版Qwen3.8-Flash-Next IQ3_S 性能报告:单卡→双卡,槽位 ×2.1、copy 解码 144–163 tok/s(128K 上下文)
本次数据分两类:受控基准(copy 任务 / 固定长度提示)与真实负载统计(正常服务状态下 273 个请求的引擎聚合)。受控基准不挑"最好看的一次",只取能重复的那一档;个别只有单次采样的值会在表里标出来。
2026-10-23 晚在双卡上补测了一组纯复述(3 次,草稿接受率 88–94%),读数并入第 2 节。单卡沿用一条历史 copy 记录(98.4 tok/s),两者的调优状态不同,怎么对比见第 3 节。
一、硬件规格与运行前提
【核心硬件】
部件 规格 显卡(GPU) 2× NVIDIA RTX 5060 Ti 16 GB(GB206 / sm_120,128-bit GDDR7,单卡带宽 448 GB/s) 显卡链路 各 PCIe 4.0 x8(理论 15.75 GB/s),PHB 拓扑,无 NVLink 处理器(CPU) AMD Ryzen 7 3700X(8C/16T,AVX2,无 AVX-512) 系统内存 92 GiB DDR4 双通道 系统固态 NVMe 465 GB 功耗 / 温度 生成时双卡合计约 232 W(上限 360 W),60 / 67 ℃ 【软件与引擎栈】
项目 配置 操作系统 Ubuntu 26.04.1 LTS,kernel 7.0.0-38-generic 显示驱动 595.99.02(Ubuntu 预编译签名模块,Secure Boot 保持开启) CUDA 13.4(引擎自编译,GCC 15.2) 推理引擎 Strata engine 0.1.48.1(仓库 v0.2.3.1) 量化权重 Qwen3.8-Flash-Next IQ3_S(GSQ-RCO,约 79 GB);当前跑 abliterated 版 投机解码 MTP, --spec 4 --spec-min-p 0.5【关键运行参数】
项目 配置 上下文 / KV --max-context 131072,--kv int8,--kv-grow分卡 layer split( gpu: [0,1]),--pipeline-windows 2专家缓存 auto → 8,957 槽 / 17,319 MiB(学习型 profile 预填) 会话缓存 --conversation-cache-mib 6144/ 4 槽,--vram-reserve-mib 1024采样 presence_penalty: 0(默认 1.5 会让双卡 overlap 退化为串行)加卡前提:BIOS 必须开 Above 4G Decoding(否则第二张卡 BAR1 = 0M,
nvidia-smi -L只看到一张),顺手开 Re-Size BAR、关 CSM。
二、核心实测数据汇总
测试规范:decode 一律取引擎底层 timing,不用客户端壁钟;decode 主指标用 copy 任务(逐字复述,草稿接受率 88–100%),排除"这段文本好不好猜"的干扰;冷提示与热缓存分开记;关键项 2–4 次取值,单次数据在表中标
n=1。【1. 单卡四阶段:8 GB → 16 GB → IQ3_S】
阶段 显卡 量化 / 上下文 专家槽位 8K Prefill 解码 A 1×8 GB IQ3_XXS / 128K / KV 流式 629 362 tok/s 33–35 tok/s B 1×16 GB IQ3_XXS / 128K / --kv-grow5,659 1,597 tok/s 73–76 tok/s C 1×16 GB IQ3_S / 128K 4,606 1,544 tok/s 98.9 tok/s(copy) D 1×16 GB IQ3_S-abl / 128K / reserve 1024 4,351 1,524 tok/s 98.4 tok/s(copy) ★ 8 GB → 16 GB:槽位 ×9.0,8K Prefill ×4.4,解码 ×2.2。 全程收益最大的一次硬件改动,比后来加第二张卡明显得多。
★ IQ3_XXS → IQ3_S:槽位 −19%,copy 解码 −12%,Prefill −3%。 用 12% 的速度换质量;长链 agent 任务里工具参数写错、重复发请求的次数明显下降(体感,无跑分)。
【2. 双卡 vs 单卡】
指标 单卡 16 GB 双卡 16 GB ×2 专家槽位 4,351 9,183(×2.11;调优后 8,957) 缓存命中率 75–80% 93.8–97.8% PCIe 缺页占比 未记录 1–6%(实盘) copy 解码(短提示) 98.4(旧配置,n=1) 144.1 / 152.5 / 162.6(n=3,中位 152.5) 解码(2.3K 真实提示,热缓存) — 89.3(加卡初期)→ 105.6(当前) 解码(7.7K 热缓存) — 84.4 / 97.2 / 89.9(n=3) Prefill(2.3K 冷) 约 900–1,100 793 Prefill(7.7K / 30.5K 冷) — 1,522 / 2,516 双卡利用率(生成时) — 70% / 79% ★ 加卡没有让解码翻倍,也不该期待它翻倍。 层拆分是逐 token 串行过两张卡,第二张卡不缩短关键路径;它买到的是槽位和命中率:4,351 → 9,183 槽,75–80% → 94–98%。
★ 同任务整体 +55%:单卡 98.4 → 双卡中位 152.5。但这 55% 里混着加卡与两项调优,不能记在卡头上——详见第三节。
★ Prefill 短降长升:2.3K 从 900–1,100 掉到 793,30.5K 却能到 2,516——层拆分的交接开销在短提示上摊不平,长提示反而被流水填满。
【3. 上下文档位权衡】
max-context 专家槽位 KV 上限 解码(2.3K 热) 代价 65,536 4,414 0.84 GB — 只多 63 槽(+1.4%),随后 67,409 token 的请求被拒 131,072(当前) 8,957 1.68 GB 105.6 日常档 262,144 8,138 3.35 GB 83.6 槽位 −11%、解码 −6%,换原生 256K ★ 64K 试验说明:槽位不是被上下文上限卡住的。减掉一半 KV 只多 63 个槽,代价却是一个能读 67K 文档的窗口——因为会话缓存的 6 GiB 并不全在显存里,减 KV 释放不了多少 VRAM。
【4. 参数逐项 A/B】
有效的:
改动 实测 代价 判定 --pipeline-windows 2利用率 45/49% → 70/79%;2.3K 83.6 → 91.6/119.1 272 MiB、−206 槽 
学习型 expert profile 命中率 82.6–85.6% → 92.6–96.4%;2.3K 91.6 → 105.6 下次启动才生效 presence_penalty: 0默认 1.5 时 overlap 退化为串行 采样风格变化 会话缓存 6 GiB / 4 槽 复用 2.5K token,首字 8.3 s → 1.0 s 6 GiB 内存 --vram-reserve-mib 1024空闲 652 MiB, #2065显存告警消失约 100 槽(2–3%) --kv-grow112.6 / 1,597(KV 流式 110.6 / 1,579) 无 --adapt-async 1(单卡)52.15 → 55.0(+5.5%,4/4 一致) 双卡层拆分下被引擎关闭 / —负优化(都回滚了):
# 改动 实测 结论 1 --kv k8v4Prefill −38%(561 → 347),解码不变 
2 --ple-io ram启动 +45 s;解码 55.75 vs 55.0; ulimit -l仅 8 MB,mlock 全失败3 --adapt-swaps 160 --adapt-every 254.95 vs 55.0,另出现一次 108 s 异常 4 STRATA_MTP_STAGE0=17.7K 86.4/87.7 → 75.6/77.1(−12%) 5 --max-context 65536省显存4,351 → 4,414(+63),67,409 token 请求被拒 6 --max-context 262144日常用槽位 −11%、解码 −6%  ️ 分场景
7 --kv-grow+--kv-resident同开语义冲突,只能二选一 8 期待 --adapt-async在双卡生效层拆分下引擎直接关闭(日志有说明) 9 pkill -f strata模式匹配到执行它的 shell,SSH 一起断 【5. 真实负载统计(273 个请求)】
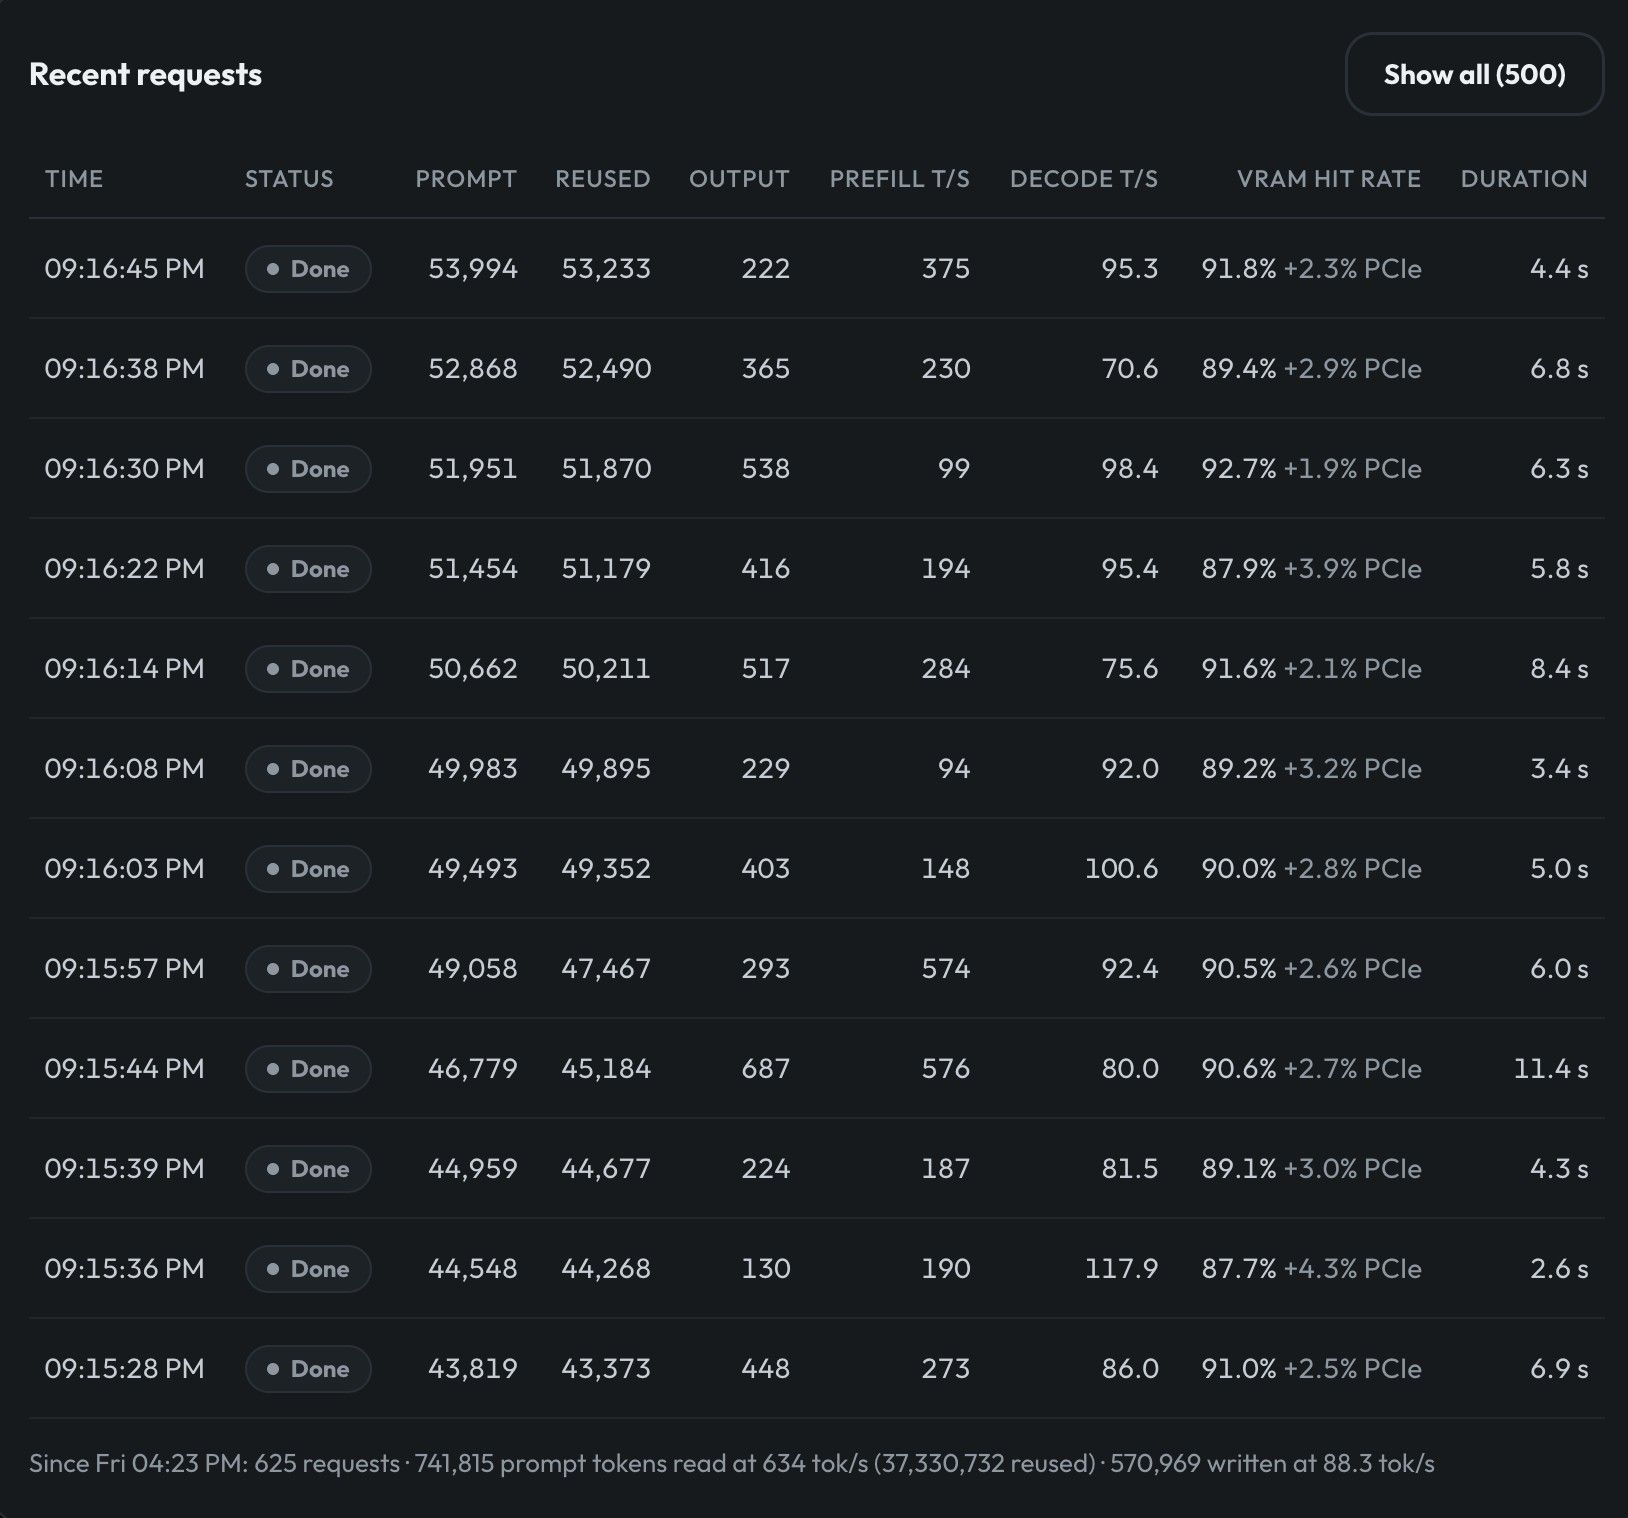
指标 值 请求数 / 时长 273 / 1 小时 46 分 prompt tokens 16.1 M 前缀复用 97.8%(15.7 M) 平均 prompt / 输出 58.9 K / 1.1 K 持续 decode 88.8 tok/s 草稿接受率 68.9% 生成时 GPU 功耗 232 W(两卡合计) 每 token 能耗 ≈ 2.6 J ★ 平均 59K 的上下文还能跑 89 tok/s,靠的是 97.8% 前缀复用——真正需要 prefill 的只有 35 万 token。没有会话缓存,这台机器会被 prefill 拖死。
三、横向对比与差异分析
【与论坛 (2× V100 16G / IQ3_S)的横向参照】
项目 V100 ×2 本机:5060 Ti ×2 模型 / 量化 IQ3_S IQ3_S-abliterated 引擎版本 0.1.44.1 0.1.48.1 解码(常规问答) 73.5–79.6 tok/s 89.3–105.6 tok/s(热缓存);copy 中位 152.5 100K 级 Prefill 1,884(100K)/ 1,666(200K) 未测 100K;30.5K 为 2,516 上下文 128K(测到 200K) 128K(可开 256K) 显存 / 卡 16 GB ×2,PHB 无 NVLink 16 GB ×2,PHB 无 NVLink PCIe 3.0 x16(实测 12 GB/s) 4.0 x8(理论 15.75 GB/s) 功耗 — 232 W 口径不同:本机是热缓存、对方未注明;引擎差 4 个小版本;对方测到 200K,本机没测 100K 冷 Prefill。只能当量级参照,不能当胜负。
【+55% 里,有多少是卡的功劳】
单卡留有一条历史 copy 记录:98.4 tok/s(4,351 槽、未开 pipeline / profile、提示长度未记录)。今天双卡同任务中位 152.5,相差 +55%。
这 55% 混着三样东西:第二张卡、
--pipeline-windows 2、学习型 profile。后两项在 2.3K 真实提示上分别测到 10–40% 和约 15%,但那是另一组提示,不能直接搬来做减法。所以正文只写「同任务整体 +55%」,不写「加卡 +55%」——这不是谦虚,是口径。
【为什么加卡换不来翻倍:一个 token 要过两张卡】
- decode 是逐 token 串行的:token 依次过卡 0 的层、交接、卡 1 的层,加卡不缩短关键路径,只多一次 hand-off。
- 真正的瓶颈是"专家在不在显存里"。8 GB 常驻 629 个(约 2.6%),16 GB 5,659 个(23%),双卡 9,183 个(37%);命中率从个位数级别爬到 75–80%,再到 95%。
- 卡内带宽 448 GB/s,PCIe 4.0 x8 只有 15.75 GB/s,差 28 倍——"少走一次 PCIe"比"多一张卡算"值钱。
- 所以加卡真正兑现的地方是长上下文:30.5K 冷 Prefill 2,516 tok/s,50–60K 上下文仍能跑 89–105 tok/s。
【为什么短提示 Prefill 反而下降】
层拆分下,每个 8K chunk 都要跨卡交接一次;单卡时那个 +5.5% 的
--adapt-async在层拆分下被引擎直接关掉。prefill_stages=2是流水不是并行——短提示只有一两个 chunk,流水填不满,交接成本全暴露;30K 以上的 prompt chunk 多,流水跑起来,反而能到 2,516 tok/s。【为什么 256K 只掉 6% 解码,却不建议日常开】
256K 的 KV 从 1.68 GB 涨到 3.35 GB,槽位 9,183 → 8,138(−11%),解码 89.3 → 83.6(−6%)。单看数字不亏,但 6 GiB 会话缓存只放得下 1 个长会话,日常切对话会频繁重建前缀。除非你确实要读 128K 以上的文档,否则 128K 是更划算的档位。
四、结论与心得
1. 双卡的真实价值不是速度,是"上下文不塌"
同任务整体是 98.4 → 152.5(+55%,含两项调优),但可以确定:加卡本身没有翻倍,也不该期待翻倍。真正的变化是槽位 4,351 → 8,957、命中率 75–80% → 93–97%——50–60K 上下文下仍能稳定 89–105 tok/s,这是单卡 4,351 个槽做不到的。如果你只跑短提示问答,第二张卡是性价比最差的升级;如果你的负载是 agent(平均 59K prompt),它才是从"能用"到"好用"的那一步。
2. 参数符号会翻转,任何百分比先看条件
--kv k8v4在论坛双卡 16G 的环境里是 +8~13%,在本机 sm_120 + 消费卡上是 Prefill −38%。同一个参数,换架构、换引擎小版本,符号能反过来。抄参数之前先看对方的卡型、量化、上下文长度。3. "省显存换槽位"多半是负收益
64K 试验只多 63 个槽(+1.4%),代价是一个 67K 文档读不了;
--vram-reserve-mib 1024掉 100 个槽,但换来显存不被打满——前者是亏,后者是买保险,别把两者混为一谈。4. 适用与不适用
- 适合:单机跑 125B 级 MoE、要 100K+ 上下文、要给 agent 当后端(前缀复用率高)、电费敏感(2.6 J/token)。
- ️ 勉强:想要 256K(能开,但会话缓存吃紧)、想要视觉(16 GB 下图像编码器走 CPU,每张几秒)。
- 不适合:只追求短提示峰值、指望加卡翻倍、显存 <24 GB 还想上 125B、想上 NVFP4(92 GB 内存太紧,约需 80 GB 权重常驻)。
数据说明:受控基准为单次或 2–4 次采样,decode 对草稿接受率极其敏感(同一配置 28~65 tok/s 都出现过),所以正文只用 copy 任务和标注过热缓存的数字;「—」表示未测,不是 0。真实负载数据来自 2026-10-23 的
/metrics聚合。单卡只有一条历史 copy 记录(提示长度未记录),双卡为今日补测,调优状态不同,所以凡涉及"加卡快多少"的地方只给整体口径,不拆到卡上。另附一张实际跑一个小项目的实况截图以供参考。真实体感是双卡比单卡爽太多了,跑任务速度肉眼提升!