英特尔Arc B60 24G显卡,还能怎么提升他的token速度呢?
-
-
-
-
不要用这个模型写小说。写出来的东西≈泔水。 至于优化,这个速度差不多就是极限了。只能靠MTP等技术来提高。
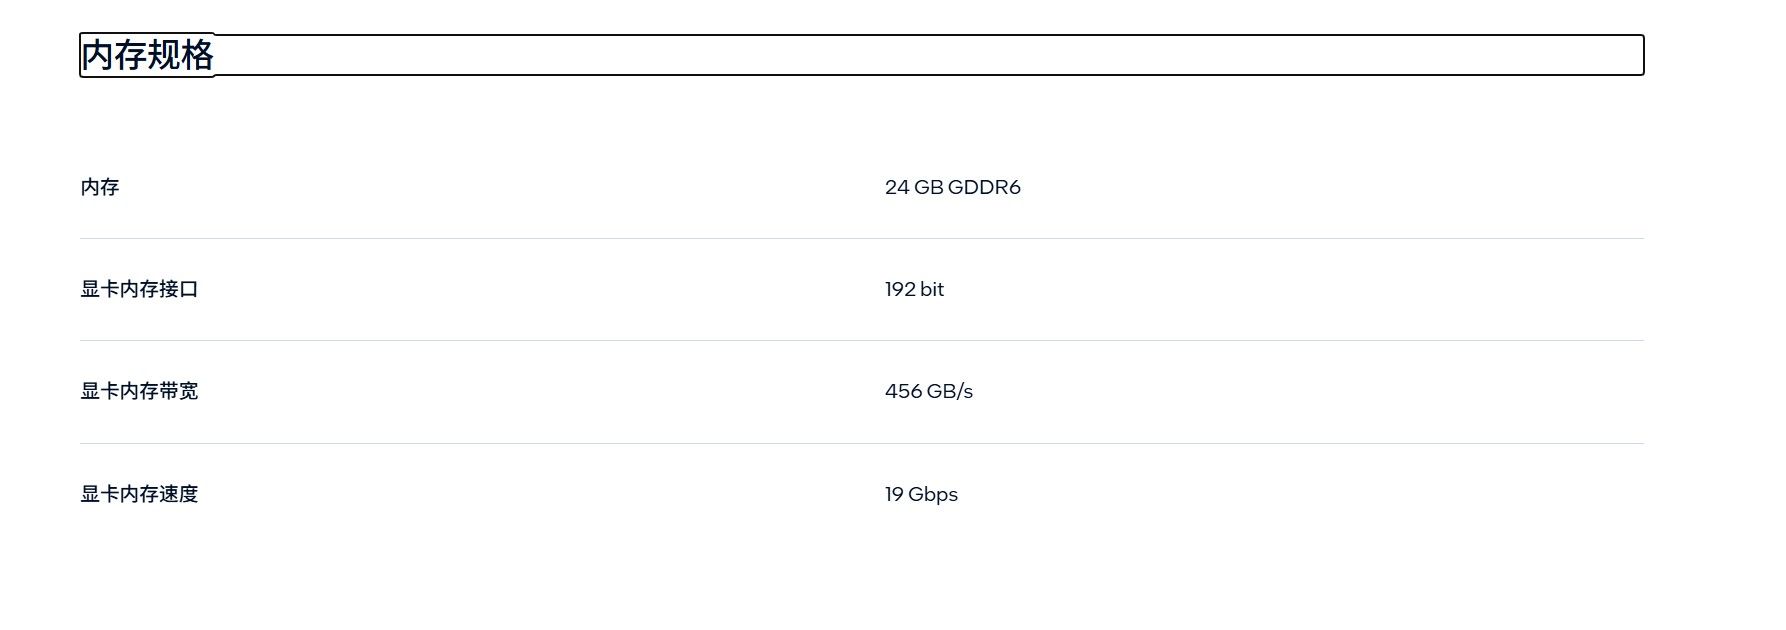
速度计算公式=显卡内存带宽/稠密模型体积。
456/27 = 16.9 token/s
-
-
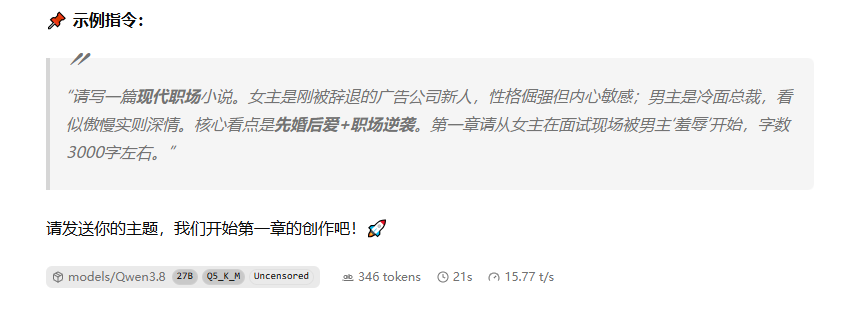
处理器I5-14400F,内存3600 64G,显卡英特尔Arc B60 24G。
主要是用来本地写小说的,用的模型是Qwen 3.8 27B Q5KM和Q4KM,上下文32K。
刚开始还有16token/s,速度其实还能接受,只是上下文长了速度越来越慢,最多掉到6token/s,Q4比Q5还要慢一点。
有没有什么办法能提升他的速度,或者保持不要掉的那么多呢。
目前用的是WINDOWS系统,用LINUX系统会好一点吗? -
16 t/s 基本摸到 B60 的带宽上限了:456 GB/s ÷ 27B Q4 的约 16GB ≈ 28 t/s(纯权重、零开销),你还有余量但不多。掉到 6 t/s 不是算力问题,是 32K 上下文的 KV 每生成一个 token 都要重读一遍。
能救回一部分的做法:
-ngl 99确认模型全在显存,看任务管理器里共享显存有没有被吃;- KV 量化:
--cache-type-k q8_0 --cache-type-v q8_0,32K 能省掉约一半 KV 占用; - 开 flash-attn(看你用的 SYCL/Vulkan 后端版本是否支持);
- 写小说不必常驻 32K,降到 8K–16K,长文用分段摘要接续;
- Q5 换 Q4_K_M,权重再省约 3GB,速度会比 Q5 明显好。
Linux 有帮助,但主要是 SYCL/oneAPI 驱动栈更完整,通常 10–30%,不会把 6 变 16。装 oneAPI 后用
sycl-ls确认认卡,llama.cpp 编 SYCL 后端;不想折腾就先拿 Vulkan 后端做对比。想要质变只能换带宽更高的卡(>1TB/s),或者上 MoE + MTP。 -
-
-
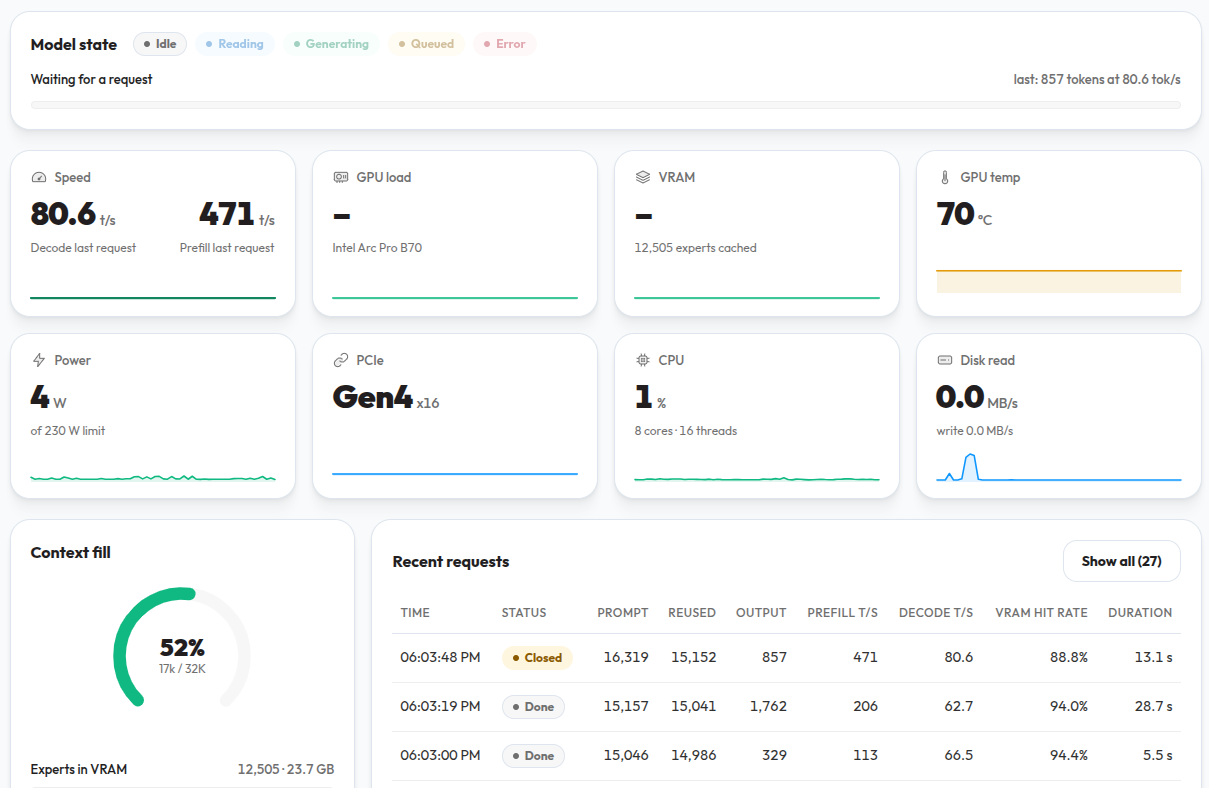
要不要用 strata 試試看, 參考如下:
gpu: arc b70 pro
cpu: i7-11700
ram: 128gb DDR4
os: linux lite 8.0
driver 用 intel omix 0.4.1 版
https://dgpu-docs.intel.com/overview/release-notes/OMIX.html執行 IQ3_S 平均約有 60 ~ 70 t/s