Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next
-
-
**【實測更新】Strata v0.1.45 + IQ4_XS — 雙卡 RTX5070 Ti
剛跑完雙卡 RTX 5070 Ti,同一套四情境測法(各生成 1,200 tokens × 3 輪取平均),數據更新如下:
雙卡 RTX 5070 Ti 16G Decode:
解題 : 113.7 tok/s
Coding: 106.7 tok/s
英文寫作 : 117.3 tok/s(單輪最高衝到 136.3)
中文寫作 : 108.7 tok/s平台規格 :
目標模型 :Qwen3.8-Flash-Next-Uncensored.i1-IQ4_XS
推理引擎 :Strata v0.1.45
Context : 256 K
CPU : i9-9900K|RAM : DDR4 128GB|PCIe : PCIe 3.0 x8 + x8(無 NVLink,雙卡 tensor split 1,1)小結:
- 跟樓主 v0.1.31 的數據對照,同測法下 IQ4_XS+v0.1.45 基本持平略勝(英文寫作單輪有摸到 136)。
- 所有調優都試過,速度一直上不去,我判斷卡在 PCIe 3.0,測試只有跑6.8G——IQ4_XS 權重單張 16G 裝不下必須雙卡,每層 decode activation 都要走 PCIe 交換,x8+x8 頻寬再砍半。量化已經換到帶了,瓶頸就轉移到總線。同場雙卡玩家若能單卡裝下,試試單卡模式對照就知道差在哪。
-
我還是老樣子,strata 跑在windows 測試是用同一台主機中的vm虛擬主機,跑ubuntu,pcie掉速可能只讀需要的專家吧,我將模型整個放在RAM中,還是有一點點會掉到SSD,我只有一台電腦只能全在這台跑。
下面跑的是我測試,不會突然掉速的限制VRAM餘量,吃光有時後會掉速,因該是WINDOWS分頁的問題。
目前兩張顯卡(2× RTX 5070 Ti 16GB)在目前執行的 [strata-uncensored-iq4_xs.json]設定下的即時顯存與專家配置如下:
一、駐留專家數量(Resident Experts)
設備 負責層數 專家槽位數 專家佔用顯存 GPU 0 (CUDA0) Layers 0–23 4,244 個 10.52 GiB GPU 1 (CUDA1) Layers 24–47 4,159 個 10.31 GiB 雙卡合計 全 48 層 8,403 個 20.83 GiB 全模型共 24,576 個專家,雙卡總共長駐 8,403 個高頻專家(佔比 34.2%),在最新推論時解碼專家快取命中率維持在 90.4% ~ 94.2%。
二、兩張顯卡剩餘顯存(Free VRAM)
1. Strata 引擎模型載入後基準剩餘(目標 500~550 MiB)
- GPU 0:537 MiB(完美落在 500~550 MiB 區間)
- GPU 1:517 MiB(完美落在 500~550 MiB 區間)
2. nvidia-smi 即時實體顯存監控(含動態工作緩衝區釋放後)
- GPU 0:已用 14,847 MiB / 剩餘 1,149 MiB(溫度 36°C)
- GPU 1:已用 14,780 MiB / 剩餘 1,216 MiB(溫度 33°C)
雙卡均穩定維持在 500 MiB 安全邊際以上,無任何 WDDM 記憶體分頁延遲,運行表現最佳。
-
-
將模型整個放在RAM中,還是有一點點會掉到SSD
Strata 三種 --ple-io 模式 — direct(放SSD)/mmap(隨機調整)/ram(只放ram)
我今天再做了一次測試,Agent的分析是
除非SSD的速度很慢, 否則PLE/n-gram放在SSD和RAM中 速度上沒有差異
而且PLE/n-gram放在 SSD中 讀取也不會減少SSD的使用壽命,好處是可以節省RAM的壓力我暫時相信Agent的說法 哈
本來全放RAM的,我昨天也有測試,我改為direct放SSD了,速度差異0.x%,反而全放RAM有時後掉一點到SSD會破碎反而慢1~2x%,不能把RAM用到爆

不在家我會把其它軟體關掉,專家大該8600~8700左右。
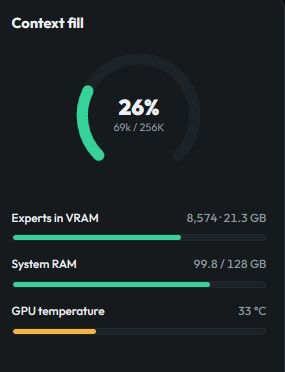
更新Strata 0.2.2(0.1.47 核心)+ CUDA 13.4.3 + Blackwell sm_120
四情境測速結果(qwen3.8-flash-next-uncensored-iq4_xs @ n_ctx 262K)
情境 R1 R2 R3 平均 解題 107.0 130.9 104.7 114.2 tok/s Coding 122.2 124.8 108.5 118.5 tok/s 英文寫作 121.2 123.2 111.1 118.5 tok/s 中文寫作 117.5 109.5 111.9 113.0 tok/s  解讀:
- 四情境平均全數突破 110,單輪最高 130.9——比 16K 標準基準的穩態(94~107)還高一截。原因:四情境 prompt 短、TTFT 只有 3~6 秒,Decode 段幾乎全程跑熱機穩態,這正是論壇「最高值」口徑的由來。
- Coding/英文寫作最快、解題與中文寫作略慢,屬正常的輸出內容差異,非硬體問題。
-
本來全放RAM的,我昨天也有測試,我改為direct放SSD了,速度差異0.x%,反而全放RAM有時後掉一點到SSD會破碎反而慢1~2x%,不能把RAM用到爆
不在家我會把其它軟體關掉,專家大該8600~8700左右。
更新Strata 0.2.2(0.1.47 核心)+ CUDA 13.4.3 + Blackwell sm_120
四情境測速結果(qwen3.8-flash-next-uncensored-iq4_xs @ n_ctx 262K)
情境 R1 R2 R3 平均 解題 107.0 130.9 104.7 114.2 tok/s Coding 122.2 124.8 108.5 118.5 tok/s 英文寫作 121.2 123.2 111.1 118.5 tok/s 中文寫作 117.5 109.5 111.9 113.0 tok/s 解讀:- 四情境平均全數突破 110,單輪最高 130.9——比 16K 標準基準的穩態(94~107)還高一截。原因:四情境 prompt 短、TTFT 只有 3~6 秒,Decode 段幾乎全程跑熱機穩態,這正是論壇「最高值」口徑的由來。
- Coding/英文寫作最快、解題與中文寫作略慢,屬正常的輸出內容差異,非硬體問題。
-
-
我讓 小秘書 幫我把對STRATA優化的找出來!!
還有今天更新 Strata v0.2.3(Engine 0.1.48)反而慢了一點點 1~3 tok/s,有空就微調一下,慢慢把 tok/s升上來,但測試跑到 * 110多 tok/s** 正常使用下,我看STRATA終端沒有那麼高的速度~~
我下載 Qwen3.8-Flash-Next-Uncensored.i1-IQ4_XS.gguf(95.2GB) expert-profile-learned.bin(另外重對齊出來)
分享我們雙卡 5070 Ti 的「全棧深度優化矩陣」(含 Strata 本地重編譯),看怎麼在 PCIe 3.0 x8 的劣勢拓撲下榨出 105~110+ tok/s、峰值 136 tok/s。
1. 底層重編譯:Blackwell sm_120 原生優化
官方預編譯二進位檔通常兼顧通用性。我們升級至 Strata v0.2.3(Engine 0.1.48)後改用 MSVC 2026 + CUDA 13.4 + Ninja 本地重編譯,明確針對 RTX 5070 Ti 的 Blackwell 架構開 -arch=sm_120,把新世代 Tensor Core 與 MTP 專用加速管線完整啟用,解碼 Kernel 呼叫延遲下降一點。2. 拓撲切分(Dual-Card Balanced Split)
--layer-split 24:GPU 0 承載第 0~23 層 dense 權重+4,311 個專家槽(約 10.7 GB);GPU 1 承載第 24~47 層+MTP 草稿頭+4,261 個專家槽(約 10.6 GB)。雙卡顯存與計算負載幾乎完美 1:1,杜絕單卡撞 OOM。3. 自適應專家快取調校(突破 PCIe 瓶頸的核心!)
--adapt-every 1 --adapt-async 1 --adapt-swaps 80 --adapt-decay 0.97。雙卡 VRAM 共容納約 8,572 對專家(約 21.3 GB),其餘 13GB 放記憶體,實測顯存專家快取命中率 98.5%。
震撼對比:今天把 adapt 關掉,命中率掉到 56%,解碼瞬間從 104 tok/s 腰斬到 46.58 tok/s;恢復非同步動態換頁立即滿血回到 105~110。4. MTP 投機解碼
--spec 4 --spec-min-p 0.8 --mtp rt。程式碼與邏輯運算上草稿頭接受率 75~80%,直接突破單 token 解碼的理論吞吐極限。5. 系統與記憶體防抖動
STRATA_ARENA_PIN_GIB=24+STRATA_RESIDENT_PIN=1:24GB 專家池鎖在實體記憶體(Page-locked),杜絕 Windows 頁面調度的微卡頓;--ple-io direct讓 3.2 億行 PLE 嵌入表直接走 SSD direct I/O,不侵佔 RAM。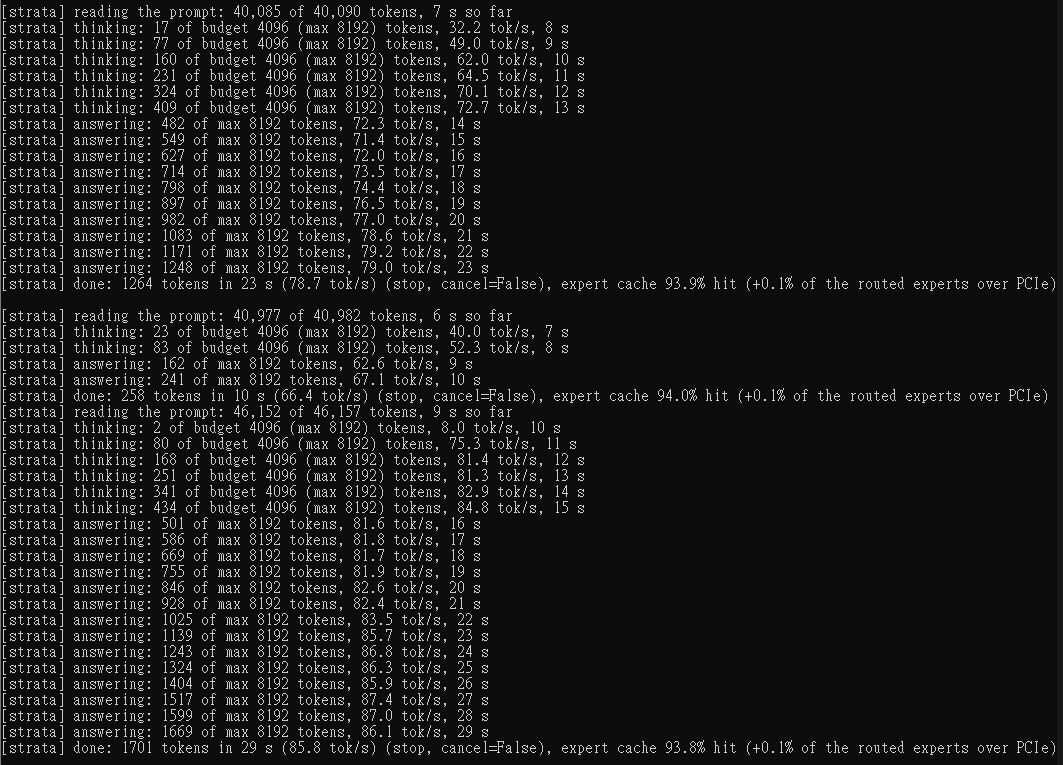
-
-