跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. MAC Studio Ultra 96GB 甜点小主机到货,用起来很爽

MAC Studio Ultra 96GB 甜点小主机到货,用起来很爽

已定时 已固定 已锁定 已移动 AI硬件
apple-m5mac本地模型
1 交叉发布 16 帖子 8 发布者 612 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • fanweng-codeF
    fanweng-codeF
    fanweng-code
    体面乡绅
    编写于 最后由 编辑
    #3

    4bit量化,decode只有80t/s的話怪怪的
    prefill也是偏慢,要找看看設定問題還是runtime問題
    我的M5 ultra也剛到還沒測試,但M5 Max使用4-8bit混合量化decode有85t/s
    ultra應該至少要有1.5倍

    tester12340T 1 条回复 最后回复
    0
    • fanweng-codeF fanweng-code

      4bit量化,decode只有80t/s的話怪怪的
      prefill也是偏慢,要找看看設定問題還是runtime問題
      我的M5 ultra也剛到還沒測試,但M5 Max使用4-8bit混合量化decode有85t/s
      ultra應該至少要有1.5倍

      tester12340T
      tester12340T
      tester12340
      体面乡绅 硕果累累
      编写于 最后由 编辑
      #4

      @fanweng-code

      啊,还能更快吗 说实话现在的速度 我觉得都飞快。

      请问兄弟用的是 omlx 吗? strara 的确是可以更快,但只支持但session。

      fanweng-codeF 1 条回复 最后回复
      0
      • tester12340T tester12340

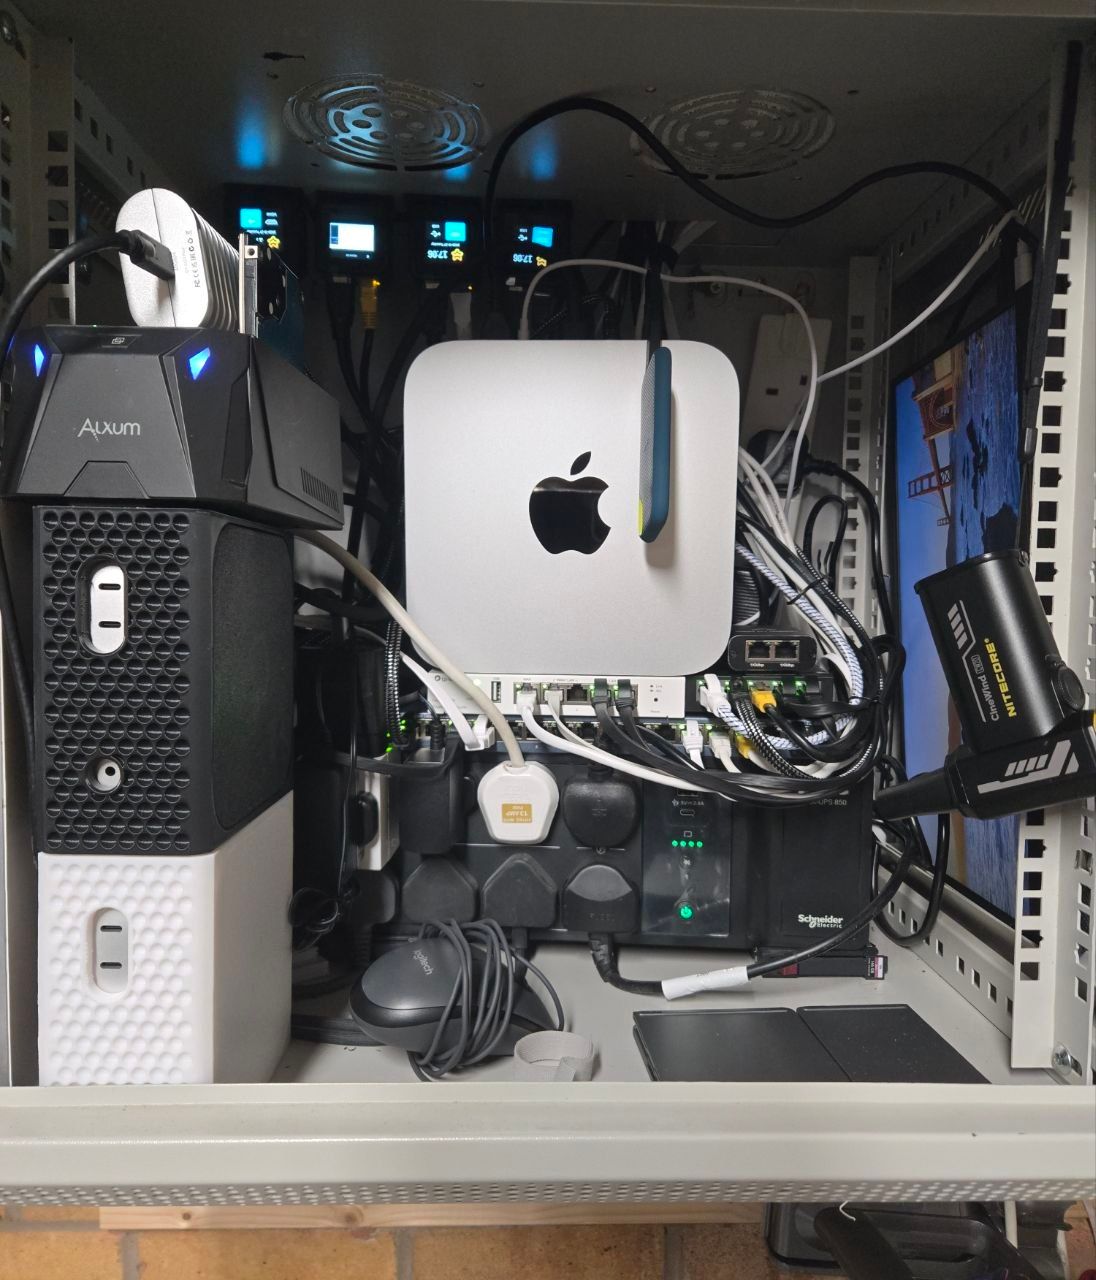
        IMAGE 2026-10-27 12:26:36.jpg

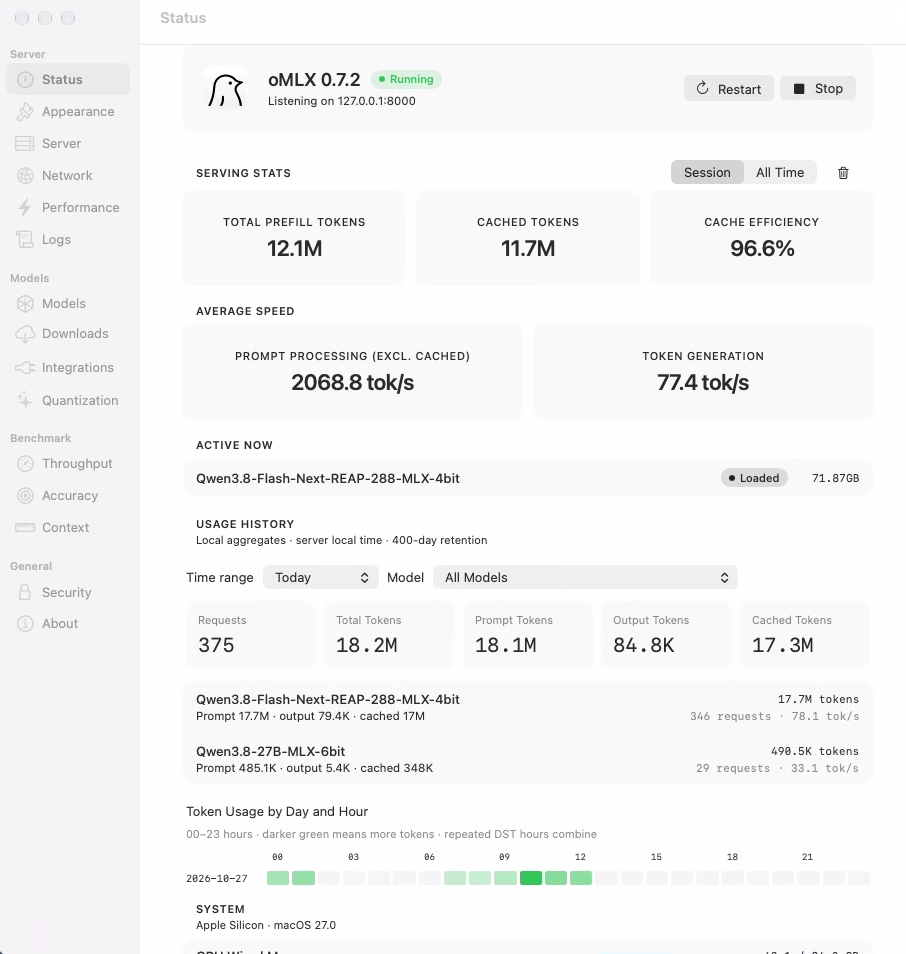
        Screenshot 2026-10-27 at 12.28.34.png

        最近在 Mac Studio M5 Ultra(96GB 统一内存)上折腾本地大模型,主要运行 Qwen3.8-Flash-Next-REAP-288-MLX-4bit,模型约 71.87GB,搭配 oMLX 0.7.2,为 !Hermes Agent 提供本地推理服务。

        目前实测表现还不错。oMLX 的生成速度在不同任务中达到过约 80 tokens/s,Prefill 速度约 1580–2450 tokens/s,累计缓存效率超过 90%。对于大型 MoE 模型来说,这个表现已经比较满意。

        Stara 速度可以跑到 130每秒,但模型是 3bit了,而且不能同时跑多session,所以直接放弃。

        最爽的是 长上下文和多会话的生产环境。我的目标是 至少128K 上下文,同时运行至少三个 Hermes 会话。如果每次请求都重新 Prefill,大量系统提示词、工具定义和对话历史就会被反复处理,影响响应速度。因此,Prefix Cache 和 KV Cache 的复用比单纯追求更高的 tokens/s 更重要。

        内存方面,开启 oMLX 的 SSD N-gram Offload 后,界面显示的 System RAM 使用量明显下降。不过,这项功能主要用于减少 N-gram 表的常驻内存,并不等于解决了所有 KV Cache 问题。此前测试还遇到过 128K Prefill 预计峰值超过当前内存限制的提示,所以三个会话能否稳定运行,仍需要进一步确认。 随着软件的进化 内存的消耗转化到高速硬盘上。

        我也尝试了 Splash 1.4.1,但目前主观上感觉开启与关闭的性能差异不明显。

        总体来说,M5 Ultra 跑这个模型的单请求性能不错,96GB 内存也有一定空间。作为一个长期稳定的多对话session 支持长上下文的小主机,我认为是个非常不错的选择!
        johnnybegoodJ
        johnnybegoodJ
        johnnybegood
        王侯将相
        编写于 最后由 编辑
        #5

        @tester12340 这么好的机器别只跑大模型, 可以发挥他更大作用的地方很多呢, 别辜负了那么贵的东西

        tester12340T 1 条回复 最后回复
        0
        • johnnybegoodJ johnnybegood

          @tester12340 这么好的机器别只跑大模型, 可以发挥他更大作用的地方很多呢, 别辜负了那么贵的东西

          tester12340T
          tester12340T
          tester12340
          体面乡绅 硕果累累
          编写于 最后由 编辑
          #6

          @johnnybegood 是啊,感谢兄弟。 不过这个我就想跑大模型。 安静省电,主要做内部数据处理用。

          1 条回复 最后回复
          0
          • tester12340T tester12340

            @fanweng-code

            啊,还能更快吗 说实话现在的速度 我觉得都飞快。

            请问兄弟用的是 omlx 吗? strara 的确是可以更快,但只支持但session。

            fanweng-codeF
            fanweng-codeF
            fanweng-code
            体面乡绅
            编写于 最后由 编辑
            #7

            @tester12340

            https://lcz.me/post/21976
            我目前正在用的模型(無審查)還有runtime
            平均有85t/s,MTP命中高的任務可到150t/s

            新到的ultra要等我過幾天比較有時間才能測

            1 条回复 最后回复
            0
            • tester12340T
              tester12340T
              tester12340
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #8

              mlx-serve 下载中

              1 条回复 最后回复
              0
              • 懒人烘培懒
                懒人烘培懒
                懒人烘培
                王侯将相
                编写于 最后由 编辑
                #9

                这个设备老安静了,就是价格也很好:)

                双 7900 XTX:模型本地跑,Token 随便烧!

                1 条回复 最后回复
                0
                • tester12340T
                  tester12340T
                  tester12340
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #10

                  @懒人烘培 是的,这个怎么比mac mini 还安静, 跟mac book pro 和 air 一样安静。 我怀疑是不是没有风扇?

                  1 条回复 最后回复
                  0
                  • tester12340T
                    tester12340T
                    tester12340
                    体面乡绅 硕果累累
                    编写于 最后由 编辑
                    #11

                    我试跑了一下,主要两个问题不行。 一个是多线程的切换感觉慢了很多。 另外就是内存管理也差了很多

                    我现在跑的这个 Qwen3.8-Flash-Next-REAP-288-MLX-4bit 就用 40gb 内存。 我接下来换一个带mtp的 只有 50gb的 4bit flash next 试试看

                    fanweng-codeF 1 条回复 最后回复
                    0
                    • terryT
                      terryT
                      terry
                      易有太极
                      编写于 最后由 编辑
                      #12

                      卧槽这个机箱....牛逼,可以发装备秀了😂

                      油管:https://www.youtube.com/@抡锤者

                      1 条回复 最后回复
                      1
                      • tester12340T tester12340

                        我试跑了一下,主要两个问题不行。 一个是多线程的切换感觉慢了很多。 另外就是内存管理也差了很多

                        我现在跑的这个 Qwen3.8-Flash-Next-REAP-288-MLX-4bit 就用 40gb 内存。 我接下来换一个带mtp的 只有 50gb的 4bit flash next 试试看

                        fanweng-codeF
                        fanweng-codeF
                        fanweng-code
                        体面乡绅
                        编写于 最后由 编辑
                        #13

                        @tester12340
                        可能96G有點吃緊

                        1 条回复 最后回复
                        0
                        • tester12340T
                          tester12340T
                          tester12340
                          体面乡绅 硕果累累
                          编写于 最后由 编辑
                          #14

                          现在调优 3.8 flash next 4bit后 已经平均到 140 tos/s 开了 8个 256k上下文。 内存还有 20gb 结余.

                          感谢各位提点,否则真不知道还有这么多潜力。

                          1 条回复 最后回复
                          2
                          • 胡一桶胡
                            胡一桶胡
                            胡一桶
                            编写于 最后由 编辑
                            #15

                            请问您购买的是:64 核图形处理器 还是 36 核中央处理器,80 核图形处理器

                            1 条回复 最后回复
                            0
                            • tester12340T tester12340

                              IMAGE 2026-10-27 12:26:36.jpg

                              Screenshot 2026-10-27 at 12.28.34.png

                              最近在 Mac Studio M5 Ultra(96GB 统一内存)上折腾本地大模型,主要运行 Qwen3.8-Flash-Next-REAP-288-MLX-4bit,模型约 71.87GB,搭配 oMLX 0.7.2,为 !Hermes Agent 提供本地推理服务。

                              目前实测表现还不错。oMLX 的生成速度在不同任务中达到过约 80 tokens/s,Prefill 速度约 1580–2450 tokens/s,累计缓存效率超过 90%。对于大型 MoE 模型来说,这个表现已经比较满意。

                              Stara 速度可以跑到 130每秒,但模型是 3bit了,而且不能同时跑多session,所以直接放弃。

                              最爽的是 长上下文和多会话的生产环境。我的目标是 至少128K 上下文,同时运行至少三个 Hermes 会话。如果每次请求都重新 Prefill,大量系统提示词、工具定义和对话历史就会被反复处理,影响响应速度。因此,Prefix Cache 和 KV Cache 的复用比单纯追求更高的 tokens/s 更重要。

                              内存方面,开启 oMLX 的 SSD N-gram Offload 后,界面显示的 System RAM 使用量明显下降。不过,这项功能主要用于减少 N-gram 表的常驻内存,并不等于解决了所有 KV Cache 问题。此前测试还遇到过 128K Prefill 预计峰值超过当前内存限制的提示,所以三个会话能否稳定运行,仍需要进一步确认。 随着软件的进化 内存的消耗转化到高速硬盘上。

                              我也尝试了 Splash 1.4.1,但目前主观上感觉开启与关闭的性能差异不明显。

                              总体来说,M5 Ultra 跑这个模型的单请求性能不错,96GB 内存也有一定空间。作为一个长期稳定的多对话session 支持长上下文的小主机,我认为是个非常不错的选择!

                              xiongjie gaoX
                              xiongjie gaoX
                              xiongjie gao
                              王侯将相
                              编写于 最后由 编辑
                              #16

                              @tester12340 说:

                              IMAGE 2026-10-27 12:26:36.jpg

                              这机箱看着小乱但有种极客感~赞

                              https://github.com/shawn86574-prog/x99-7900xtx-p2p
                              https://github.com/shawn86574-prog/kuzuryusen

                              1 条回复 最后回复
                              0

                              你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                              厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                              有了你的建议,这篇帖子会更精彩哦 💗

                              注册 登录
                              回复
                              • 在新帖中回复
                              登录后回复
                              • 从旧到新
                              • 从新到旧
                              • 最多赞同


                              • 登录

                              • 登录或注册以进行搜索。
                              • 第一个帖子
                                最后一个帖子
                              0
                              • 版块
                              • 最新
                              • 标签
                              • 热门
                              • 用户
                              • 群组