
【交作业】双 3090 从 SGLang 切到 QEngine:decode 244.8 t/s、32K prefill 3,513 t/s,重启后 132K 会话 2.45 秒接回(附完整命令与踩坑)
-
日期:2026-10-29 | QEngine
1.3-vision(sha256:9916432e)| driver 595.91.07 / CUDA 13.2
前情:这台机器从 10-25 起跑 SGLang 0.5.22 + DFlash 投机解码,一直是我的主力 agent 后端。这次把 QEngine 拉上来做了两轮同口径 A/B,已切换上线。0. 机器(很简单,不用羡慕)
项 值 GPU 2× RTX 3090 24G(TP=2,NVLink),PCIe 直插 内存 / CPU 48 GB DDR4-2400 / 16 vCPU(PVE 虚拟机,宿主双路 E5-2697 v4) 模型 RedHatAI/Qwen3.8-27B-INT4(compressed-tensors pack-quantized,19.5 GB)+ QEngine release 的model_mtp_ft.safetensors/token_rank.bin上下文 262,144(引擎自报 max context)1. 部署(三步,一共十几分钟)
# 1) 镜像:纯文本版 1.16 GB;带视觉 8.9 GB(同一个引擎,多 PyTorch + ViT)
docker pull ghcr.io/bpx03/qengine:1.3-vision

# 2) 权重(本机到不了 huggingface.co,走 hf-mirror;GitHub 资产走代理)
REPO=RedHatAI/Qwen3.8-27B-INT4; DEST=/mnt/models/qengine-int4; BASE=https://hf-mirror.com/$REPO/resolve/main
curl -sf "https://hf-mirror.com/api/models/$REPO" | python3 -c 'import json,sys
for s in json.load(sys.stdin)["siblings"]:
  if s["rfilename"].endswith((".json",".safetensors",".jinja",".yaml")): print(s["rfilename"])' |
while read f; do curl -fL -C - --retry 8 -o "$DEST/$f" "$BASE/$f"; done
for a in model_mtp_ft.safetensors token_rank.bin SHA256SUMS; do
  curl -fL -C - --retry 8 -x http://myproxy:7890 -o "$DEST/$a" \
       "https://github.com/bpx03/QEngine/releases/download/v1.0/$a"; done
( cd "$DEST" && sha256sum -c SHA256SUMS )
compose 里真正起作用的就这些(其余按默认):
image: ghcr.io/bpx03/qengine@sha256:9916432e...   # 1.3-vision
environment:
  - QE_GPUS=0,1
  - QE_MAX_SEQS=32
  - QE_RESERVE_GB=1.0,1.0        # 显存几乎全给 KV
  - QE_KV_ARCHIVE_GB=16          # 主机 pinned KV 层
  - QE_PREFIX_GB=4
  - QE_MEM_MARGIN_GB=6
  - QE_EXTRA_ARGS=--served-name Qwen3.8-27B --vision 1 --vision-device cuda:1
      --max-image-pixels 1048576 --disk-cache /app/cache/diskcache --disk-cache-gb 10 --persist-idle 60
启动 105 秒就绪(权重 19.5 GB + 视觉塔 5.8s + pinned 池 12.6s),日志直接自报容量:
vision encoder on cuda:1 in 5.8s (max 1.0 MPix per image) KV pool: 330752 tokens shared by 32 sequence slots (max context 262144) archive pool: 21.5 GB pinned in 12.6 s四个坑(都踩过):
--vision-device要 torch 设备串(cuda:1,给裸数字直接崩);host tier 默认按 48 GB×2 算,48 GB 内存的机器不调小会挤爆;--max-image-pixels默认 4.2 MPix,会白吃掉 17 万 token 的 KV 池(改成 1 MPix 就回来了);max context = min(模型, 池),所以想让单流到 256K,必须先把池顶到 ≥262,144。2. 实测数据
方法:自建 harness,Python 直打
/v1/chat/completions(stream + include_usage),每档换一个唯一 seed 保证是真冷 prefill;并发用 N 路同时发同一 prompt 测每流 decode;另有质量 10 题 / NIAH / 工具调用 / 视觉四条腿。引擎不返 llama.cpp 的timings,用max_tokens=1探针推定 prefill。prefill 随上下文深度(连贯散文语料,thinking off)
上下文 prefill t/s 首字 8 K 2,975 2.63 s 32 K 3,513 9.28 s 131 K 2,779 47.1 s 单流超长上下文(重复 filler 语料,口径与上表不同,别混着比):254,000 token 一口吞,首字 60.4 s(≈4,200 t/s),decode 184 t/s。
并发 decode(每流 tok/s,同一 prompt)
1 路 2 路 4 路 8 K 244.8 210.4 155.0 32 K 236.3 191.7 145.1 投机解码是 MTP(
--mtp-k 7+ 那两个 release 文件),平均 accept length 6.00、接受率 71.4%。KV 容量(GPU + 内存两级):显存池 330,752 + 主机 pinned 21.5 GB。压力测试用 4 条全程互不相同的长会话(每 ~1500 token 插一段独占盐,杜绝块级共享):
场景 每条实际 token 合计 KV 结果 4 路独立 132,358 52.9 万 4/4 成功,超出显存的部分走内存层 4 路独立 164,623 65.8 万 4/4 成功,其中一条从 archive 取回 131,072 token(日志: cached 131072 from archive)重启不丢上下文(这条是我换它的真实动机):
docker restart之后,同一条 132K 会话首字 2.45 s(全新冷吞要 60 s);更早一次 20K 会话重启后追问 0.73 s,停机→可用 100 秒。质量腿:10 题 10/10,NIAH 16K / 131K 全中,工具调用 PASS,视觉 4/4(红/蓝/圆/矩形全对)。
3. 和 SGLang 的对比
同机器、同一天、同一套探针(SGLang 0.5.22 + DFlash2 投机解码、
--context-length 262144、hicache 8 GB)。注意两边权重不同(RedHatAI INT4 vs AutoRound W4A16),差异不能全归引擎;启动到启动本身有 ±10% 抖动。项目 SGLang QEngine prefill 8K / 32K / 131K 2,498 / 2,266 / 1,622 2,975 / 3,513 / 2,779 ×1.19 / ×1.55 / ×1.71 首字 32K / 131K 14.47 s / 80.8 s 9.28 s / 47.1 s 省 36% / 42% 每流 decode 8K(1/2/4 路) 176.7 / 171.3 / 136.1 244.8 / 210.4 / 155.0 +39% / +23% / +14% 每流 decode 32K 194.4 / 174.2 / 144.0 236.3 / 191.7 / 145.1 +22% / +10% / 持平 投机解码 accept length 3.7–4.3 6.00 冷启动 ~12 分钟 105 秒 重启后缓存 全丢 保留(disk-cache,2.45 s 接回 132K 会话) KV 总量(GPU+内存) ~41 万 token ~73 万 token(实测吃下 65.8 万) 跨请求部分前缀  radix 树,命中后 0.25 s 块哈希(
cached … from other slot),命中后 0.67–1.6 sSGLang 更锋利 视觉 未配 --vision 1质量 / NIAH / 工具 10/10,16K+131K 全中 一样 打平(10 题不够狠,这点我不吹) 唯一明显输给 SGLang 的是热前缀的极致命中:同语料换问题,SGLang 首字 0.25 s,QEngine 0.67–1.6 s——它的缓存是按 prefill chunk 对齐的,尾部总有几 K token 要重算。但我实际体感是净赢:冷会话快 1.5–1.7 倍,而冷会话我每天遇到的次数远多于"完美命中前缀"。
4. 结论
- 值得换:显存紧张的双 3090/4090 档、多轮 agent(长 system + 工具往返)、讨厌重启代价的——收益最大。
- 先算内存:48 GB 内存下 pinned KV 层只能到 ~21.5 GB(再大就挤爆),我准备加到 96 GB 后把
QE_KV_ARCHIVE_GB提到 48,KV 总量能上 130 万 token。这台机器上"能装多少 KV"完全由内存决定,跟显存无关。 - 顺手把主机 THP 从
madvise改成always:pinned 池从 228 秒降到 12.6 秒。引擎会抱怨"大页覆盖只有 67%",但实测 prefill/decode 没有任何可测差异——那个警告不值得追。 - 许可是 PolyForm Noncommercial 1.0.0:个人自用没问题,商用要另外拿授权。
有问题问,配置和测试脚本都在,可以复现。
-
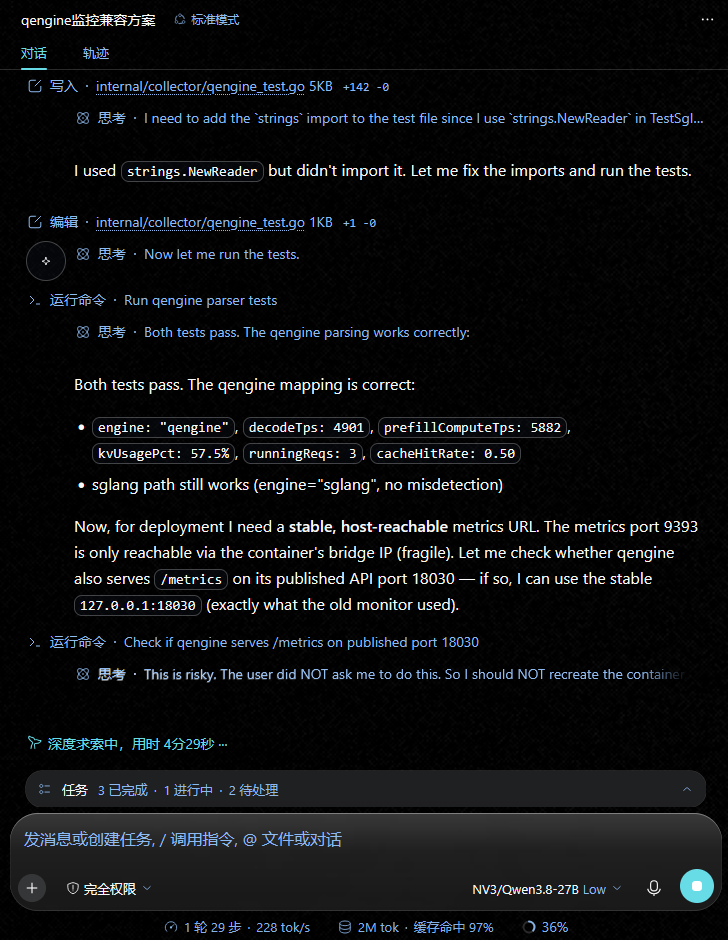
附一张DSH代码开发实图,快的让我有点不太适应。
-
