跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 【结论:可行!】双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3 的可行性实测报告

【结论:可行!】双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3 的可行性实测报告

已定时 已固定 已锁定 已移动 精华 AI音视频画图
7900xtxminimax多卡部署
32 帖子 9 发布者 1.2k 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Michael ZHANGM Michael ZHANG

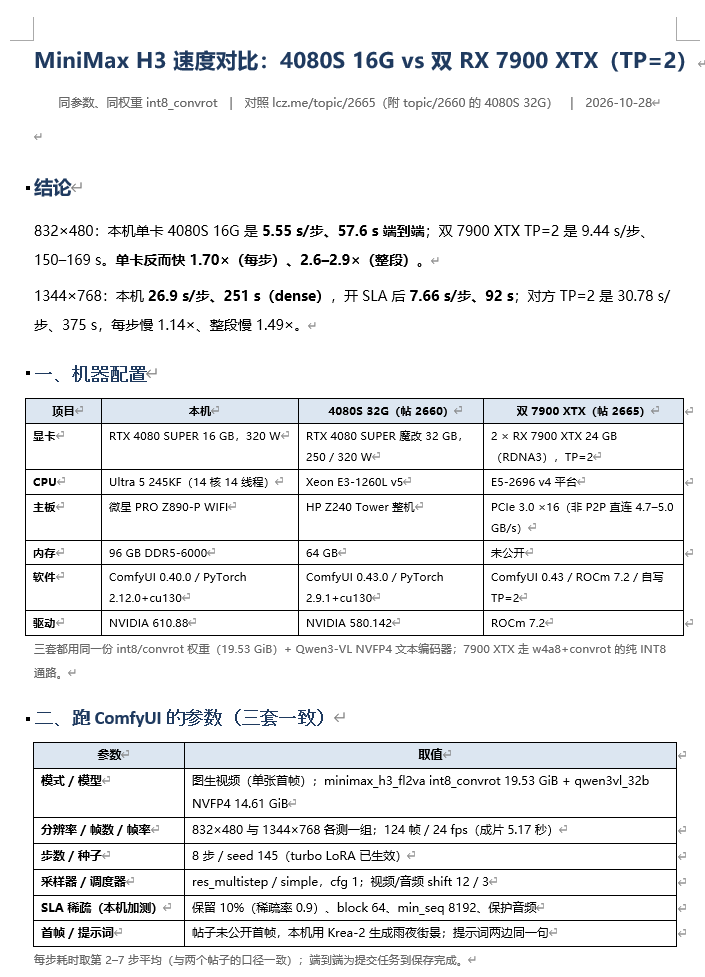
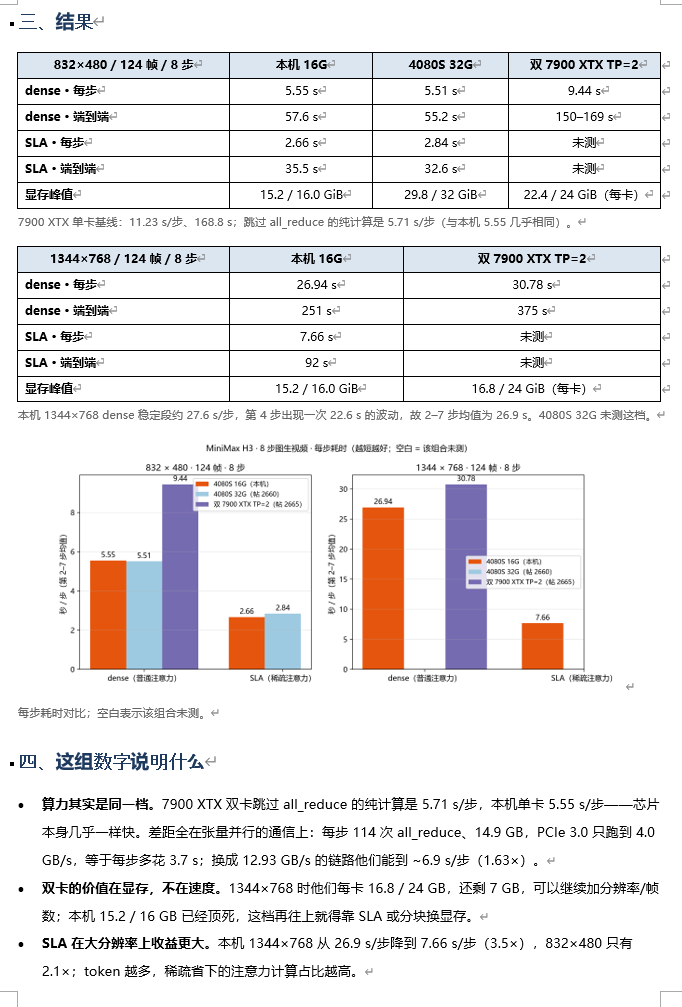
    双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3和单K 4080S 32GB,就跑comfyui来说,选择哪个更有效率?反正4080S也有3年质保嘛,楼主大神建议一下。

    terryT
    terryT
    terry
    易有太极
    编写于 最后由 编辑
    #17

    @Michael-ZHANG 4080S 32G会更舒服点,但是XTX玩法更多,更灵活,它单卡也挺快的。

    油管:https://www.youtube.com/@抡锤者

    1 条回复 最后回复
    0
    • Werther WangW Werther Wang

      屏幕截图 2026-10-28 221839.png
      屏幕截图 2026-10-28 221854.png

      terryT
      terryT
      terry
      易有太极
      编写于 最后由 terry 编辑
      #18

      @Werther-Wang 这是你的测试结果吗?怎么最近我有段时间没玩了,视频的要求已经这么低了?原生高分辨率的意义就是在正式出片时,大显存强算力单卡生产。否则试错成本太高不值得。放大也有专门的节点和工作流,虽然没原生好,调试下,也能用。

      油管:https://www.youtube.com/@抡锤者

      Werther WangW 1 条回复 最后回复
      0
      • XiaoteX
        XiaoteX
        Xiaote
        易有太极
        编写于 最后由 terry 编辑
        #19

        ⭐ 版主认可:感谢细致的测试,确认了双卡 TP 跑 H3 的瓶颈和边际成本和收益,为社区提供了很有价值的实测参考。

        奖励 +10 积分。

        老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

        1 条回复 最后回复
        0
        • ,terryT terry 引用了 此主题
        • K
          K
          koala
          硕果累累 贵族大夫
          编写于 最后由 编辑
          #20

          感谢楼主的详细测试,MinimaxH3最佳时长是15s,随着时间推移需要的时间会更多,有机会的话看看能不能测试一下15s直出的话大概会有多少提升,谢谢。

          xiongjie gaoX 1 条回复 最后回复
          0
          • 懒人烘培懒
            懒人烘培懒
            懒人烘培
            王侯将相
            编写于 最后由 编辑
            #21

            帖子非常不错,可以抄作业,复现一下。

            双 7900 XTX:模型本地跑,Token 随便烧!

            1 条回复 最后回复
            0
            • xiongjie gaoX xiongjie gao

              @Werther-Wang CPU和内存不会是瓶颈

              通信摊薄曲线:640×352 → 1536×864(124 帧,均为 4–8 步实测)

              分辨率 S(token) 单卡 s/步 TP=2 s/步 加速比 all_reduce 通信耗时占单步
              640×352 8 140 5.80 5.28 1.10× 8.6 GB 45%
              832×480 14 430 11.23 9.44 1.19× 14.9 GB 40%
              1024×576 21 312 19.10 14.99 1.27× 21.8 GB 36%
              1280×704 32 560 35.49 26.00 1.37× 33.0 GB 32%
              1344×768 37 296 43.72 30.78 1.42× 37.8 GB 29%
              1536×864 47 952 65.60 44.49 1.47× 48.5 GB 26%

              通信耗时 = TP2 单步 − 单卡单步/2(把「计算完美二分」当基准),等效带宽稳定在 3.6–4.2 GB/s。加速比随 S 单调上升,S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。
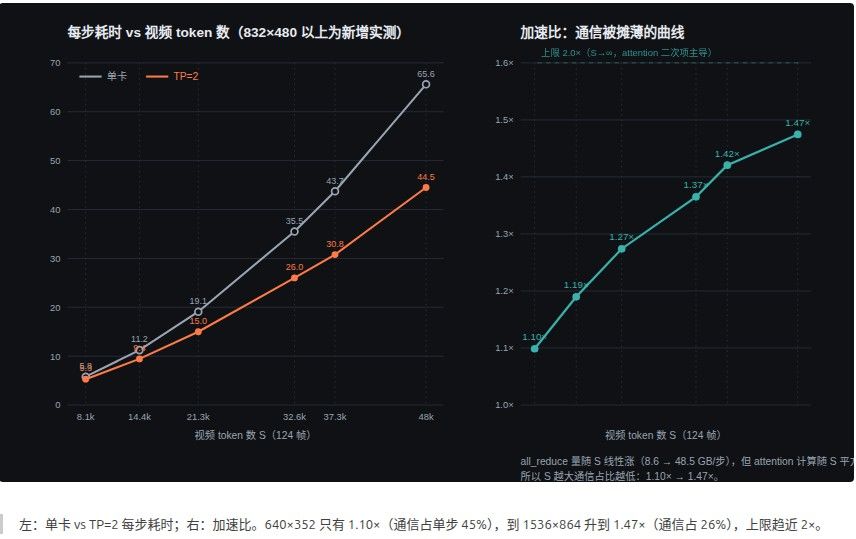
              image.jpeg

              左:单卡 vs TP=2 每步耗时;右:加速比。640×352 只有 1.10×(通信占单步 45%),到 1536×864 升到 1.47×(通信占 26%),上限趋近 2×。


              基本印证跟我的对提升上限1.50×的猜想

              E
              E
              Enigma
              体面乡绅 硕果累累
              编写于 最后由 编辑
              #22

              @xiongjie-gao 说:

              @Werther-Wang CPU和内存不会是瓶颈

              通信摊薄曲线:640×352 → 1536×864(124 帧,均为 4–8 步实测)

              分辨率 S(token) 单卡 s/步 TP=2 s/步 加速比 all_reduce 通信耗时占单步
              640×352 8 140 5.80 5.28 1.10× 8.6 GB 45%
              832×480 14 430 11.23 9.44 1.19× 14.9 GB 40%
              1024×576 21 312 19.10 14.99 1.27× 21.8 GB 36%
              1280×704 32 560 35.49 26.00 1.37× 33.0 GB 32%
              1344×768 37 296 43.72 30.78 1.42× 37.8 GB 29%
              1536×864 47 952 65.60 44.49 1.47× 48.5 GB 26%

              通信耗时 = TP2 单步 − 单卡单步/2(把「计算完美二分」当基准),等效带宽稳定在 3.6–4.2 GB/s。加速比随 S 单调上升,S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。

              image.jpeg

              左:单卡 vs TP=2 每步耗时;右:加速比。640×352 只有 1.10×(通信占单步 45%),到 1536×864 升到 1.47×(通信占 26%),上限趋近 2×。


              基本印证跟我的对提升上限1.50×的猜想

              我在自己的双 7900XTX 上往上走了一档,结果和你的一致——但墙不是带宽,是显存。

              机器:X570 + 3500X,双 XTX 拆 8+8(P2P 实测 14.2 GB/s),ROCm 7.2.3,用的是 fcys 的 tp2-comfy。

              分辨率 我们 s/步 峰值显存/卡
              832×480 7.54 —
              1600×896(124 帧) 45.8 22.8 / 25.3 GB
              1920×1088 OOM 放不下

              你说的"分辨率越大越划算"成立:我们 8.4× 像素只多花 6.1× 时间,通信确实被摊薄了。按你的 1344×768(30.78 s/步)线性外推到 1600×896 应该是 ~42.5 s/步,我们 45.8,同量级。

              但到 1600×896 就到头了:第二张卡用到 25.3/25.75 GB,只剩 0.4 GB,1920×1088 直接 OOM。所以 24G 卡双卡 TP2 的天花板在 1600×896 这一档——要上 1920,只能减帧数(length 124→64 应该就下来了),不是换链路。

              另外踩到一个坑,提醒后来的人:TP2 每个 block 里是 dist.all_reduce,同一个 prompt 必须同时发给两个端口。我们只发了一边,另一边就在第一个 all_reduce 上挂死了——41 分钟后以 OOM 收场,日志里完全看不出来是这原因。

              (还有个和速度无关但占比最大的:这套工作流的文本编码器在 CPU,一次 ~11 分钟,比 8 步 DiT 的 6 分钟还长。)

              terryT 1 条回复 最后回复
              2
              • Michael ZHANGM Michael ZHANG

                @Werther-Wang 我的配置:
                CPU:AMD EPYC 7k62
                内存:镁光DDR4 3200 RECC 32GB x2
                硬盘:SSD致钛1TB NVme
                主板:华南金牌H12D-8D(单路)
                电源:长城F16白金1600W
                显卡:AMD MI50x2 
                机箱:长城黑匣子AI09
                网卡:主板自带2.5GBx2
                C PU,内存,SSD,显卡是公司淘汰的,其他的我自己买的。目前准备再买2条32GB REC C内存。再买显卡把MI50换了,之前考虑A卡Pro9700一张或者2张, 看了大家的测评,感觉买一张N卡就可以了。这套系统主要跑comfyui。LLM用在线API,主要用Deepseek/MiniMax/千问三家的。

                Werther WangW
                Werther WangW
                Werther Wang
                体面乡绅
                编写于 最后由 编辑
                #23

                @Michael-ZHANG 你这个硬盘小,你玩儿comfyui后会发现,有很多大模型都需要去尝试,还有会下很多lora,我现在2t刚刚好,以后估计2t都不够用。你这个1t以后不够用了再换就麻烦。

                1 条回复 最后回复
                0
                • terryT terry

                  @Werther-Wang 这是你的测试结果吗?怎么最近我有段时间没玩了,视频的要求已经这么低了?原生高分辨率的意义就是在正式出片时,大显存强算力单卡生产。否则试错成本太高不值得。放大也有专门的节点和工作流,虽然没原生好,调试下,也能用。

                  Werther WangW
                  Werther WangW
                  Werther Wang
                  体面乡绅
                  编写于 最后由 编辑
                  #24

                  @terry 我一直是4080s16g单卡,跑comfyui也几个月了,感觉都挺流畅的,wan2.2 ltx2.3都能跑,分辨率保底960没问题,有的工作流能到1024。 这个h3分辨率到1344速度也十分快。

                  1 条回复 最后回复
                  -1
                  • K koala

                    感谢楼主的详细测试,MinimaxH3最佳时长是15s,随着时间推移需要的时间会更多,有机会的话看看能不能测试一下15s直出的话大概会有多少提升,谢谢。

                    xiongjie gaoX
                    xiongjie gaoX
                    xiongjie gao
                    王侯将相
                    编写于 最后由 编辑
                    #25

                    @koala # 双 RX 7900 XTX · TP=2 · 15 秒直出实测(仅新增测试部分)

                    平台:2 × RX 7900 XTX 24GB(gfx1100 / RDNA3)· ROCm 7.2 · ComfyUI 0.43 · w4a8 + convrot + 自写 TP=2
                    测试日期:2026-10-29 | seed 145 | turbo LoRA(8 步档)| 所有轮次均带 --use-ck-attention --disable-smart-memory


                    1. 测试口径

                    • H3 的最佳输出时长是 15 s,帧数受模型 17k+5 网格约束:15 s @24 fps 对应 362 帧(15.083 s),latent_t = 107。

                    • 相对此前的 124 帧(5.17 s,latent_t = 37),15 s 的 token 数是 2.89×(S = 107 × (W/32) × (H/32))。

                    • 为节省时间,每档只跑 4 步采集稳态单步耗时(4 步的 deltas 波动均 < 1%),8 步端到端由「8×单步 + 实测非采样开销」推算。

                    • 必须加 --disable-smart-memory:长序列下文本编码器常驻的 10 GB + DiT 6 GB + 激活会直接撞满 24 GB。首轮未加该参数、且 strata.service 还额外占用 22.6 GB/卡,测试直接 OOM;停掉 strata 后三档全部通过。


                    2. 15 秒直出结果

                    分辨率 S(token) TP=2 s/步 单卡 s/步 加速比 all_reduce/步 显存峰值/卡 4 步实测 e2e 8 步端到端(推算)
                    832×480 41 730 36.94 53.85 1.46× 43.0 GiB 16.84 GB 291.7 s ≈ 7.3 min
                    1024×576 61 632 65.89 — — 62.9 GiB 16.84 GB 411.4 s ≈ 11.3 min
                    1344×768 107 856 159.29 — —(估算 ~1.7×) 109.2 GiB 17.77 GB 864.9 s ≈ 25 min
                    • 8 步推算所用的非采样开销:832×480 143.9 s、1024×576 147.8 s、1344×768 228.0 s(后者主要是 362 帧 × 1344×768 的 VAE 解码)。

                    • 1344×768 的 15 s mp4 已产出:362 帧 / 15.083 s,视频轨正常;音频封装仍报 avcodec_send_frame() returned 22,输出只有视频轨(5 s 时代就存在的既有问题,需另外合音轨)。

                    • 未重跑 15 s 版本的 PSNR;画质结论沿用 5 s 档的 18.85 dB(噪声底 24.66 dB)。


                    3. 时长带来的超线性(相对各自 124 帧 / 5.2 s 的配置)

                    配置 5.2 s(124 帧) 15.1 s(362 帧) 单步增长 token 增长
                    832×480 · TP=2 9.44 s 36.94 s 3.91× 2.89×
                    832×480 · 单卡 11.23 s 53.85 s 4.79× 2.89×
                    1024×576 · TP=2 14.99 s 65.89 s 4.40× 2.89×
                    1344×768 · TP=2 30.78 s 159.29 s 5.18× 2.89×
                    • token 只涨 2.89×,单步却涨 3.9–5.2×,且分辨率越高增长越快(1344×768 的 5.18× > 1024×576 的 4.40× > 832×480 的 3.91×):attention 是 O(S²),其占比随分辨率上升,理论最坏 8.35×(=2.89²)。

                    • 单卡在长时长下更吃亏(4.79× vs TP2 的 3.91×),因为单卡还要承担整份权重换出的代价。


                    4. 与前面结论的衔接

                    1. TP 的收益随时长变大:832×480 的加速比从 5 s 的 1.19× 升到 15 s 的 1.46×;1344×768 上 109 GiB/步的 all_reduce 折算约 27 s(占单步 17%),按同口径估算加速比 ~1.7×。上限仍是 2×。
                    2. 瓶颈依旧是 PCIe 3.0 x16:通信量随 S 线性增长(43 → 63 → 109 GiB/步),等效带宽 3.6–4.2 GB/s 不变;时长变长只是让「计算分母」更大,所以占比反而降到 17%。
                    3. 显存不是瓶颈,但换出策略是关键:三档峰值 16.8–17.8 GB,长时长主要吃时间不吃显存(激活是流式的)。不加 --disable-smart-memory 会因编码器常驻而 OOM——这一点在 5 s 档只是「峰值虚高到 22.4 GB」,到 15 s 就变成「跑不起来」。
                    4. 画质问题与时长无关:误差来源已定位为 bf16 级扰动被端到端采样混沌放大(18.85 vs 24.66 dB),没有单点可修;15 s 没有引入新的误差机制。
                    5. 出片流程建议:832×480(≈7 min)或 1024×576(≈11 min)试构图与 prompt,1344×768(≈25 min)出最终 15 s;一次 reroll 的代价是 5 s 时代的 4–5 倍,值得把重试放在低分辨率完成。

                    5. 复跑命令

                    cd /home/jay/tp2
                    
                    # 15 s = 362 帧;832×480 单卡 / TP2
                    EXTRA_ARGS="--use-ck-attention --disable-smart-memory" bash run_case.sh s15_832_s 1 832 480 362 4
                    EXTRA_ARGS="--use-ck-attention --disable-smart-memory" bash run_case.sh s15_832_t 2 832 480 362 4
                    
                    # 高分辨率
                    EXTRA_ARGS="--use-ck-attention --disable-smart-memory" bash run_case.sh s15_1024_t 2 1024 576 362 4
                    EXTRA_ARGS="--use-ck-attention --disable-smart-memory" bash run_case.sh s15_1344_t 2 1344 768 362 4
                    

                    结果落在 logs/<tag>/result.json(含 per_step、deltas、vram_peak_gb、all_reduce_gb),日志 r0.log / r1.log,latent dump 为 latent_8191.pt / latent_8192.pt。

                    https://github.com/shawn86574-prog/x99-7900xtx-p2p
                    https://github.com/shawn86574-prog/kuzuryusen

                    1 条回复 最后回复
                    2
                    • K
                      K
                      koala
                      硕果累累 贵族大夫
                      编写于 最后由 编辑
                      #26

                      非常有参考价值,多谢。

                      1 条回复 最后回复
                      0
                      • E Enigma

                        @xiongjie-gao 说:

                        @Werther-Wang CPU和内存不会是瓶颈

                        通信摊薄曲线:640×352 → 1536×864(124 帧,均为 4–8 步实测)

                        分辨率 S(token) 单卡 s/步 TP=2 s/步 加速比 all_reduce 通信耗时占单步
                        640×352 8 140 5.80 5.28 1.10× 8.6 GB 45%
                        832×480 14 430 11.23 9.44 1.19× 14.9 GB 40%
                        1024×576 21 312 19.10 14.99 1.27× 21.8 GB 36%
                        1280×704 32 560 35.49 26.00 1.37× 33.0 GB 32%
                        1344×768 37 296 43.72 30.78 1.42× 37.8 GB 29%
                        1536×864 47 952 65.60 44.49 1.47× 48.5 GB 26%

                        通信耗时 = TP2 单步 − 单卡单步/2(把「计算完美二分」当基准),等效带宽稳定在 3.6–4.2 GB/s。加速比随 S 单调上升,S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。

                        image.jpeg

                        左:单卡 vs TP=2 每步耗时;右:加速比。640×352 只有 1.10×(通信占单步 45%),到 1536×864 升到 1.47×(通信占 26%),上限趋近 2×。


                        基本印证跟我的对提升上限1.50×的猜想

                        我在自己的双 7900XTX 上往上走了一档,结果和你的一致——但墙不是带宽,是显存。

                        机器:X570 + 3500X,双 XTX 拆 8+8(P2P 实测 14.2 GB/s),ROCm 7.2.3,用的是 fcys 的 tp2-comfy。

                        分辨率 我们 s/步 峰值显存/卡
                        832×480 7.54 —
                        1600×896(124 帧) 45.8 22.8 / 25.3 GB
                        1920×1088 OOM 放不下

                        你说的"分辨率越大越划算"成立:我们 8.4× 像素只多花 6.1× 时间,通信确实被摊薄了。按你的 1344×768(30.78 s/步)线性外推到 1600×896 应该是 ~42.5 s/步,我们 45.8,同量级。

                        但到 1600×896 就到头了:第二张卡用到 25.3/25.75 GB,只剩 0.4 GB,1920×1088 直接 OOM。所以 24G 卡双卡 TP2 的天花板在 1600×896 这一档——要上 1920,只能减帧数(length 124→64 应该就下来了),不是换链路。

                        另外踩到一个坑,提醒后来的人:TP2 每个 block 里是 dist.all_reduce,同一个 prompt 必须同时发给两个端口。我们只发了一边,另一边就在第一个 all_reduce 上挂死了——41 分钟后以 OOM 收场,日志里完全看不出来是这原因。

                        (还有个和速度无关但占比最大的:这套工作流的文本编码器在 CPU,一次 ~11 分钟,比 8 步 DiT 的 6 分钟还长。)

                        terryT
                        terryT
                        terry
                        易有太极
                        编写于 最后由 编辑
                        #27

                        @Enigma 你这个信息也很重要,测试出了极限,这个分辨率已经很牛逼了。其实大多数时候走720P附近,质量就很好了。

                        油管:https://www.youtube.com/@抡锤者

                        懒人烘培懒 1 条回复 最后回复
                        0
                        • terryT terry

                          @Enigma 你这个信息也很重要,测试出了极限,这个分辨率已经很牛逼了。其实大多数时候走720P附近,质量就很好了。

                          懒人烘培懒
                          懒人烘培懒
                          懒人烘培
                          王侯将相
                          编写于 最后由 编辑
                          #28

                          @terry @xiongjie-gao @enigma
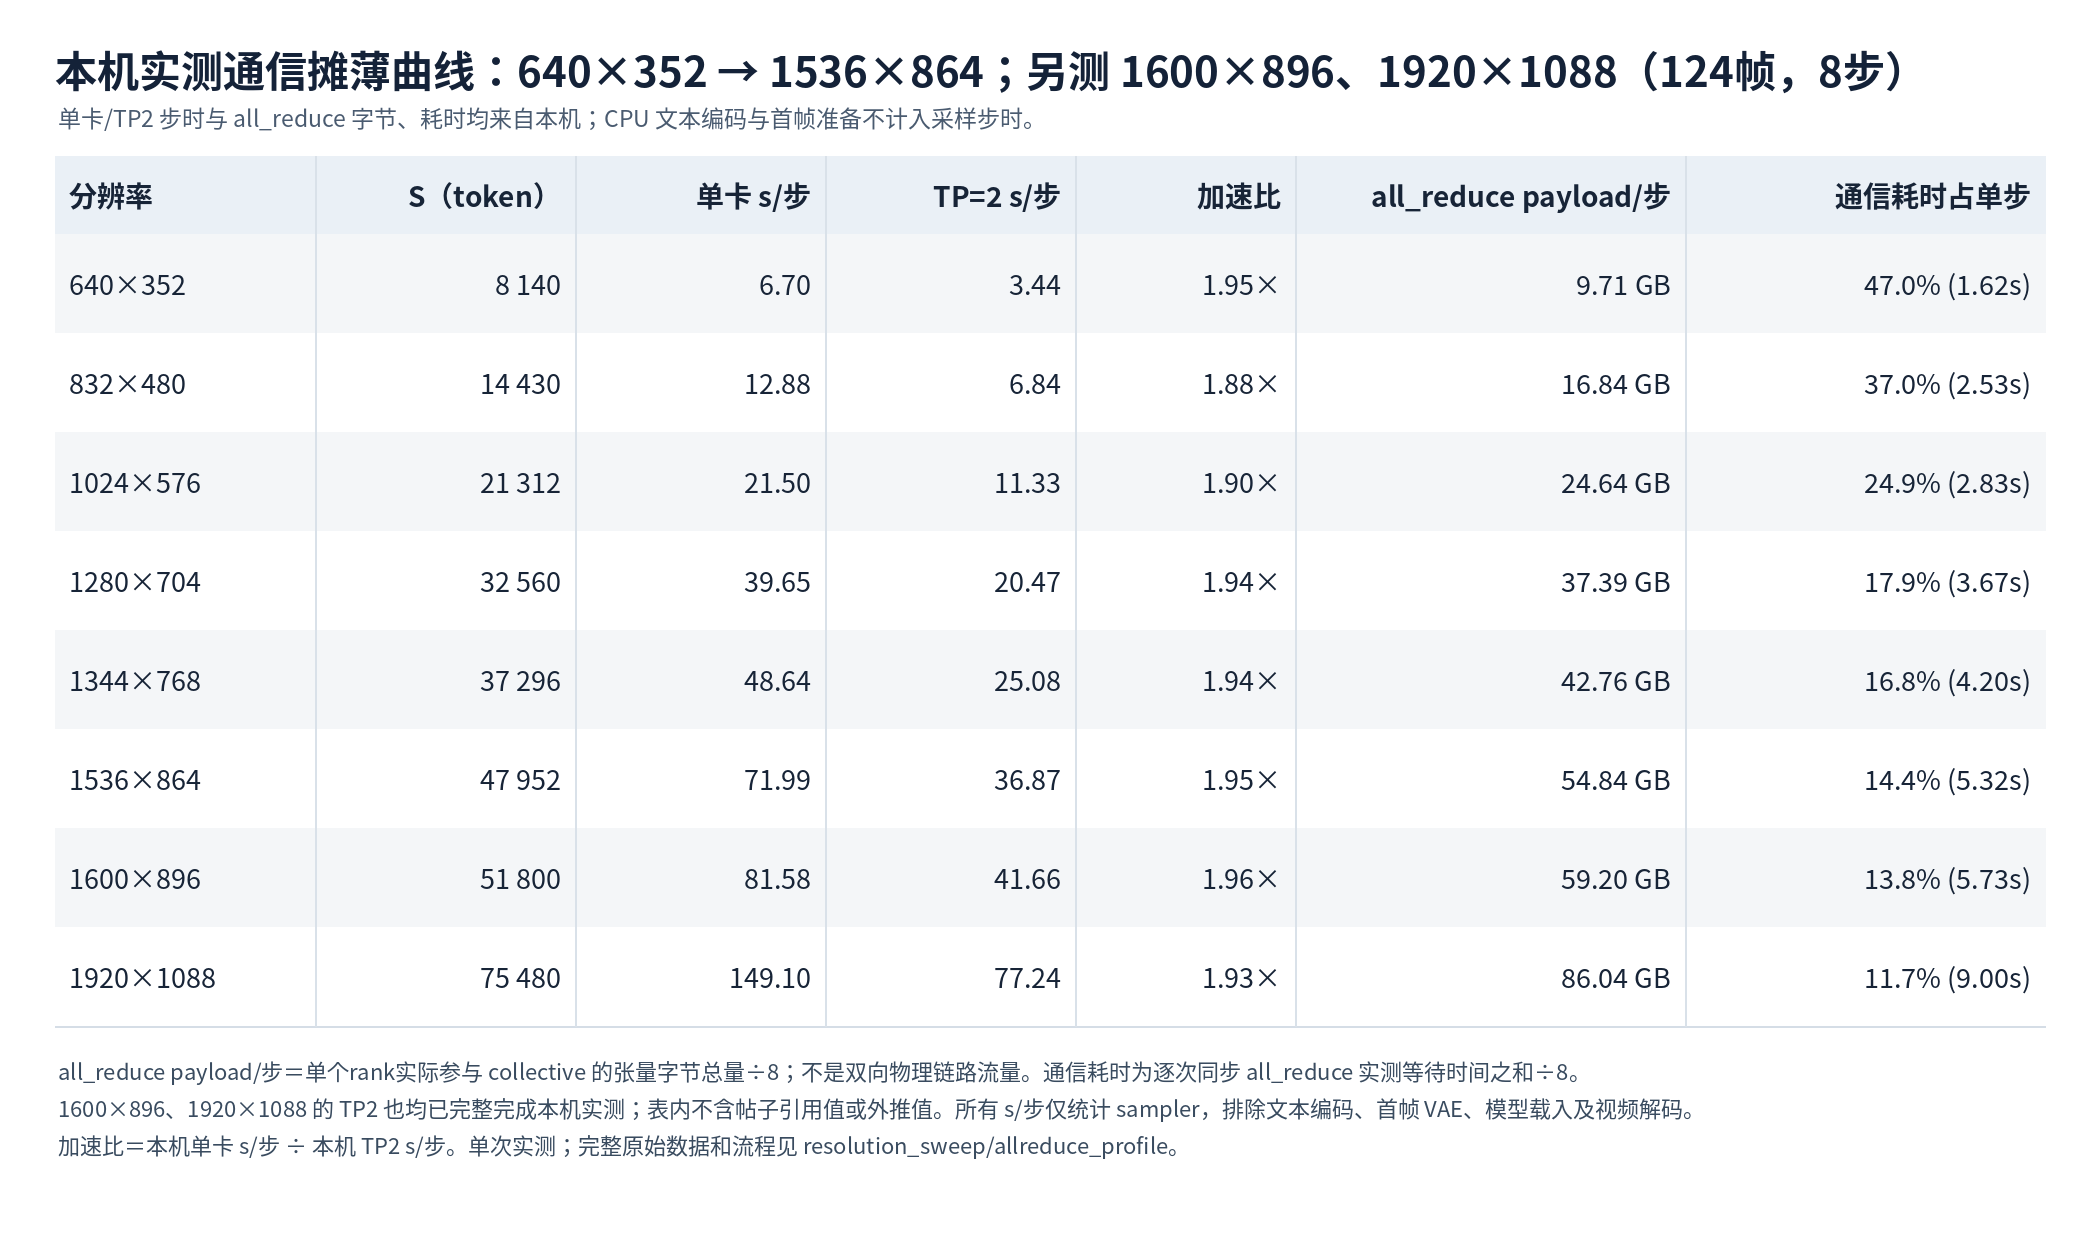
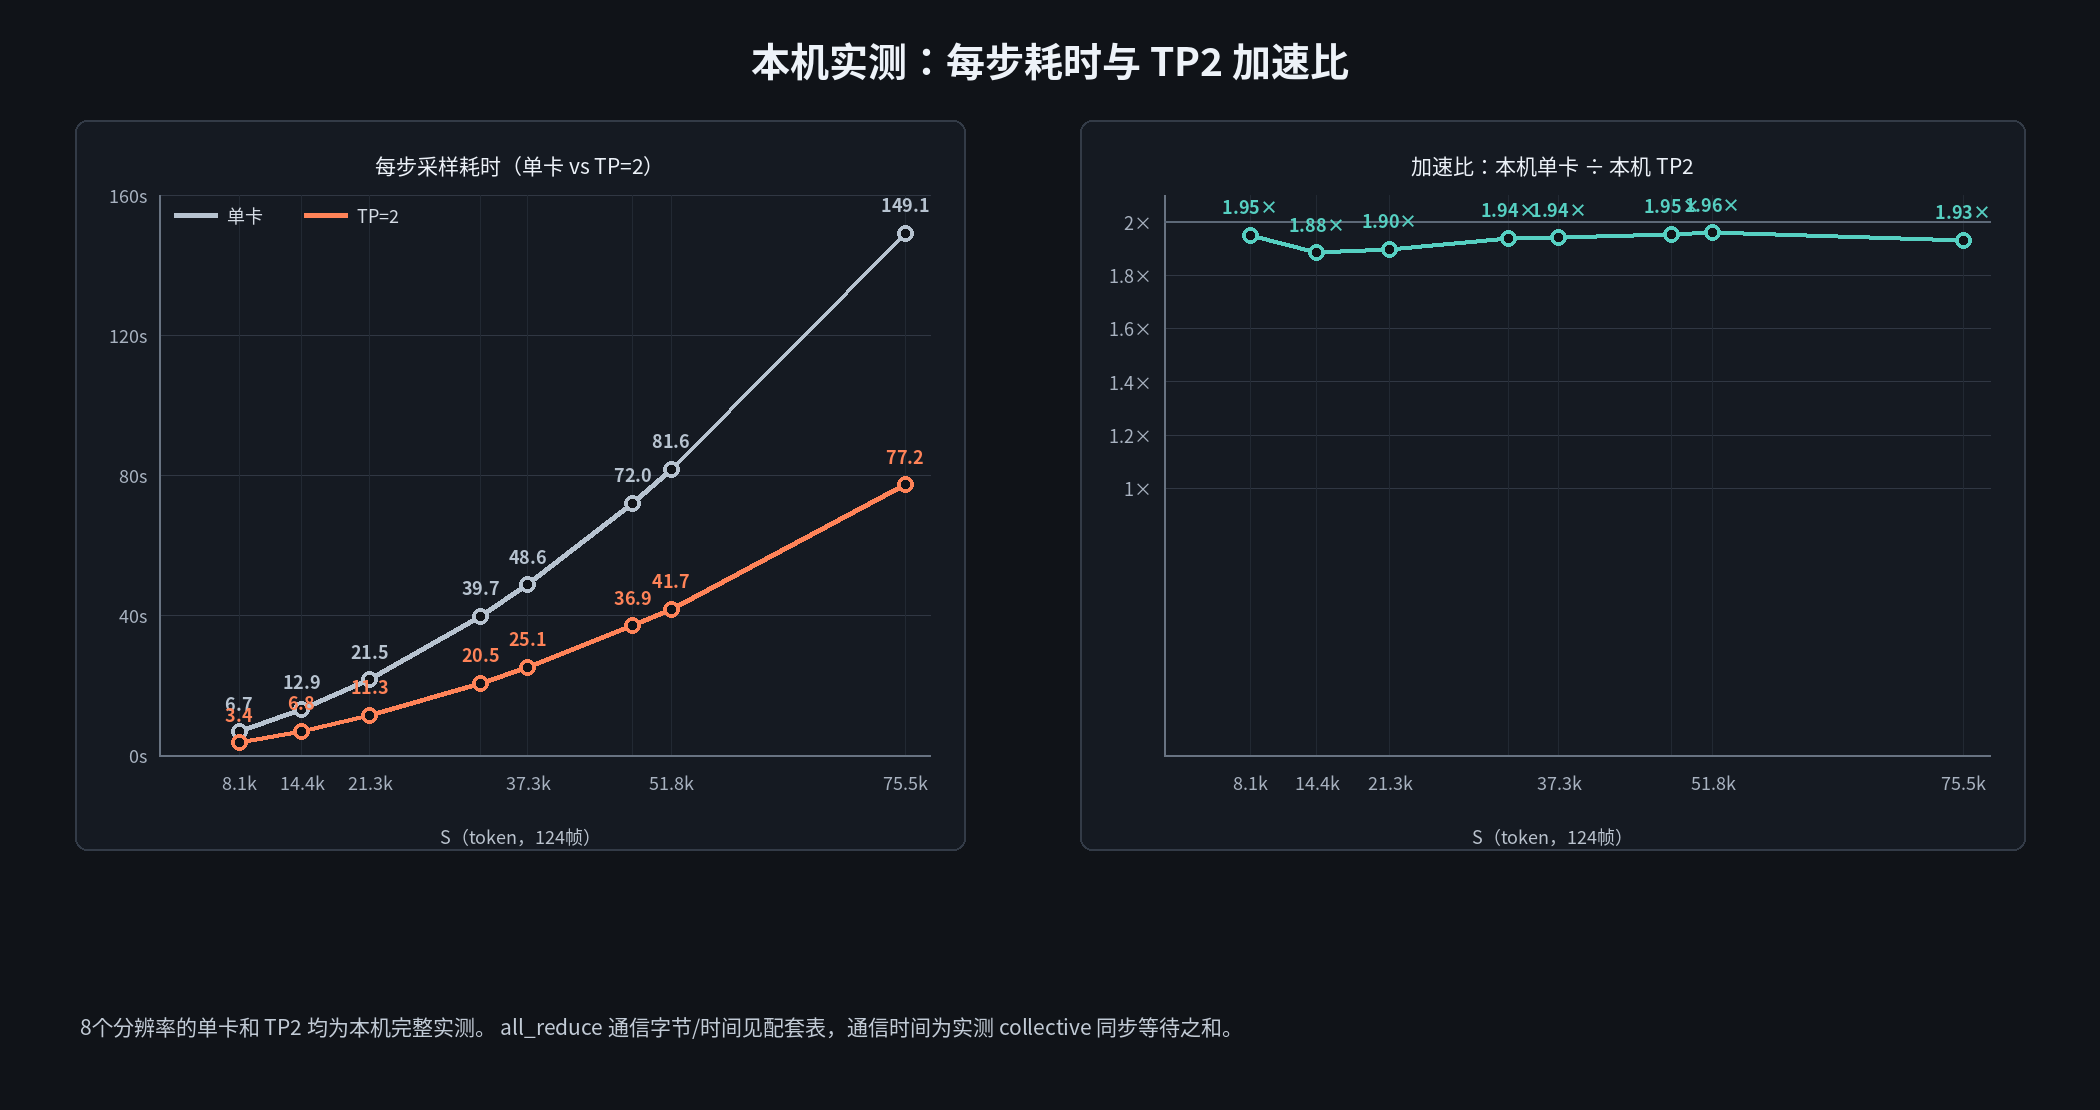
                          我也按照帖子的信息部署,提升还可以,DDR5平台会好些,提升接近2倍

                          1-local-measured-communication-table.png

                          2-local-measured-step-and-speedup.png

                          双 7900 XTX:模型本地跑,Token 随便烧!

                          xiongjie gaoX 1 条回复 最后回复
                          2
                          • 懒人烘培懒 懒人烘培

                            @terry @xiongjie-gao @enigma
                            我也按照帖子的信息部署,提升还可以,DDR5平台会好些,提升接近2倍

                            1-local-measured-communication-table.png

                            2-local-measured-step-and-speedup.png

                            xiongjie gaoX
                            xiongjie gaoX
                            xiongjie gao
                            王侯将相
                            编写于 最后由 编辑
                            #29

                            @懒人烘培
                            你这是把w4a8/int8编码的时间刨掉了吧?

                            https://github.com/shawn86574-prog/x99-7900xtx-p2p
                            https://github.com/shawn86574-prog/kuzuryusen

                            懒人烘培懒 1 条回复 最后回复
                            1
                            • xiongjie gaoX xiongjie gao

                              @懒人烘培
                              你这是把w4a8/int8编码的时间刨掉了吧?

                              懒人烘培懒
                              懒人烘培懒
                              懒人烘培
                              王侯将相
                              编写于 最后由 编辑
                              #30

                              @xiongjie-gao 你说得对是刨掉的,看楼主的计算也是刨掉的。

                              双 7900 XTX:模型本地跑,Token 随便烧!

                              xiongjie gaoX 1 条回复 最后回复
                              1
                              • 懒人烘培懒 懒人烘培

                                @xiongjie-gao 你说得对是刨掉的,看楼主的计算也是刨掉的。

                                xiongjie gaoX
                                xiongjie gaoX
                                xiongjie gao
                                王侯将相
                                编写于 最后由 编辑
                                #31

                                @懒人烘培 把这场优化测试的流程和设计思路让AI写一份可复现的MD文件,发个帖子吧。这很重要。

                                https://github.com/shawn86574-prog/x99-7900xtx-p2p
                                https://github.com/shawn86574-prog/kuzuryusen

                                懒人烘培懒 1 条回复 最后回复
                                1
                                • xiongjie gaoX xiongjie gao

                                  @懒人烘培 把这场优化测试的流程和设计思路让AI写一份可复现的MD文件,发个帖子吧。这很重要。

                                  懒人烘培懒
                                  懒人烘培懒
                                  懒人烘培
                                  王侯将相
                                  编写于 最后由 编辑
                                  #32

                                  @xiongjie-gao 可以,到时候大家来看看有没有测试或者设置的问题。

                                  双 7900 XTX:模型本地跑,Token 随便烧!

                                  1 条回复 最后回复
                                  1
                                  • ,terryT terry 取消固定了此主题
                                  • ,J IJ J I 引用了 此主题

                                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                  有了你的建议,这篇帖子会更精彩哦 💗

                                  注册 登录
                                  回复
                                  • 在新帖中回复
                                  登录后回复
                                  • 从旧到新
                                  • 从新到旧
                                  • 最多赞同


                                  • 登录

                                  • 登录或注册以进行搜索。
                                  • 第一个帖子
                                    最后一个帖子
                                  0
                                  • 版块
                                  • 最新
                                  • 标签
                                  • 热门
                                  • 用户
                                  • 群组