神了, 7900xtx 单卡prefill 3,570 tok/s decode 106.6 tok/s, Strata RDNA3 fork:安装、调优与 32K–256K 性能实测
-
-
-
-
-
-
好勁呀 ! 等我都抄一抄先, 以下係雙7900 xtx嘅測試:
硬件
項目 配置 主機板 華南金牌 HUANANZHI X99-F8D PLUS,V1.33 作業系統 Ubuntu 26.04.1 LTS,64 位元 CPU 2 × Intel Xeon E5-2673 v4,標稱基礎時脈 2.30 GHz 系統記憶體 已安裝 224 GiB:7 × 32 GiB Samsung DDR4 ECC( 本來買咗八條但係有兩條壞嘅,換貨後仍然係有一條係壞嘅 ) ) CPU0 記憶體 已安裝 96 GiB,三個記憶體通道有插 DIMM;Linux 可見約 94.0 GiB CPU1 記憶體 已安裝 128 GiB,四個記憶體通道均有插 DIMM;Linux 可見約 122.0 GiB GPU0,連接 CPU0 Sapphire Nitro+ RX 7900 XTX,24 GB 顯存;PCI 0000:07:00.0 GPU1,連接 CPU1 XFX MERC 310 RX 7900 XTX,24 GB 顯存;PCI 0000:86:00.0 電源供應器 Great Wall 2000 W,型號由使用者提供 Fork 設定
項目 設定 引擎 實際使用 RDNA3 Fork,原生引擎版本 0.1.43 原始碼 nicejunjie/Strata-rdna3 PR #1,commit: 309f0c8f8cef010f62746f80caf677c68e7141f9GPU 運作模式 單一請求使用兩張卡;24/24 分層,Nitro+ 處理第 0–23 層,MERC 處理第 24–47 層 專家資料的記憶體配置 各 GPU 階段使用其所連接 CPU 的本地記憶體 Expert workers 合共 8 個,每顆 CPU 分配 4 個;綁定邏輯 CPU 1、2、3、4、20、21、22、23 上下文上限 262,144 tokens Prefill 自動選擇,每個區塊上限 32,768 tokens;啟用雙 GPU DP prefill Prefill ring/CPU 分工 384 個槽位;CPU-share 為 auto,上限 1,024 KV cache INT8;32,768 個常駐 KV cells 推測解碼 Spec 3,最低機率 0.5;MTP Q4 all;MTP window 4,096 Pipeline windows 2 預留顯存 每張卡 2,048 MiB 對話快取 16,384 MiB,8 個槽位 HIP 硬件佇列 GPU_MAX_HW_QUEUES=8視覺功能 透過現有 CPU 視覺編碼器啟用;本次效能測試只輸入文字 單位:tokens/秒。
雙 GPU 測試結果
輸入長度 Prefill Decode 1K 607.9 115.5 8K 2353.2 115.8 10K 1450.9 113.1 15K 2119.8 104.3 32K 3609.1 121.8 64K 4339.0 123.3 128K 4645.6 107.5 250K 5457.0 104.4 -
好勁呀 ! 等我都抄一抄先, 以下係雙7900 xtx嘅測試:
硬件
項目 配置 主機板 華南金牌 HUANANZHI X99-F8D PLUS,V1.33 作業系統 Ubuntu 26.04.1 LTS,64 位元 CPU 2 × Intel Xeon E5-2673 v4,標稱基礎時脈 2.30 GHz 系統記憶體 已安裝 224 GiB:7 × 32 GiB Samsung DDR4 ECC( 本來買咗八條但係有兩條壞嘅,換貨後仍然係有一條係壞嘅 ) ) CPU0 記憶體 已安裝 96 GiB,三個記憶體通道有插 DIMM;Linux 可見約 94.0 GiB CPU1 記憶體 已安裝 128 GiB,四個記憶體通道均有插 DIMM;Linux 可見約 122.0 GiB GPU0,連接 CPU0 Sapphire Nitro+ RX 7900 XTX,24 GB 顯存;PCI 0000:07:00.0 GPU1,連接 CPU1 XFX MERC 310 RX 7900 XTX,24 GB 顯存;PCI 0000:86:00.0 電源供應器 Great Wall 2000 W,型號由使用者提供 Fork 設定
項目 設定 引擎 實際使用 RDNA3 Fork,原生引擎版本 0.1.43 原始碼 nicejunjie/Strata-rdna3 PR #1,commit: 309f0c8f8cef010f62746f80caf677c68e7141f9GPU 運作模式 單一請求使用兩張卡;24/24 分層,Nitro+ 處理第 0–23 層,MERC 處理第 24–47 層 專家資料的記憶體配置 各 GPU 階段使用其所連接 CPU 的本地記憶體 Expert workers 合共 8 個,每顆 CPU 分配 4 個;綁定邏輯 CPU 1、2、3、4、20、21、22、23 上下文上限 262,144 tokens Prefill 自動選擇,每個區塊上限 32,768 tokens;啟用雙 GPU DP prefill Prefill ring/CPU 分工 384 個槽位;CPU-share 為 auto,上限 1,024 KV cache INT8;32,768 個常駐 KV cells 推測解碼 Spec 3,最低機率 0.5;MTP Q4 all;MTP window 4,096 Pipeline windows 2 預留顯存 每張卡 2,048 MiB 對話快取 16,384 MiB,8 個槽位 HIP 硬件佇列 GPU_MAX_HW_QUEUES=8視覺功能 透過現有 CPU 視覺編碼器啟用;本次效能測試只輸入文字 單位:tokens/秒。
雙 GPU 測試結果
輸入長度 Prefill Decode 1K 607.9 115.5 8K 2353.2 115.8 10K 1450.9 113.1 15K 2119.8 104.3 32K 3609.1 121.8 64K 4339.0 123.3 128K 4645.6 107.5 250K 5457.0 104.4 -
-
-
-
@Eric-Seto 可以在优化一下,双7900XTX的262K上prefill上6000是没有问题的
-
@mudfox 怎么r9700 卖掉? 现在应该最强amd 消费级卡
@applejuice 哈哈, 卖掉 9700 买 7900 搞不懂, 这不是负优化么?
-
@懒人烘培
哥,能给兄弟们单出一篇帖子吗?我让deepseek抄作业,一直抄不明白,就卡在5000死活上不去了 -
-
-
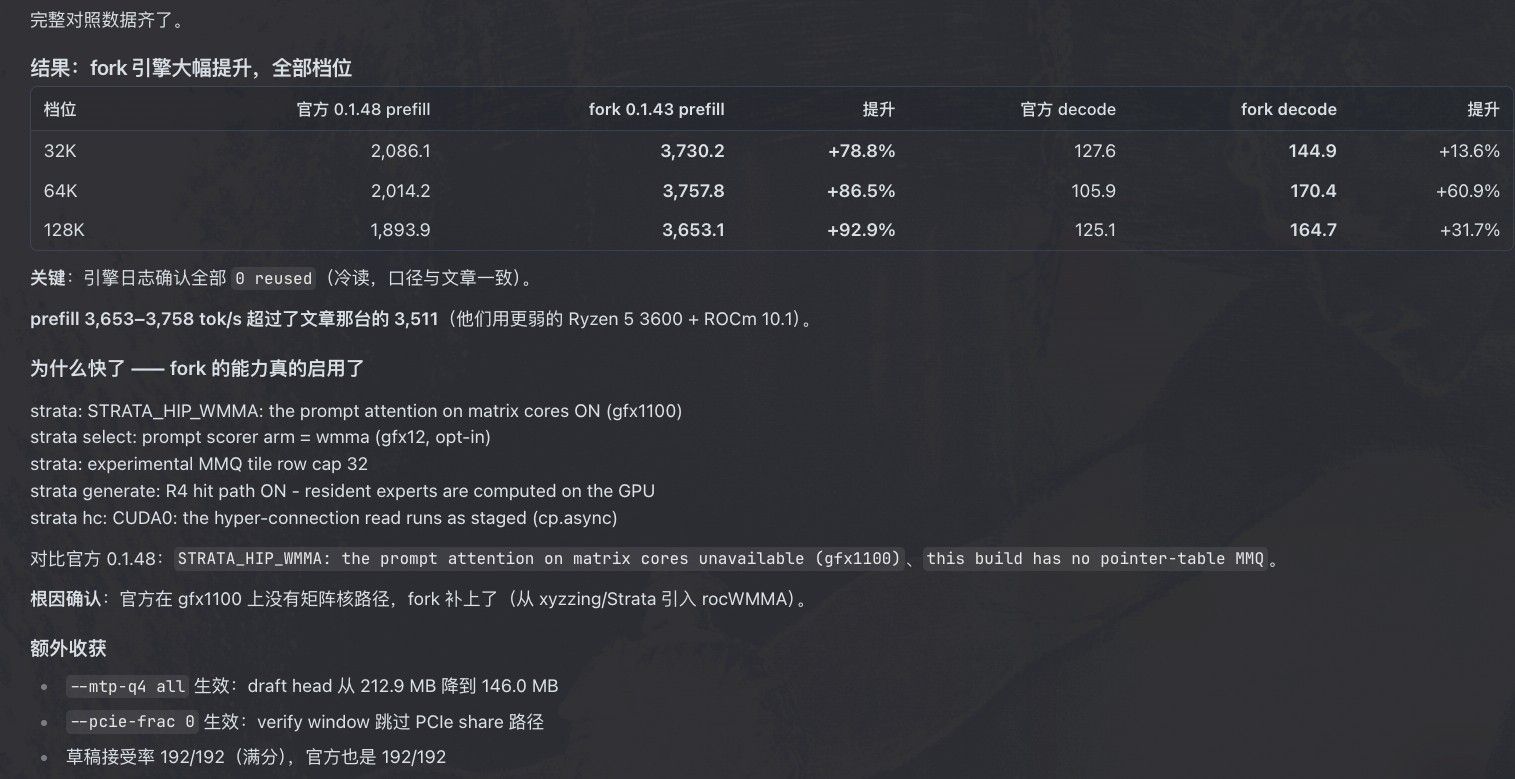
提升非常大,用了1个小时AI去配置。
抄作业结果fork 明显更快(prefill 2 倍、agent 循环 1.76 倍)
实测已经全部完成,数据写进运维手册第 9 节了。下面是优化前 vs 优化后的完整对比。
-
prefill:处理长提示词(tok/s,越高越好)
提示词长度 优化前 0.1.45 原配置 0.1.45 只把块调到 32K fork RDNA3
1 万 token 1,019 1,263(+24%) 2,090(+105%)
8 万 token 1,281 1,429(+12%) 3,129(+144%)
三次重复测量误差仅 ±0.3%(1,018.7 / 1,019.4 / 1,021.5),这组数字很硬。 关键结论:光把 prefill 块从 8192 调到 32768 只拿到 +24%/+12%,剩下的大头是 fork 的 RDNA3 内核真本事——我专门做了这个隔离实验,否则会把功劳记错。 -
decode:生成速度(tok/s,固定 seed、6 次中位数)
优化前 优化后 提升
短提示 66.5 74.1 +11.4%
3.2 万 token 提示 64.1 77.4 +20.7% -
真实 agent 循环(12 轮,每轮追加约 830 token,上下文涨到 2.68 万)
优化前 优化后 倍数
首轮冷 prefill 15.12 s 8.01 s 1.89×
稳态每轮 2.70 s 1.59 s 1.70×
12 轮总计 46.37 s 26.32 s 1.76×
这个才是你日常体感对应的场景(大部分请求是"恢复检查点 + 追加一小段")。 -
一个重要的反向验证
我担心 fork 缺 --prompt-cache-spread(0.1.45 有,是我上次修长任务缓存抖动的开关),专门测了缓存命中:两边逐条完全相同(cached token 数 8396 / 28551 / 75576 一模一样)。所以这个差异在本机测不出影响,不是迁移障碍。 -
折算到你那个 140 步长任务
按之前统计的成本结构(prompt 读 5.12 h + decode 15.32 h = 20.4 h):
prompt 部分:5.12 h → 约 2.3 h
decode 部分:15.32 h → 约 13.4 h(decode 只快 12-16%,且它占 75%)
合计约 20.4 h → 15.7 h,省 23%
也就是说:prefill 快 2 倍多非常可观,但你的长任务瓶颈其实在生成 token 数,换引擎能省四分之一,真正的大头还是要靠少生成。- 现在的状态
fork 正在跑(strata-fork.service),strata.service 已停止但仍是开机默认
所以现在重启会回到 0.1.45,不会留下半吊子状态
回滚一条命令:systemctl stop strata-fork && systemctl start strata
0.1.45 的配置我也加了 --prefill auto:32768(白捡 +24%/+12%,无代价),备份在 strata-iq3_s.json.before-prefill32k
代价:fork 是 0.1.43(比 0.1.45 旧)、没编译 vision(源码在 tools/vision/strata_vision.cpp,需要时能补编)、多占 16 GB 源码。
-
-
,
 Y yi song 引用了 此主题
-
,A applejuice 引用了 此主题
-
-
@mudfox 怎么r9700 卖掉? 现在应该最强amd 消费级卡
@applejuice 7900XTX 带宽高
-
@applejuice 7900XTX 带宽高
@rongda-weng fp8 算力不可忽视,新架构有优势
-

 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!



 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!