M5 Ultra(256GB)本地高负载运行实测:硬件监测数据记录与观察
-
M5 Ultra(256GB)本地高负载运行实测:硬件监测数据记录与观察
设备与环境配置
硬件规格Apple M5 Ultra · 80 核 GPU · 256GB 统一内存 · macOS Sequoia
加载模型DeepSeek-V4.1-Flash-oQ2.5e-mtp(原生 256K 上下文)
推理后端oMLX Server(启用 Paged SSD KV 缓存)+ DeepSeek Harness
辅助散热底部防尘进风底座 + 出风口探头温控智能调速风扇
一、会话负载与 Token 吞吐数据
在初次运行鹈鹕骑自行车代码生成任务中,Agent 在后台自主执行了 81 个连续决策步骤,会话累计处理量达到千万级。
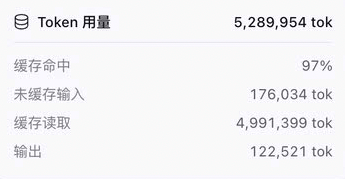
- 缓存复用效率:总处理量突破 1000 万 Token,其中 945 万由缓存直接读取,未缓存输入仅 51.6 万,缓存命中率达 95%。
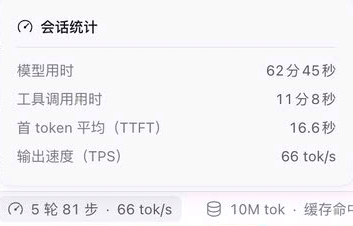
- 长上下文速率:任务推进至 132K 上下文(占模型标称 256K 窗口的约 50%)时,平均首字延迟(TTFT)维持在 16.6 秒,Token 实时生成速率维持在 66 tok/s。
二、内存子系统:220GB 物理占用与弹窗警告
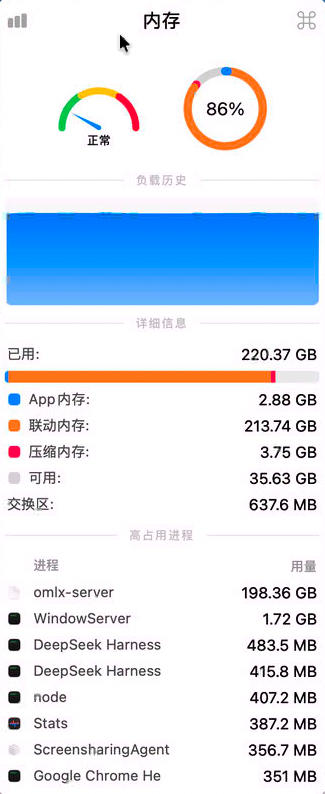
高压运行状态下,通过 Stats 捕获到的实时内存分配如下:
- 单进程占用:
omlx-server进程占用达 198.36 GB,整机物理内存占用上升至 220.37 GB(占比 86%),大部分表现为锁定的联动内存(Wired Memory)。 - 交换区与内存压力:Swap 仅使用 637.6 MB,压力指针停留在绿色区间。
- 长时运行现象(OOM 告警):在连续高频调用约一至两小时后,系统出现“应用程序内存不足”的弹窗,提示需强制退出部分任务以释放内存。
三、磁盘 I/O:分层缓存读写状态
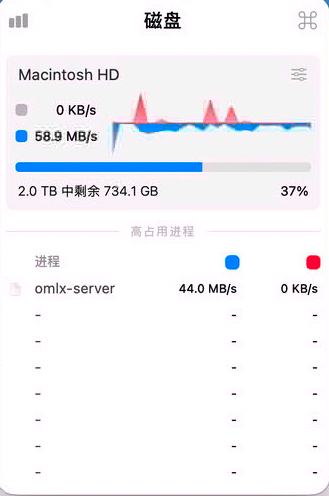
在物理内存占用超过 200GB 阶段,
omlx-server产生约 44.0 MB/s 的持续磁盘 I/O。该数据对应 oMLX 对不活跃前缀 KV Cache 进行的分页换入与换出。
四、算力调用与散热表现
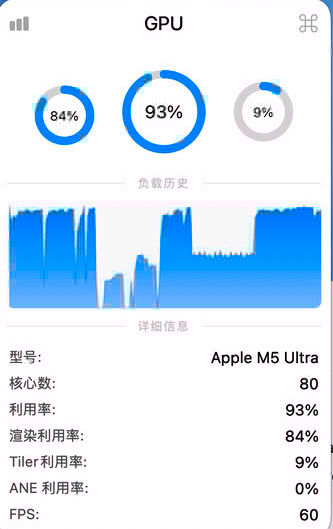
- GPU 核心负荷:80 颗 GPU 核心整体利用率维持在 93%(渲染负荷 84%),CPU 整体闲置率在 90% 左右。
- 温度与辅助散热说明:
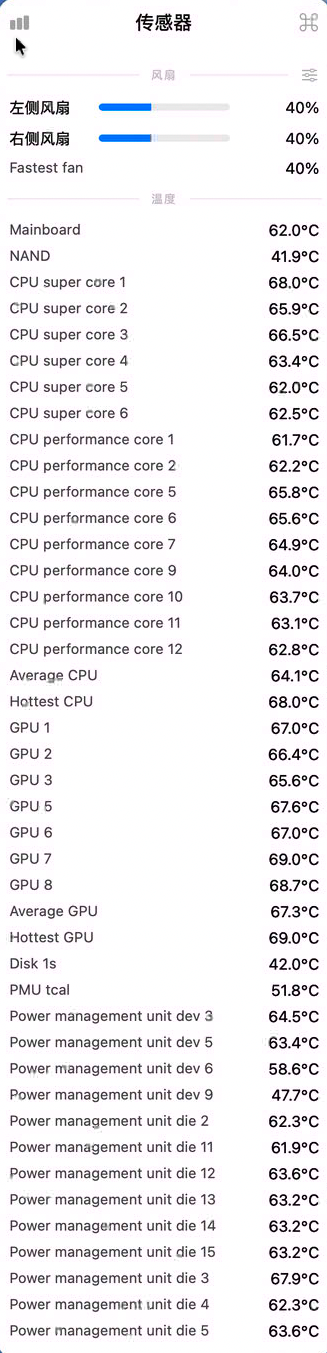
- 传感器显示 GPU 最高温 69.0°C,CPU 最高温 68.0°C,机身内置风扇恒定在 40%。
- 此项温控包含外置物理散热干预:机身底部加装了带防尘网的主动散热底座,温控探头置于背部出风口以实现变速进风。在高负荷运转期间,外置底座有风噪。
五、连续运行 5 小时后的状态与降速现象
在连续运行 4 小时 51 分钟、累计处理 724 次请求(共计 7220 万 Token)后,oMLX 后台状态呈现出明显的数据变化:
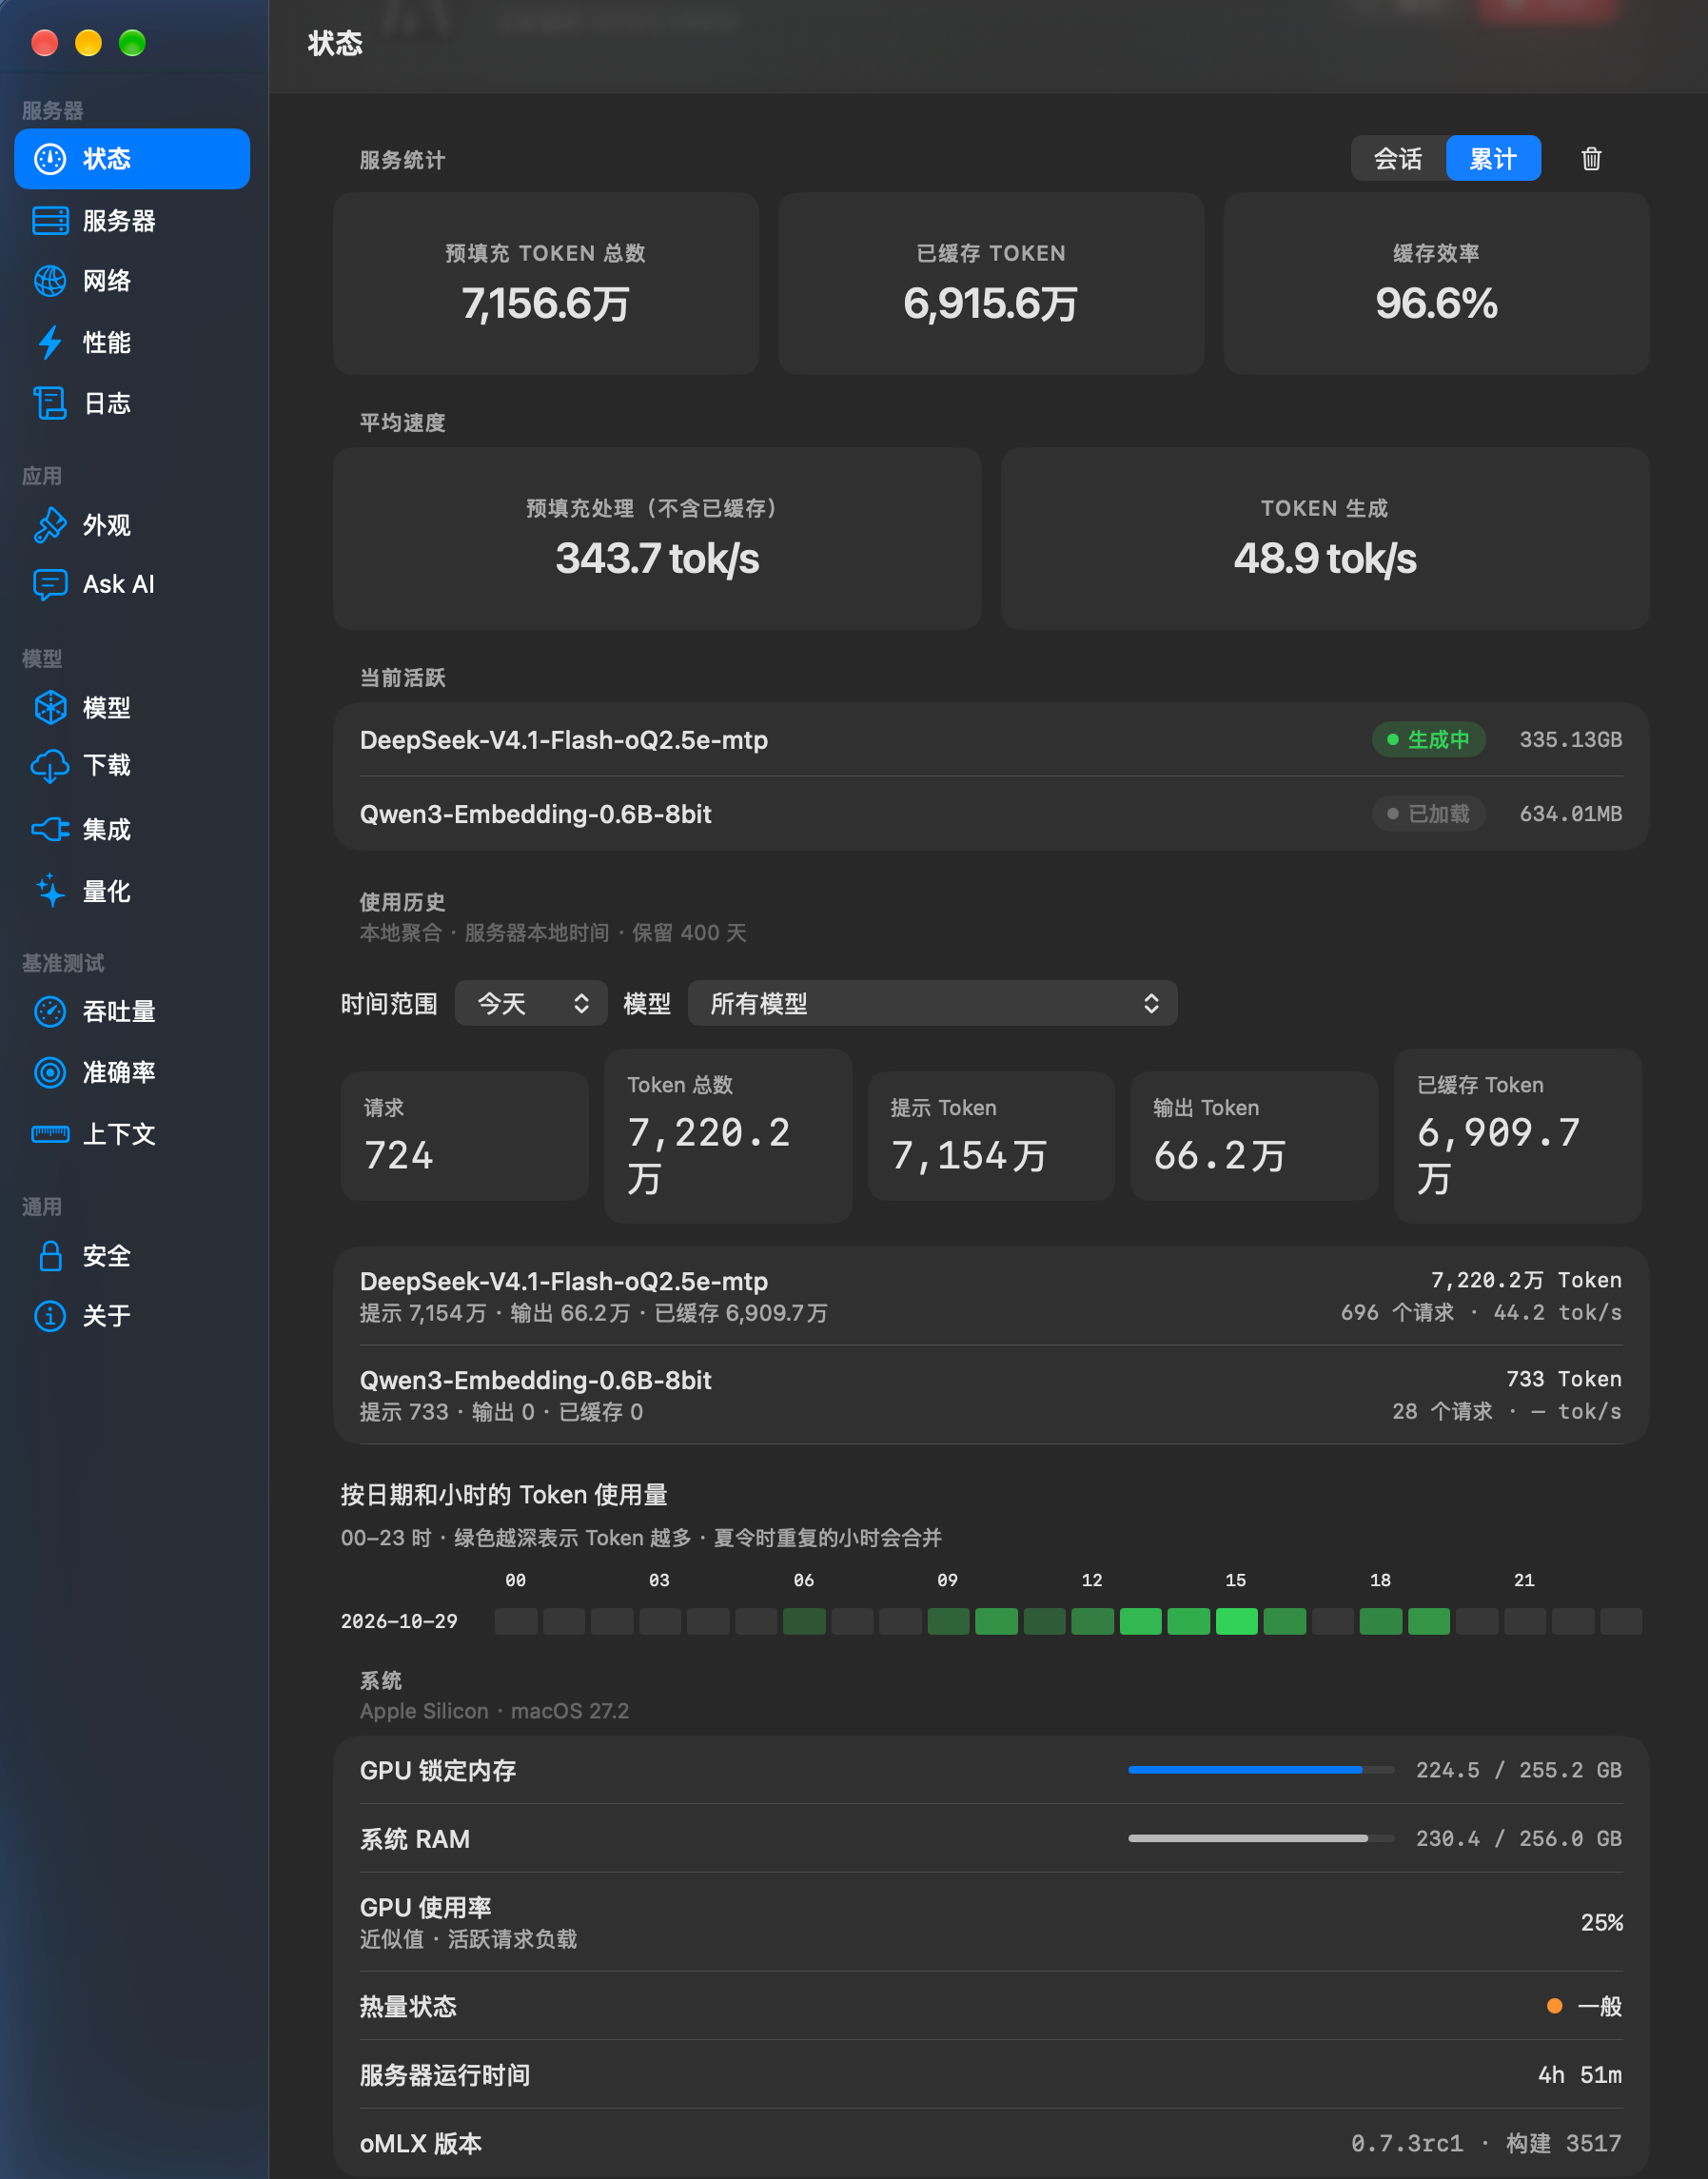
- 生成速率下滑:实时输出速度由初期的 60~66 tok/s 逐步回落至 38~40 tok/s 区间(面板记录平均速率为 44.2 tok/s)。
- 伴随的硬件状态变化:
- 系统 RAM 达到 230.4 GB(占用率 90%),GPU 锁定内存达到 224.5 GB;
- oMLX 状态栏中的热量状态(Thermal State)由初始状态转变为黄色的“● 一般”;
- 该模型所搭载的 MTP(多 Token 预测)在长上下文、多轮历史堆叠后的体感命中效果有所改变。
说明
以上为 M5 Ultra 单机运行本地大模型与 Agent 流程的第一手监测数据记录,刚开始用样本较少,各项软硬件参数与速率变化仅供折腾参考。
-
-
-
-
-

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!