
# Strata 上下文拉到 512K 实测:8K 到 470K 只掉 15%,顺手让 IQ2_XS 接管了 1Panel 和 VPS 运维
-
Strata 上下文拉到 512K 实测:8K 到 470K 只掉 15%,顺手让 IQ2_XS 接管了 1Panel 和 VPS 运维
逛这个论坛能学到不少东西,大佬确实多。最近 Strata 火了,我也在本机部署了一套,用了一段时间,体验比我预想的好。64GB 内存上 IQ3 有点吃力,IQ2 的效果其实完全够用。
之前上过 IQ3_S,速度也能跑到 150-160 t/s,但内存一直贴着上限,跑 agent 长任务心里没底,后来干脆退回去只用 IQ2_XS。少那点质量分换稳定,我觉得值。
背景:它现在顺手帮我管 1Panel
前几天试着让它完全接管 1Panel,过程挺顺:证书、域名、容器的问题都能自己处理,甚至发现面板的 API 功能没默认打开,自己通过 SSH 去开了。之后 VPS 上的应用部署、子域名反代都交给它,不用在线模型。1Panel 确实适合个人在 VPS 上折腾服务,配好通配符域名和证书以后,部署一个服务就是一句话的事,以前还得手动点半天。
系统运维这块,目前我还是觉得 Hermes 排第一。dsh 也能干,但长期记忆和跨项目目录上不如 Hermes,所以 Hermes 是主力,dsh 单独用也不错。
环境
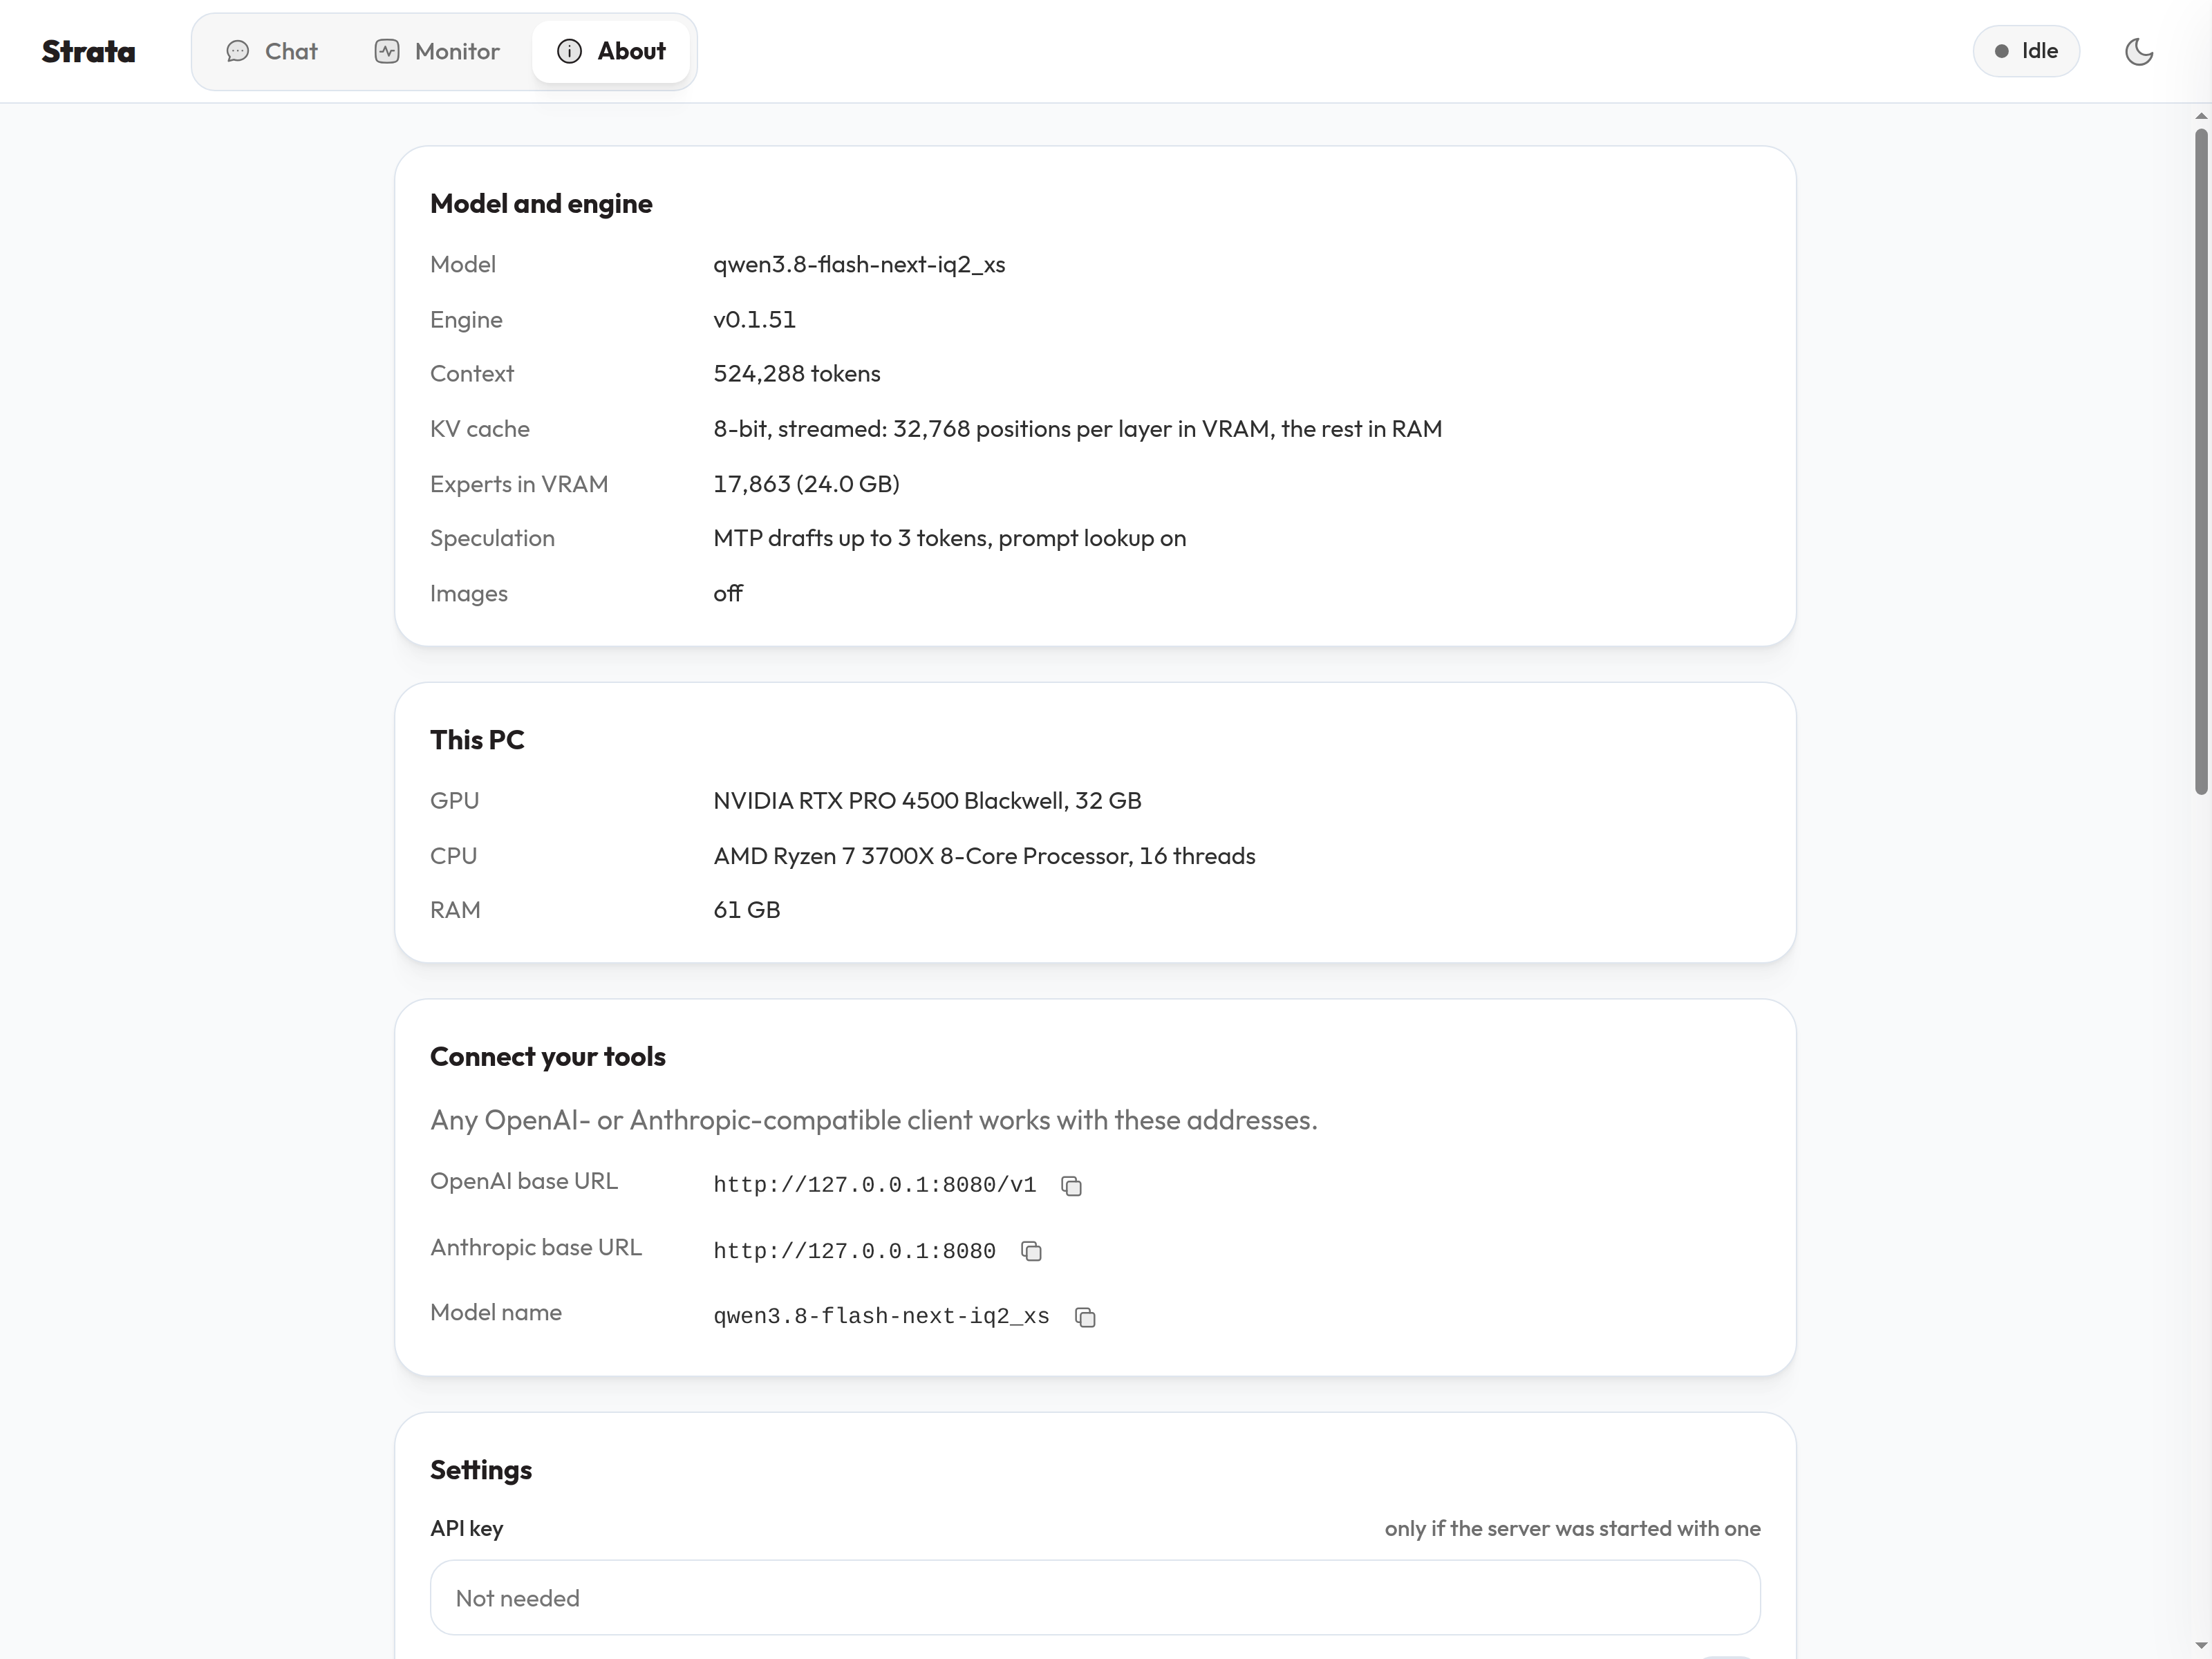
项 值 GPU NVIDIA RTX PRO 4500 Blackwell 32GB(驱动 595.99.02,PCIe 4.0 x16) CPU AMD Ryzen 7 3700X,8 核 16 线程 主板 Gigabyte X570 GAMING X 内存 64 GB 物理(MemTotal 60.7 GiB,面板取整显示 61 GB) 磁盘 模型放 Samsung 970 PRO 1TB NVMe 系统 Ubuntu 26.04.1 引擎 Strata 0.2.6 / engine 0.1.51 模型 Qwen3.8-Flash-Next IQ2_XS(125B MoE) 上下文 524,288 专家缓存 17,863 个 / 23.99 GiB(面板显示 24.0 GB;整卡 32 GB) 
配置:从 262K 提到 512K
今天下午改的,动了两处:
--max-context翻倍,加了--rope-scaling yarn,KV 还是 int8、--kv-resident没动。--max-context 524288 --rope-scaling yarn # 新增;超过训练长度 256K 必须外推 --kv int8 --kv-resident 32768 # KV 主体放内存,显存每层只留 32,768 个位置--kv-resident是 512K 便宜的前提。要是让 512K 的 KV 全进显存,专家缓存得少掉约五千个槽,decode 直接掉档。面板上「Experts in VRAM 17,863 (24.0 GB)」说的是专家缓存这一项,不是整卡显存。32GB 卡扣掉 dense 权重、KV 常驻(约 429 MiB)、MTP 草稿头、CUDA 上下文和 700 MiB 预留,剩下的全被
--expert-cache auto填成专家槽:17863 × 每个专家约 1.4 MB ≈ 24 GiB。所以这个数由模型(125B MoE、48 层 × 512 专家、IQ2_XS 的 blob 大小)和框架策略共同决定,换量化档、开关视觉、改 KV 常驻都会变——IQ2_XS 之前是 18,314 个槽,512K 之后让出约 476 个。实测:8K 到 470K 的九档阶梯
每档一个请求:先在 90% 深度埋一条随机口令,让它复述口令,再列 200 个城市名。这样一次 prefill 同时测召回和吐字,速度只认服务端自己的 timings,不数客户端的分片。
深度(prompt) prefill t/s decode t/s 召回 草稿接受 8,158 3,585 193.0 ✓ 90.3% 32,343 3,674 178.3 ✓ 85.5% 64,571 3,821 180.2 ✓ 85.8% 129,093 3,664 181.3 ✓ 80.0% 201,657 3,447 165.2 ✓ 87.5% 264,300 3,377 166.6 ✓ 82.1% 396,424 3,139 160.3 ✓ 80.8% 473,808 3,069 163.7 ✓ 81.9% 
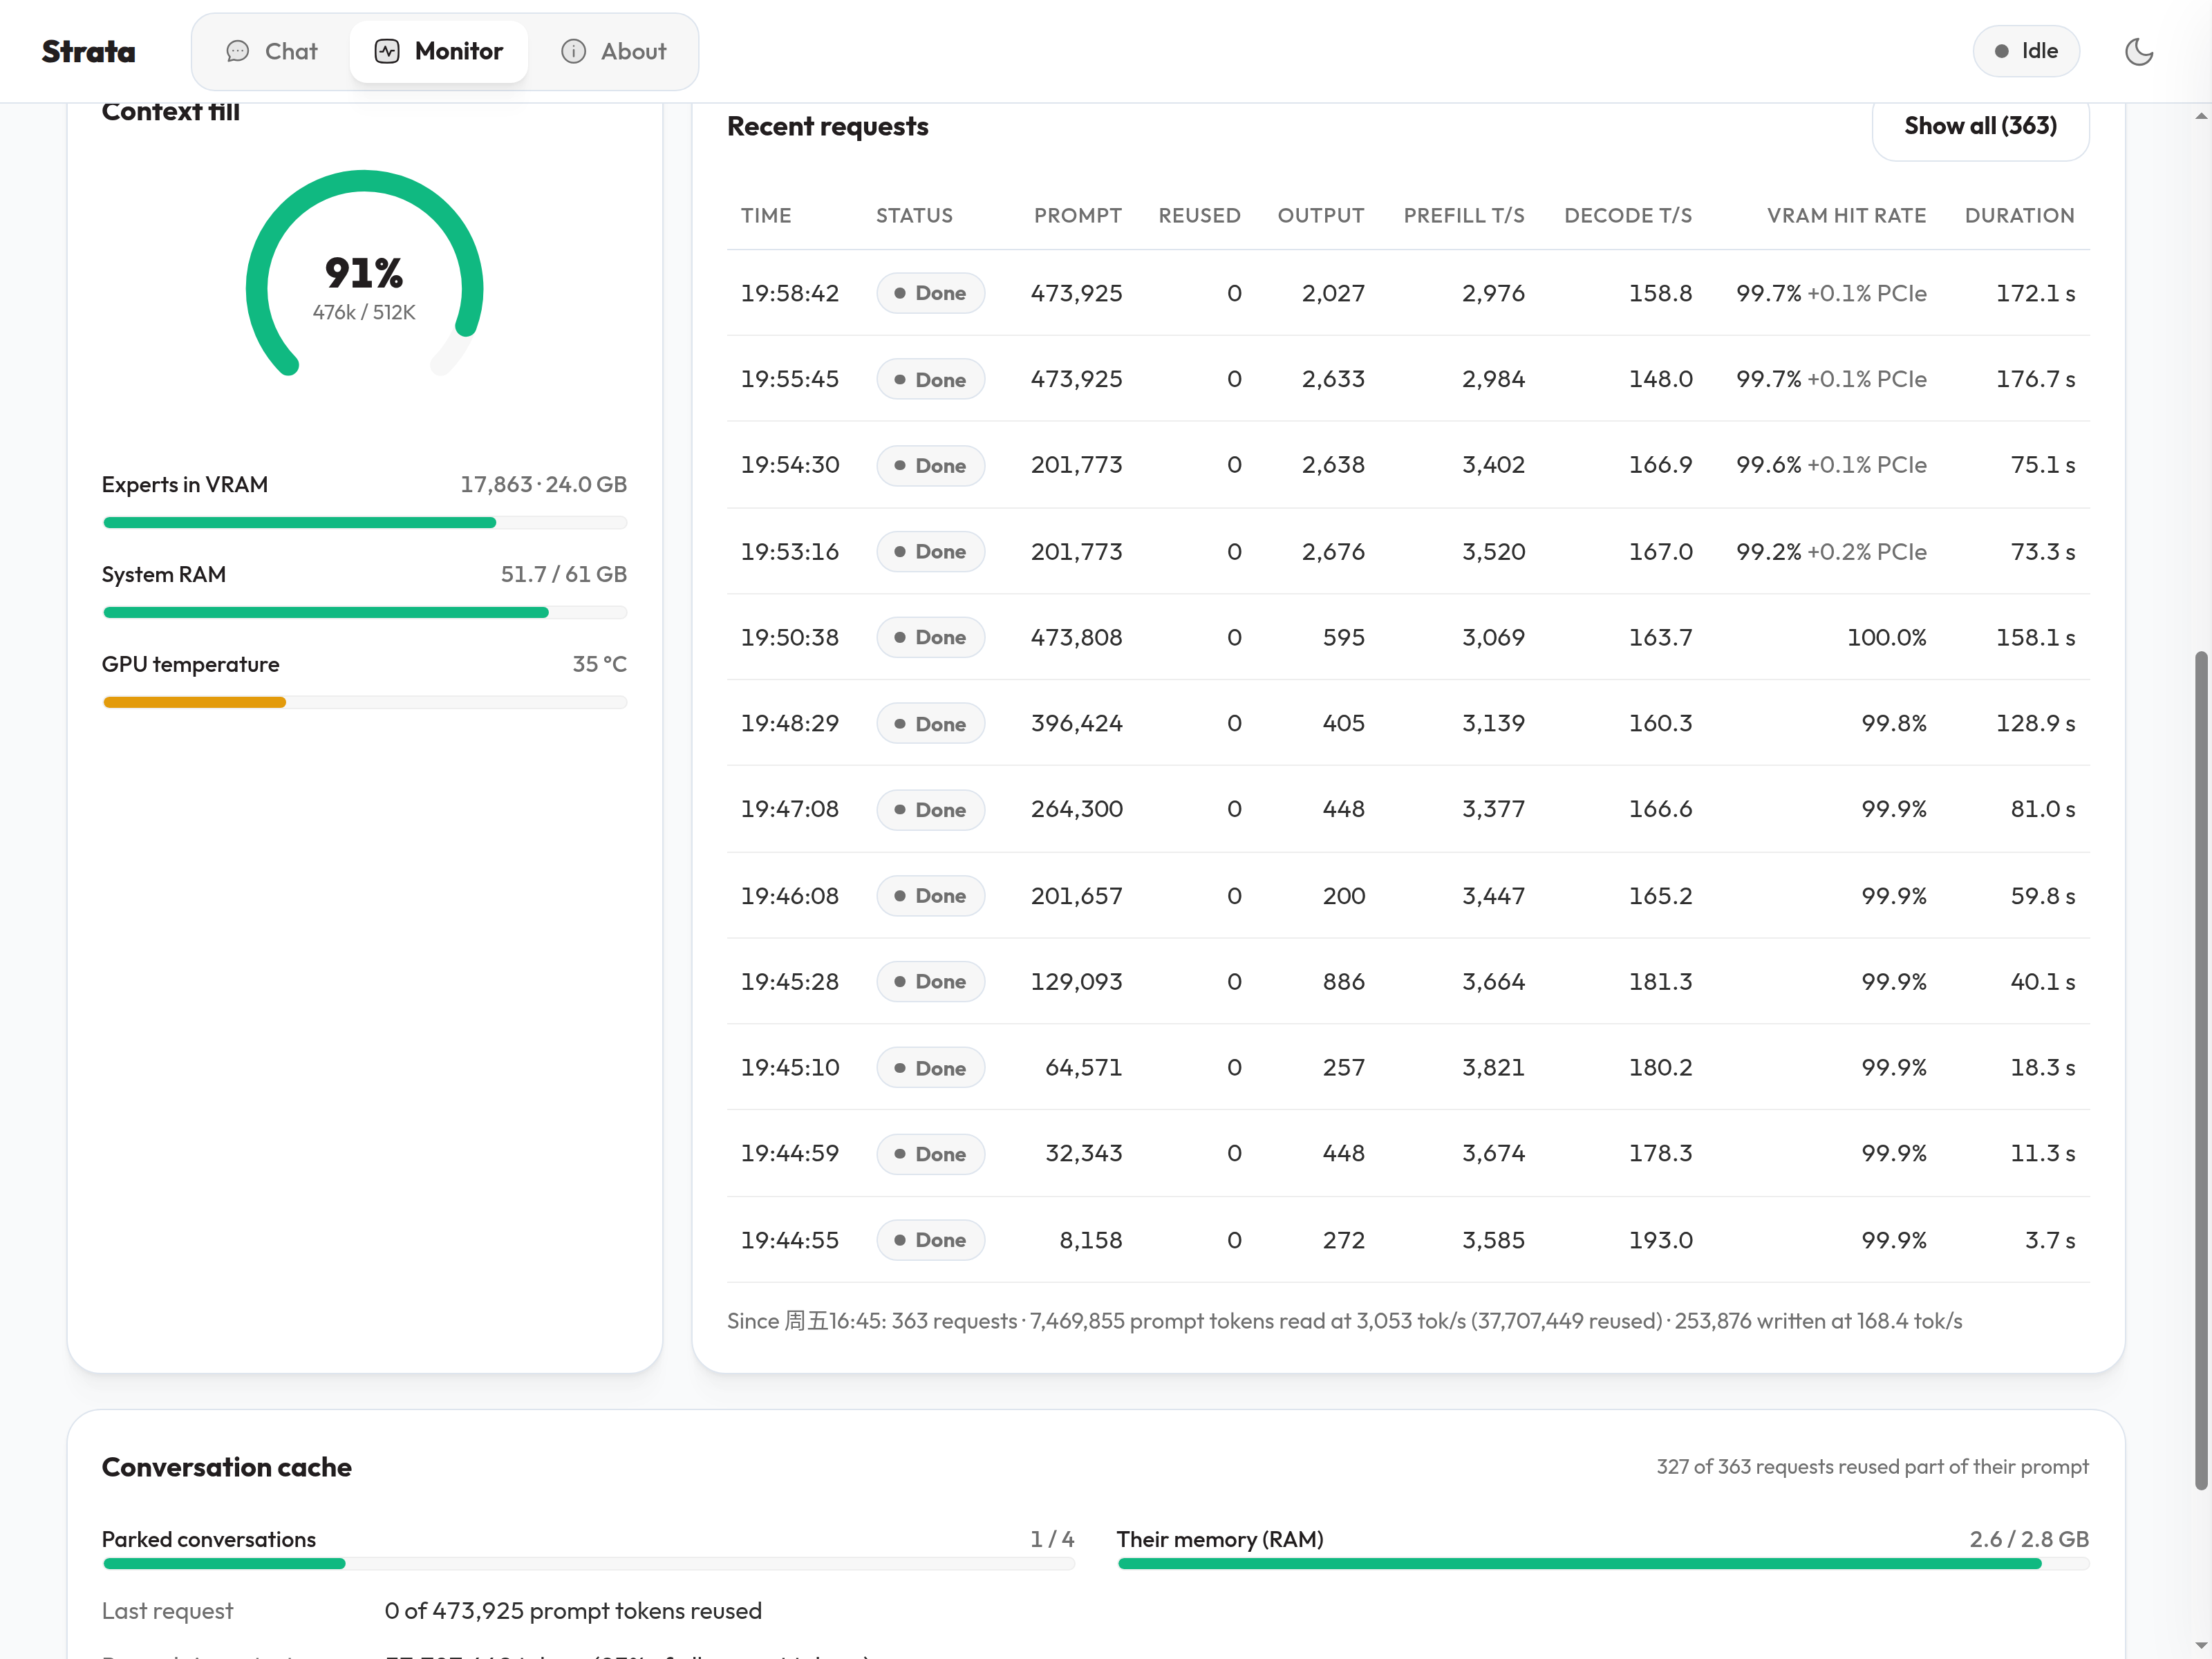
开跑前我以为 470K 会掉到 60-70 t/s,之前按每档 KV 体积外推就是这个数,结果实测 164,外推直接被打脸。测的时候还碰到个小问题:另一个会话也在用这个引擎,得等它 idle 再发,不然排队会把整个请求的时间拖长。
内存这块也顺便确认了一件事:九档跑下来系统可用内存一直在 9.0-9.7 GiB 晃,专家槽 17,863 一个没少,会话缓存 2.8GB 没动。也就是说 KV 池是启动时按 max-context 一次预留好的,请求深浅不额外吃内存和显存。以前我按两档之间的内存差去算 KV 成本,是错的,那些波动只是会话 park/evict 的噪声。
外推区质量对照
同一道四步算术题(一周出货多少箱 → 折成件数 → 分段打折 → 算总金额),分别塞进 20 万和 47 万 token 的文档里,各问两次:
- 20 万:2/2 正确
- 47 万:2/2 正确
- 中间量和终值都对得上:700 箱 / 25,900 件 / 166,800 元
yarn 外推已经超过模型训练长度 256K,检索和这种多步综合目前没看出退化,更复杂的推理我还没测,不敢下结论。

几个要注意的
- 别把旧数字连成曲线:上个帖子 262K 时代测的 245K 深度 85 t/s,是 0.1.39 那代引擎、另一套采样和 MTP 接受率下的结果;这次同样的 262K 深度复测是 166.6。
- 短样本会把速度读低:之前 470K 只读到 133.7 t/s,是只生成了 86 个 token;这次生成 595 个 token 读出来 163.7。
- 短 prompt 的 prefill 别当引擎上限:8K 那档只有 3,585,到 64K 才真正跑满(3,821)。
- 512K 差不多是这台机器的天花板:按 KV 账本算,再往上到 786K,内存余量会压到 2.5 GiB,正好是会话缓存 park 的门槛,多轮对话就保不住;1M 要 13.4 GiB 的 KV,直接超 60.7 GiB 可用内存,想上只能加到 128GB。
日常使用
512K 对我不是刚需,但偶尔整本手册、整份日志一次塞进去确实省事;平时 100K 上下最舒服,速度快、缓存也留得住。引擎从下午装好到现在三个多小时、三百多个请求,没重启也没 OOM。
