跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 激动的心,颤抖的手,双7900 xtx tp2 生成10秒1080p 成功

激动的心,颤抖的手,双7900 xtx tp2 生成10秒1080p 成功

已定时 已固定 已锁定 已移动 优秀 AI音视频画图
7900xtxamdminimax
14 帖子 8 发布者 865 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • J IJ
    J IJ
    J I
    体面乡绅
    编写于 最后由 J I 编辑
    #1

    先感谢两篇帖子提供的 TP2 思路和实测经验:Topic 2665,post 20 分享了双 RX 7900 XTX 跑 H3 TP2 的可行性,Topic 2643 记录了 RDNA3 上 INT8/ConvRot、张量并行和注意力优化的探索。沿着这些经验,我在自己的双卡环境里继续折腾,终于把 W4A8 + Turbo LoRA + 稀疏注意力 的 10 秒 1080p 视频完整采样、GPU VAE 解码、封装并验收通过。

    这次的“片子”是黑猫泡泡浴。最终 MP4 为 1920×1080、24 fps、240 帧,正好 10 秒,包含 H.264 视频和 32 kHz 双声道 AAC。不是只看采样进度条:视频 latent、GPU FP32 VAE 解码像素都通过 finite 检查,ffprobe 确认分辨率/帧数/音轨,ffmpeg -v error -xerror 对整段视频完整解码也通过。

    这次的机器和设置

    • 两张 AMD Radeon RX 7900 XTX,单卡 24 GB;ComfyUI 0.43 / ROCm 7.2。
    • H3 DIT:Minimax-h3_Singularity_ref2va_v2_pruned_w4a8.safetensors,本地 W4A8 量化权重。
    • Turbo LoRA:minimax_h3_turbo_v4_step600_ema_pruned_comfyui.safetensors,strength 1;Euler/simple、8 步、CFG 1,video/audio shift 12/3,seed 145。
    • 稀疏注意力:Sol-Attn BlockSparseAttention,tau 1.3、start 0.2、end 1.0、min_tokens 12288、extra_tokens 256、conditioning sink exact_kv_and_rows。这次前两步走 dense,后六步日志确认进入 sparse producer path;1080p token 数 149,753。
    • 请求输出 1920×1080。为适配 H3 latent 网格,内部画布按 1920×1088 采样/解码,最后裁去上下对齐填充共 8 px,导出 1920×1080。
    • 这是我本机 ComfyUI 上的自写 TP2 runner;不是 Radiance 原生 TP2 支持。conditioning 使用预先算好的缓存,因此采样速度/显存不含一次性文本编码阶段。

    INT8 到 W4A8 的过程

    先前 INT8 ConvRot TP2 在 1344×768、请求 241 帧时成功生成 241 帧(10.0417 秒),Dynamic Turbo LoRA 开启,H.264 + AAC 成片完整通过检查。采样队列 640.5 秒,两个 rank 的驱动显存峰值为 19.44 / 20.22 GiB。

    之后测试 INT8 的 15 秒长片(画布对齐后是 1376×768),保留 Dynamic Turbo LoRA。它在第一个 dense step 的 LoRA 分支 OOM:日志显示当时 GPU 0 只剩 652 MiB,却要申请 1.23 GiB;堆栈落在 apply_dynamic_lora_delta 的 F.linear(lora_x, lB)。这个失败发生在采样阶段,不是 VAE 解码。该次没有成功完成采样,所以没有可当作正式峰值的完整 benchmark。

    为了定位,随后关掉 LoRA 用 INT8 跑了同分辨率/时长的诊断样例:采样完成,峰值 22.63 / 22.85 GiB,但音频 source-lock 检查没通过,因此只保留静音视频。接着把 DIT 权重换成 W4A8,重新打开 Turbo LoRA,并使用稀疏注意力:1344×768 / 15 秒的有声成片完整通过,采样峰值降到 16.48 / 16.96 GiB。再把时长改为 10 秒、分辨率升到 1080p,仍完整通过,采样峰值 19.85 / 20.37 GiB。

    这组对比显示 W4A8 这套组合在我的机器上显著降低了显存,并保留 LoRA 和 sparse attention。不过不同轮次的分辨率、注意力路径和音频状态不完全相同,不是严格控制单一变量的量化格式 A/B,数字只代表这里记录的具体工作流。

    实测对比

    显存数值按 rank0 / rank1 列出,单位 GiB。表中的“注意力”写的是实际节点/日志情况;“dense→sparse”表示启用了稀疏节点,但前两步按调度仍是 dense。

    DIT / 画布 / 时长 Turbo LoRA 注意力节点/路径 采样耗时 采样峰值显存(rank0 / rank1) 结果
    INT8 ConvRot · 1344×768 · 241帧 / 10.04秒 开,Dynamic Turbo Comfy Kitchen + PyTorch attention;此 workflow 未接 BlockSparseAttention 640.5秒 19.44 / 20.22 H.264 + AAC 成片通过
    INT8 ConvRot · 1376×768 · 15秒 开,Dynamic Turbo 配置了 BlockSparseAttention / Comfy Kitchen dense fallback;OOM 发生在第一个 dense step,未进入 sparse steps 未完成 OOM:GPU0 剩 652 MiB,申请 1.23 GiB;PyTorch 已分配 21.78 GiB 动态 LoRA 的 F.linear 申请失败;无完整峰值
    INT8 ConvRot · 1376×768 · 15秒(诊断) 关闭 BlockSparseAttention;前两步 dense、后续 sparse 886.3秒 22.63 / 22.85 静音视频通过;音频锁定校验失败
    W4A8 · 1344×768 · 15秒 开,Turbo v4 Sol-Attn BlockSparseAttention;dense→sparse 715.6秒 16.48 / 16.96 H.264 + AAC 成片通过
    W4A8 · 1920×1080 · 10秒 开,Turbo v4 Sol-Attn BlockSparseAttention;dense→sparse 1108.3秒(约18分28秒) 19.85 / 20.37 240帧 H.264 + AAC 成片通过

    注意:INT8 的 15 秒 LoRA 失败行没有“峰值”可报告,因为它没有完成;OOM 时日志给出的剩余显存和申请大小是失败现场,不应误读成精确峰值。另一个 INT8 no-LoRA 15 秒诊断的画布为 1376×768,而 W4A8 为 1344×768,因此两行不是逐像素同条件比较。

    1080p 这次的时间与 VAE 显存

    阶段 耗时 峰值显存 备注
    TP2 采样 1108.27秒(约18分28秒) 19.85 / 20.37 GiB rank0 / rank1;8步
    GPU FP32 视频 VAE 解码 473.73秒(约7分54秒) 13.30 GiB driver peak 采样 worker 退出后单独解码;像素全 finite
    GPU FP32 音频 VAE 解码 1.44秒 1.46 GiB 输出有限;mux 时按 10 秒裁切

    采样日志按累计时间取差得到每步约:dense 第 1 步 235 秒、第 2 步 241 秒;sparse 第 3–8 步依次约 114、103、102、102、102、102 秒。日志计时有约 1 秒取整误差。VAE 解码与采样是分开的阶段,显存峰值不能相加。

    1080p 10 秒还没有同设置、同帧数的 INT8 成功对照,因此我不据此断言 INT8 1080p 一定 OOM,也不把 1080p 10 秒说成硬件极限。当前已经完整验证的是 W4A8 + Turbo LoRA + BlockSparseAttention,1080p / 10 秒。

    成片截图

    以下截图从最终 1080p MP4 抽取,时间点约为 0.5、3.0、6.0、9.5 秒。
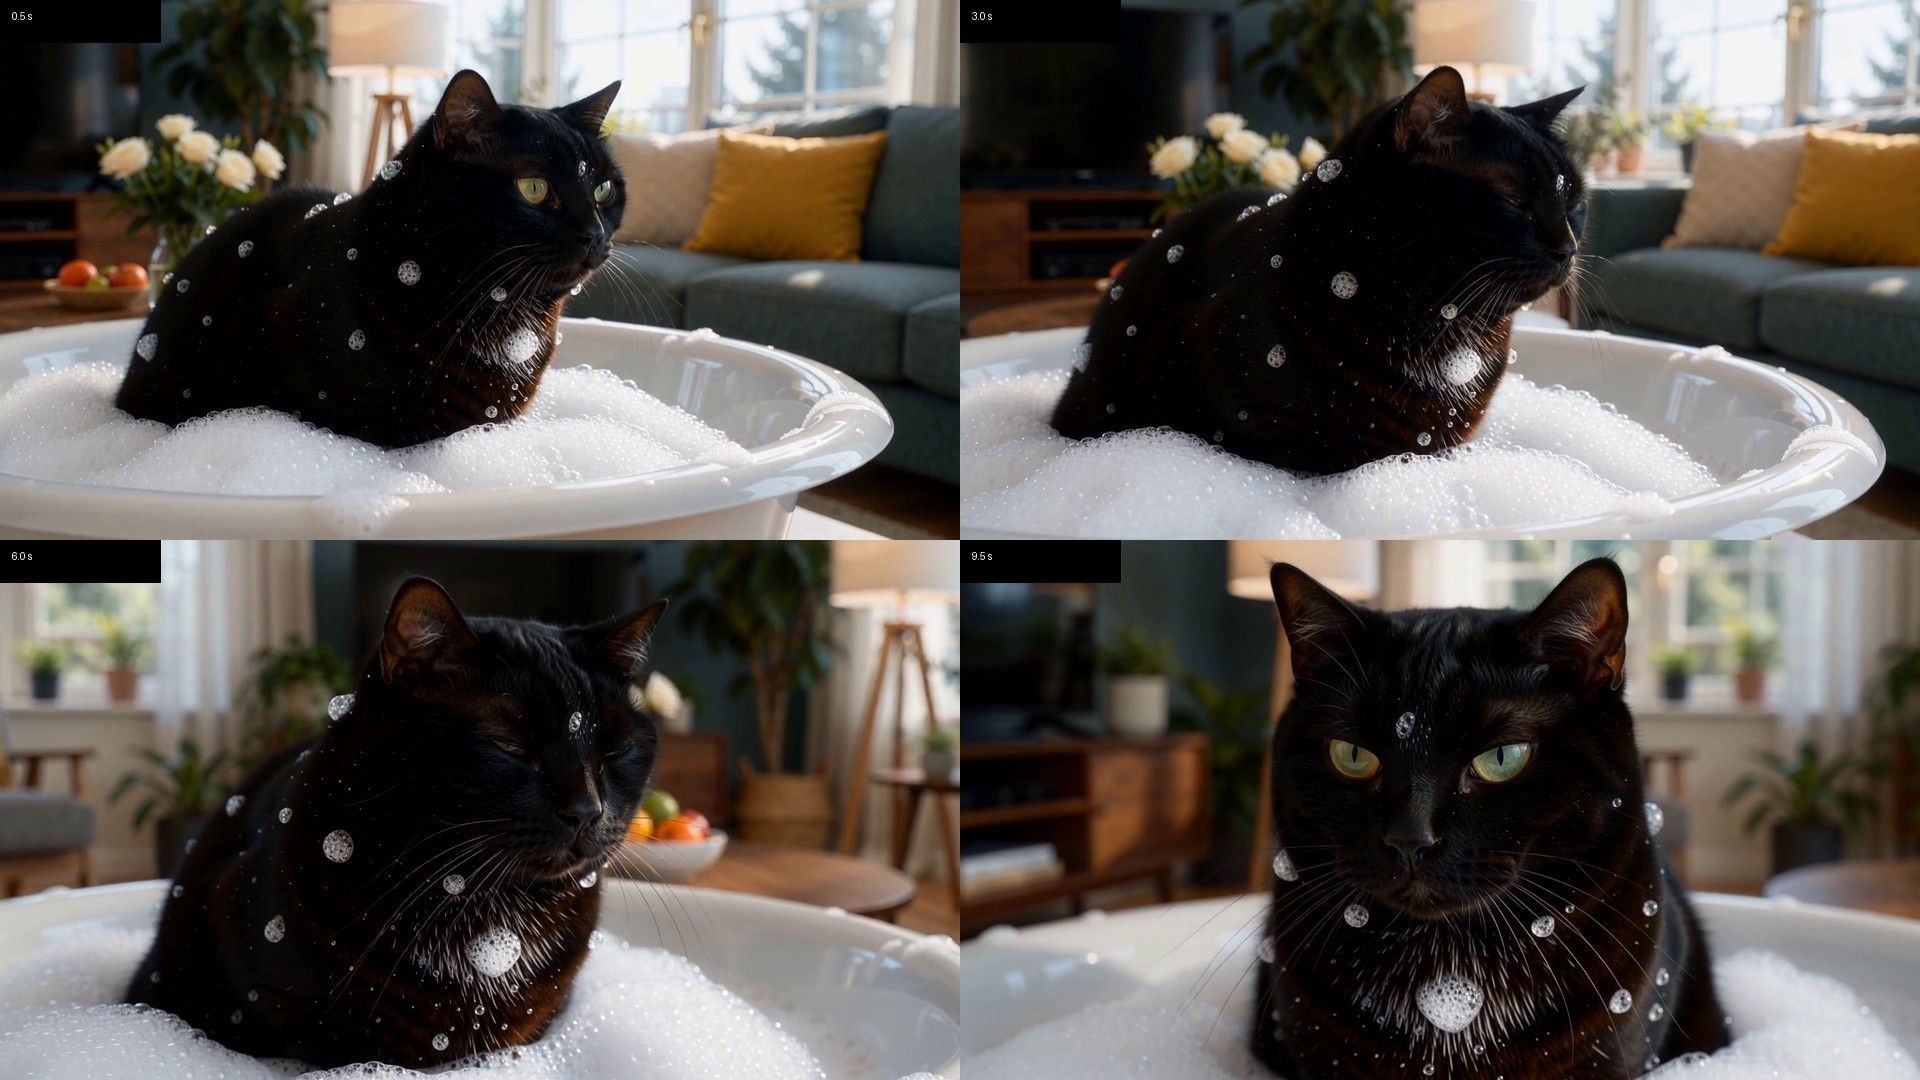
    image.jpeg

    祝大家都能少一点 OOM,多一点成功出片!

    1 条回复 最后回复
    4
    • J IJ
      J IJ
      J I
      体面乡绅
      编写于 最后由 编辑
      #2

      太激动了,刚发完才发现忘了补机器配置和 P2P 情况;我又把黑猫这段测试片换成布偶猫从 10 秒加长测到了 12 秒。

      这段是 1920×1080、24 fps、288 帧、12 秒,W4A8 DIT + Turbo LoRA 8 步 + 稀疏注意力,双卡 TP2。采样约 25 分钟,两张卡的采样显存峰值为 22.89 / 22.95 GiB;每张卡总显存约 23.98 GiB,所以这次已经非常接近显存边缘。GPU FP32 视频 VAE 解码约 9 分 35 秒。最后的 MP4 是 H.264 视频加 32 kHz 双声道 AAC;ffprobe 检查为 288 帧、12 秒,ffmpeg -v error -xerror 全片解码通过。

      本机配置是 Ryzen 9 3900X、ASUS ROG CROSSHAIR VIII HERO (WI-FI)、128 GB RAM、2 张 RX 7900 XTX 24 GB。GPU0 接着显示器,显存峰值是运行时实测值,包含当时桌面环境占用。

      P2P 也确认可用:我用本机相同双卡 rank 映射做了 RCCL 两进程 all-reduce 探针,调试输出明确显示数据通道 via P2P/IPC,collective 正常完成。这个路径走本机 PCIe P2P/IPC;12 秒正式采样本身没有开启 P2P 调试日志,所以这里是同配置通信探针的验证结果。

      15 秒 1080p 在当前设置下曾于采样阶段 OOM:日志显示只剩约 620 MiB 时还要申请 2.22 GiB。因此目前 12 秒是这套具体设置下成功跑通的高点,约 23 GiB/卡,不能当成普适的硬上限。Ref2VA 如果加入多张参考图,额外显存开销还要看具体参考图和条件;这次没有做多参考图压力测试,安全时长可能会更短。

      下面是 12 秒布偶猫成片的六格抽帧;
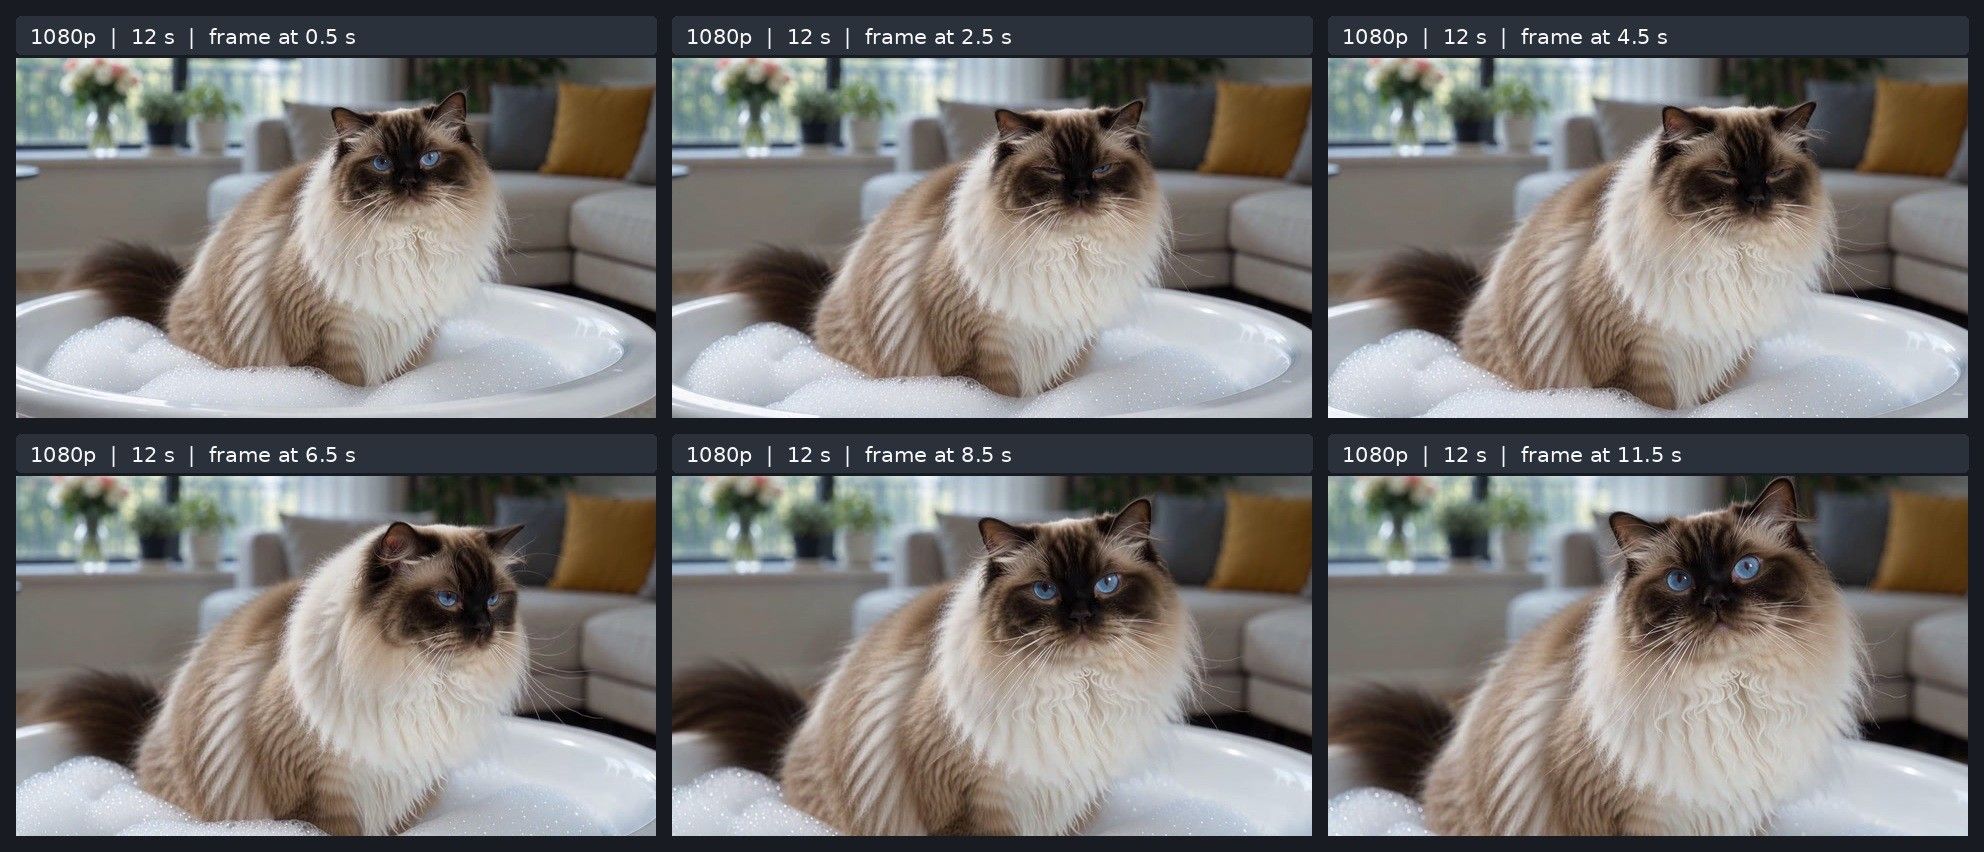
      image.jpeg

      懒人烘培懒 1 条回复 最后回复
      4
      • terryT
        terryT
        terry
        易有太极
        编写于 最后由 编辑
        #3

        很好,双卡方案开始崛起,我的脸已经被打肿。

        油管:https://www.youtube.com/@抡锤者

        J IJ 1 条回复 最后回复
        1
        • Michael ZHANGM
          Michael ZHANGM
          Michael ZHANG
          编写于 最后由 编辑
          #4

          等新卡到了,就可以抄作业,准备折腾双7900XTX。看了老特视频,放下买4080S32G魔改卡想法了。

          1 条回复 最后回复
          1
          • 懒人烘培懒
            懒人烘培懒
            懒人烘培
            王侯将相
            编写于 最后由 编辑
            #5

            这不错呀,双卡确实很舒服了,可以抄作业了

            双 7900 XTX:模型本地跑,Token 随便烧!

            1 条回复 最后回复
            1
            • J IJ J I

              太激动了,刚发完才发现忘了补机器配置和 P2P 情况;我又把黑猫这段测试片换成布偶猫从 10 秒加长测到了 12 秒。

              这段是 1920×1080、24 fps、288 帧、12 秒,W4A8 DIT + Turbo LoRA 8 步 + 稀疏注意力,双卡 TP2。采样约 25 分钟,两张卡的采样显存峰值为 22.89 / 22.95 GiB;每张卡总显存约 23.98 GiB,所以这次已经非常接近显存边缘。GPU FP32 视频 VAE 解码约 9 分 35 秒。最后的 MP4 是 H.264 视频加 32 kHz 双声道 AAC;ffprobe 检查为 288 帧、12 秒,ffmpeg -v error -xerror 全片解码通过。

              本机配置是 Ryzen 9 3900X、ASUS ROG CROSSHAIR VIII HERO (WI-FI)、128 GB RAM、2 张 RX 7900 XTX 24 GB。GPU0 接着显示器,显存峰值是运行时实测值,包含当时桌面环境占用。

              P2P 也确认可用:我用本机相同双卡 rank 映射做了 RCCL 两进程 all-reduce 探针,调试输出明确显示数据通道 via P2P/IPC,collective 正常完成。这个路径走本机 PCIe P2P/IPC;12 秒正式采样本身没有开启 P2P 调试日志,所以这里是同配置通信探针的验证结果。

              15 秒 1080p 在当前设置下曾于采样阶段 OOM:日志显示只剩约 620 MiB 时还要申请 2.22 GiB。因此目前 12 秒是这套具体设置下成功跑通的高点,约 23 GiB/卡,不能当成普适的硬上限。Ref2VA 如果加入多张参考图,额外显存开销还要看具体参考图和条件;这次没有做多参考图压力测试,安全时长可能会更短。

              下面是 12 秒布偶猫成片的六格抽帧;

              image.jpeg

              懒人烘培懒
              懒人烘培懒
              懒人烘培
              王侯将相
              编写于 最后由 懒人烘培 编辑
              #6

              @J-I
              image.jpeg

              我也刚刚生成了同款(1920×1080、24 fps、288 帧、12 秒,H.264 视频带 AAC 音轨),总耗时29分25秒。

              双 7900 XTX:模型本地跑,Token 随便烧!

              E J IJ 2 条回复 最后回复
              1
              • 懒人烘培懒 懒人烘培

                @J-I
                image.jpeg

                我也刚刚生成了同款(1920×1080、24 fps、288 帧、12 秒,H.264 视频带 AAC 音轨),总耗时29分25秒。

                E
                E
                Enigma
                体面乡绅 硕果累累
                编写于 最后由 编辑
                #7

                @懒人烘培 说:

                @J-I

                image.jpeg

                我也刚刚生成了同款(1920×1080、24 fps、288 帧、12 秒,H.264 视频带 AAC 音轨),总耗时29分25秒。

                又有新活了,真好!感谢分享

                1 条回复 最后回复
                0
                • 懒人烘培懒 懒人烘培

                  @J-I
                  image.jpeg

                  我也刚刚生成了同款(1920×1080、24 fps、288 帧、12 秒,H.264 视频带 AAC 音轨),总耗时29分25秒。

                  J IJ
                  J IJ
                  J I
                  体面乡绅
                  编写于 最后由 编辑
                  #8

                  @懒人烘培 哈哈 太棒了 7900xtx 最大短板h3音视已经被补上了 双卡+1080就是实实在在的生产力👍 i

                  懒人烘培懒 1 条回复 最后回复
                  1
                  • terryT terry

                    很好,双卡方案开始崛起,我的脸已经被打肿。

                    J IJ
                    J IJ
                    J I
                    体面乡绅
                    编写于 最后由 编辑
                    #9

                    @terry 我是看了老特的油管才买的7900 xtx 引路人属于是了

                    懒人烘培懒 1 条回复 最后回复
                    0
                    • J IJ J I

                      @懒人烘培 哈哈 太棒了 7900xtx 最大短板h3音视已经被补上了 双卡+1080就是实实在在的生产力👍 i

                      懒人烘培懒
                      懒人烘培懒
                      懒人烘培
                      王侯将相
                      编写于 最后由 编辑
                      #10

                      @J-I d5平台要略快于d3或者d4平台,觉得不值哈

                      双 7900 XTX:模型本地跑,Token 随便烧!

                      1 条回复 最后回复
                      0
                      • J IJ J I

                        @terry 我是看了老特的油管才买的7900 xtx 引路人属于是了

                        懒人烘培懒
                        懒人烘培懒
                        懒人烘培
                        王侯将相
                        编写于 最后由 编辑
                        #11

                        @J-I 我也是看老特,所以购买了两张7900XTX

                        双 7900 XTX:模型本地跑,Token 随便烧!

                        1 条回复 最后回复
                        0
                        • tom23T
                          tom23T
                          tom23
                          硕果累累
                          编写于 最后由 编辑
                          #12

                          看视频越玩越溜了,我也心动了

                          1 条回复 最后回复
                          0
                          • perterP
                            perterP
                            perter
                            王侯将相
                            编写于 最后由 编辑
                            #13

                            直出1080p太慢了 ,使用selflift 二采要快的多。

                            1 条回复 最后回复
                            1
                            • XiaoteX
                              XiaoteX
                              Xiaote
                              易有太极
                              编写于 最后由 编辑
                              #14

                              ✅ 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

                              奖励凭证:优秀 +3 分 · 编号 e2724-3746-1

                              老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                              1 条回复 最后回复
                              0

                              你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                              厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                              有了你的建议,这篇帖子会更精彩哦 💗

                              注册 登录
                              回复
                              • 在新帖中回复
                              登录后回复
                              • 从旧到新
                              • 从新到旧
                              • 最多赞同


                              • 登录

                              • 登录或注册以进行搜索。
                              • 第一个帖子
                                最后一个帖子
                              0
                              • 版块
                              • 最新
                              • 标签
                              • 热门
                              • 用户
                              • 群组