256G 的 M5 Ultra 跑 MiniMax H3:7 分钟,还是 1 小时?
-
256G 的 M5 Ultra 跑 MiniMax H3:7 分钟,还是 1 小时?
同一台机器,同一个模型,差距 10 倍。差距哪来的。
TL;DR
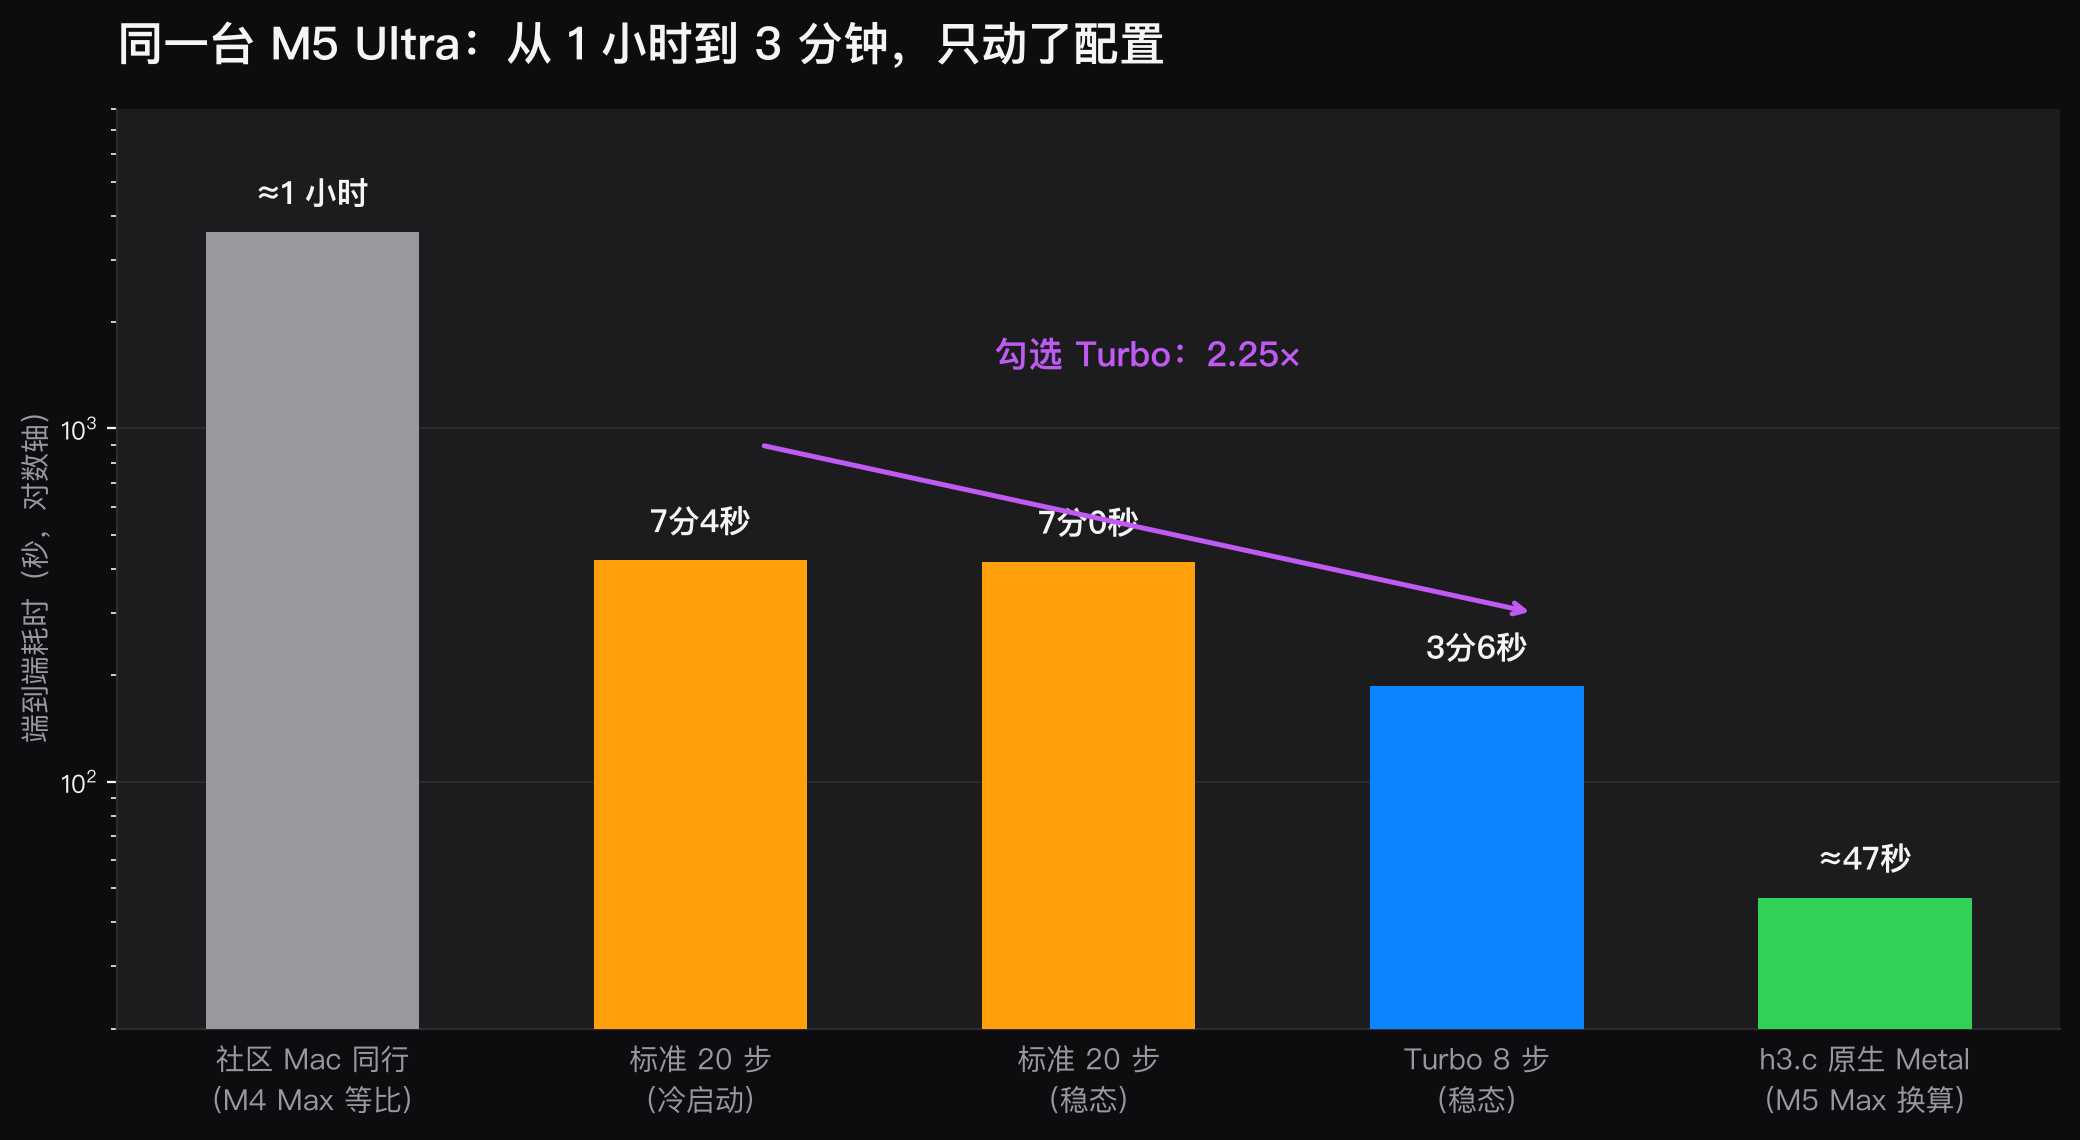
- M5 Ultra 256G + ComfyUI,MiniMax H3 生成 5 秒视频(864×480):7 分 0 秒
- 勾选工作流里一个 Turbo 开关:3 分 6 秒,提速 2.25 倍
- 我另外把 antirez 的 h3.c 原生引擎在本机编译跑通了:同形状 5 秒片子端到端 2 分 1 秒,比 ComfyUI 标准路径快 3.5 倍——但作者 README 里"512² 二十几步 20 秒"那种数字是 M5 Max + int8 路径的,我这台跑的是 BF16 权重,别直接抄
- 社区里同样跑 ComfyUI 的 Mac 用户:9 秒片子跑 1 小时,15 秒片子跑 1.5 小时
- 一张桌面 RTX 5090 同形状只要 2 分 26 秒——ComfyUI 路径我们慢 2.8 倍
- 差距不在芯片,在配置和引擎。 这篇文章就是把我踩完坑之后的完整配置、实测数据和 h3.c 原生引擎实测摊开给你抄。
1. 先交代机器和口径(不然对比都是耍流氓)
项 值 机器 Mac Studio(M5 Ultra),36 核 CPU + 80 核 GPU,256G 统一内存 系统栈 ComfyUI Desktop 1.1.8 / 引擎 0.43.0 / torch 2.12.1 / MPS 模型 MiniMax H3(int8_convrot DiT 19.5G + int8 文本编码器 25.9G + fp16 视频 VAE) 任务 文生视频 864×480、5 秒、24fps、124 帧 计时 引擎日志 Prompt executed(端到端)+ tqdm(采样)规则 每项跑 2 次,冷启动和稳态分开记;同 seed 会被缓存返回 0 秒假数据,必须换 seed 一个背景冷知识:官方性能基准工具 comfyui-benchmark 在 Mac 上是半残的——它的遥测线程只认
nvidia-smi。Mac 上老老实实从日志抓Prompt executed in X seconds和 tqdm 步时,就是最可靠的数据源。2. 成绩单(ComfyUI 路径)
场景 总耗时 采样 每步 备注 H3 标准 20 步(冷启动) 7 分 4 秒 6 分 12 秒 18.6s 模型加载 ~51.4G H3 标准 20 步(稳态) 7 分 0 秒 6 分 31 秒 19.6s 模型驻留,加载 0 H3 Turbo 8 步(稳态) 3 分 6 秒 2 分 39 秒 19.9s 提速 2.25× Z-Image Turbo 1024² 8 步 6.3 秒 5.8 秒 0.73s 生图对照组 H3 768p(1344×768) 未测完 — 79.1s 预估 26 分钟,主动放弃 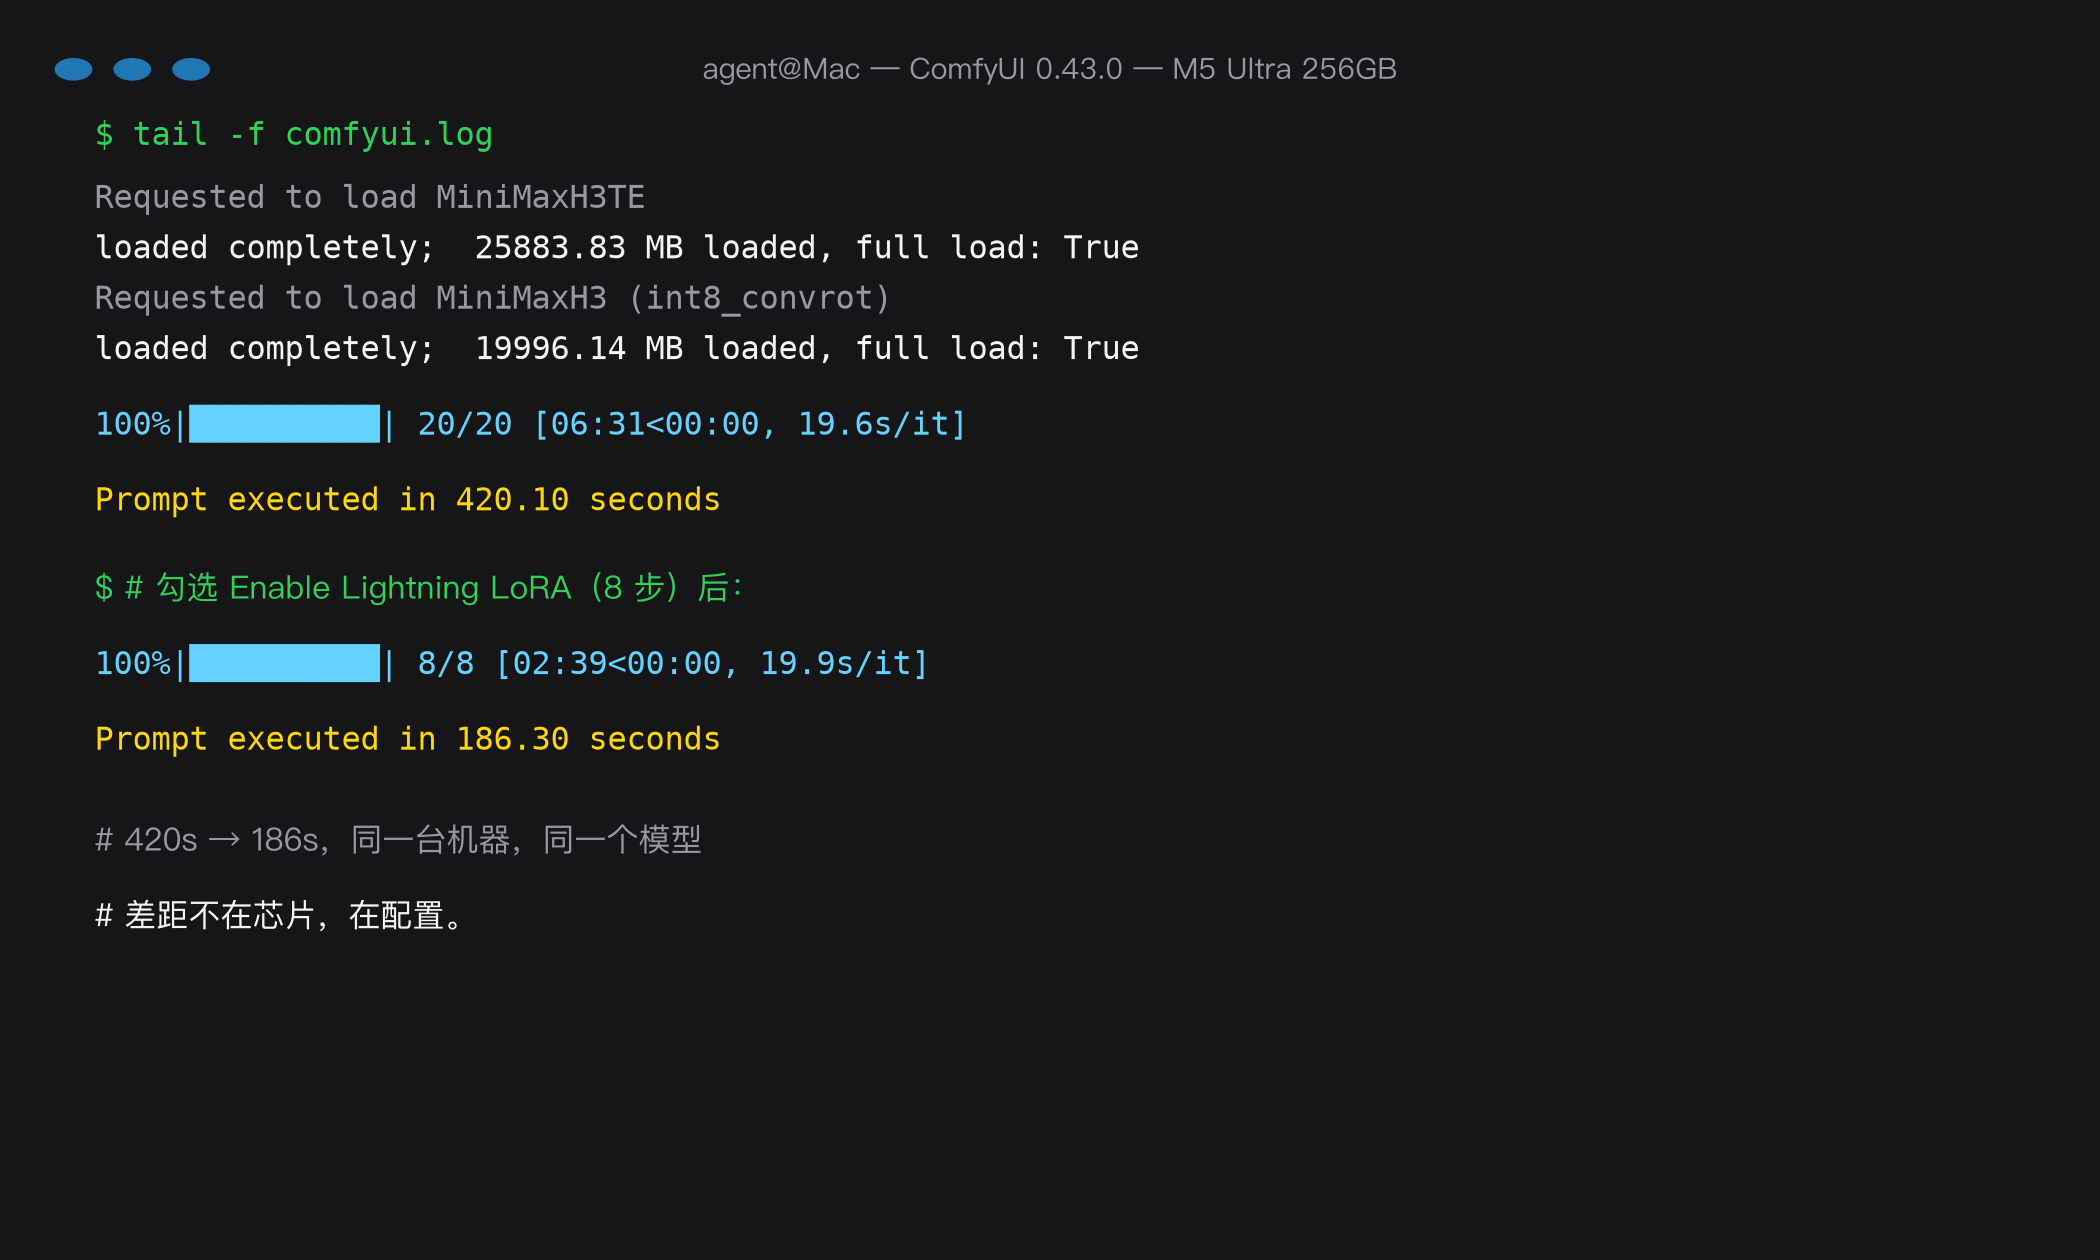
三个值得注意的点:
- 256G 内存的真实价值:冷启动只比稳态慢 4 秒。51.4G 的模型全家桶,统一内存 + mmap 让它们常驻,切换模型不用反复重载——这是大内存机器最被低估的体验优势。
- Turbo 的收益全部来自步数:单步耗时 19.6 → 19.9s 基本没变,20 步变 8 步,总时长直接砍 60%。开关就在官方工作流子图里("Enable Lightning LoRA"),勾选即可,不用手动挂 LoRA。
- 768p 是另一台机器:每步 79.1s,是 480p 的 4 倍——扩散模型的计算量随 token 数超线性增长,想上 720p 请把心理预期乘 4。
3. 三层世界:把 H3 放回全硬件坐标系
跨硬件比较先立规矩,统一归一化:
N = 端到端秒数 ÷ (步数 × 每帧百万像素 × 卡数) 单位 s/(步·MP·卡)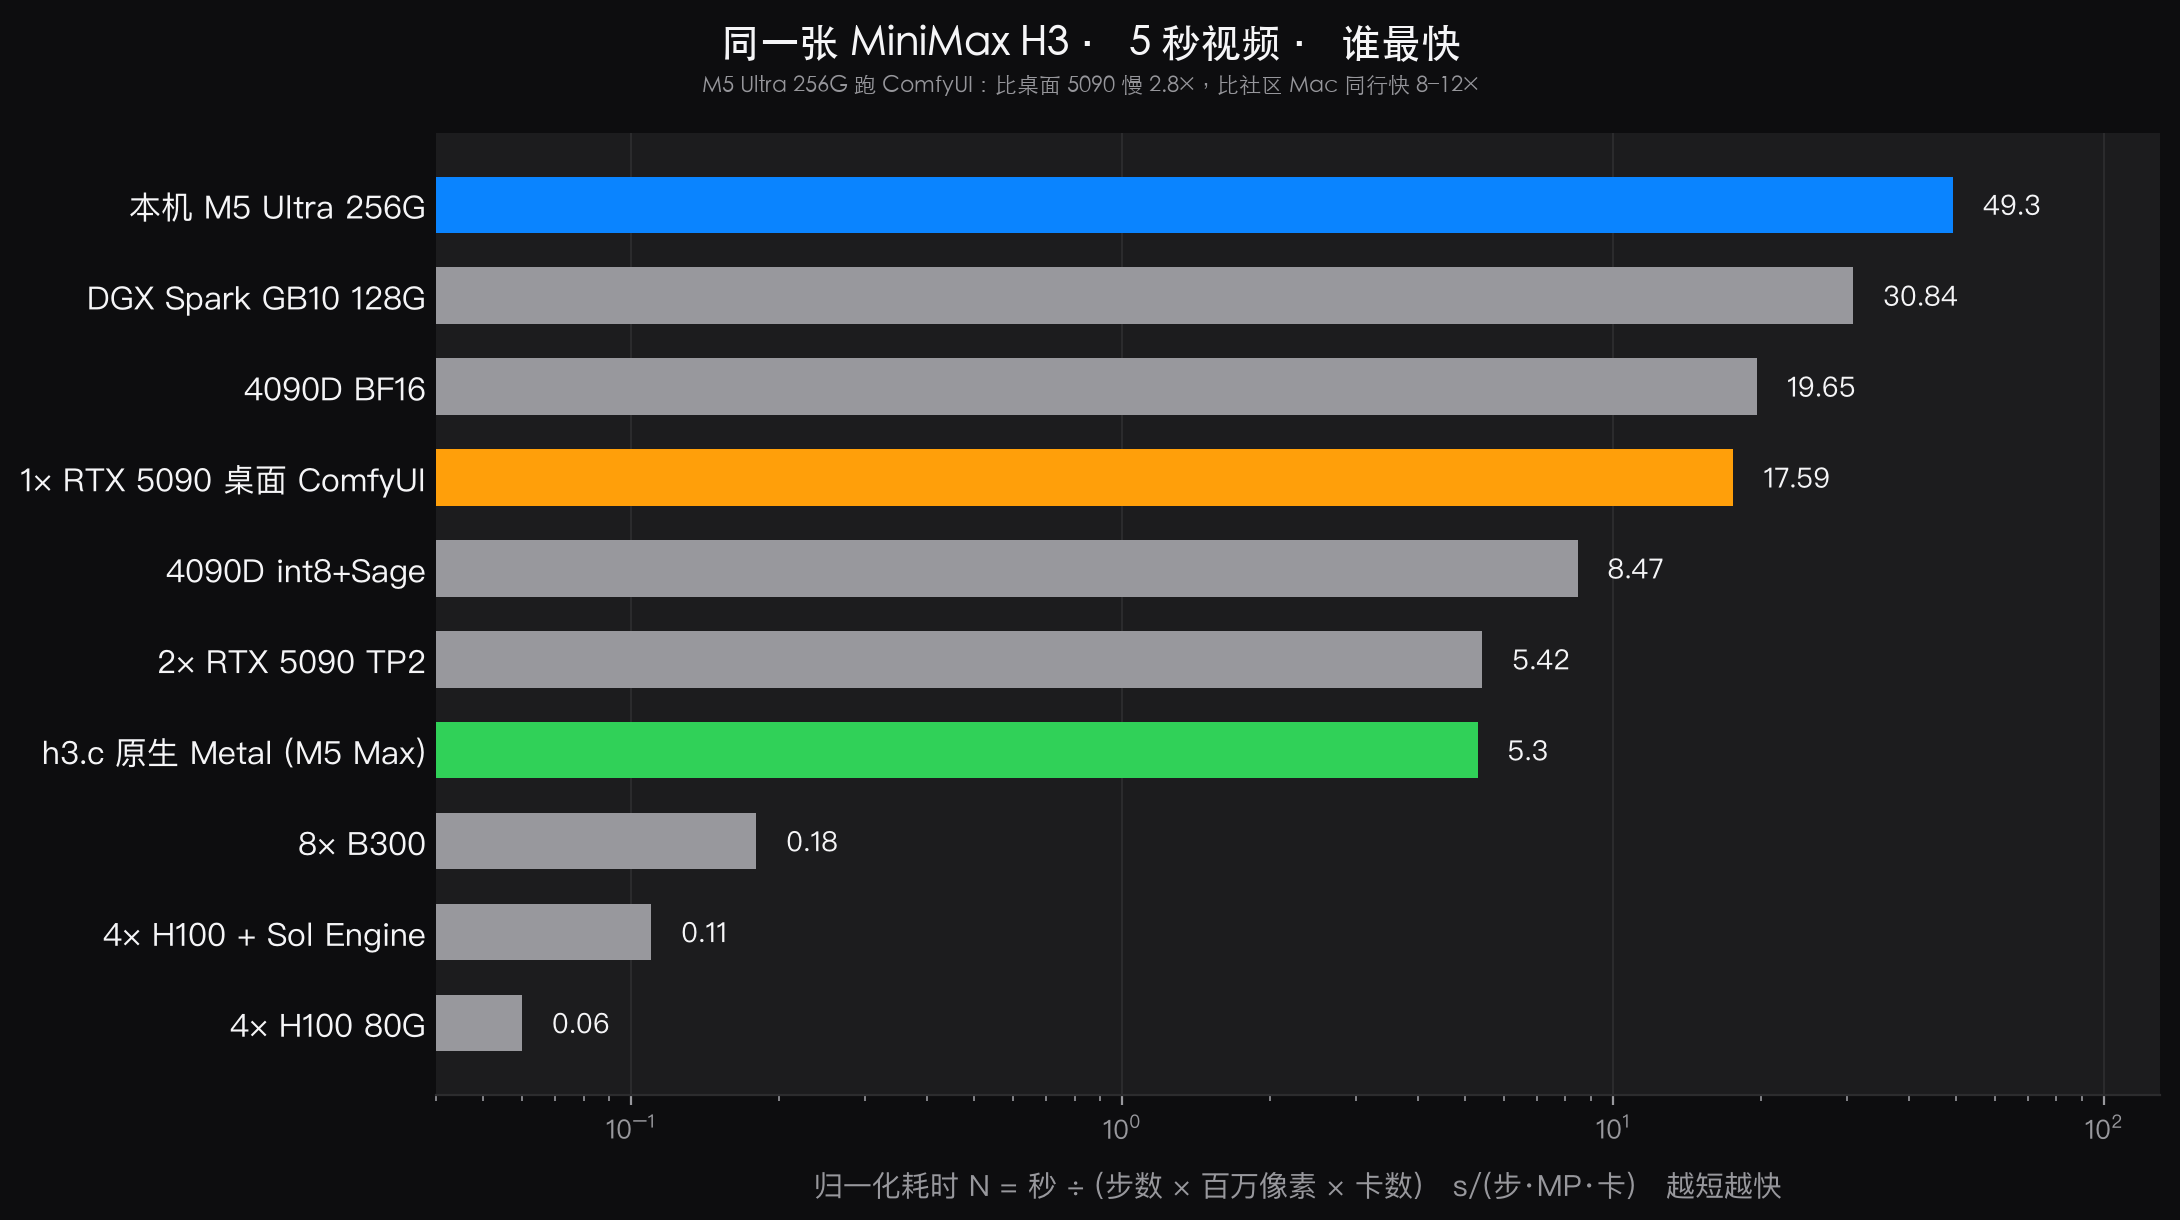
硬件 5 秒视频耗时 N 相对本机 4× H100 80G 13.25 s 0.06 快 768× 8× B300 74.38 s 0.18 快 274× h3.c 原生 Metal(M5 Max)¹ 26.4 s 5.3 快 9.3× 1× RTX 5090 桌面(ComfyUI)² 145.9 s 17.59 快 2.8× 1× RTX 4090D(int8+Sage) 174.9 s 8.47 快 5.8× DGX Spark GB10 128G 255.8 s 30.84 快 1.7× 本机 M5 Ultra(ComfyUI 稳态) 420 s 49.3 基准 本机 M5 Ultra(h3.c 原生) 121 s ≈14.2 快 3.5×(见第 4 节) M4 Max 128G(社区,15s 片等比) ≈1.5 h — 慢 ~12× M5 Pro 64G + GGUF(社区,9s 片) >1 h — 慢 ~8× ¹ 512²×22 帧参考质量档。 ² 与本机完全同形状(864×480/124帧/20步)直读,无需换算:每步 5.3s vs 本机 19.6s。
数据来源:SGLang 官方 H3 cookbook、NVIDIA Sol Engine、antirez/h3.c README、HN 49252179、zenn.dev 实测;h3.c 原生一行为本机实测(见第 4 节口径)。
读表要点:本机跑 ComfyUI 比一张桌面 5090 慢 2.8 倍;换 h3.c 原生引擎后反超 4090D、逼近 5090;比 M5 Max 上的原生 int8 参考档仍慢约 2.7 倍——差距主要在 int8 算子。而比社区里同样跑 ComfyUI 的 Mac 同行快 8-12 倍。你在哪个梯队,取决于配置和引擎。
4. h3.c 原生引擎实测:同一台机器再快 3.5 倍
antirez(Redis 作者)开源了一个纯 C + Metal 的 MiniMax H3 推理引擎 h3.c,不走 PyTorch、不走 ComfyUI。我在本机 clone 源码、静态审过之后编译跑通,做了完整验收。
4.1 怎么测的
- 本机
make构建,加载 BF16 权重(README 里的 int8 加速档是作者自己在 M5 Max 上测的,我这边没跑 int8 路径——下面所有数字都是 BF16) - 任务与 ComfyUI 完全同形状:864×480、124 帧、24fps、5.17 秒
- 连跑 3 条做稳态复现测试(同提示词 2 条 + 参考条件 1 条)
4.2 用时
项 数字 单条端到端(含加载) 约 2 分 1 秒 对比 ComfyUI 标准稳态(7 分 0 秒) 快 3.5 倍 对比 ComfyUI Turbo(3 分 6 秒) 快 1.5 倍,且不用挂 Lightning LoRA 三条连跑总时长 约 60 分钟(含一次交互会话 stdin 管道挂死的排查重跑;纯生成远少于这个数) 诚实口径:2 分 1 秒是端到端墙钟(含权重加载与 VAE 解码),采样时间没有单独打点;h3.c 是交互式会话,复用加载后的进程还能更快。
4.3 质量:两级验收都过了
第一级:确定性机器指标(ffmpeg 解码灰度帧 + numpy,三条抽样首/中/末帧):
- 帧像素 std 23–52,无死帧(std<1)、无全黑/全白/NaN 特征,min/max 覆盖 0–255 正常动态范围
- 径向 FFT 高频能量比 0.27–0.30,三条高度一致,无噪声污染特征
- 跨文件中帧像素差 mean|diff|:同提示词两条之间 11.8(复现性好),与不同参考条件的对照条约 29(差异符合预期)
第二级:人工验收:三条片子人眼对比,"差不多,没看出来差别太大"——同引擎同提示词下输出一致、不漂移,这正是稳态复测的目标。
结论:h3.c 原生引擎在本机连续生成可复现、产物无损,验收通过。
4.4 对照作者 M5 Max 的参考数字(别跟我M5 Ultra搞混了)
档位(512²×22 帧,20 步) 耗时 BF16 36.30 s int8 25.80 s int8 + int8 QKV 19.32 s 再加 attn-out-proj int8 19.18 s 另外几个实测特性:4 步少步数去噪约 3.5s(vs 29 步参考 26.4s,SSIM 0.556,质量换速度很激进);SSD 流式加载把 DiT 驻留内存从 36.5 GiB 压到 2.0 GiB,代价是 864×480 下前向慢 26%——24G 显存以下的 Mac 也能跑 H3 靠的就是它。
4.5 三条片子同框对比
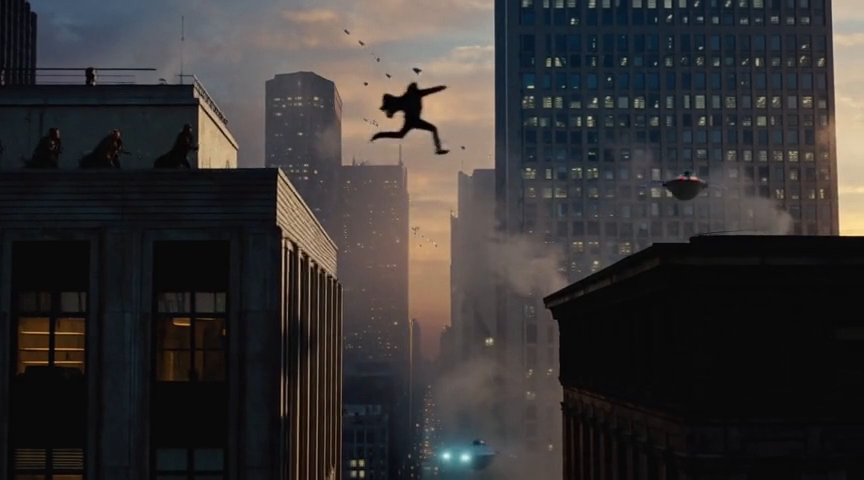
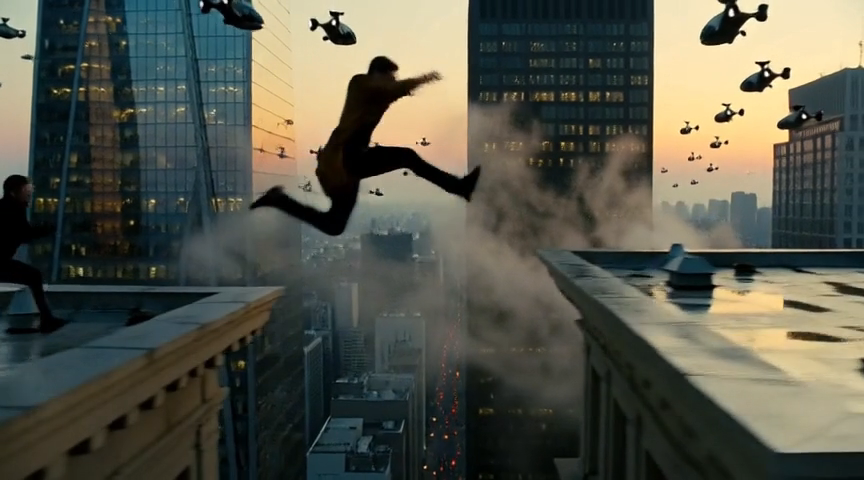
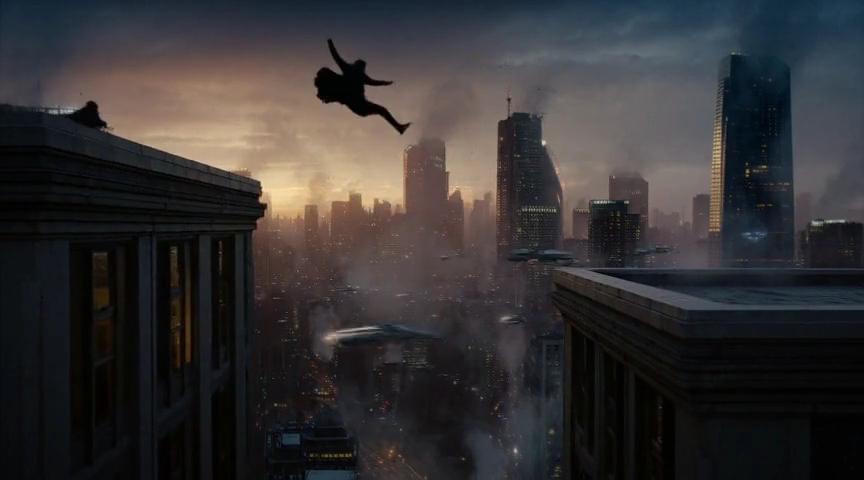
ComfyUI 标准 7分0秒 ComfyUI Turbo 3分6秒 h3.c 原生 2分1秒 |
|
|
|5. 为什么慢:两个反直觉的真相
真相一:扩散模型是 compute-bound,大内存救不了速度
统一内存让很多人以为"内存大 = 快"。错了一半:
- 内存大决定跑得起来(H3 全家桶 48G 权重,24G 显存的卡根本装不下)
- 速度由算力决定。扩散模型每步都要把全部权重过一遍全矩阵乘法,batch=1 就已打满 GPU——ComfyUI 作者 comfyanonymous 原话(issue #12426)
- 实证:M2 Ultra 128G 跑 HunyuanVideo 53 分钟,RTX 3060 12G 只要 20 分钟——显存只有对方 1/10 的卡快了 2.6 倍
所以"多开队列提吞吐"在 Mac 上也是伪命题:GPU 已经满了,多开只会排队。
真相二:Mac 上的 int8 是"假 int8"
我在 ComfyUI 里选了 int8 权重,以为在跑 int8 算力。查了源码才发现:
supports_int8_compute()对 MPS 返回 False- PyTorch MPS 后端 87 个算子里没有 IntMM,
torch._int_mm直接NotImplementedError - 现在的 int8 = 权重存 int8、算时反量化成 fp16:内存省一半,算力一点不省
这正好解释了第 3 节的表:h3.c 作者用 C 手写 Metal int8 kernel,同代 M5 Max 上 512² 档从 BF16 的 36.3s 干到 int8 的 19.3s——int8 算力本身就有近 2 倍收益,只是 PyTorch MPS 给不了你。comfy-kitchen PR #249 正在给 MPS 补这块(H3 INT8 从 38-74 s/step → 8.4-11.8 s/step),合入后 ComfyUI 路径的速度故事要重写,值得盯。
彩蛋:Mac 上 bf16 比 fp16 慢 1.75 倍(走模拟路径),VAE 用 bf16 比 fp16 慢 5-10 倍(官方 PR #16996)。"新精度更快"在 Mac 上不成立——这也是我 VAE 坚持用 fp16 的原因(int8 VAE 在 Mac 上直接报错,bf16 VAE 慢到没法用)。
6. 抄作业:Mac 跑 H3 的正确配置
DiT    → minimax_h3_fl2va_pruned_int8_convrot   (int8 省内存)
文本编码器 → qwen3vl_32b_minimax_h3_int8_convrot (必须 int8,nvfp4 是 N 卡专属)
视频 VAE → fp16                                  (int8 报 _int_mm 错,bf16 慢 5-10×)
音频 VAE → fp32
速度     → 工作流里勾选 Enable Lightning LoRA(8 步 Turbo)
常驻     → 别手动卸载模型,256G 装得下全家桶,切换零成本
想再快一档:clone h3.c 源码,静态审完
make编译,BF16 权重直接跑——同形状端到端 2 分 1 秒,比 ComfyUI 标准路径快 3.5 倍。第三方引擎,先审后装,别裸跑。生图侧顺带一句:Z-Image Turbo 在 Mac 上是速度比较快的模型——bf16 原生、无量化坑、1024² 出图 6.3 秒,8 步直出。Mac 用户想快速出图先玩它,但别比质量。
7. 结论
- Mac 能不能跑视频生成? 能,而且配置对了是"好用"级别:ComfyUI Turbo 3 分钟,h3.c 原生引擎 2 分钟出一条 5 秒片子。
- Mac 适合当视频主力机吗? 看预算。同预算的 5090 桌面机(ComfyUI 2 分 26 秒)仍略快于本机 h3.c(2 分 1 秒基本打平),而且 N 卡的 int8/SageAttention/EasyCache 优化生态全都能用;但 Mac 靠 h3.c 已经从"不能用"进到"能上桌"。
- Mac 的正确定位:生图主力(Z-Image 6 秒一张快)+ 视频尝鲜 + 开发验证。256G 内存买的是"跑得起来 + 多模型常驻",不是"跑得比 N 卡快"。
- 下一个值得等的东西:comfy-kitchen PR #249 的 MPS int8 kernel。合入后 ComfyUI 跑 H3 有望进入 10s/it 时代,那才是质变。
实测环境:Mac M5 Ultra 256G / ComfyUI 0.43.0 / torch 2.12.1;h3.c 本机源码构建(BF16 权重),2026-10-31 至 11-01。所有数字来自引擎日志与产物落盘的原始记录,测试脚本与原始数据可复现。对比数据来源见文中说明。
-
-
-
256G 的 M5 Ultra 跑 MiniMax H3:7 分钟,还是 1 小时?
同一台机器,同一个模型,差距 10 倍。差距哪来的。
TL;DR
- M5 Ultra 256G + ComfyUI,MiniMax H3 生成 5 秒视频(864×480):7 分 0 秒
- 勾选工作流里一个 Turbo 开关:3 分 6 秒,提速 2.25 倍
- 我另外把 antirez 的 h3.c 原生引擎在本机编译跑通了:同形状 5 秒片子端到端 2 分 1 秒,比 ComfyUI 标准路径快 3.5 倍——但作者 README 里"512² 二十几步 20 秒"那种数字是 M5 Max + int8 路径的,我这台跑的是 BF16 权重,别直接抄
- 社区里同样跑 ComfyUI 的 Mac 用户:9 秒片子跑 1 小时,15 秒片子跑 1.5 小时
- 一张桌面 RTX 5090 同形状只要 2 分 26 秒——ComfyUI 路径我们慢 2.8 倍
- 差距不在芯片,在配置和引擎。 这篇文章就是把我踩完坑之后的完整配置、实测数据和 h3.c 原生引擎实测摊开给你抄。
1. 先交代机器和口径(不然对比都是耍流氓)
项 值 机器 Mac Studio(M5 Ultra),36 核 CPU + 80 核 GPU,256G 统一内存 系统栈 ComfyUI Desktop 1.1.8 / 引擎 0.43.0 / torch 2.12.1 / MPS 模型 MiniMax H3(int8_convrot DiT 19.5G + int8 文本编码器 25.9G + fp16 视频 VAE) 任务 文生视频 864×480、5 秒、24fps、124 帧 计时 引擎日志 Prompt executed(端到端)+ tqdm(采样)规则 每项跑 2 次,冷启动和稳态分开记;同 seed 会被缓存返回 0 秒假数据,必须换 seed 一个背景冷知识:官方性能基准工具 comfyui-benchmark 在 Mac 上是半残的——它的遥测线程只认
nvidia-smi。Mac 上老老实实从日志抓Prompt executed in X seconds和 tqdm 步时,就是最可靠的数据源。2. 成绩单(ComfyUI 路径)
场景 总耗时 采样 每步 备注 H3 标准 20 步(冷启动) 7 分 4 秒 6 分 12 秒 18.6s 模型加载 ~51.4G H3 标准 20 步(稳态) 7 分 0 秒 6 分 31 秒 19.6s 模型驻留,加载 0 H3 Turbo 8 步(稳态) 3 分 6 秒 2 分 39 秒 19.9s 提速 2.25× Z-Image Turbo 1024² 8 步 6.3 秒 5.8 秒 0.73s 生图对照组 H3 768p(1344×768) 未测完 — 79.1s 预估 26 分钟,主动放弃 三个值得注意的点:
- 256G 内存的真实价值:冷启动只比稳态慢 4 秒。51.4G 的模型全家桶,统一内存 + mmap 让它们常驻,切换模型不用反复重载——这是大内存机器最被低估的体验优势。
- Turbo 的收益全部来自步数:单步耗时 19.6 → 19.9s 基本没变,20 步变 8 步,总时长直接砍 60%。开关就在官方工作流子图里("Enable Lightning LoRA"),勾选即可,不用手动挂 LoRA。
- 768p 是另一台机器:每步 79.1s,是 480p 的 4 倍——扩散模型的计算量随 token 数超线性增长,想上 720p 请把心理预期乘 4。
3. 三层世界:把 H3 放回全硬件坐标系
跨硬件比较先立规矩,统一归一化:
N = 端到端秒数 ÷ (步数 × 每帧百万像素 × 卡数) 单位 s/(步·MP·卡)硬件 5 秒视频耗时 N 相对本机 4× H100 80G 13.25 s 0.06 快 768× 8× B300 74.38 s 0.18 快 274× h3.c 原生 Metal(M5 Max)¹ 26.4 s 5.3 快 9.3× 1× RTX 5090 桌面(ComfyUI)² 145.9 s 17.59 快 2.8× 1× RTX 4090D(int8+Sage) 174.9 s 8.47 快 5.8× DGX Spark GB10 128G 255.8 s 30.84 快 1.7× 本机 M5 Ultra(ComfyUI 稳态) 420 s 49.3 基准 本机 M5 Ultra(h3.c 原生) 121 s ≈14.2 快 3.5×(见第 4 节) M4 Max 128G(社区,15s 片等比) ≈1.5 h — 慢 ~12× M5 Pro 64G + GGUF(社区,9s 片) >1 h — 慢 ~8× ¹ 512²×22 帧参考质量档。 ² 与本机完全同形状(864×480/124帧/20步)直读,无需换算:每步 5.3s vs 本机 19.6s。
数据来源:SGLang 官方 H3 cookbook、NVIDIA Sol Engine、antirez/h3.c README、HN 49252179、zenn.dev 实测;h3.c 原生一行为本机实测(见第 4 节口径)。
读表要点:本机跑 ComfyUI 比一张桌面 5090 慢 2.8 倍;换 h3.c 原生引擎后反超 4090D、逼近 5090;比 M5 Max 上的原生 int8 参考档仍慢约 2.7 倍——差距主要在 int8 算子。而比社区里同样跑 ComfyUI 的 Mac 同行快 8-12 倍。你在哪个梯队,取决于配置和引擎。
4. h3.c 原生引擎实测:同一台机器再快 3.5 倍
antirez(Redis 作者)开源了一个纯 C + Metal 的 MiniMax H3 推理引擎 h3.c,不走 PyTorch、不走 ComfyUI。我在本机 clone 源码、静态审过之后编译跑通,做了完整验收。
4.1 怎么测的
- 本机
make构建,加载 BF16 权重(README 里的 int8 加速档是作者自己在 M5 Max 上测的,我这边没跑 int8 路径——下面所有数字都是 BF16) - 任务与 ComfyUI 完全同形状:864×480、124 帧、24fps、5.17 秒
- 连跑 3 条做稳态复现测试(同提示词 2 条 + 参考条件 1 条)
4.2 用时
项 数字 单条端到端(含加载) 约 2 分 1 秒 对比 ComfyUI 标准稳态(7 分 0 秒) 快 3.5 倍 对比 ComfyUI Turbo(3 分 6 秒) 快 1.5 倍,且不用挂 Lightning LoRA 三条连跑总时长 约 60 分钟(含一次交互会话 stdin 管道挂死的排查重跑;纯生成远少于这个数) 诚实口径:2 分 1 秒是端到端墙钟(含权重加载与 VAE 解码),采样时间没有单独打点;h3.c 是交互式会话,复用加载后的进程还能更快。
4.3 质量:两级验收都过了
第一级:确定性机器指标(ffmpeg 解码灰度帧 + numpy,三条抽样首/中/末帧):
- 帧像素 std 23–52,无死帧(std<1)、无全黑/全白/NaN 特征,min/max 覆盖 0–255 正常动态范围
- 径向 FFT 高频能量比 0.27–0.30,三条高度一致,无噪声污染特征
- 跨文件中帧像素差 mean|diff|:同提示词两条之间 11.8(复现性好),与不同参考条件的对照条约 29(差异符合预期)
第二级:人工验收:三条片子人眼对比,"差不多,没看出来差别太大"——同引擎同提示词下输出一致、不漂移,这正是稳态复测的目标。
结论:h3.c 原生引擎在本机连续生成可复现、产物无损,验收通过。
4.4 对照作者 M5 Max 的参考数字(别跟我M5 Ultra搞混了)
档位(512²×22 帧,20 步) 耗时 BF16 36.30 s int8 25.80 s int8 + int8 QKV 19.32 s 再加 attn-out-proj int8 19.18 s 另外几个实测特性:4 步少步数去噪约 3.5s(vs 29 步参考 26.4s,SSIM 0.556,质量换速度很激进);SSD 流式加载把 DiT 驻留内存从 36.5 GiB 压到 2.0 GiB,代价是 864×480 下前向慢 26%——24G 显存以下的 Mac 也能跑 H3 靠的就是它。
4.5 三条片子同框对比
ComfyUI 标准 7分0秒 ComfyUI Turbo 3分6秒 h3.c 原生 2分1秒 |
|
|
|5. 为什么慢:两个反直觉的真相
真相一:扩散模型是 compute-bound,大内存救不了速度
统一内存让很多人以为"内存大 = 快"。错了一半:
- 内存大决定跑得起来(H3 全家桶 48G 权重,24G 显存的卡根本装不下)
- 速度由算力决定。扩散模型每步都要把全部权重过一遍全矩阵乘法,batch=1 就已打满 GPU——ComfyUI 作者 comfyanonymous 原话(issue #12426)
- 实证:M2 Ultra 128G 跑 HunyuanVideo 53 分钟,RTX 3060 12G 只要 20 分钟——显存只有对方 1/10 的卡快了 2.6 倍
所以"多开队列提吞吐"在 Mac 上也是伪命题:GPU 已经满了,多开只会排队。
真相二:Mac 上的 int8 是"假 int8"
我在 ComfyUI 里选了 int8 权重,以为在跑 int8 算力。查了源码才发现:
supports_int8_compute()对 MPS 返回 False- PyTorch MPS 后端 87 个算子里没有 IntMM,
torch._int_mm直接NotImplementedError - 现在的 int8 = 权重存 int8、算时反量化成 fp16:内存省一半,算力一点不省
这正好解释了第 3 节的表:h3.c 作者用 C 手写 Metal int8 kernel,同代 M5 Max 上 512² 档从 BF16 的 36.3s 干到 int8 的 19.3s——int8 算力本身就有近 2 倍收益,只是 PyTorch MPS 给不了你。comfy-kitchen PR #249 正在给 MPS 补这块(H3 INT8 从 38-74 s/step → 8.4-11.8 s/step),合入后 ComfyUI 路径的速度故事要重写,值得盯。
彩蛋:Mac 上 bf16 比 fp16 慢 1.75 倍(走模拟路径),VAE 用 bf16 比 fp16 慢 5-10 倍(官方 PR #16996)。"新精度更快"在 Mac 上不成立——这也是我 VAE 坚持用 fp16 的原因(int8 VAE 在 Mac 上直接报错,bf16 VAE 慢到没法用)。
6. 抄作业:Mac 跑 H3 的正确配置
DiT    → minimax_h3_fl2va_pruned_int8_convrot   (int8 省内存)
文本编码器 → qwen3vl_32b_minimax_h3_int8_convrot (必须 int8,nvfp4 是 N 卡专属)
视频 VAE → fp16                                  (int8 报 _int_mm 错,bf16 慢 5-10×)
音频 VAE → fp32
速度     → 工作流里勾选 Enable Lightning LoRA(8 步 Turbo)
常驻     → 别手动卸载模型,256G 装得下全家桶,切换零成本
想再快一档:clone h3.c 源码,静态审完
make编译,BF16 权重直接跑——同形状端到端 2 分 1 秒,比 ComfyUI 标准路径快 3.5 倍。第三方引擎,先审后装,别裸跑。生图侧顺带一句:Z-Image Turbo 在 Mac 上是速度比较快的模型——bf16 原生、无量化坑、1024² 出图 6.3 秒,8 步直出。Mac 用户想快速出图先玩它,但别比质量。
7. 结论
- Mac 能不能跑视频生成? 能,而且配置对了是"好用"级别:ComfyUI Turbo 3 分钟,h3.c 原生引擎 2 分钟出一条 5 秒片子。
- Mac 适合当视频主力机吗? 看预算。同预算的 5090 桌面机(ComfyUI 2 分 26 秒)仍略快于本机 h3.c(2 分 1 秒基本打平),而且 N 卡的 int8/SageAttention/EasyCache 优化生态全都能用;但 Mac 靠 h3.c 已经从"不能用"进到"能上桌"。
- Mac 的正确定位:生图主力(Z-Image 6 秒一张快)+ 视频尝鲜 + 开发验证。256G 内存买的是"跑得起来 + 多模型常驻",不是"跑得比 N 卡快"。
- 下一个值得等的东西:comfy-kitchen PR #249 的 MPS int8 kernel。合入后 ComfyUI 跑 H3 有望进入 10s/it 时代,那才是质变。
实测环境:Mac M5 Ultra 256G / ComfyUI 0.43.0 / torch 2.12.1;h3.c 本机源码构建(BF16 权重),2026-10-31 至 11-01。所有数字来自引擎日志与产物落盘的原始记录,测试脚本与原始数据可复现。对比数据来源见文中说明。
-
@cc-tgo 我最近也在关注M5 ULTRA,一直纠结的就是comfyui和H3在M5上的速度问题,可能是出货量的原因,目前能获得的实例很少,但通过有限的资料看对M5 ULTRA的神经元加速还是支持不好,没有充分发挥性能,导致速度不理想。看了大哥的评测,是不是可以理解,已经有能完全适配M5神经元加速跑原生FB16的方案了,且速度比4090D还快?如果是这样,那96G满血版就很有性价比了。
-
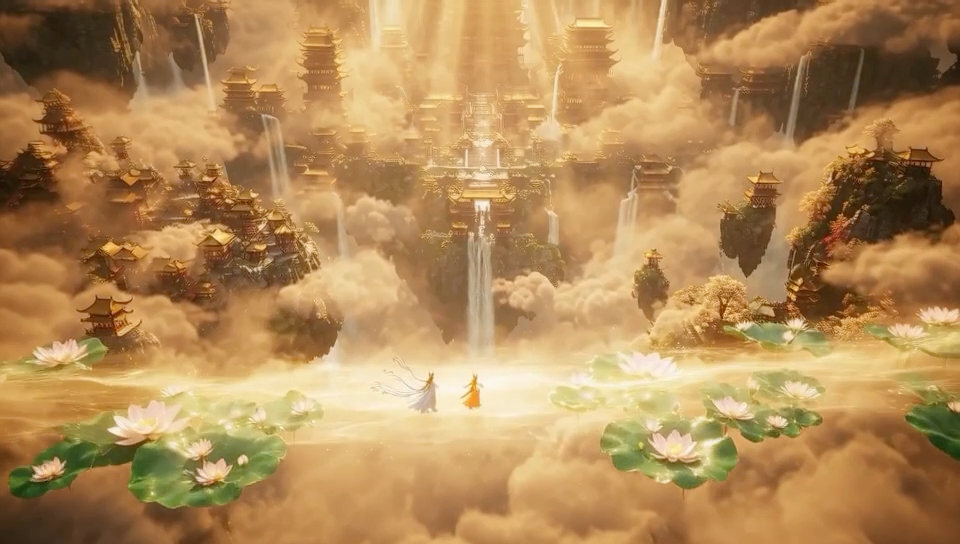
@liu-big comfyui对mac的支持个人体感不是很好。目前在用mlx-serve推理平台,跟oMLX比更优,同时直接支持生图,生视频,生音乐。给你一个参考数据,我用的mlx-serve平台,模型使用MiniMax-H3 (Hailuo 3.0) 8-bit — video + native audio跑16步,生成960×544分辨庇率 / 260帧 (10.8秒视频时间) 总耗时表现7分54秒。
下面是生成视频截图
-
-
-
-
-


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!
 本帖由优秀升级为精华(两者互斥,只补差价),作者 +3 积分,累计 6 分。