【抄作业】单张 7900 XTX 跑 Qwen3.8-Flash-Next:Strata 原版调优,Decode 67.8 → 107.4 tok/s(+58%)
-
继续折腾这台 X99 洋垃圾,目标是让单张 RX 7900 XTX 上的 Strata 跑 Qwen3.8-Flash-Next 吐字速度更快。这次没有重新编译 RDNA3 fork,也没有改 Strata 源码,主要检查官方 hipBLASLt 调优表、逐组测试启动参数,最后打开自适应专家缓存。
先交成绩(同机、同一天、10.2K token prompt、每组取三次中位数):
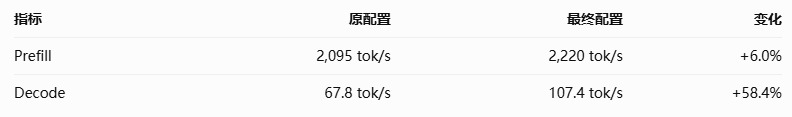
先说明口径: 这是 GPU0 单卡上的 Strata,虽然机器装了两张 7900 XTX,GPU1 还运行另一个 27B llama 服务,但本次并非 TP=2,也不是两卡聚合吞吐。数值取自引擎返回的
timings,不是客户端墙钟;最终成绩是在预热后测得,冷启动第一发明显较慢。一、硬件和运行环境
项目 配置
CPU Xeon E5-2696 v3,18 核 / 36 线程
主板 华南金牌 X99-TF GAMING
内存 128 GB DDR3-1866 RECC,四通道
GPU 2 × RX 7900 XTX 24 GB(gfx1100);本次 Strata 仅使用 GPU0,GPU1 另跑 27B llama 服务
系统 Ubuntu 24.04.5 LTS,内核7.0.0-38-generic
ROCm 7.2.0
引擎 Strata 0.1.50,rx7900variant,f-amd-visioncommit6270e2d9d6bf
hipBLASLt 引擎自带库版本100200
模型 Qwen3.8-Flash-Next GSQ-RCO IQ3_S,双 shard(--native+--ple-gguf)
上下文 262,144,--kv int8 --kv-resident 32768
专家内存策略--ple-io ram --expert-cache auto
其余基线参数--pool-workers 30 --vram-reserve-mib 3072 --prefill auto:32768 --spec 4 --spec-min-p 0.5
模型加载约 2.5 分钟,峰值内存约 104 GB。128 GB 内存并不宽裕,但这套配置能跑。二、怎么测,避免缓存和预热干扰
先用约 500 词的小 prompt 热身,再送入约 10.2K token 的长 prompt 预热,然后用相同长度的请求正式测试。
每调整一组配置,通过systemctl restart strata-next重启服务;每组连续跑三次,以中位数记成绩。
Prefill 用引擎timings.prompt_per_second(PP),Decode 用timings.predicted_per_second(TG);不是前端看到的整体响应速度。
测试在同一天、同一台机器上完成,后台没有下载任务。这里的对照仍是单机实测,不代表其他 CPU、内存及模型配置也有相同收益。
注意:自适应缓存会随着连续请求逐步进入较好的状态。因此这份帖子里的“最终成绩”是预热后的吞吐,不是重启服务后第一发吞吐。三、逐组调参结果(10.2K token prompt)
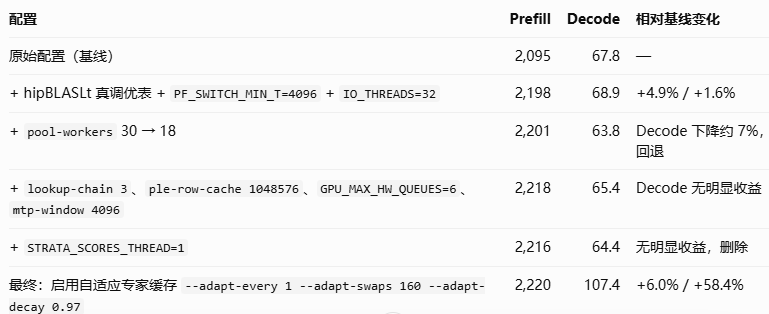
以上是各阶段的测量记录,不是一张所有参数逐项独立控制的消融表;中间测试后有些选项已经回退,不能把每行简单理解为在上一行基础上永久叠加。
- 最大的收益来自自适应专家缓存这一组
在自适应参数尚未打开时,Decode 基本在 64–69 tok/s 附近。加入下面这组设置后,预热后的速度上到了 103–108 tok/s:
--adapt-every 1 --adapt-swaps 160 --adapt-decay 0.97引擎日志里能看到专家缓存命中率约 94.8%–99.8%。从现象看,自适应缓存能更及时地调整 VRAM 中的热专家,减少重复搬运,正好对上这台 X99 + DDR3 的瓶颈。
严格说: 这三个参数是一起加入的,没有分别拆开测试adapt-every、adapt-swaps和adapt-decay。所以能确定的是开启这组自适应缓存设置后,Decode 显著提升;不能把 +58.4% 全部精确归因于其中某一个参数。
2. 自适应缓存必须看预热后的成绩
最终配置在同一服务中连续六发的 Decode:
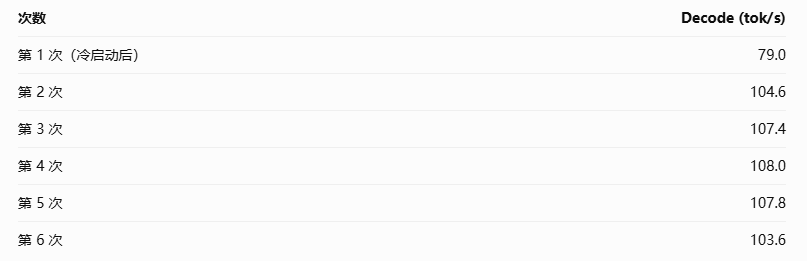
只测第一发会低估效果。反过来,比较不同参数时,也应尽量采用一致的预热方法,否则很容易把缓存状态误当成性能差异。
3. Prefill 的提升相对有限
Prefill 从 2,095 到 2,220 tok/s,约 +6.0%。主要调过三个地方:# STRATA_HIPBLASLT_TUNING 应指向实际存在且版本匹配的调优表文件 STRATA_HIPBLASLT_TUNING=/实际路径/gfx1100-hipblaslt-100200.txt STRATA_PF_SWITCH_MIN_T=4096 STRATA_IO_THREADS=32这里的
/实际路径/是占位符,请替换为自己机器上的真实文件位置,不是直接可执行的完整配置。三项共同调整后的阶段成绩是 2,198 tok/s,后续其他参数调整后最终为 2,220 tok/s。没有逐项单测这三个参数各贡献多少。
原先把STRATA_HIPBLASLT_TUNING写成了"1",并不是有效表路径;引擎没有明显报错,导致排查方向一度跑偏。调优表名称中的100200要与这套引擎自带的 hipBLASLt 版本对应,不能只看系统 ROCm 版本。4.
pool-workers不一定越接近物理核数越好
这台 E5 是 18 核 36 线程。我试着把--pool-workers从 30 降到 18,Decode 从 68.9 跌到 63.8 tok/s,反倒更慢。最后仍使用 30。
所以论坛里关于 worker 数量的经验可以参考,但不能只根据 CPU 的物理核数直接照搬,尤其是 X99 + DDR3 + CPU 侧专家流这种组合。四、128K 长上下文单次结果
最终配置测了约 127K token 输入、64 token 输出:
指标 实测
Prefill 3,007 tok/s
Decode 82.9 tok/s
单发墙钟 43.0 s
这一档没有做修改前的同口径基线,因此只分享最终配置的绝对性能,不计算“128K 提升百分比”。而且只测了一发,属于趋势参考,不宜当成稳定的多轮均值。
还试过STRATA_SCORES_THREAD=1:在本机 128K 测试里开关两边的数值区间约 2,956–3,024 tok/s,暂未看到可辨认的收益,就删掉了。五、哪些参数可以参考,哪些不要照抄
这次是原版 Strata 0.1.50 的rx7900variant。参考论坛其他作者的调优帖时发现,一些变量只存在于他们自编译的 RDNA3 fork,本机这个二进制并没有对应实现。
类型 参数或变量 本机结论
本轮收益最明显--adapt-every 1 --adapt-swaps 160 --adapt-decay 0.97组合开启后,热态 Decode 显著提升
有一定收益 正确 hipBLASLt 调优表、STRATA_PF_SWITCH_MIN_T、STRATA_IO_THREADS组合调整后 Prefill 有小幅提升
本轮无明确 Decode 收益--lookup-chain、--ple-row-cache、GPU_MAX_HW_QUEUES、--mtp-window不建议期待通用加速
本轮未见收益STRATA_SCORES_THREAD=1删除
测试后回退--pool-workers 18比 30 慢
以下 10 个变量在本次使用的 0.1.50 二进制中未找到对应字符串,属于参考帖中 RDNA3 fork 的实现路径,不要直接把它们塞进原版配置后期待生效:STRATA_RDNA_MMVQ_WAVE STRATA_PF_GROUP_RES STRATA_PREFILL_MMQ_TILE_ROWS STRATA_GDN_CHUNK_GDV STRATA_PA_KLDS STRATA_COMBINE_CPU STRATA_WAIT_FUSE STRATA_ROUTE_PUBLISH STRATA_GR_INJ_UP STRATA_GR_FUSED例如论坛里用
STRATA_RDNA_MMVQ_WAVE=3改 native_mmvq 内核布局得到的 Decode 提升,是自编 fork 的路线;这篇的 +58.4% 则是在当前 Strata 0.1.50 上调整运行参数得到的,两者不要混为一谈。六、这轮最值得记下来的坑
hipBLASLt 表路径写错会静默降级。STRATA_HIPBLASLT_TUNING要写真实路径,文件头版本与引擎库配对;不要写"1"当作开关。
不要只看冷启动第一发。 这次自适应缓存首发只有 79.0 tok/s,第二发已到 104.6 tok/s。
worker 数不是按物理核心数拍脑袋。 本机 30 比 18 快。
一次只改一组变量并重启对照。 这台机器跨时段 Decode 本身会波动,混着改参数很难定位收益来源。
别把 RDNA3 fork 参数直接抄进原版二进制。 有些变量对当前构建根本没有作用。感谢论坛几位作者的测试与资料:
#2745:7900 XTX 单卡 Prefill / Decode 调优,空语;其中 7、14、15 楼还有 Y G 0 的 X99 实测数据。
#2694:双 7900 XTX Strata IQ3_S、262K Prefill,懒人烘培。
#2562:7900 XTX 跑 125B MoE 的 X99 旧平台实测,sbbdog。
Strata 仓库内docs/AMD_HIP_PERFORMANCE.md、docs/AMD_HIP.md、docs/TROUBLESHOOTING.md。
以上数据都是自己这台机上的测试记录,欢迎用相同口径交流,尤其想看看其他 X99/DDR3 平台上adapt的收益是否也这么明显。 - 最大的收益来自自适应专家缓存这一组
-
-
继续折腾这台 X99 洋垃圾,目标是让单张 RX 7900 XTX 上的 Strata 跑 Qwen3.8-Flash-Next 吐字速度更快。这次没有重新编译 RDNA3 fork,也没有改 Strata 源码,主要检查官方 hipBLASLt 调优表、逐组测试启动参数,最后打开自适应专家缓存。
先交成绩(同机、同一天、10.2K token prompt、每组取三次中位数):
先说明口径: 这是 GPU0 单卡上的 Strata,虽然机器装了两张 7900 XTX,GPU1 还运行另一个 27B llama 服务,但本次并非 TP=2,也不是两卡聚合吞吐。数值取自引擎返回的
timings,不是客户端墙钟;最终成绩是在预热后测得,冷启动第一发明显较慢。一、硬件和运行环境
项目 配置
CPU Xeon E5-2696 v3,18 核 / 36 线程
主板 华南金牌 X99-TF GAMING
内存 128 GB DDR3-1866 RECC,四通道
GPU 2 × RX 7900 XTX 24 GB(gfx1100);本次 Strata 仅使用 GPU0,GPU1 另跑 27B llama 服务
系统 Ubuntu 24.04.5 LTS,内核7.0.0-38-generic
ROCm 7.2.0
引擎 Strata 0.1.50,rx7900variant,f-amd-visioncommit6270e2d9d6bf
hipBLASLt 引擎自带库版本100200
模型 Qwen3.8-Flash-Next GSQ-RCO IQ3_S,双 shard(--native+--ple-gguf)
上下文 262,144,--kv int8 --kv-resident 32768
专家内存策略--ple-io ram --expert-cache auto
其余基线参数--pool-workers 30 --vram-reserve-mib 3072 --prefill auto:32768 --spec 4 --spec-min-p 0.5
模型加载约 2.5 分钟,峰值内存约 104 GB。128 GB 内存并不宽裕,但这套配置能跑。二、怎么测,避免缓存和预热干扰
先用约 500 词的小 prompt 热身,再送入约 10.2K token 的长 prompt 预热,然后用相同长度的请求正式测试。
每调整一组配置,通过systemctl restart strata-next重启服务;每组连续跑三次,以中位数记成绩。
Prefill 用引擎timings.prompt_per_second(PP),Decode 用timings.predicted_per_second(TG);不是前端看到的整体响应速度。
测试在同一天、同一台机器上完成,后台没有下载任务。这里的对照仍是单机实测,不代表其他 CPU、内存及模型配置也有相同收益。
注意:自适应缓存会随着连续请求逐步进入较好的状态。因此这份帖子里的“最终成绩”是预热后的吞吐,不是重启服务后第一发吞吐。三、逐组调参结果(10.2K token prompt)
以上是各阶段的测量记录,不是一张所有参数逐项独立控制的消融表;中间测试后有些选项已经回退,不能把每行简单理解为在上一行基础上永久叠加。
- 最大的收益来自自适应专家缓存这一组
在自适应参数尚未打开时,Decode 基本在 64–69 tok/s 附近。加入下面这组设置后,预热后的速度上到了 103–108 tok/s:
--adapt-every 1 --adapt-swaps 160 --adapt-decay 0.97引擎日志里能看到专家缓存命中率约 94.8%–99.8%。从现象看,自适应缓存能更及时地调整 VRAM 中的热专家,减少重复搬运,正好对上这台 X99 + DDR3 的瓶颈。
严格说: 这三个参数是一起加入的,没有分别拆开测试adapt-every、adapt-swaps和adapt-decay。所以能确定的是开启这组自适应缓存设置后,Decode 显著提升;不能把 +58.4% 全部精确归因于其中某一个参数。
2. 自适应缓存必须看预热后的成绩
最终配置在同一服务中连续六发的 Decode:
只测第一发会低估效果。反过来,比较不同参数时,也应尽量采用一致的预热方法,否则很容易把缓存状态误当成性能差异。
3. Prefill 的提升相对有限
Prefill 从 2,095 到 2,220 tok/s,约 +6.0%。主要调过三个地方:# STRATA_HIPBLASLT_TUNING 应指向实际存在且版本匹配的调优表文件 STRATA_HIPBLASLT_TUNING=/实际路径/gfx1100-hipblaslt-100200.txt STRATA_PF_SWITCH_MIN_T=4096 STRATA_IO_THREADS=32这里的
/实际路径/是占位符,请替换为自己机器上的真实文件位置,不是直接可执行的完整配置。三项共同调整后的阶段成绩是 2,198 tok/s,后续其他参数调整后最终为 2,220 tok/s。没有逐项单测这三个参数各贡献多少。
原先把STRATA_HIPBLASLT_TUNING写成了"1",并不是有效表路径;引擎没有明显报错,导致排查方向一度跑偏。调优表名称中的100200要与这套引擎自带的 hipBLASLt 版本对应,不能只看系统 ROCm 版本。4.
pool-workers不一定越接近物理核数越好
这台 E5 是 18 核 36 线程。我试着把--pool-workers从 30 降到 18,Decode 从 68.9 跌到 63.8 tok/s,反倒更慢。最后仍使用 30。
所以论坛里关于 worker 数量的经验可以参考,但不能只根据 CPU 的物理核数直接照搬,尤其是 X99 + DDR3 + CPU 侧专家流这种组合。四、128K 长上下文单次结果
最终配置测了约 127K token 输入、64 token 输出:
指标 实测
Prefill 3,007 tok/s
Decode 82.9 tok/s
单发墙钟 43.0 s
这一档没有做修改前的同口径基线,因此只分享最终配置的绝对性能,不计算“128K 提升百分比”。而且只测了一发,属于趋势参考,不宜当成稳定的多轮均值。
还试过STRATA_SCORES_THREAD=1:在本机 128K 测试里开关两边的数值区间约 2,956–3,024 tok/s,暂未看到可辨认的收益,就删掉了。五、哪些参数可以参考,哪些不要照抄
这次是原版 Strata 0.1.50 的rx7900variant。参考论坛其他作者的调优帖时发现,一些变量只存在于他们自编译的 RDNA3 fork,本机这个二进制并没有对应实现。
类型 参数或变量 本机结论
本轮收益最明显--adapt-every 1 --adapt-swaps 160 --adapt-decay 0.97组合开启后,热态 Decode 显著提升
有一定收益 正确 hipBLASLt 调优表、STRATA_PF_SWITCH_MIN_T、STRATA_IO_THREADS组合调整后 Prefill 有小幅提升
本轮无明确 Decode 收益--lookup-chain、--ple-row-cache、GPU_MAX_HW_QUEUES、--mtp-window不建议期待通用加速
本轮未见收益STRATA_SCORES_THREAD=1删除
测试后回退--pool-workers 18比 30 慢
以下 10 个变量在本次使用的 0.1.50 二进制中未找到对应字符串,属于参考帖中 RDNA3 fork 的实现路径,不要直接把它们塞进原版配置后期待生效:STRATA_RDNA_MMVQ_WAVE STRATA_PF_GROUP_RES STRATA_PREFILL_MMQ_TILE_ROWS STRATA_GDN_CHUNK_GDV STRATA_PA_KLDS STRATA_COMBINE_CPU STRATA_WAIT_FUSE STRATA_ROUTE_PUBLISH STRATA_GR_INJ_UP STRATA_GR_FUSED例如论坛里用
STRATA_RDNA_MMVQ_WAVE=3改 native_mmvq 内核布局得到的 Decode 提升,是自编 fork 的路线;这篇的 +58.4% 则是在当前 Strata 0.1.50 上调整运行参数得到的,两者不要混为一谈。六、这轮最值得记下来的坑
hipBLASLt 表路径写错会静默降级。STRATA_HIPBLASLT_TUNING要写真实路径,文件头版本与引擎库配对;不要写"1"当作开关。
不要只看冷启动第一发。 这次自适应缓存首发只有 79.0 tok/s,第二发已到 104.6 tok/s。
worker 数不是按物理核心数拍脑袋。 本机 30 比 18 快。
一次只改一组变量并重启对照。 这台机器跨时段 Decode 本身会波动,混着改参数很难定位收益来源。
别把 RDNA3 fork 参数直接抄进原版二进制。 有些变量对当前构建根本没有作用。感谢论坛几位作者的测试与资料:
#2745:7900 XTX 单卡 Prefill / Decode 调优,空语;其中 7、14、15 楼还有 Y G 0 的 X99 实测数据。
#2694:双 7900 XTX Strata IQ3_S、262K Prefill,懒人烘培。
#2562:7900 XTX 跑 125B MoE 的 X99 旧平台实测,sbbdog。
Strata 仓库内docs/AMD_HIP_PERFORMANCE.md、docs/AMD_HIP.md、docs/TROUBLESHOOTING.md。
以上数据都是自己这台机上的测试记录,欢迎用相同口径交流,尤其想看看其他 X99/DDR3 平台上adapt的收益是否也这么明显。@Wang-Wei
让AI读了下,有用,谢谢!逐条对表本机
① --adapt-every 1 --adapt-swaps 160 --adapt-decay 0.97(帖子主收益)→ 本机支持,且默认值更保守,值得 A/B我查了 generate.cpp:875/880/911,本机 0.1.56 的默认是 adapt_every=4 / adapt_swaps=96 / adapt_decay=0.7——帖子等于把自适应层调激进:每轮都换(vs 每 4 轮)、一次换 160 个专家(vs 96)、热度衰减更慢(0.97 vs 0.7,记忆更长)。
关键差异在瓶颈结构:他基线 decode 只有 67.8,说明专家缓存 miss 严重、被搬运卡死,激进自适应正好打在这个点上。我们日志里 hit rate: 95.0–97.3%,miss 走 PCIe 12.6 GB/s,占比只有 3–5% ⇒ 理论空间就是他那边的 1/10 不到,别指望 +58%,预期 0~5%。而且我们 decode 连跑单调爬升的现象(99→116→131)本身就是自适应层在逐轮预热——机制我们一直在用,只是档位保守。
 ️ 注意:换入换出专家会改舍入路径 ⇒ 改答案,和槽位变化同类,须单独 A/B。
① adapt 三参:确实有效,decode 稳定 +5.4~7.6%
三轮同向,不是噪声。机制也对得上:首轮命中率 94.40% → 96.30%,稳态 98.70% → 98.90%,miss 少一点、PCIe 搬运少一点,decode 就快一点。投机接受率几乎没变(153/227 vs 154/222),说明提速不是靠多吃草稿。帖子 +58% 我们 +6%,起点不同不矛盾——他基线 67.8(被搬运卡死),我们基线已 99.8。
adapt 三参收益稳定、启动零副作用、回退就是删三个参数。唯一没验证的是会不会改答案——台架用 temp 0.3,文本本来就有随机性,判不出来。理论上专家只是"常驻在哪"变了,算术仍在 GPU 上跑,但这个项目里我们已经吃过"槽位变了就改答案"的亏,所以不敢替你打包票。
- 最大的收益来自自适应专家缓存这一组
-
@Wang-Wei
让AI读了下,有用,谢谢!逐条对表本机
① --adapt-every 1 --adapt-swaps 160 --adapt-decay 0.97(帖子主收益)→ 本机支持,且默认值更保守,值得 A/B我查了 generate.cpp:875/880/911,本机 0.1.56 的默认是 adapt_every=4 / adapt_swaps=96 / adapt_decay=0.7——帖子等于把自适应层调激进:每轮都换(vs 每 4 轮)、一次换 160 个专家(vs 96)、热度衰减更慢(0.97 vs 0.7,记忆更长)。
关键差异在瓶颈结构:他基线 decode 只有 67.8,说明专家缓存 miss 严重、被搬运卡死,激进自适应正好打在这个点上。我们日志里 hit rate: 95.0–97.3%,miss 走 PCIe 12.6 GB/s,占比只有 3–5% ⇒ 理论空间就是他那边的 1/10 不到,别指望 +58%,预期 0~5%。而且我们 decode 连跑单调爬升的现象(99→116→131)本身就是自适应层在逐轮预热——机制我们一直在用,只是档位保守。
️ 注意:换入换出专家会改舍入路径 ⇒ 改答案,和槽位变化同类,须单独 A/B。① adapt 三参:确实有效,decode 稳定 +5.4~7.6%
三轮同向,不是噪声。机制也对得上:首轮命中率 94.40% → 96.30%,稳态 98.70% → 98.90%,miss 少一点、PCIe 搬运少一点,decode 就快一点。投机接受率几乎没变(153/227 vs 154/222),说明提速不是靠多吃草稿。帖子 +58% 我们 +6%,起点不同不矛盾——他基线 67.8(被搬运卡死),我们基线已 99.8。
adapt 三参收益稳定、启动零副作用、回退就是删三个参数。唯一没验证的是会不会改答案——台架用 temp 0.3,文本本来就有随机性,判不出来。理论上专家只是"常驻在哪"变了,算术仍在 GPU 上跑,但这个项目里我们已经吃过"槽位变了就改答案"的亏,所以不敢替你打包票。
呃,让ai改配置后又否定了……
开始写入。先备份并确认两份配置的 args 尾部结构:
两份配置都写入成功(无 BOM,与主配置只差这三个参数)。现在用生产配置本体跑一轮完整确认,既是验收,也是以后的正式基线:
生产配置的检验已完成。现在把三组数据对比一下:
生产配置的验证结果不干净,先查清原因,再下结论:
这两侧的行为完全一致(base 与 pafast 逐项相同、连草稿数都一样),说明台架本身是确定性的。那么我就可以直接对比文本,判断 adapt 是否改了答案:
三参已经写入主配置与 esp,并用生产配置本体复跑了一轮复核。结果是:写入成功,但复核暴露了一个我上一轮没看到的问题,得跟你摊开讲。生产配置复核(131K×3)
run base(改前) adapt(副本) prod(生产配置) 1 99.8 105.2 (+5.41%) 110.2 (+10.42%) 2 122.9 132.2 (+7.57%) 114.7 (−6.67%) 3 121.2 127.8 (+5.45%) 124.1 (+2.39%) 均值 114.6 121.7 (+6.1%) 116.3 (+1.5%) prefill 与启动指纹依旧无变化(+0.19/+0.03/−0.61%,ready 56.1 s、11,371 槽)。
为什么 +6% 站不住
adapt和prod是同一组参数,却跑出 132.2 与 114.7,差 15%。我顺着查了文本哈希,发现两件事:一、台架本身是可复现的。 base 与 pafast 属等价配置,三次输出 sha256 逐字节相同(
ce0b81f8 / a2c22be2 / 61d99364),连草稿数153/227、157/228、152/212都一模一样。所以不是台架噪声。二、adapt 打破了这种可复现性。 同一配置的两个会话,run-1 文本相同(
75d2efd598df),但 run-2/3 开始互相分歧(首个分歧位置 @306 vs @72);而且它跟 base 必然不同(@306 / @111)——确实改答案,且改法不稳定。拆开归因:
指标 能否归因于配置 结论 命中率 能(三轮全抬高) 94.4→96.3、98.7→98.9、98.7→99.3 ⇒ 真实 run-1 decode 能(两会话同向 +5.4%/+10.4%) 冷缓存起点收益真实 稳态 decode 不能(草稿接受率 63.5%~78.3% 漂移主导) 不可归因 端到端 — decode 只占 20% ⇒ +0.5%~1% 一句话:真实收益是命中率 +0.2~1.9 个百分点、端到端约 1%;代价是任何 A/B 的 decode 侧从此失去可比性,同一提示词换会话可能给不同答案。 我之前说"三轮同向、值得采纳",是被 run-N 的表面一致性误导了——这轮复核否掉了它。
现场状态:配置已写入,服务已停,8080 空闲,
git status仍只有既有 2 个未跟踪项、git diff为空。备份在.workbuddy/tmp/backup-20261104-pre-adapt/。
收到,回退。
已回退,现场干净。回退结果
项 状态 strata-swift-iq3_s.jsonsha256 回到 d3fbb4d6…0ee6,与改前逐字节相同,args 41 项,无任何adapt-*strata-swift-iq3_s-esp.json同步回退,args 50 项,无 adapt-*备份 .workbuddy/tmp/backup-20261104-pre-adapt/(保留)A/B 副本与引擎日志 移入 ab-harness/adapt-pafast-20261104/configs/仓库自检 git status仅既有 2 个未跟踪项、git diff为空环境 8080 空闲、显存 1,603 MiB 这次跑出来的真结论
PA_FAST 永久划掉。 它在 CUDA 构建里根本不存在(
strata.exe里 0 次命中,同族PA_TRIM/PA_RPF/HIP_WMMA_MIN_Q也全是 0;它是 gfx11/gfx12 的 WMMA 路径)。STRATA_PF_SWITCH_MIN_T在我们这里是死代码。这条同时被实测印证:pafast 与 base 三次输出 sha256 逐字节相同。adapt 三参不采纳。 表面 +5.4~7.6%,用生产配置复跑只有 +1.5%(run-2 还倒退 6.7%)。根因是同配置的两个会话结果不一致——而 base/pafast 这种等价配置能逐字节复现,说明破坏来自换专家路径的时序依赖。端到端约 1%,换掉可复现性不划算。
顺带得到一条方法论。 这次差点被 run-N 的表面同向骗过去(我上一轮就是这么下的判断)。以后凡"可能改答案"的改动,A/B 必须加一步:同配置跑两个会话,比对文本 sha256。因为 decode 速度会被生成文本的草稿接受率拖着走(本次在 63.5%~78.3% 之间飘),不先确认文本一致,配置差异和文本运气就分不开。这条已写进
MEMORY.md§7。报告已补上 §8(生产复核、归因拆解、回退记录),
ab-harness/adapt-pafast-20261104/里的原始 JSON、脚本、配置快照都留着,将来谁再提这个帖子可以直接复现。 -
强悍!~这是可以作为token自由了~
-
抄 Wang Wei(lcz.me #2804)两套配置实测 vs 基线
臂改动引擎账本 decode 中位草稿接受率结果基线现役 0.1.56 配置53.1(52.4–54.6)~80%参照B(全抄)+expert-cache auto / prefill auto:32768 / kv-resident 32768 / vram-reserve 3072~42.2(41.6–43.3)63–69%−21%A(只抄可移植)+pool-workers 30 / spec-min-p 0.5 / adapt-decay 0.97 / PF_SWITCH_MIN_T 4096 / IO_THREADS 3250.7(49.1–54.7)62–69%−4.5%仪器:probe_speed.py 1024 6,六轮 out=1024 全干净,取引擎账本 decode 列。为什么输
B:expert-cache auto + vram-reserve 3072 把 GPU 专家缓存从 7498 槽压到 ~6204,非专家显存预留又挤掉缓存 → 命中下降;spec-min-p 0.5 同时把接受率打掉。两个负面叠加 = −21%。他那台是双 7900XTX 用 GPU0、峰值 RAM 104 GB,显存/内存预算比我们宽得多,auto 对他安全、对我们是降级。
A:唯一实质伤害是 --spec-min-p 0.5(我们 0.7)——接受率 80%→65% 直接把 decode 拖到 50.7。pool-workers 30/PF_SWITCH_MIN_T/IO_THREADS 在本机短提示测不出红利(他的收益在 prefill 侧、且依赖 hipBLASLt 表命中)。
决定:两臂都没跑赢,已全部回退,配置字节级等于备份基线(226d2892)。按规矩不写上游档。