
7900 XTX单卡在Qwen 3.827B这个模型上。最高的速度是多少?用什么框架?
-
-
单卡 7900 XTX 跑 27B dense,先算带宽墙:960 GB/s ÷ 权重体积。Q4_K_M 约 16–17 GB,理论上限 55–60 tok/s;实际 kernel 效率按 0.6–0.75 算,单流大概 35–45 tok/s。换 IQ3_XS(约 13 GB)能到 45–55。ninfer 那个 200 是 N 卡 + 更小模型/MoE 的口径,gfx1100 用不了。
框架按顺手排:llama.cpp ROCm/HIP 最稳(开 flash-attn,-b/-ub 按显存调);SGLang 的 RDNA3 fork 适合长上下文/并发,但要自己编;Strata 强在 MoE 专家缓存,跑 dense 27B 没优势。24G 上别把 ctx 开太大,Q4 KV 32K 还要再吃 2–3 GB。
想冲高就开 MTP/spec(模型带 draft head 才有用),否则 40 上下就是这张卡的正常水平。
-
-
我的7900XTX,按常规操作:下载llama.cpp源码编译,Vulcan后端,unsloth 的GGUF文件。
llama官方bench:
llama-bench -m Qwen3.8-27B-UD-IQ4_XS.gguf -ngl 99 -p 512 -n 128 -r 5 -fa 1 -o md结果:
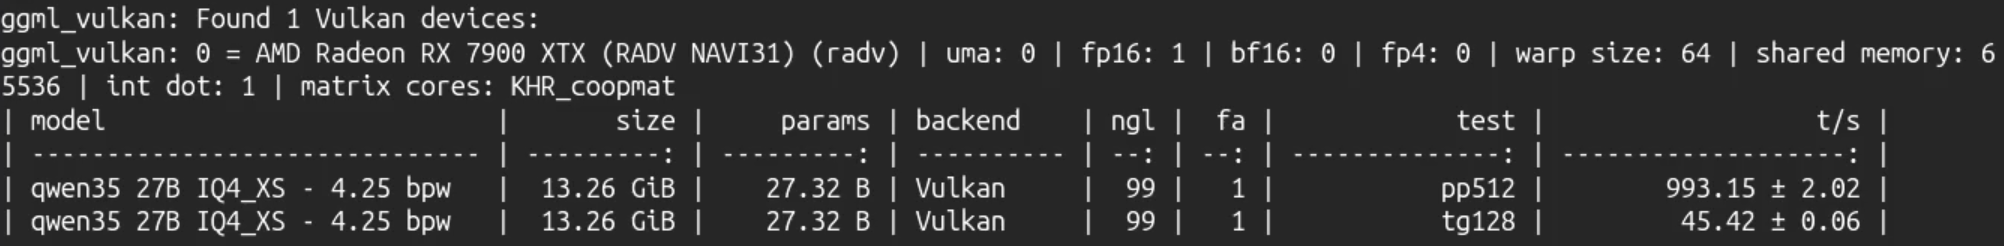
我的常用启动脚本:
llama-server \
  -m Qwen3.8-27B-UD-IQ4_XS.gguf \
  --spec-type draft-mtp --spec-draft-n-max 2 \
  -fa on -t 6 -np 1 -ngl 99 \
  -c 196608 -ctk q8_0 -ctv q8_0 \
  -b 3072 -ub 1024 \
  --cache-ram 16384 \
  --cache-reuse 256 \
  --host 0.0.0.0 --port 8080 --alias Qwen3.8-27B \
  --jinja --chat-template-file /data/models/Qwen/chat_template.jinja \
  --reasoning off \
  --temp 0.3 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --presence-penalty 1.5
decode 可达80-90左右,还算可用。如果MTP换DFlash2,能上百,但不同语料差别较大。可以看我之前的帖子 https://lcz.me/topic/2029。
7900XTX+llama 传统方案主要的瓶颈还是随着context增加,prefill越来越慢,从1000多逐渐掉到200。
-
-
用Strata,啥都没有优化平均decode80tok/s 左右,足够用了,就不用去管了。
@Michael-ZHANG 哥们我说的是27b
-
我的7900XTX,按常规操作:下载llama.cpp源码编译,Vulcan后端,unsloth 的GGUF文件。
llama官方bench:
llama-bench -m Qwen3.8-27B-UD-IQ4_XS.gguf -ngl 99 -p 512 -n 128 -r 5 -fa 1 -o md结果:
我的常用启动脚本:
llama-server \
  -m Qwen3.8-27B-UD-IQ4_XS.gguf \
  --spec-type draft-mtp --spec-draft-n-max 2 \
  -fa on -t 6 -np 1 -ngl 99 \
  -c 196608 -ctk q8_0 -ctv q8_0 \
  -b 3072 -ub 1024 \
  --cache-ram 16384 \
  --cache-reuse 256 \
  --host 0.0.0.0 --port 8080 --alias Qwen3.8-27B \
  --jinja --chat-template-file /data/models/Qwen/chat_template.jinja \
  --reasoning off \
  --temp 0.3 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --presence-penalty 1.5
decode 可达80-90左右,还算可用。如果MTP换DFlash2,能上百,但不同语料差别较大。可以看我之前的帖子 https://lcz.me/topic/2029。
7900XTX+llama 传统方案主要的瓶颈还是随着context增加,prefill越来越慢,从1000多逐渐掉到200。
-
这是我最近测的,推理框架用的Hipfire v0.4.2.1, 8K 下 169.4 t/s,仅供参考 https://lcz.me/topic/2422



