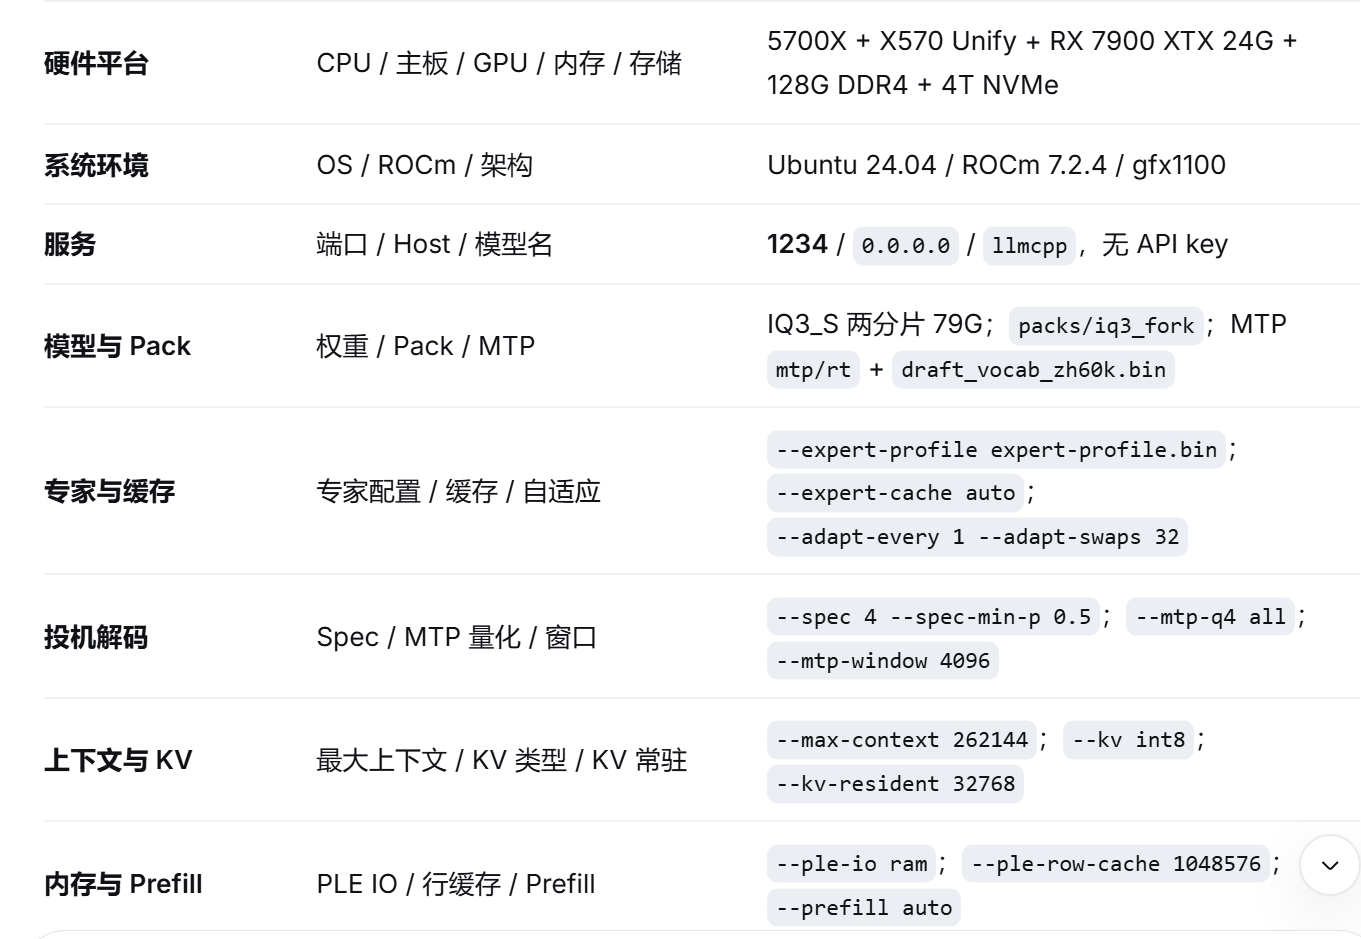
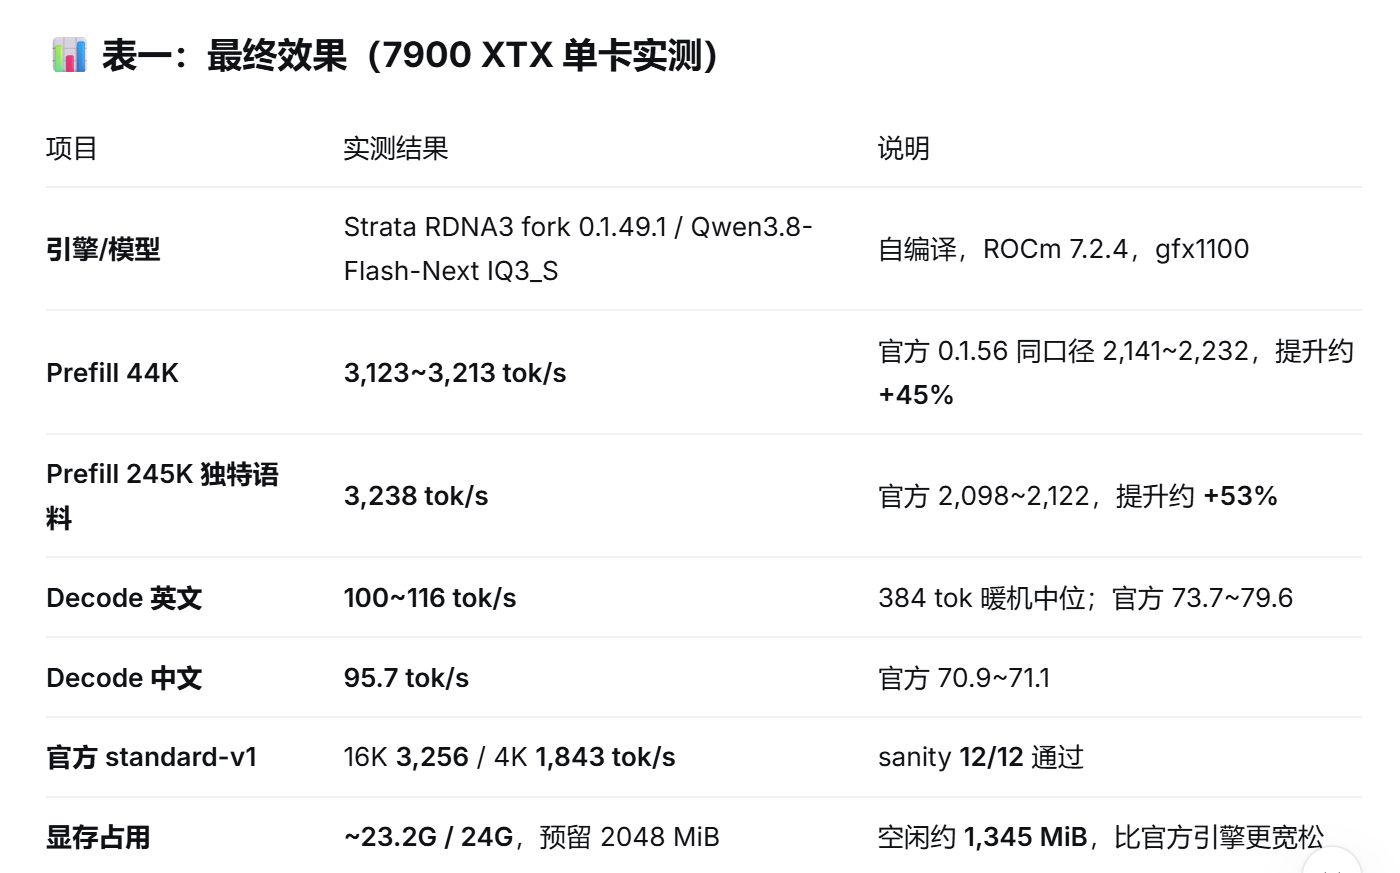
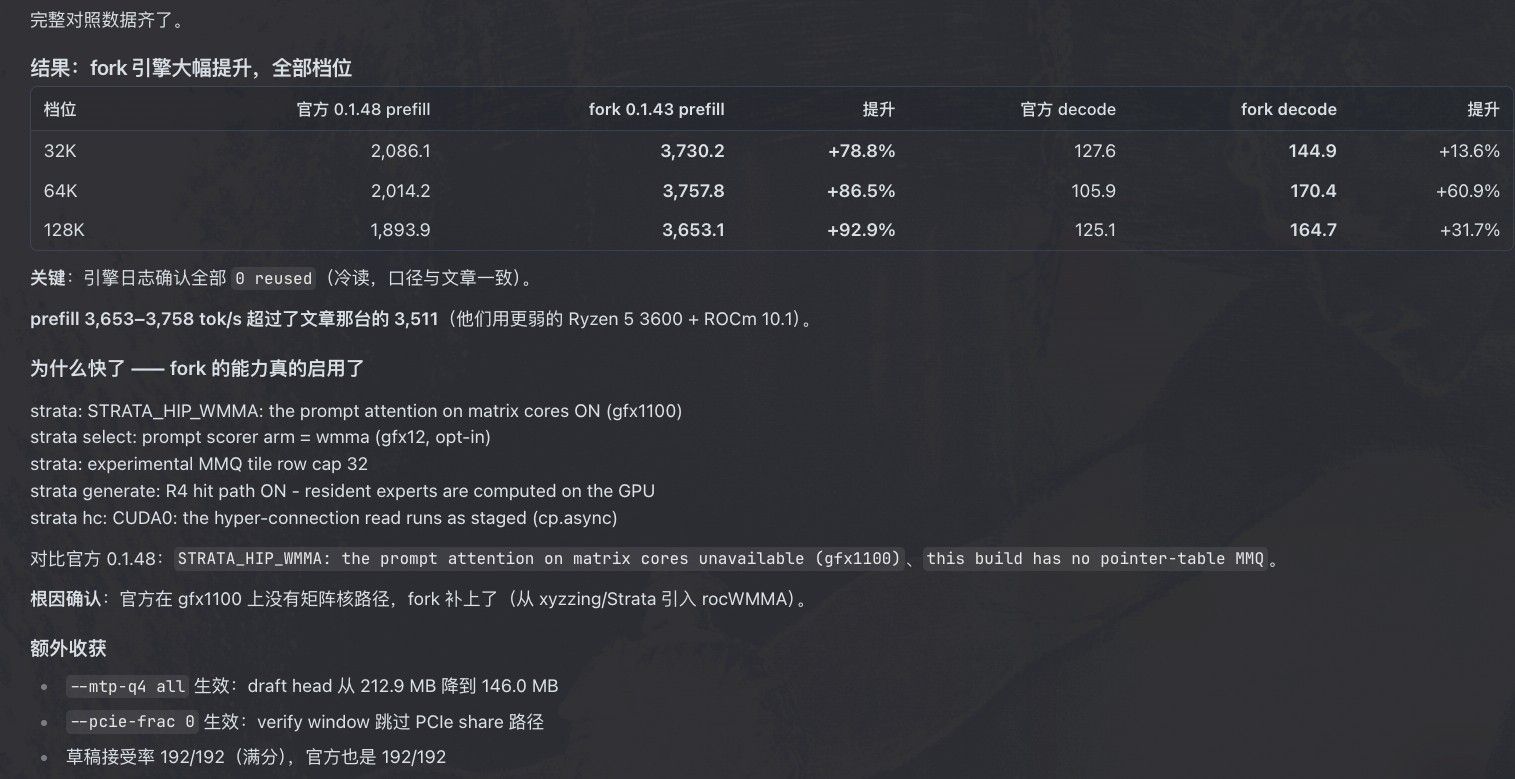
跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 神了, 7900xtx 单卡prefill 3,570 tok/s decode 106.6 tok/s, Strata RDNA3 fork:安装、调优与 32K–256K 性能实测

神了, 7900xtx 单卡prefill 3,570 tok/s decode 106.6 tok/s, Strata RDNA3 fork:安装、调优与 32K–256K 性能实测

已定时 已固定 已锁定 已移动 精华 热议 LLM讨论区
7900xtxstrata
35 帖子 26 发布者 3.2k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • James PangJ
    James PangJ
    James Pang
    编写于 最后由 James Pang 编辑
    #26

    我這邊正在進行測試,但我是Windows 11
    我的Strata是託管在Antigravity下面,是IQ2,64K上下文,單卡RX7900XTX 24GB
    Prefill提升巨大,但decode持平,主因是有一個補丁目前Windows沒有下面這些補丁,我看看能不能重新編譯windows版本的出來用
    ├── src/kernels/cuda/rdna_gr.cu <-- 【最核心】RDNA3 硬體級底層彙編優化
    ├── src/kernels/cuda/fused_gr.cu <-- 殘差連結 (Hyper-Connection) 算子融合
    ├── src/kernels/cpu/iq_avx512.cpp <-- PR #1 修復:AVX2 CPU 啟動防崩潰補丁
    └── src/core/layer.cpp <-- 引擎調度層:註冊 STRATA_GR_RDNA 開關
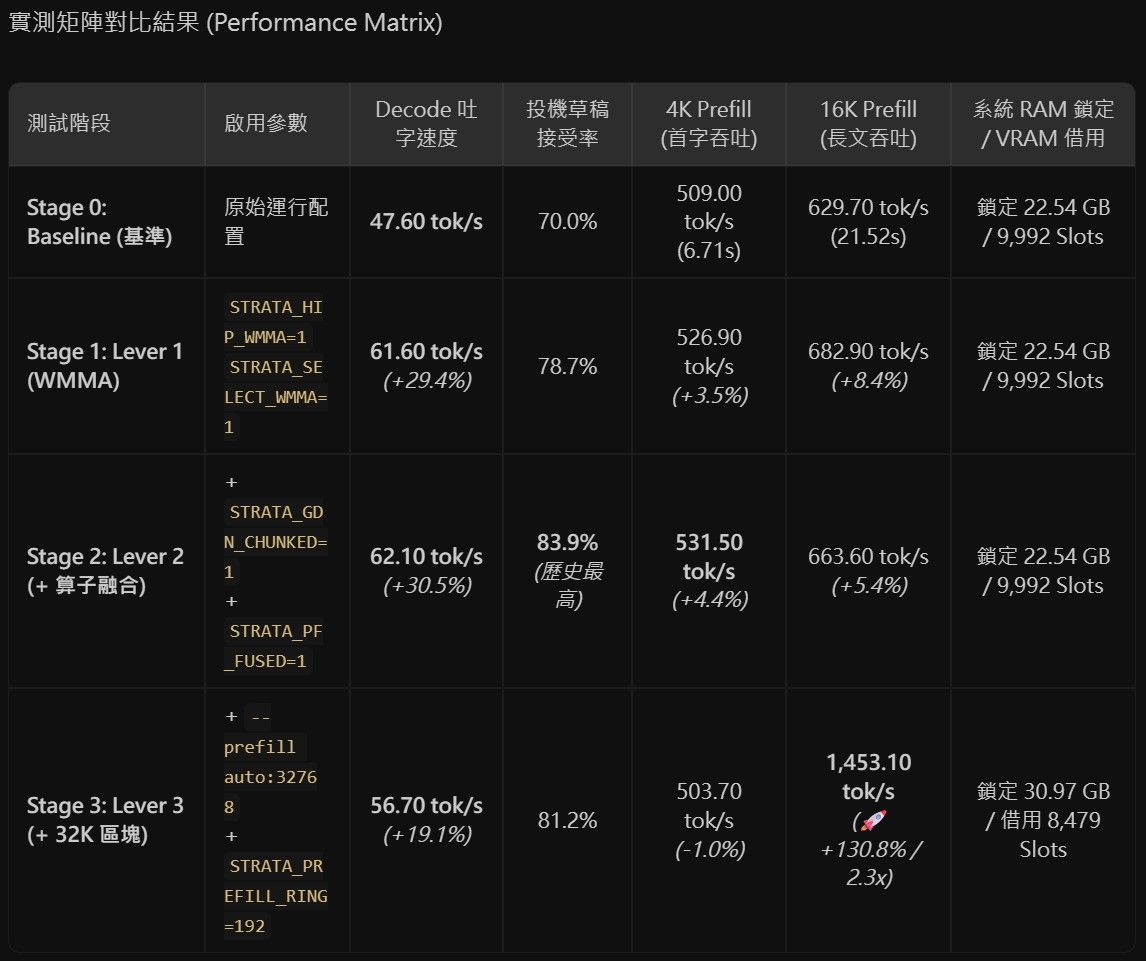
    image.jpeg
    image.jpeg

    1 条回复 最后回复
    0
    • James PangJ
      James PangJ
      James Pang
      编写于 最后由 James Pang 编辑
      #27

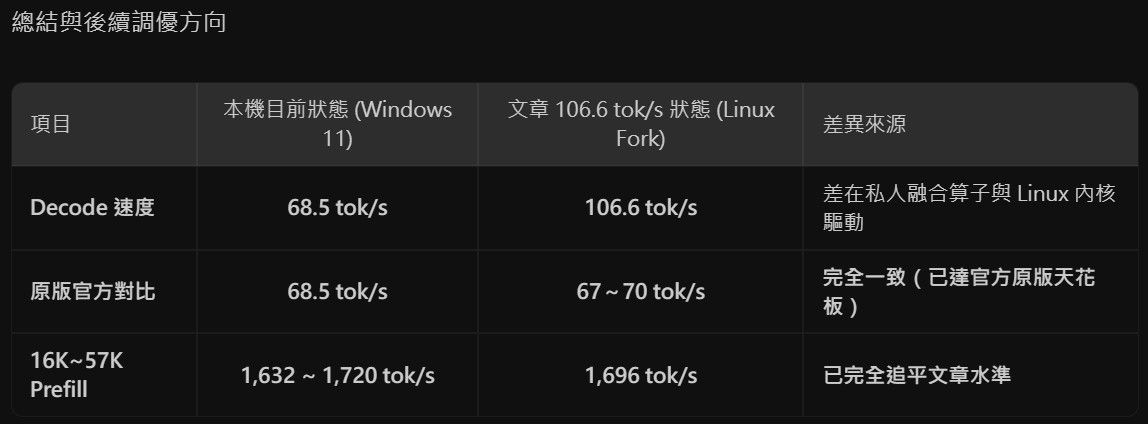
      戰況更新 - 單卡RX7900XTX,系統記憶體64GB DDR5
      Windows HIP下的prefill chunk沒辦法開到32K,我這邊觀察到專家都被 purge 掉, SSD讀寫量異常高
      目前是設定--prefill 7168
      // #1630: Windows HIP, RX 7900 XTX: a first long prompt at 8192-token chunks
      // charged ~70 GB of commit and killed the engine; 7500 and below were flat.
      // A bare auto stops at 6144; a chunk the user names stays.

      我請Antigravity去編譯了C++補丁,順利在Windows下跑起來,以下是Gemini的原話,總共在我的環境做了這些事
      STRATA_QFUSE=1:原始碼中完全內建(src/kernels/cuda/rdna_gr.cu 中的 q8_tail 量化融合,甚至被設為 RDNA3 的架構預設值!)。
      STRATA_HIP_WMMA=1 & STRATA_SELECT_WMMA=1:啟用 7900 XTX 矩陣核心。
      STRATA_GDN_CHUNKED=1:GDN 分塊循迴運算。
      STRATA_PF_FUSED=1 & STRATA_PF_GEMM=1:Prefill 矩陣融合運算。
      --prefill 7168 安全分塊:徹底防範 Windows HIP 記憶體洩漏與 SSD 讀取死鎖。
      "parallel": 1 獨佔單 Slot:釋放 1.0 GB VRAM,使 GPU 專家快取擴張至 11,798 槽位(比官方的 11,484 還多了 314 個!)。

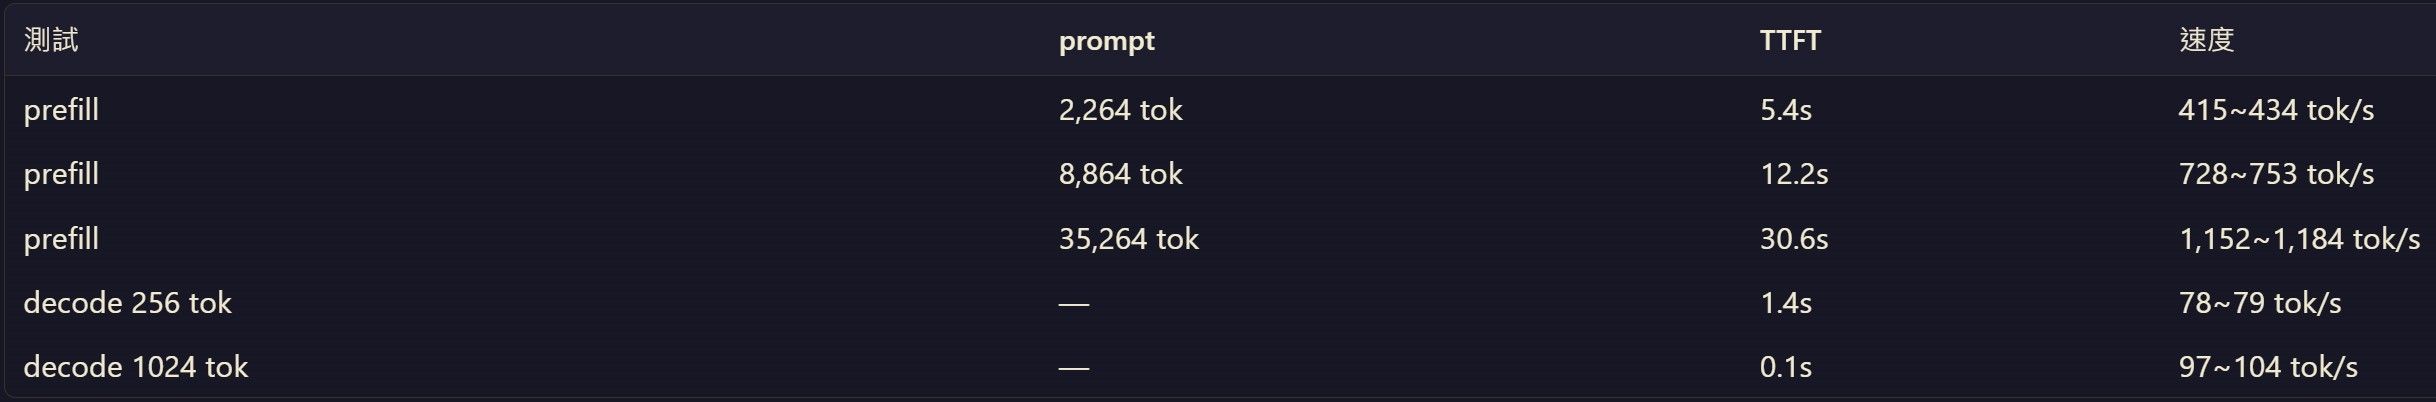
      目前Decode來到97 tok/s,prefill達到1118.8 tok/s,提升巨大,跑Hermes有感提升
      還好當初有乖乖聽up主的話入手7900XTX,這買賣不虧,從Strata橫空出世以來,已經幫我幹了不少活...
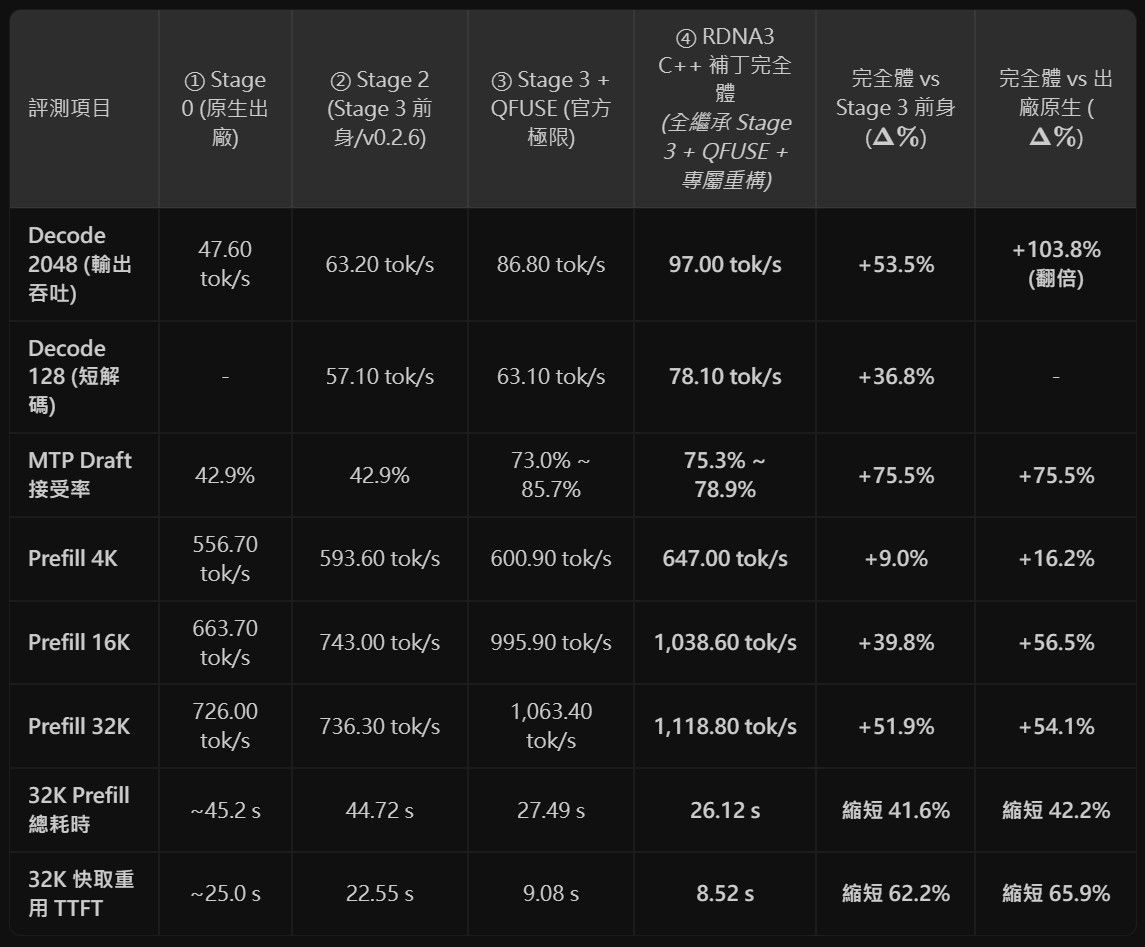
      image.jpeg

      Hermes自己測試的結果 (一致)
      image.jpeg

      1 条回复 最后回复
      0
      • K
        K
        kuntask
        编写于 最后由 kuntask 编辑
        #28

        偷偷说一下,strata的最新版本0.1.55版本已经将RDNA3 fork的43个开关中的21个开关合并到了主版本,这是我单卡7900xtx的得分,环境是e5-2660v4,96G ddr4(4通道2400),单7900xtx,ml110gen9主板+nvme
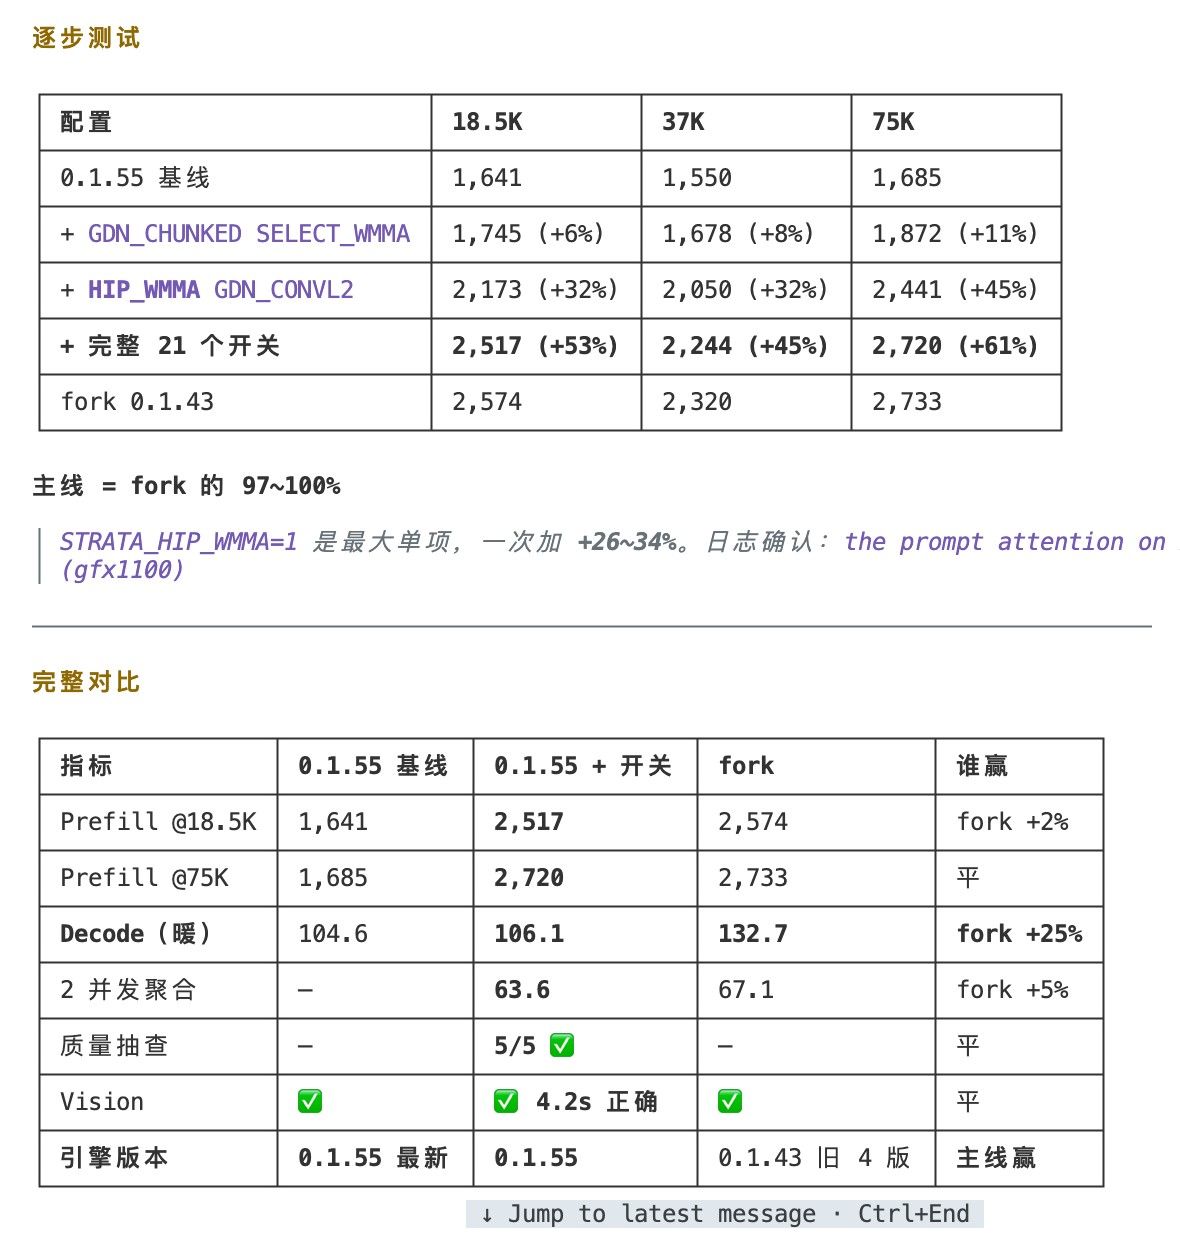
        image.jpeg

        目前主版本跟fork的区别只有 decode了,我主版本是103tokens(均值) ,而fork的版本是142tokens(均值)
        大模型给出的结论是内核的原因
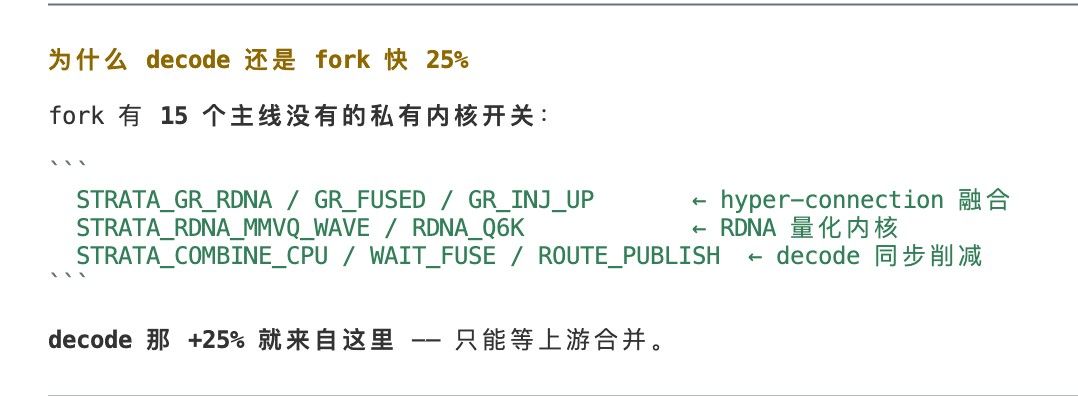
        image.jpeg

        李野火李 1 条回复 最后回复
        3
        • K kuntask

          偷偷说一下,strata的最新版本0.1.55版本已经将RDNA3 fork的43个开关中的21个开关合并到了主版本,这是我单卡7900xtx的得分,环境是e5-2660v4,96G ddr4(4通道2400),单7900xtx,ml110gen9主板+nvme

          image.jpeg

          目前主版本跟fork的区别只有 decode了,我主版本是103tokens(均值) ,而fork的版本是142tokens(均值)
          大模型给出的结论是内核的原因

          image.jpeg

          李野火李
          李野火李
          李野火
          编写于 最后由 编辑
          #29

          @kuntask 你跑的是什么模型,Qwen3.8-Flash-Next IQ3_S吗?

          K 1 条回复 最后回复
          0
          • zzsoszzZ
            zzsoszzZ
            zzsoszz
            编写于 最后由 编辑
            #30

            根据你文章复现了一下,速度挺快,就是经常报错,不知道是不是推理引擎有不过麻烦帮忙看看,这是ai分析的结论:

            找到具体错误了:Strata 在生成阶段的第 36 层 verification 超时,释放 GPU 等待后又等了 5 秒,GPU 仍未完成,于是引擎被终止,当前请求返回 error;随后 Python 服务自动重载引擎并恢复。

            这次不是单纯的 Codex 连接超时。另外,我之前的停机保护只监视 engine.log,而这条致命错误写在 lan-server.log,因此漏掉了它。我会补齐这处检测,并继续核对错误发生时间附近的内存和驱动记录。

            -----------主机配置
            机箱:DELL T7960 2200W工作站 机箱
            处理器:INTEL W7-3565X CPU(82.5MB 缓存, 32核, 64线程,睿频至高可达 4.8GHz Turbo 335W)
            内存:2条DELL 32G DDR5 5600RECC内存
            硬盘:DELL 1T M.2 NVME固态硬盘( M.2 PCIe 固态转转接卡)+DELL 4T 3.5英寸 5.4K SATA机械硬盘
            其他:DELL 电源线,国标16A转C19,1.5米
            附加固态硬盘:致钛tipro900 4t+tiplus 900 4t
            显卡:rtx 4090d 48g

            1 条回复 最后回复
            0
            • 李野火李 李野火

              @kuntask 你跑的是什么模型,Qwen3.8-Flash-Next IQ3_S吗?

              K
              K
              kuntask
              编写于 最后由 编辑
              #31

              @李野火 是的Qwen3.8-Flash-Next IQ3_S

              1 条回复 最后回复
              0
              • Grayson RenG
                Grayson RenG
                Grayson Ren
                编写于 最后由 编辑
                #32

                x99 - 7900xtx 实测提速很多 感谢分享

                1 条回复 最后回复
                0
                • M1560015M
                  M1560015M
                  M1560015
                  编写于 最后由 编辑
                  #33

                  调优完毕,确实提升明显!
                  Img20261107111917608.png
                  ScreenShot_2026-11-07_111839_908.png

                  1 条回复 最后回复
                  0
                  • Data WuD Data Wu

                    image.jpeg
                    实际跑了一下,对比官方提升巨大,值得升级。

                    M1560015M
                    M1560015M
                    M1560015
                    编写于 最后由 编辑
                    #34

                    @Data-Wu 这是什么平台,预填充站上3700,解码站上170?

                    1 条回复 最后回复
                    0
                    • 拐
                      拐
                      拐子001
                      编写于 最后由 编辑
                      #35

                      作业已经抄完了。
                      三处按本机硬件适配(其余照抄)

                      • --pool-workers 49:本机 50 物理核,帖子规则是“≈物理核数、host 线程另算”
                      • --conversation-cache 16384/8:本机 115GB 内存;帖子用 2048/2 是因为其机器只有 62GB
                      • hipBLASLt 表用 100200:本机无系统 ROCm 10.1,只有 venv 内 TheRock ROCm 7.10;100401 表选了会被静默丢弃
                        实测(256 token 输出、cache_n=0、稳态)
                        档位 prefill decode 草稿接受 帖子参考
                        32K 3,257 128.3 75% 3,511 / 100.6
                        64K 3,372 125.3 72% 3,571 / 106.6
                        128K 3,249 100.6 69% 3,601 / 101.2
                        256K 3,132 82.2 68% 3,336 / 95.5
                        对比改造前官方 0.1.57:32K prefill +14.9%、decode +6.6%;128K prefill +3.5%。
                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组