170hx跑无审查qwen 27b 300+t/s上下文拉满占用49g显存
-
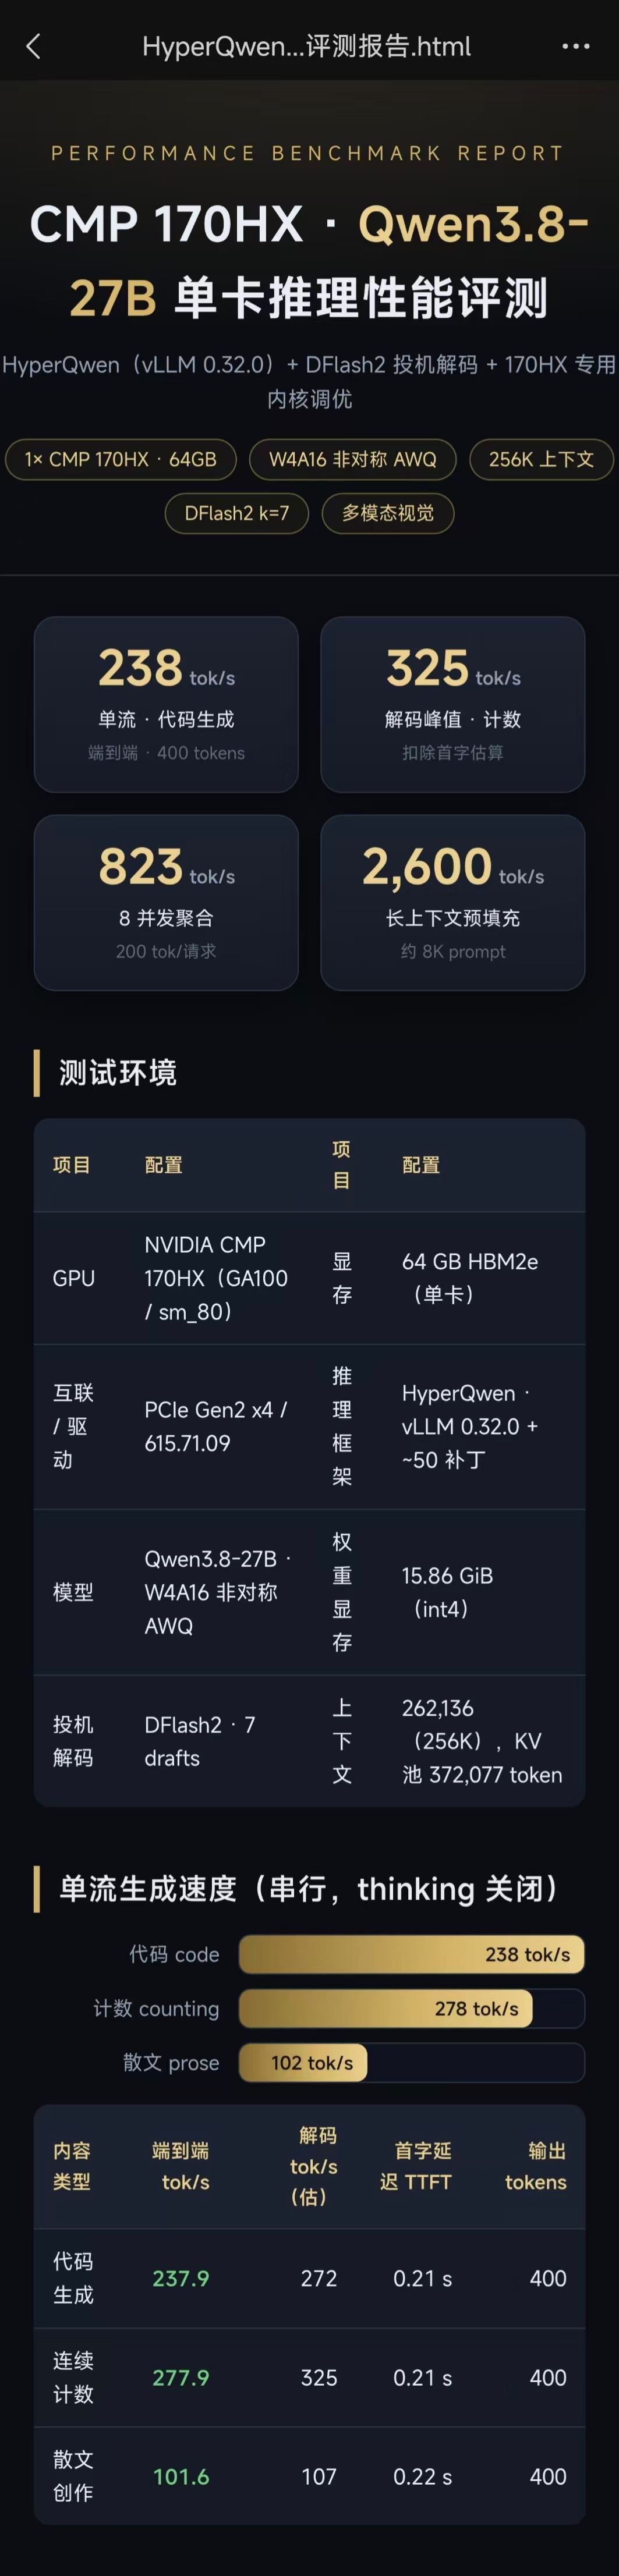
核心指标(单卡 CMP 170HX · 64G · Gen2 x4)
单流生成(thinking 关闭,400 tokens,取中位数)
内容 端到端 解码(估) 首字 TTFT 代码 237.9 tok/s ~272 0.21s 计数 277.9 tok/s ~325 0.21s 散文 101.6 tok/s ~107 0.22s 并发扩展(每请求 200 tokens)
并发 聚合 单客户端 c1 272.1 tok/s 272.1 c2 359.6 179.8 c4 562.5 140.6 c8 822.7 tok/s 102.8 长上下文预填充(读 prompt 速度)
2K→2,178 · 8K→2,622 · 32K→2,507 tok/s(32K 首字 12.8s)
加载/上下文/多模态
- 权重加载 ~30s(15.86GiB)
- 256K 上下文 / KV 池 37.2 万 token
- 3 张图一次识别 1.12s(单 prompt 最多 32 图)
配置
Qwen3.8-27B W4A16 非对称AWQ · vLLM 0.32.0(HyperQwen)+ DFlash2(k=7) · 驱动 615.71.09
CMP 170HX · Qwen3.8-27B 单卡推理性能评测
HyperQwen(vLLM 0.32.0)+ DFlash2 投机解码 + 170HX 专用内核调优
- 1× CMP 170HX · 64GB
- W4A16 非对称 AWQ
- 256K 上下文
- DFlash2 k=7
- 多模态视觉
指标 数值 单流 · 代码生成 238 tok/s(端到端 · 400 tokens) 解码峰值 · 计数 325 tok/s(扣除首字估算) 8 并发聚合 823 tok/s(200 tok/请求) 长上下文预填充 2,600 tok/s(约 8K prompt) 测试环境
项目 配置 项目 配置 GPU NVIDIA CMP 170HX(GA100 / sm_80) 显存 64 GB HBM2e(单卡) 互联 / 驱动 PCIe Gen2 x4 / 615.71.09 推理框架 HyperQwen · vLLM 0.32.0 + ~50 补丁 模型 Qwen3.8-27B · W4A16 非对称AWQ 权重显存 15.86 GiB(int4) 投机解码 DFlash2 · 7 drafts 上下文 262,136(256K),KV 池 372,077 token 单流生成速度(串行,thinking 关闭)
内容类型 端到端 tok/s 解码 tok/s(估) 首字延迟 TTFT 输出 tokens 代码生成 237.9 272 0.21 s 400 连续计数 277.9 325 0.21 s 400 散文创作 101.6 107 0.22 s 400 - 代码 code:238 tok/s
- 计数 counting:278 tok/s
- 散文 prose:102 tok/s
并发扩展(每请求 200 tokens)
并发 聚合 tok/s 单客户端 tok/s 总耗时 扩展比 1 272.1 272.1 0.73 s 1.00× 2 359.6 179.8 1.11 s 1.32× 4 562.5 140.6 1.42 s 2.07× 8 822.7 102.8 1.94 s 3.02× - c1:272 tok/s
- c2 聚合:360 tok/s
- c4 聚合:563 tok/s
- c8 聚合:823 tok/s
长上下文预填充(读取/喂 prompt 速度)
输入长度 实际 prompt tokens 首字延迟 TTFT 预填充速度 约 2K 2,057 0.94 s 2,178 tok/s 约 8K 8,057 3.07 s 2,622 tok/s 约 32K 32,057 12.79 s 2,507 tok/s 多模态 · 视觉
同一次请求送入 3 张图片(红 / 绿 / 蓝),模型正确识别并作答;单次响应耗时 1.12 s。单 prompt 支持最多 32 张图片。
模型加载与上下文
项目 数值 权重加载(15.86 GiB) ~30 s 最大上下文 tokens 256 K KV 池 tokens 37.2 万 短 prompt 首字延迟 0.21 s 为什么这么快
- DFlash2 投机解码:每步前瞻 7 个 draft token,高命中率,单流大幅提速。
- 170HX 专用内核调优:split-KV verify kernel 用 64-token KV tile(GA100 163KB 共享内存),长上下文 +17~25%。
- GA100 稳定修复:Marlin 重排 + 内存分配器调参,规避 Xid 31,长时间稳定。
- 256K 超长上下文:64GB 显存几乎全给 KV,单卡即可容纳 25 万+ token 的文档/代码库。
-
-
-
-
-
-
-
-