Mac 用引擎自带脚本跑通 MiniMax-H3-Image:84 秒一张 5K 图,全程本地
-
Mac 上跑通了 MiniMax-H3-Image:84 秒一张 5K 图,全程本地
折腾了一下午,把 Phosphene + MiniMax-H3-Image 开源图像模型在 M5 Ultra 上跑通了。踩的坑和命令都记在这儿,新鲜出炉想抄的直接抄。
先说结果
两张测试图都在楼下,都是本机出的,没碰任何云端 API。
档位 输出 耗时 内存峰值 4MP 2720 × 1536 22.6 秒 27.6 GB 16MP 5472 × 3072 83.5 秒 27.8 GB 机器是 M5 Ultra 256GB,Python 3.13,模型钉的是
6534ea1c这个 revision。有两件事跟我预期不一样,先说在前面:
一是内存。官方说要 48GB 起,我一开始做好了它吃掉大几十 GB 的准备,结果峰值只有 27.8GB——它是分段加载的,28GB 的文本编码用完就放,再上 20GB 的量化 DiT。也就是说 64GB 的机器应该真能跑,不是我这种 256GB 大户专属。
二是快慢。耗时几乎全在去噪那 6 步上,16MP 每步 12 秒出头。没有 CFG 没有负向提示词这些额外开销,6 步就是 6 步。
这是套是什么东西
Phosphene 是个 MIT 协议的 Mac 本地 AI 工作室,视频图像音乐都有,v5.0.15 版本起支持 MiniMax-H3-Image——MiniMax 开源的纯文生图模型。底层引擎 minimax-h3-mlx 也是开源的。
我没装它的 Pinokio 和 Mac App,直接用引擎自带的脚本跑。理由很简单:依赖少,路径全在自己手里,坏了知道哪儿坏的。下面的步骤就是这条路线。
装之前备好这些
- Apple Silicon,官方口径 ≥48GB 统一内存(我实测峰值 27.8GB,64GB 机器够呛但应该能跑,有 64GB 机器的兄弟可以验证下)
- 磁盘先留 90GB:源分片 68.6GB + 量化后 20GB。量化确认没问题后源分片可以删,能回收 68.6GB
- Python 3.13,brew 装一个就行,别动系统自带的
抄作业
① 拉引擎,注意要 checkout 到指定提交
main 分支上没有图像脚本,得切到这个提交:
git clone https://github.com/mrbizarro/minimax-h3-mlx.git
cd minimax-h3-mlx
git checkout d65ec9f710fce31fbe9efa375537b5c94d83d7fe

python3.13 -m venv ../venv
../venv/bin/pip install -r requirements.txt
② 下模型
仓库
MiniMaxAI/MiniMax-H3-Image,revision6534ea1c979a5f8cb00c2bd1025d5ca4ee8d8901。国内直接连 huggingface 费劲的话,URL 里的域名换成 hf-mirror.com 就行,浏览器、IDM、aria2 随意:https://hf-mirror.com/MiniMaxAI/MiniMax-H3-Image/resolve/6534ea1c979a5f8cb00c2bd1025d5ca4ee8d8901/<路径>一共 20 个文件,按这个结构摆(模型根目录假设叫
models/minimax-h3-image/):models/minimax-h3-image/ ├── LICENSE ├── model_index.json ├── pdd_config.json ├── pdd_fused_heads.safetensors (12 MB) ├── vae/ │ ├── config.json │ └── diffusion_pytorch_model.safetensors (2.3 GB) └── source/transformer/ ├── config.json ├── model.safetensors.index.json └── model-00001-of-00012.safetensors … model-00012-of-00012.safetensors (12 片,共 66.3 GB)文本编码器是另一个仓库的,单独拿两个文件:
models/text/
├── text_encoder.safetensors   ← ddalcu/MiniMax-H3-FL2VA-MLX-Serve-8bit 仓库(28.2 GB)
└── config.json                ← MiniMaxAI/MiniMax-H3 仓库里的 FL2VA/text_encoder/config.json
要是你之前用 mlx 跑过 H3 视频包,这个 text_encoder 直接拿现成的,先对一下 sha256 再复用,能省 28GB 下载。我就是这么省的。
③ 校验加量化,一条命令
../venv/bin/python scripts/fetch_h3_image.py \
    --dir ../models/minimax-h3-image --accepted --keep-source
已经下好的文件它只做 sha256 校验不会重新下,这点放心。校验过了就逐片量化成 8-bit,顺手把 AdaLN 表预计算好,产出
dit/目录(20GB)。我这边跑了十几分钟,看到PACK OK就是成了。④ 出图
../venv/bin/python scripts/generate_h3_image.py "你的英文提示词" \ -o out.png \ --root ../models/minimax-h3-image \ --text-dir ../models/text \ --text-config ../models/text/config.json \ --aspect 16:9 --mp 16 --seed 7--mp就三档:4、8、16。seed 固定住能复现,加--metrics metrics.json会把每段耗时落下来,想看瓶颈在哪就加。
两张测试图论坛图片大小有限制做了分辨率降低,提示词原文奉上
第一张试水,4MP,22.6 秒:
A weathered wooden fishing boat resting on a black sand beach at dawn, low golden sunlight raking across wet sand, thin mist over calm water, distant volcanic ridge behind, shot on 35mm film, medium format look, soft natural grain, warm muted palette, quiet documentary photography style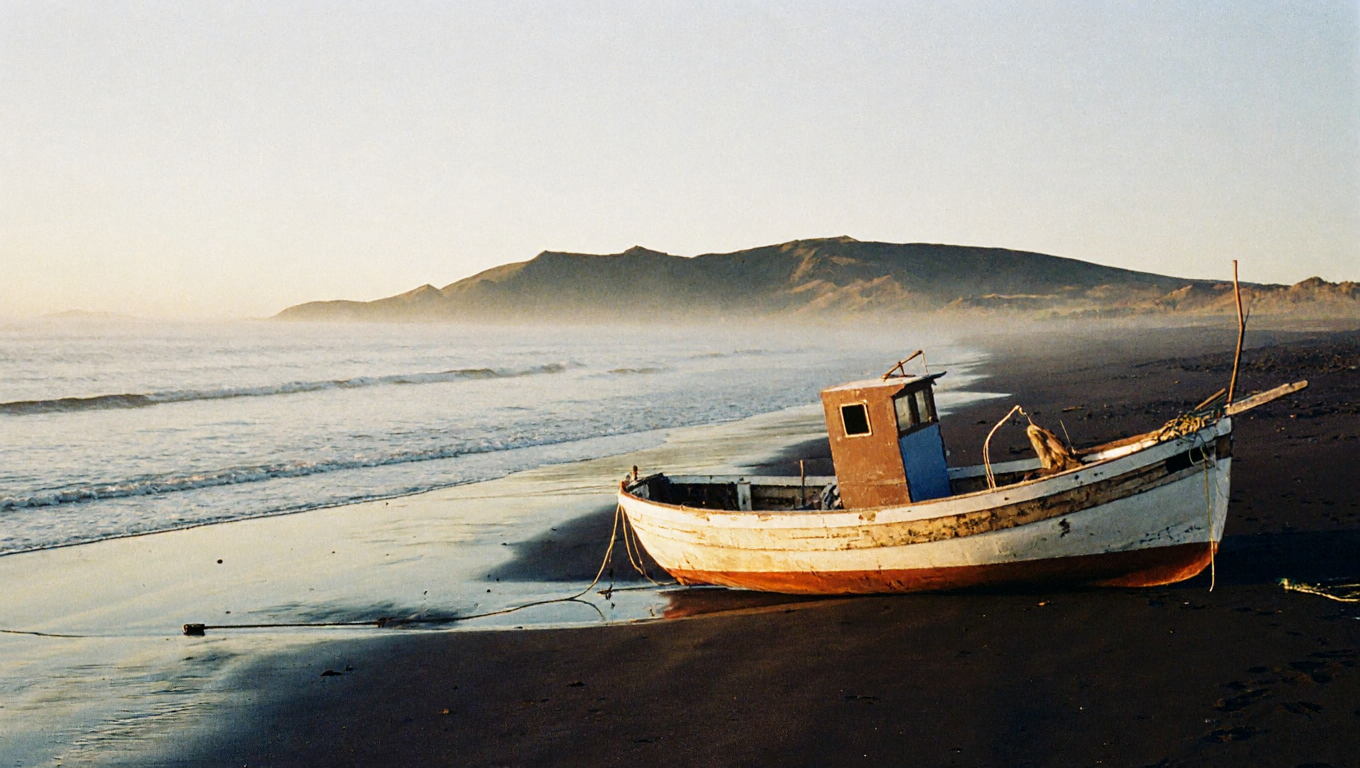
黑沙的质感、水雾、侧逆光都扎实,颗粒感像胶片,直接能用的水平。
第二张是我故意刁难它的,16MP,83.5 秒。中文招牌字、英文刻字、机械手套五根手指、杯壁水珠、窗下睡猫,全塞一条里:
Cinematic 8K ultra-detailed wide-angle shot. In the center-right of the frame, a focused young East Asian cyberpunk craftswoman sits at a cluttered workbench, wearing a weathered leather apron. Her right hand is a delicate brass mechanical prosthetic glove with five clearly defined, anatomically precise articulated fingers, carefully holding tiny microchips with precision tweezers; her left hand is a natural human hand holding a soldering pen. On the desk sits a frosted translucent glass cup with visible water condensation droplets, an open aged leather notebook, and a polished metallic badge clearly engraved with the exact legible text: "极客工坊" and "CYBER TECH 2026". In the left background, a large rain-streaked floor-to-ceiling glass window reflects the cool blue neon lights of a futuristic rainy cyberpunk metropolis; curled up beneath the window is a fluffy tabby cat sleeping peacefully. Volumetric lighting with warm tungsten desk lamp contrasting with cool neon ambiance, Tyndall effect with floating dust motes, rich textures, deep depth of field, sharp focus, 35mm film photography aesthetic.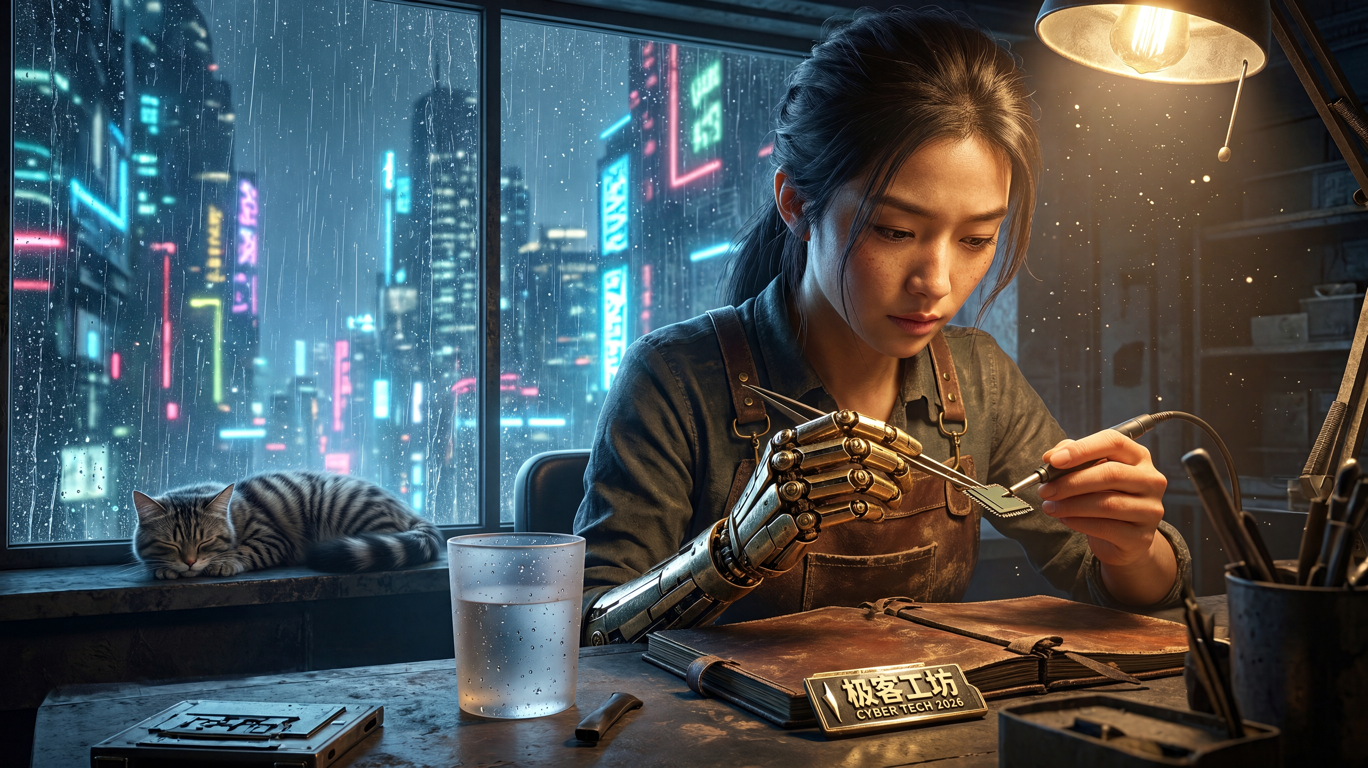
附上中文提示词给大家对照出图效果:
一幅电影质感、细节极其丰富的8K超高清广角场景。 画面中央偏右,一位年轻的东亚赛博朋克工匠女性坐在工作台前,穿着做旧的皮质围裙和工装,眼神专注。她的右手戴着精密的黄铜机械义肢手套,五指修长且骨节分明,正用细镊子小心翼翼地夹取一枚微型芯片;左手为真实的人类手掌,握着一把烙铁。 工作台上摆放着半透明磨砂玻璃水杯(杯壁有清晰凝结的水珠)、一本摊开的皮革笔记本(纸页泛黄、边缘磨损)、以及一枚发光的金属铭牌,铭牌上清晰镌刻着中文字样“极客工坊”和英文“CYBER TECH 2026”,字迹锐利工整。 画面左侧背景是一扇被夜雨打湿的大落地玻璃窗,窗外是赛博朋克风格的雨夜都市街景,散落着霓虹灯的倒影和漫射光晕;窗户下方趴着一只毛发蓬松的虎斑猫,正在安详沉睡。 整体采用丁达尔效应强烈的暖金色钨丝台灯光与窗外冷蓝色霓虹光的冷暖对比色调,景深层次分明,微距微尘在光束中浮动,真实胶片颗粒感,体积光,无模糊,超高清晰度。中文渲染是这类模型的照妖镜,放大看徽章上"极客工坊"四个字和那五根手指,行不行你们自己判。有瑕疵就换 seed 重跑,一分多钟的事,不心疼。
顺带一提:输出 5472×3072分辨率,24MB PNG格式,因论坛限制上传图片容量为改为1368*768了。
许可证,发帖前扫一眼
Phosphene 和引擎都是 MIT,随便用。但 MiniMax-H3-Image 是 Community License,有几条得注意:运行和生成物的使用地域排除了美国、欧盟、英国、韩国;不能拿生成物去训练别的模型;界面上要保留 "MiniMax-H3-Image" 署名;年收入超 100 万美元或者对外提供服务,得拿书面授权。本地自己玩没事,要往全球可达的地方发图的,自己掂量。
下载时记得把仓库里的 LICENSE 和 NOTICE 放在模型旁边,别删。
66GB 的开源图像模型,量化到 20GB、峰值 28GB 内存、84 秒出 5K 图。本地生图"能不能"的问题,M5 Ultra 机器算是翻篇了,剩下的是"好不好"——这个你们看图评。
哈哈,我很满意

-
意思是为了做出真正fullframe效果,得购买一颗比600f4还贵得显示卡。。。我比较期待可以否直接做出raw档案格式。。。
-
-
-
感谢分享。先记录一下,试试在MAX上的表现
-
-
我在7900xtx单卡和m2max mbp 96G上分别部署了一下,苹果上主要的心得是:不要用量化,bf16更快,bf16 比 8bit 快 27%,比 4bit 快 21%。但在我的老m2max平台上出4MP图仍然需要159.2s+26.5s=181.9s一张图,比楼主的M5 Ultra 生生慢了两分钟