
[H3剑心比赛] RTX 4080 SUPER 16G 单卡|1344×768 / 12 秒|标准配置,不挂加速 LoRA
-
一、口径
按题目统一前提:MiniMax H3、1344×768、12 秒、帖子给的统一提示词、6 张参考图,3D 一个 2D 一个。
提示词正文一字未改,只做了两件事,都写在附件里可逐字复现:
- 在正文前面加了一段参考图绑定说明,指明
<Picture 1>~<Picture 3>是剑心、<Picture 4>~<Picture 6>是志志雄,以及各自要保留的外形特征。原因是 H3 的 Ref2VA 靠提示词里的标签绑定参考图,不加这段的话,挂上去的 6 张图基本不生效,模型会按"红衣剑客"自己编人。 - 3D 版在 Style 括号里补了 3D 渲染强化词(PBR 材质、体积光、无描边、非 2D)。不加这段的话,3D 那条会退回 2D 平涂。
成片:
二、硬件
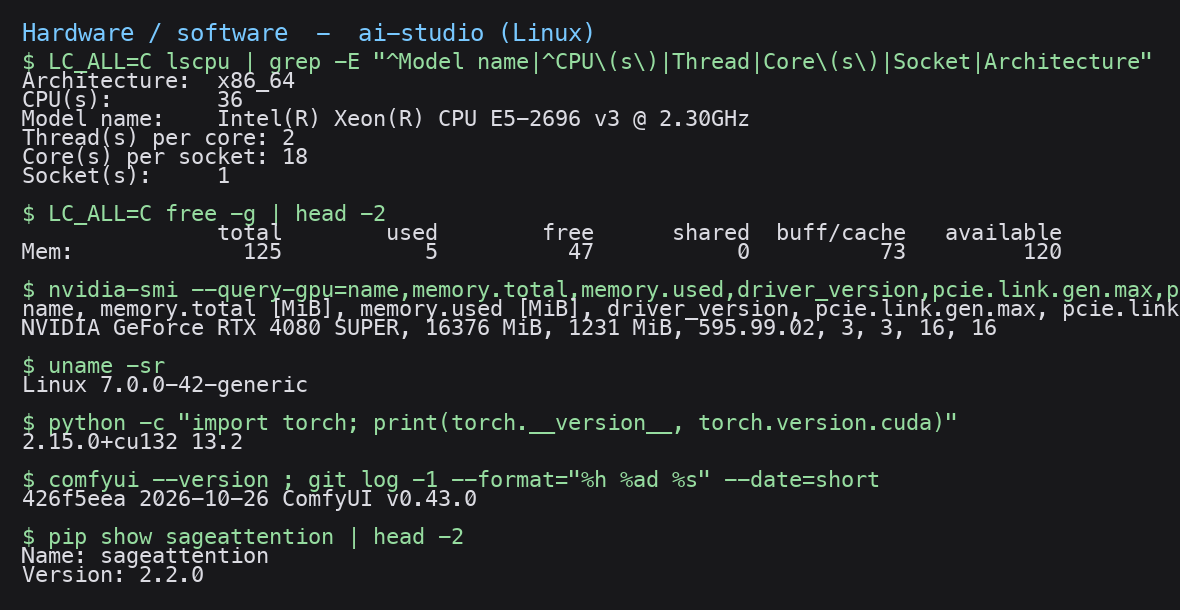
- GPU:RTX 4080 SUPER 16 GB(Ada,sm_89)
- 平台:华南金牌 X99-TF + Xeon E5-2696 v3(18C/36T,无 AVX-512)+ 128 GB DDR3 四通道
- 链路:PCIe 3.0 x16,负载下 H2D 约 10.1 GB/s,Resizable BAR 未开
- 系统:Ubuntu 24.04 / 内核 7.0.0-42 / 驱动 595.99.02 / CUDA 13.2
- 显存峰值:15,909 MiB(2D)、15,876 MiB(3D),贴边但无 OOM
三、模型与工作流
- DiT:
minimax_h3_ref2va_pruned_int8_convrot.safetensors(20.97 GB) - 文本编码器:
qwen3vl_32b_minimax_h3_int8_convrot.safetensors(27.1 GB) - VAE:
minimax_h3_video_vae_int8_convrot+minimax_h3_audio_vae_fp32 - 采样:res_multistep + beta 调度器,20 步稠密,不挂加速 LoRA
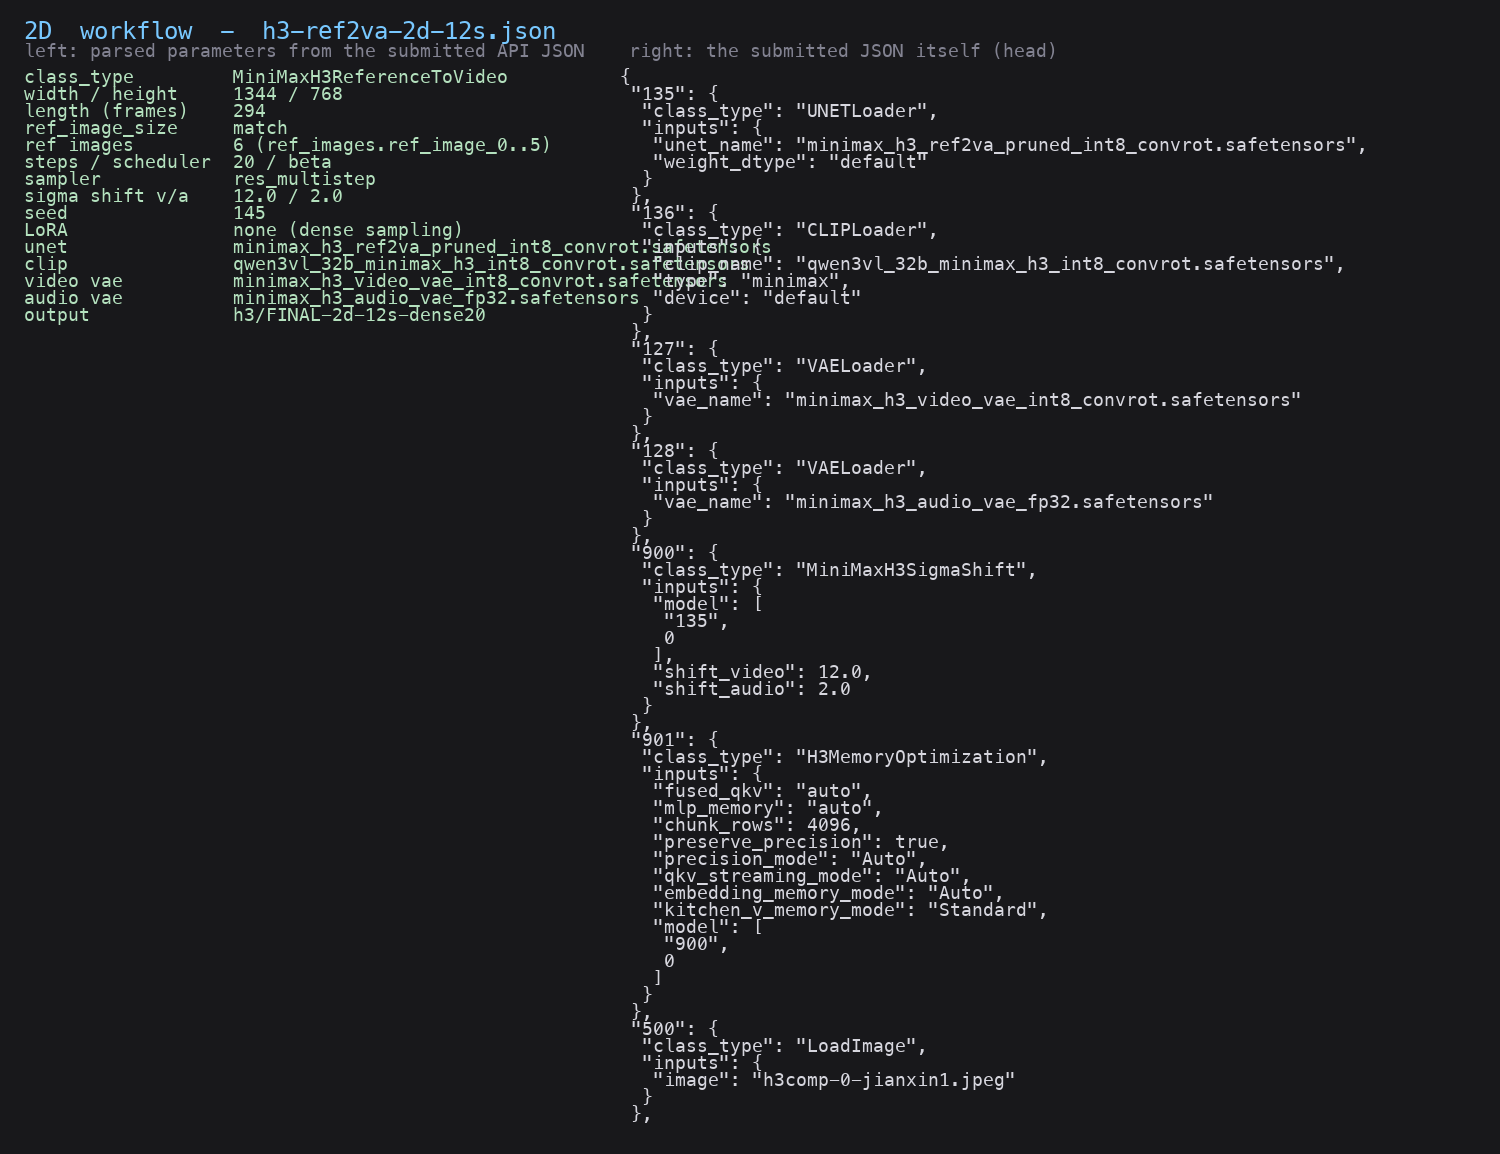
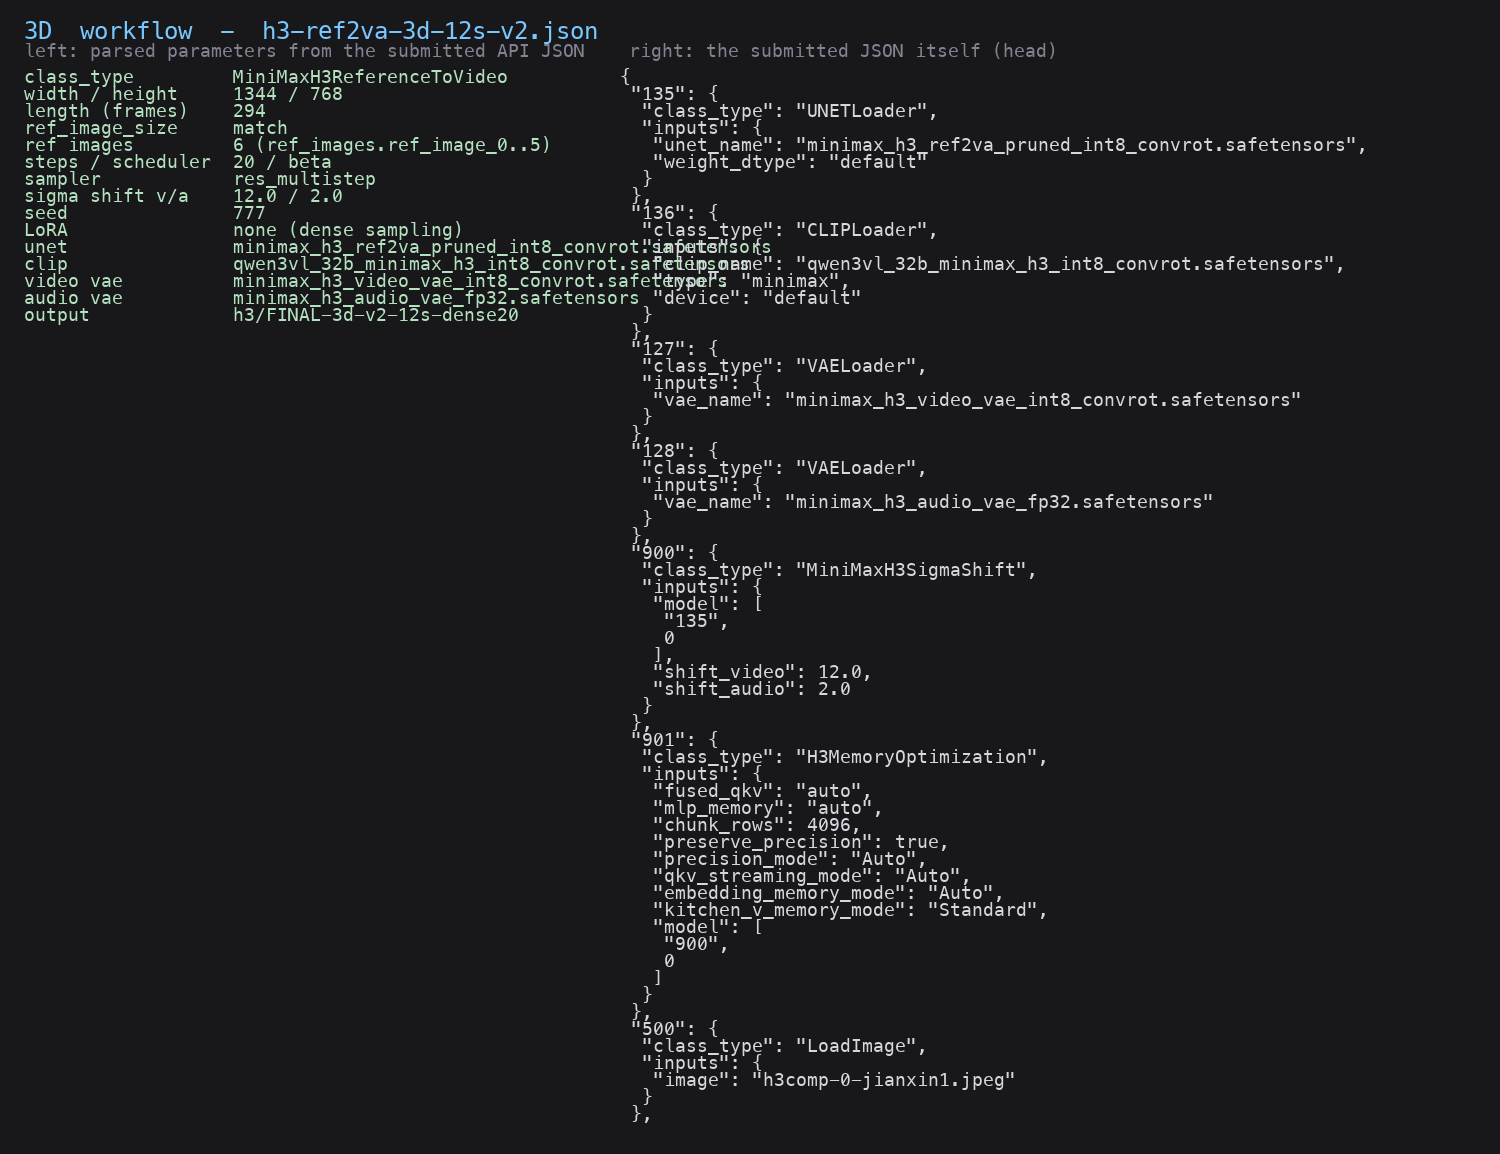
- SigmaShift:video 12.0 / audio 2.0
- 参考图:Ref2VA 挂 6 张,ref_image_size=match
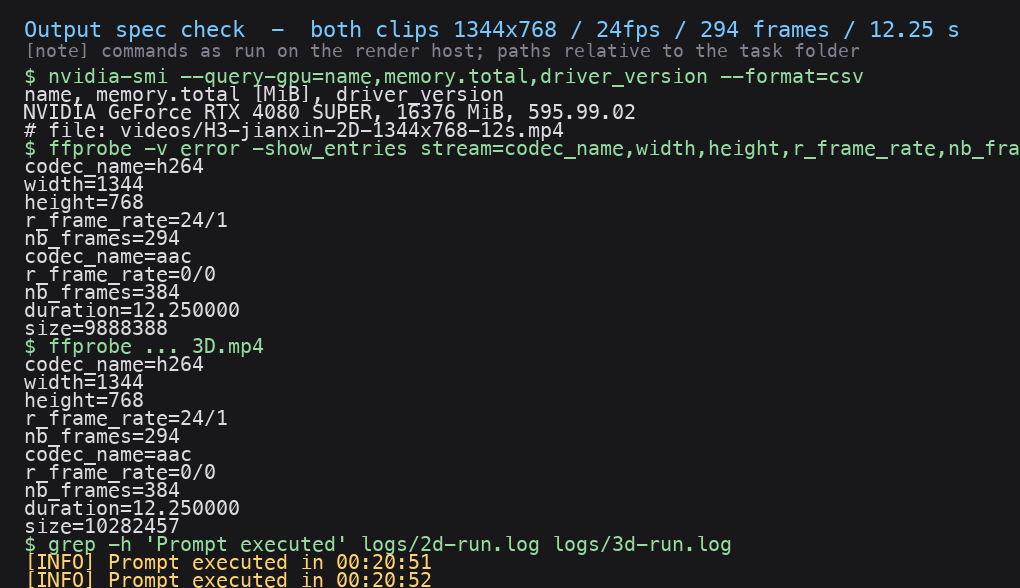
- 帧数:294(17n+5 对齐,24fps 下 12.25 秒,非硬填,导出不裁)
- 种子:2D 145、3D 777,均固定
- 框架:ComfyUI v0.43.0(提交 426f5eea),PyTorch 2.15.0+cu132
工作流原件(可直接导入复现):
- 2D:https://upload.lcz.me/uploads/99796628-1c7f-4797-81fe-381384115068.json
- 3D:https://upload.lcz.me/uploads/f53ea801-1e08-4ebd-b2fc-0bb7ebd36e40.json
逐字提示词:
- 2D:https://upload.lcz.me/uploads/1d9f2116-680a-4fda-b836-c2e7d9f55968.txt
- 3D:https://upload.lcz.me/uploads/916c9874-5201-42e2-8d18-0d2df057ab3e.txt
工作流参数(左为从实际提交的 JSON 解析,右为 JSON 原文):
四、加速手段
- SageAttention 2.2.0
- ComfyUI 原生 H3MemoryOptimization(int8 ConvRot 分块换入)+ 启动参数
--lowvram - int8 ConvRot 剪枝权重
- 没有挂任何 turbo / DMAD / LCM 加速 LoRA,也没有降分辨率或二次超分
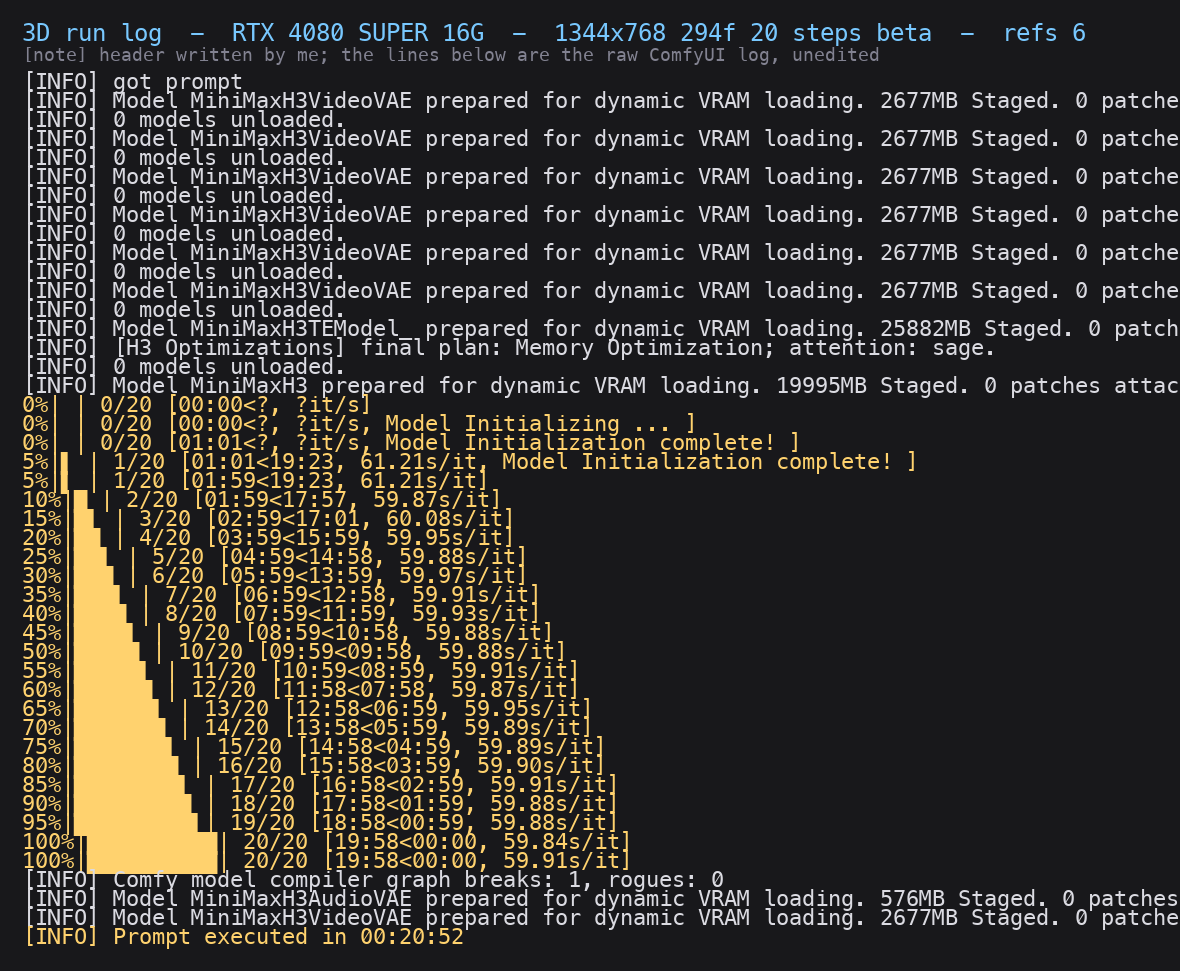
五、生成速度(1344×768 / 294 帧 / 20 步稠密)
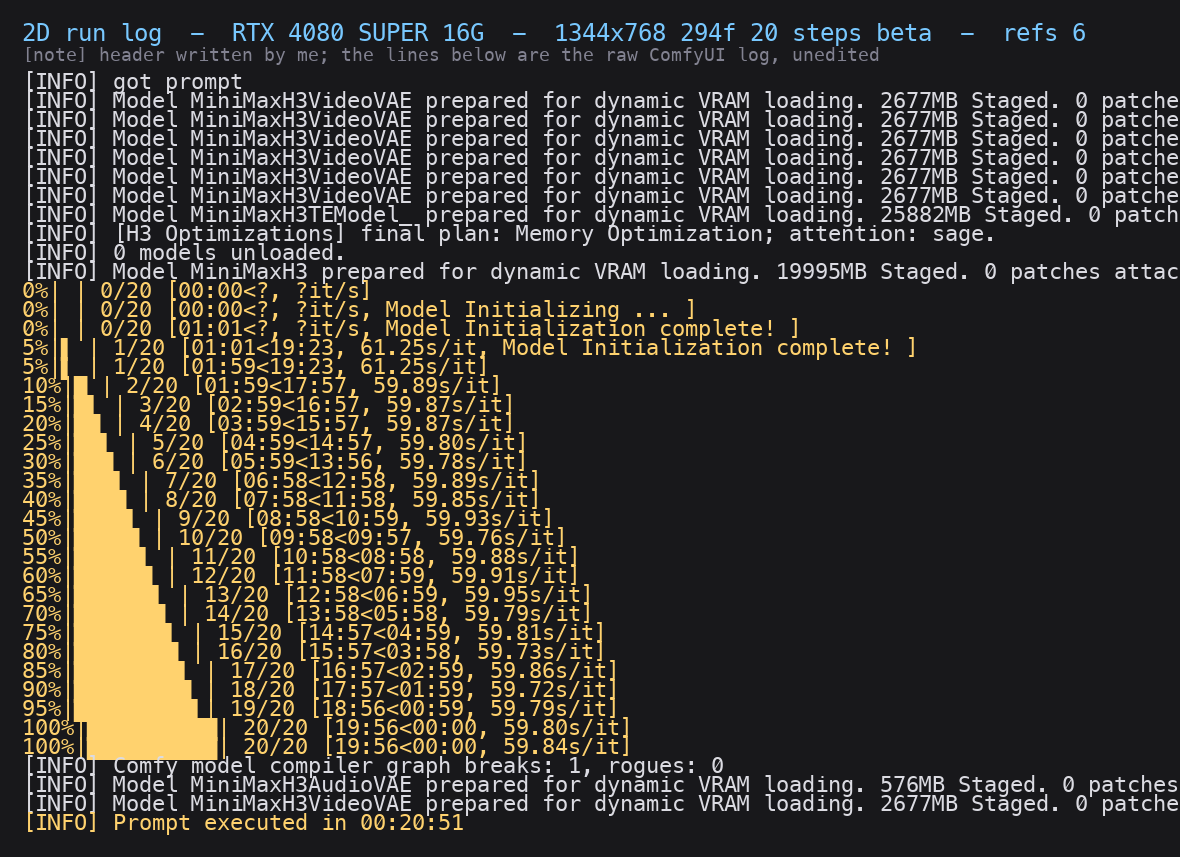
版本 端到端 日志 Prompt executed in(即 Total Time) 每步 显存峰值 2D 1251.8 秒 00:20:51 59.84 s/it 15,909 MiB 3D 1253.7 秒 00:20:52 59.91 s/it 15,876 MiB 冷启动含模型加载(20.97 GB DiT + 27.1 GB 文本编码器)。每步成本与步数基本无关:4 步档每步 57.06 秒,20 步档每步 59.84 秒,所以总时长约等于步数 × 60 秒。
2D 完整运行日志:
3D 完整运行日志:
成品规格自检:
六、同口径对照
步数不是题目规定的,各人自选,所以光看总时间没有可比性。下面按“同等步数”和“同等显存档”各找一个参照。
同等步数:4090 D 48G(3053 帖,20 步 beta + 两档 sigma 精修,折合 22 次前向)
4090 D 48G 本机 4080 SUPER 16G 端到端 9 分 15 秒 / 9 分 30 秒 20 分 51 秒 / 20 分 52 秒 折算单步 约 25 秒 59.8 秒 倍数 1 2.4 同等显存档:5070 Ti 16G(3047 帖,6 步 LCM + Pika LoRA + SOL Attention)
本机按他的配置跑了一遍(6 步 LCM + Pika Flex ref2va LoRA + Comfy Kitchen 注意力,其余同本文工作流):
5070 Ti 16G 本机 4080 SUPER 16G 步数 / 采样 6 步 LCM 6 步 LCM + Pika + Kitchen 采样耗时 269.7 秒(45.0 秒/步) 389.5 秒(64.9 秒/步) 端到端 390.8 秒 430.4 秒 显存峰值 14,715 MiB 15,681 MiB 帧数 生成 294、导出裁到 288 294 再加一条加速档参考:4 步 turbo 本机 275.6 秒(4 分 36 秒),比 7900 XTX 双卡(3054 帖,同样 4 步)报的 7 分 00 秒还快。
怎么读这三组数:
对 4090 D 48G 单步慢 2.4 倍。48 GB 卡能把 20.97 GB 的 DiT 和 27.1 GB 的文本编码器整只放进显存;16 GB 卡每步都要经 PCIe 3.0 x16 从内存换入换出,DDR3 平台的内存带宽也拖后腿。这是显存账,不是算力账。
对 5070 Ti 16G 这一组要拆开看。端到端只慢 10% 并不是平台只差 10%,而是两个方向相反的因素叠在一起:
- 他的 Total Time 从服务启动算起,非采样部分 121 秒;我们只算 41 秒。这多出来的 80 秒把采样段的差距吃掉一半。
- 采样段他每步 45.0 秒,我们 64.9 秒,单步实际慢 44%。这才是真实差距。
这 44% 的差,我能测的部分拆成两块,第三块只给判断:
- 注意力后端(可测):为了对齐他写的 SOL Attention,我用的是 Comfy Kitchen。本机同分辨率、8 步、5 秒档的基线是 Sage 143.1 秒、Kitchen 166.8 秒,Kitchen 慢 16.6%。换回 Sage 大约能拿回 15%,折算到 6 步是 55 秒上下。
- 平台换入带宽(有方向性证据):20.97 GB 的 DiT 在 16 GB 卡上必须分块换入,本机 PCIe 3.0 x16 实测 H2D 10.1 GB/s;对方是 Ryzen 9 3900X + PCIe 4.0/5.0 + 125 GiB 内存,理论带宽是我们的两到三倍。这一项在 20 步档放大得更明显(对 4090 D 单步慢 2.4 倍)。
- 架构(只能判断,不下结论):Ada 对 Blackwell,int8 吞吐与指令集不同,没有同机对照,我不硬说哪一项占多少。
所以更准确的说法是:这张 4080 SUPER 在 6 步档上单步比 5070 Ti 慢四成,其中约六分之一能用注意力后端解释,其余指向 PCIe 3.0 + DDR3 的换入成本与架构差异;端到端只差一成,是对方的启动开销替我们挡了一部分。
4 步档反而比 7900 XTX 双卡快一倍。
结论:20 分 51 秒是“20 步稠密 + 16 GB 显存”的真实代价,不是卡本身慢。要进 6 到 9 分钟,得压步数或者两阶段超分,那是另一种口径。
七、两个坑,报给社区
- ComfyUI 里 H3 的参考图是 autogrow 输入,API 提交必须用点分扁平键
ref_images.ref_image_0这种写法。写成嵌套字典{"ref_images": {...}}不报错、任务也成功,但参考图被静默丢掉。我用同一输入只改 ref_image_size(match / max)各跑一次,两次输出逐像素完全相同(SSIM 1.000000)才确认;改成扁平键后 SSIM 0.378。这是 bug 修复,不是调参。 - turbo 4 步 LoRA 配 beta 调度器,在 480p 上直接出网格噪纹加偏色,整段废片;配 simple 能出图,但 12 秒档中段约 1.6 秒重影溶解。所以这次老老实实跑 20 步稠密。
八、如实说明(别被我这楼带偏)
- 我做过灰图对照:把 6 张参考图换成一张纯灰图,两个角色照样画得出来、也认得出来。这次身份还原主要来自提示词里的名字、特征描述与模型先验,参考图最多补细节。我不声称“参考图驱动了身份还原”。
- 3D 版是半 3D(手办渲染质感),人物脸仍是动画式五官,不是写实 CG。
- 剑心左颊的十字疤、志志雄的锯齿刀,在 1344×768 下抽帧看不清;两条的末帧都是志志雄正脸特写,绷带头、碎发、狞笑与参考图对得上。
- 2D 中段约 3 到 7 秒停在刀刃相抵的同一构图,有火花与镜头抖动,不算卡死,但节奏偏慢。
九、附件
- 工作流 JSON(可直接导入):2D、3D 各一份
- 逐字提示词:2D、3D 各一份
- 硬件截图:lscpu / free / nvidia-smi(含 PCIe Gen3 x16)/ torch / SageAttention 版本
- 完整运行日志截图:含
Prompt executed in 00:20:51与00:20:52 - 规格自检:ffprobe 显示 1344×768、24fps、294 帧、12.25 秒、AAC 32 kHz 立体声
- 同口径对照用的 6 步 LCM 运行日志
十、结论
16 GB 单卡在 20 步稠密下跑 1344×768 / 12 秒 H3,单条约 21 分钟,显存贴到 15.9 GiB。同口径对照显示,差距来自步数与显存换入,而不是这张卡的绝对算力:4 步档它比 7900 XTX 双卡快,6 步档它只比 5070 Ti 慢 10%。
- 在正文前面加了一段参考图绑定说明,指明
-
,
 M mo lynch5 引用了 此主题
-
-
-
补一条证据,对应正文第六节的「同等显存档」对照。
本机按 5070 Ti 那位的配置复跑(6 步 LCM)
为了和 3047 帖(RTX 5070 Ti 16G,6 步 LCM + Pika LoRA + SOL Attention)对齐,我在本机用同一套思路跑了一遍:
- 采样:6 步、
lcm采样器、simple 调度器 - 加速 LoRA:
pika_h3_flex_ref2va_v1_bf16(强度 1.0) - 注意力:Comfy Kitchen attention(对应他写的 SOL Attention)
- 其余同正文工作流:ref2va pruned int8、int8 ConvRot 文本编码器、1344×768、294 帧、种子 145
结果:
5070 Ti 16G(3047 帖) 本机 4080 SUPER 16G 采样耗时 269.7 秒(45.0 秒/步) 389.5 秒(64.9 秒/步) 端到端 390.8 秒 430.4 秒 显存峰值 14,715 MiB 15,681 MiB 日志:
100%|██████████| 6/6 [06:29<00:00, 64.92s/it],Prompt executed in 429.29 seconds。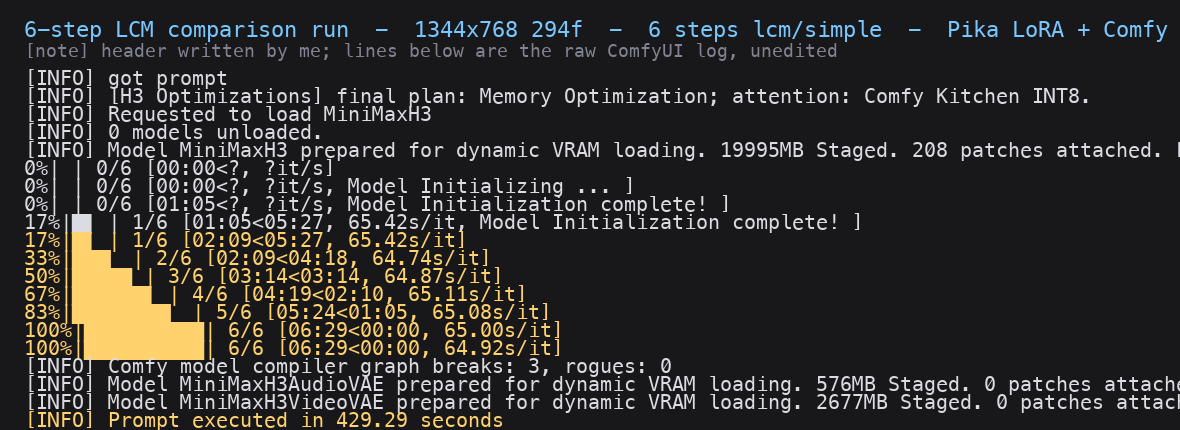
工作流 JSON:https://upload.lcz.me/uploads/9831858c-f15e-4112-9259-b58a18987e0a.json
差在哪
端到端只慢 10%,但这不是平台只差一成:他的 Total Time 含约 121 秒服务启动开销,本机只含 41 秒,把采样段的差距挡掉一半。真实差距在单步,我们慢 44%。
拆开看:
- 注意力后端:本机同分辨率、8 步、5 秒档的基线是 Sage 143.1 秒、Comfy Kitchen 166.8 秒,Kitchen 慢 16.6%,折算到 6 步约 55 秒/步。这部分占单步差距的六分之一左右。
- 平台换入:20.97 GB 的 DiT 在 16 GB 卡上必须分块换入,本机 PCIe 3.0 x16 实测 H2D 10.1 GB/s,对方是 PCIe 4.0/5.0 平台,带宽是我们的两到三倍;CPU 侧还是 Xeon E5-2696 v3 + DDR3。
- 架构差异(Ada 对 Blackwell 的 int8 吞吐)没有同机对照,不给具体比例。
对照一下 20 步档就更清楚:本机 20 分 51 秒,4090 D 48G 同样 20 步是 9 分 15 秒,单步差 2.4 倍——那一档的差主要也是显存装不装得下,而不是算力。
所以本机这条 20 分 51 秒,是「20 步稠密 + 16 GB 显存」的真实代价;把步数压到 6 步,同样一张卡 7 分 10 秒就能出片。
- 采样:6 步、
-
补一条证据,对应正文第六节的「同等显存档」对照。
本机按 5070 Ti 那位的配置复跑(6 步 LCM)
为了和 3047 帖(RTX 5070 Ti 16G,6 步 LCM + Pika LoRA + SOL Attention)对齐,我在本机用同一套思路跑了一遍:
- 采样:6 步、
lcm采样器、simple 调度器 - 加速 LoRA:
pika_h3_flex_ref2va_v1_bf16(强度 1.0) - 注意力:Comfy Kitchen attention(对应他写的 SOL Attention)
- 其余同正文工作流:ref2va pruned int8、int8 ConvRot 文本编码器、1344×768、294 帧、种子 145
结果:
5070 Ti 16G(3047 帖) 本机 4080 SUPER 16G 采样耗时 269.7 秒(45.0 秒/步) 389.5 秒(64.9 秒/步) 端到端 390.8 秒 430.4 秒 显存峰值 14,715 MiB 15,681 MiB 日志:
100%|██████████| 6/6 [06:29<00:00, 64.92s/it],Prompt executed in 429.29 seconds。工作流 JSON:https://upload.lcz.me/uploads/9831858c-f15e-4112-9259-b58a18987e0a.json
差在哪
端到端只慢 10%,但这不是平台只差一成:他的 Total Time 含约 121 秒服务启动开销,本机只含 41 秒,把采样段的差距挡掉一半。真实差距在单步,我们慢 44%。
拆开看:
- 注意力后端:本机同分辨率、8 步、5 秒档的基线是 Sage 143.1 秒、Comfy Kitchen 166.8 秒,Kitchen 慢 16.6%,折算到 6 步约 55 秒/步。这部分占单步差距的六分之一左右。
- 平台换入:20.97 GB 的 DiT 在 16 GB 卡上必须分块换入,本机 PCIe 3.0 x16 实测 H2D 10.1 GB/s,对方是 PCIe 4.0/5.0 平台,带宽是我们的两到三倍;CPU 侧还是 Xeon E5-2696 v3 + DDR3。
- 架构差异(Ada 对 Blackwell 的 int8 吞吐)没有同机对照,不给具体比例。
对照一下 20 步档就更清楚:本机 20 分 51 秒,4090 D 48G 同样 20 步是 9 分 15 秒,单步差 2.4 倍——那一档的差主要也是显存装不装得下,而不是算力。
所以本机这条 20 分 51 秒,是「20 步稠密 + 16 GB 显存」的真实代价;把步数压到 6 步,同样一张卡 7 分 10 秒就能出片。
- 采样:6 步、


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!