[H3剑心比赛] RX 7900 XTX 24GB 单卡
-
RX 7900 XTX 24GB 单卡 · Windows 原生 ROCm · 1344×768 / 12 秒直出|MiniMax H3 3D / 2D
视频链接
H3剑心3D风格
Youtube VideoH3剑心2D风格
Youtube Video
硬件与环境
项目 配置 GPU AMD Radeon RX 7900 XTX(24GB VRAM) CPU Ryzen 5 7500F RAM 32GB DDR5 4800MHZ 系统 Windows 11(原生,不走 WSL) PyTorch 2.9.1 + ROCm 7.13 ComfyUI 0.42 便携版
二、模型与推理工作流(ComfyUI)
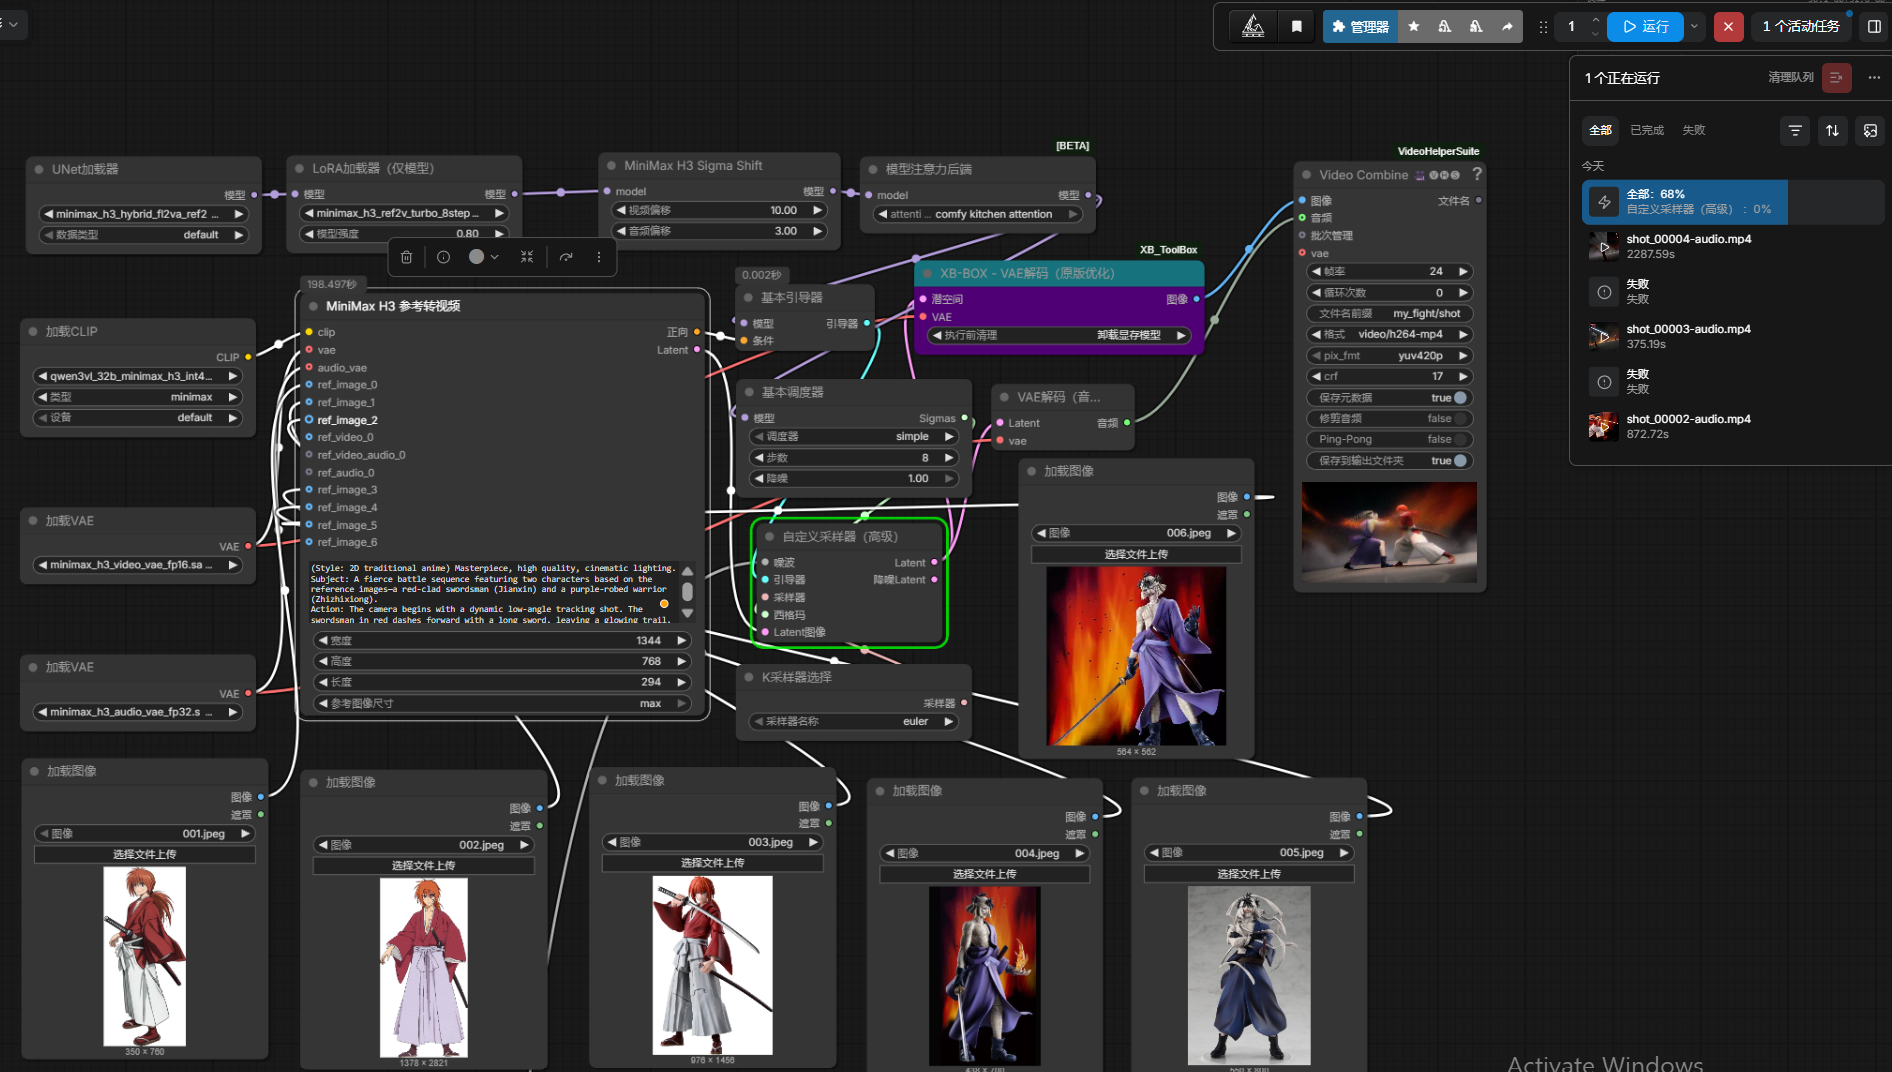
复现工作流json
剑心_参考图转视频_H3加速版.json- 主模型
- DiT:minimax_h3_hybrid_fl2va_ref2va_b25-49-int8.safetensors
- 文本编码器:qwen3vl_32b_minimax_h3_int4_convrot.safetensors
- 视频 VAE:minimax_h3_video_vae_fp16.safetensors
- 音频 VAE:minimax_h3_audio_vae_fp32.safetensors
- 加速 LoRA
- minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors,强度 0.8
- 加速手段
- 注意力:comfy kitchen attention(ModelAttentionBackend 节点指定)
- 解码后卸载显存模型(单卡 24G 防爆显存)
- 采样参数
- MiniMaxH3ReferenceToVideo:1344×768,294 帧(12.25 秒),参考图尺寸 max,6 张参考图(题目提供)
- MiniMaxH3SigmaShift:视频 10 / 音频 3
- BasicGuider(不开 CFG)+ euler / simple,8 步
- 种子:469413803756287
- 输出:24fps,h264,crf 17,带声音
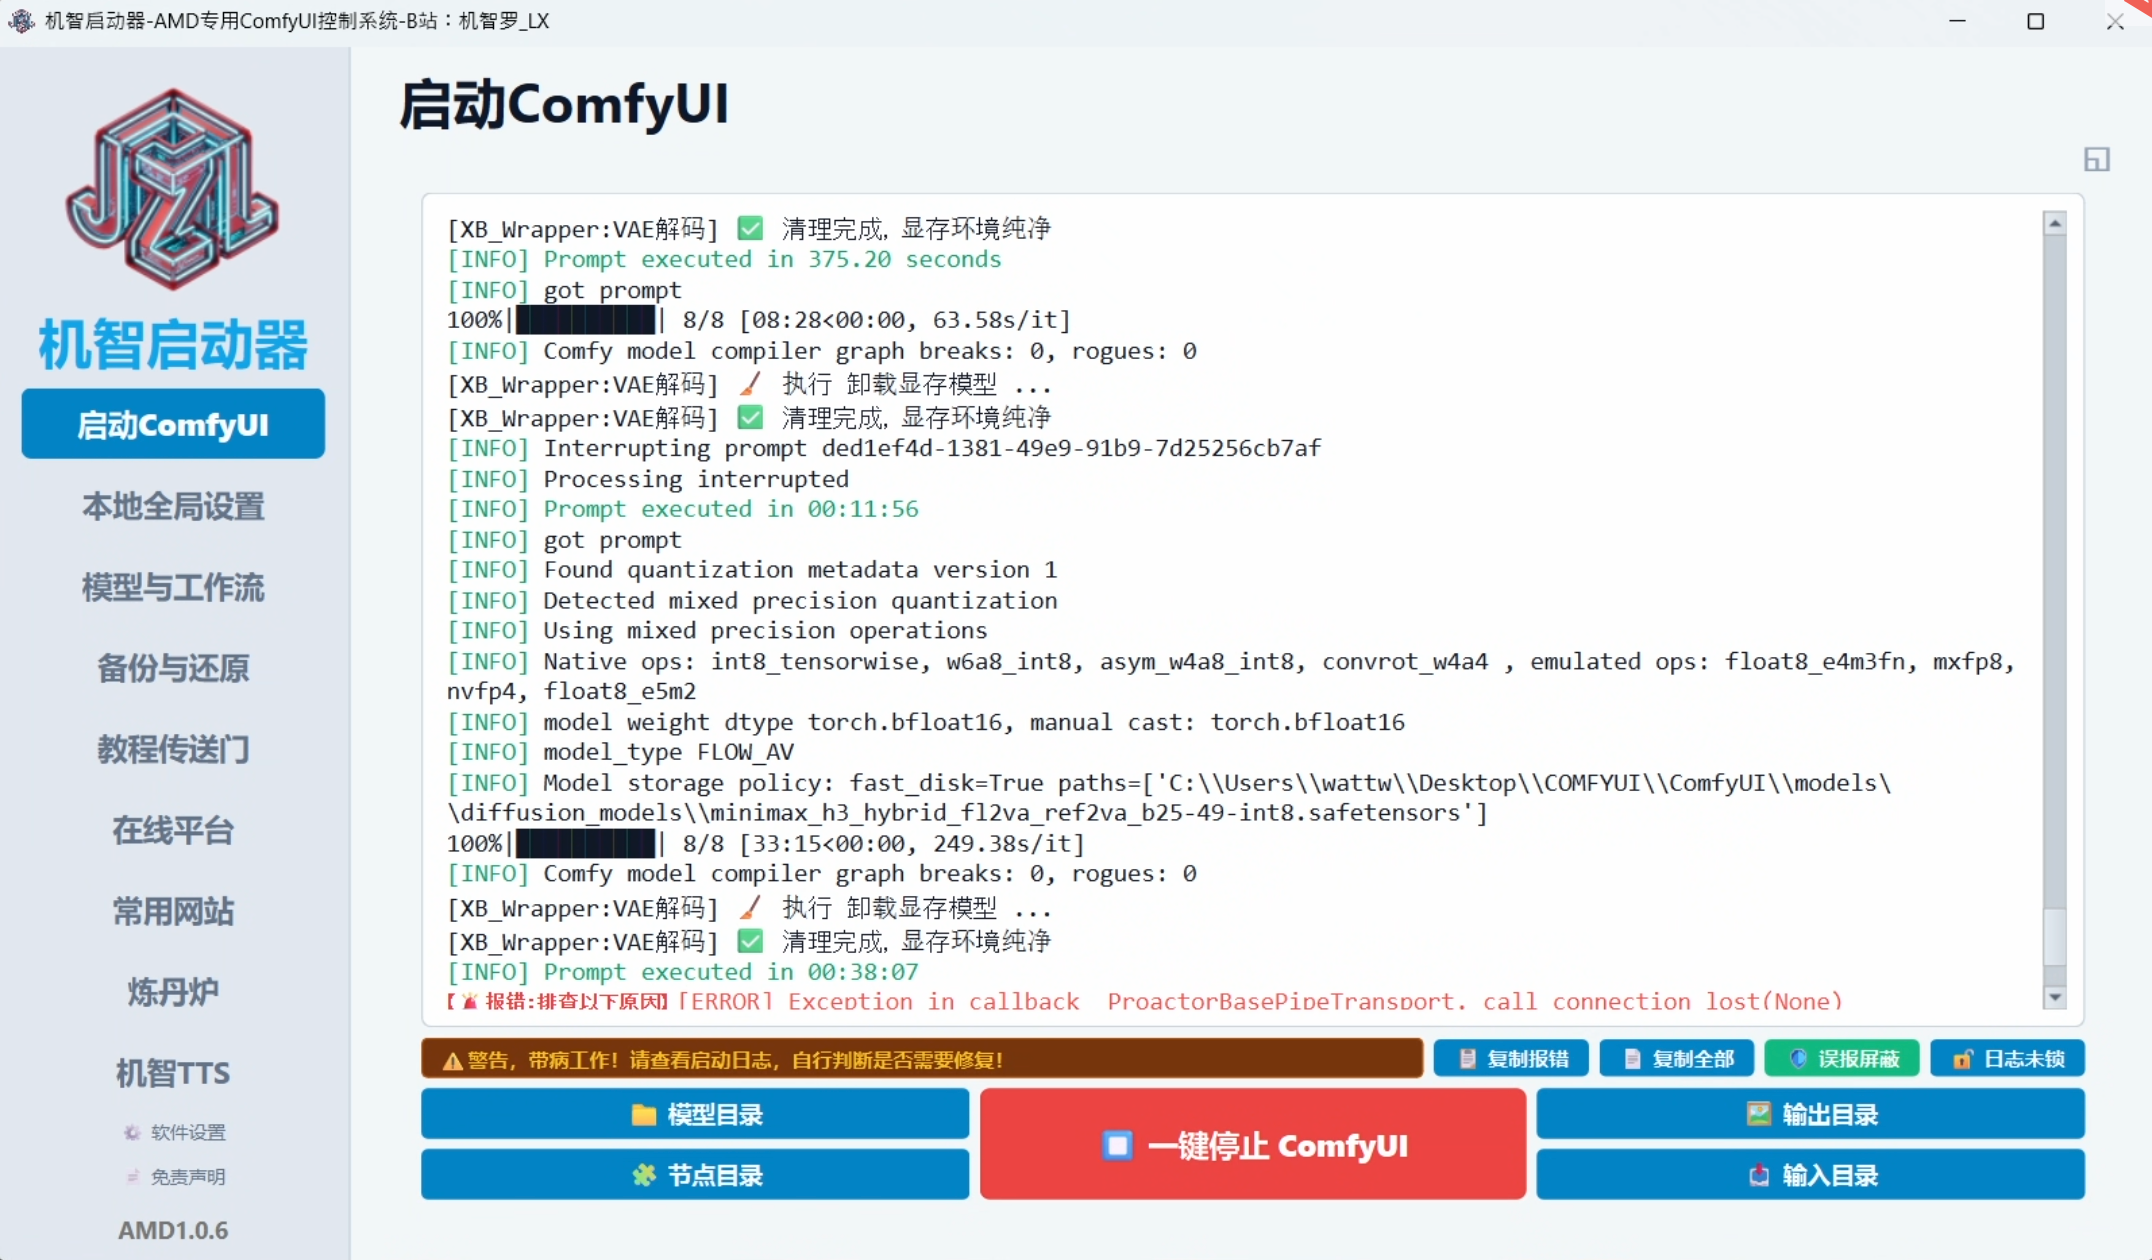
三、运行时间(3D 版,完整日志见截图)
3D 版
阶段 起止 耗时 加载模型 + 文本编码 16:41:24 → 16:44:41 3 分 17 秒 采样 8 步 16:44:42 → 17:17:42 33 分 15 秒(约 249 秒/步) VAE 解码 + 封装 17:17:42 → 17:19:32 1 分 50 秒 Total 16:41:24 → 17:19:32 38 分 07 秒 2D 版
阶段 起止 耗时 加载模型 + 文本编码 20:44:11 → 20:46:25 2 分 14 秒 采样 8 步 20:46:25 → 21:16:57 30 分 32 秒(约 229 秒/步) VAE 解码 + 封装 21:16:57 → 21:18:34 1 分 37 秒 Total 20:44:11 → 21:18:34 34 分 22 秒 峰值没有爆显存,单卡一次直出 1344×768 / 12 秒。
四、心得
- 1344×768 × 294 帧在 24G 单卡上能直出,但每步约 4 分钟;同分辨率 124 帧每步只要 1–2 分钟,帧数多 2.4 倍,耗时多 3 倍左右。
- 快速打斗、满屏火焰的画面,8 步加速 LoRA 容易出拉丝条纹。这次把 LoRA 强度调到 0.8、shift 调到 10,还没做严格的对比测试。
重在参与,向各位大神学习。
-
,
 J Junjie Heng 引用了 此主题
-
-
2D版 声音有杂音。
-
-
是因为上传后画面发虚吗?油管画面不清晰,有模糊感。
本地是什么效果?@williamlouis @terry
本地视频也发虚严重, 我从16:41:24 一直生成到20:44:11 一直在重复生成想办法解决发虚可是还是发虚,后来有事出门就暂停了.(上个帖子钢炼反而没发虚和线条的问题),目前试了换(主模型)HyperFlow H3 Flash解决了发虚问题, 但是我这是换了主模型,还是没解决原本的主模型生成的发虚, 我现在接着用回原本的主模型继续测试看看具体哪个节点还是设置有问题,做个补发,顺带总结一下发虚和线条问题.
-
这次活动有显卡和你相同的。你可以找其他同配置了解下。或直接参考工作流。
杂音 H3 更新过。你版本还是老版本吧?