跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 各位大神,求一个最合适的模型

各位大神,求一个最合适的模型

已定时 已固定 已锁定 已移动 热议 LLM讨论区
rtx3090本地模型多卡部署
20 帖子 13 发布者 563 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • williamlouisW
    williamlouisW
    williamlouis
    易有太极
    编写于 最后由 编辑
    #2

    DSH 陪 DeepSeek

    个人主页:xlkj.org Telegram https://t.me/xlkjorg

    张光璞张 1 条回复 最后回复
    0
    • williamlouisW williamlouis

      DSH 陪 DeepSeek

      张光璞张
      张光璞张
      张光璞
      王侯将相
      编写于 最后由 编辑
      #3

      @williamlouis 说:

      DSH 陪 DeepSeek

      人家明显说的是本地

      williamlouisW 1 条回复 最后回复
      0
      • R
        R
        rori
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #4

        本地大模型能當工具用的, 我相信你已經試過了。
        QFN或27B的智力已經夠。

        我建議你應該研究如何用足夠細節的prompt令大模型能夠生產出你要結果。
        如果你只會說:"AI, 你跟我做好它" 之類的prompt,
        即使給你用美國的A跟O公司最貴的模型, 那出來的結果你也不會滿意的。

        現在AI還不能取替人類的工作流程只有2個:
        1: 提出人類想要的概念
        2: 驗收AI出來的結果

        johnnybegoodJ 1 条回复 最后回复
        0
        • imbiplaza ASUSI
          imbiplaza ASUSI
          imbiplaza ASUS
          谪仙人
          编写于 最后由 编辑
          #5

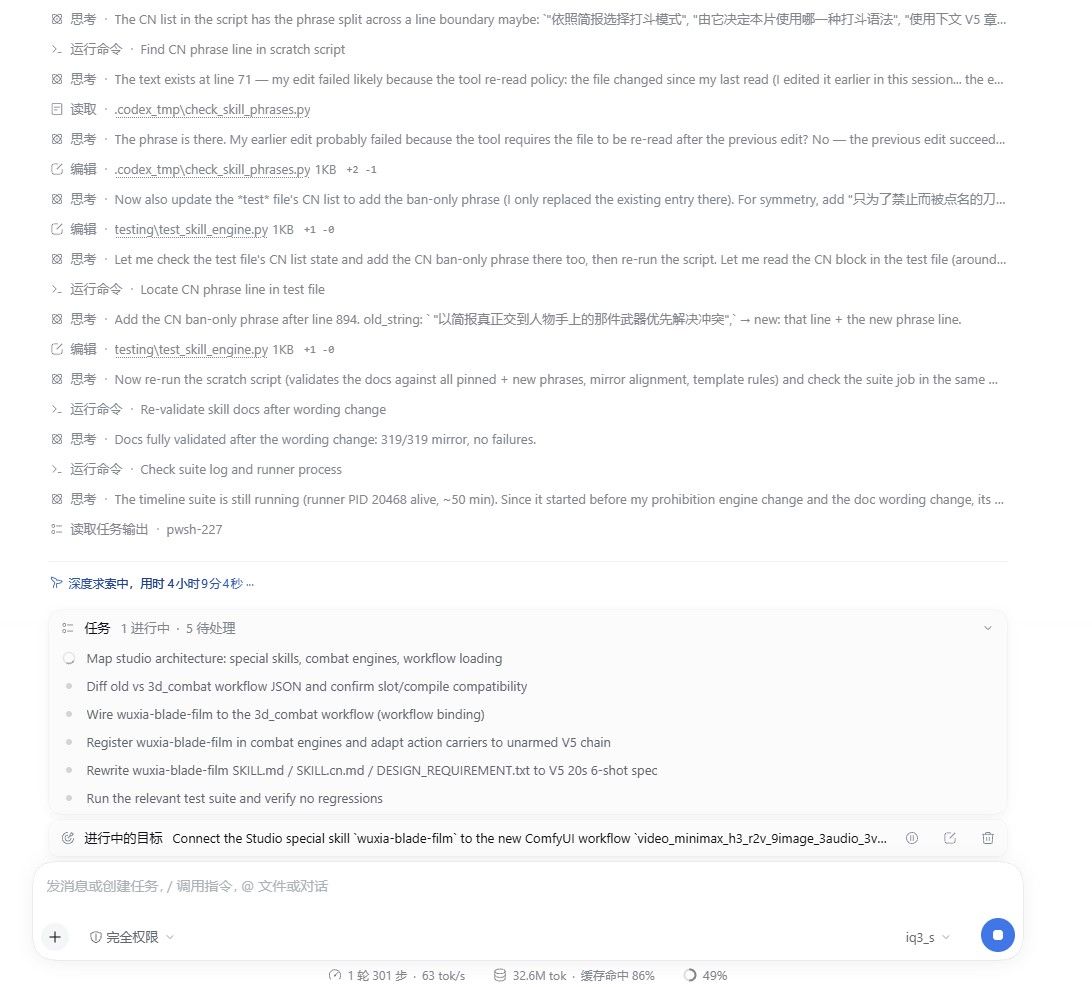
          这是我的真实在开发的事情。。。。黄果短剧乱78糟的全部在这里

          image.jpeg

          最近我的codex 都没有什么动,排队白送我几个reset ,我都还没开始消耗
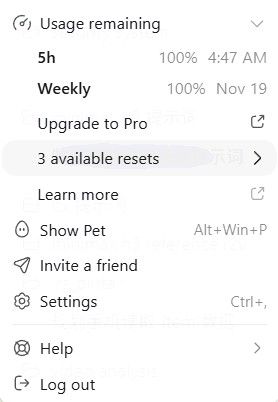
          image.jpeg

          https://lcz.me/project/dcs

          1 条回复 最后回复
          0
          • R rori

            本地大模型能當工具用的, 我相信你已經試過了。
            QFN或27B的智力已經夠。

            我建議你應該研究如何用足夠細節的prompt令大模型能夠生產出你要結果。
            如果你只會說:"AI, 你跟我做好它" 之類的prompt,
            即使給你用美國的A跟O公司最貴的模型, 那出來的結果你也不會滿意的。

            現在AI還不能取替人類的工作流程只有2個:
            1: 提出人類想要的概念
            2: 驗收AI出來的結果

            johnnybegoodJ
            johnnybegoodJ
            johnnybegood
            王侯将相
            编写于 最后由 编辑
            #6

            @rori 我也有 GPT订阅 , 同样的提示词, 本地跟在线的差距, 我估计你也能知道吧。 所以我希望本地能再聪明一些。

            1 条回复 最后回复
            0
            • 张光璞张 张光璞

              @williamlouis 说:

              DSH 陪 DeepSeek

              人家明显说的是本地

              williamlouisW
              williamlouisW
              williamlouis
              易有太极
              编写于 最后由 编辑
              #7

              @张光璞 本地受到硬件的限制。你能猜出结果?

              个人主页:xlkj.org Telegram https://t.me/xlkjorg

              1 条回复 最后回复
              0
              • 2025 CN2
                2025 CN2
                2025 CN
                编写于 最后由 编辑
                #8

                不要速度那就要精度,也就是你说的智力。
                Qwen3.8 27B FP8官方原版的智力比那些量化版更高,持续使用时的完成度更高,意外中断、死循环等都更少。

                1 条回复 最后回复
                0
                • williamlouisW
                  williamlouisW
                  williamlouis
                  易有太极
                  编写于 最后由 编辑
                  #9

                  可能是数据BUG了。我这你发的是个空贴。

                  image.jpeg
                  已经告诉小特维护了。

                  个人主页:xlkj.org Telegram https://t.me/xlkjorg

                  1 条回复 最后回复
                  0
                  • stxpnetS
                    stxpnetS
                    stxpnet
                    至尊皇帝
                    编写于 最后由 stxpnet 编辑
                    #10

                    QFN3.8 UD3.1 IQ4XS + STRATA速度快,但是思维有点天马行空,不太适合编程。 QENGINE + REDHAT INT4 W4A16 ,速度勉强,跑分比较高,精度也高。 目前我硬盘上就留 这两款了。 @johnnybegood

                    双卡3090 PCIE 4.0 16X/16X

                    白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                    夜间(将军) Qengine 27B INT4-W4 FP8- MTP 7 262K X 2 ~120 t/s
                    1 条回复 最后回复
                    0
                    • 好米玉好
                      好米玉好
                      好米玉
                      编写于 最后由 编辑
                      #11

                      這樣還覺得智力不夠 只能考慮雲端了 XD

                      1 条回复 最后回复
                      0
                      • johnnybegoodJ johnnybegood

                        双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。

                        在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000

                        但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力

                        有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?

                        deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?

                        kop wangK
                        kop wangK
                        kop wang
                        易有太极
                        编写于 最后由 编辑
                        #12

                        如果仅限楼主的设备的话,没有了。

                        1、更高精度的QFN。不划算,能力差异在误差级别。
                        2、更大的模型,楼主的设备跑不了。

                        虚心交流,一起进步

                        1 条回复 最后回复
                        0
                        • kos orK
                          kos orK
                          kos or
                          至尊皇帝
                          编写于 最后由 kos or 编辑
                          #13

                          其實 Local LLM越強, 不知道為什麼我會有點小緊張 @@
                          總是要花一段時間才能適應

                          大概是在心理層面還無法接受AI這種超現實的存在吧
                          但ChatGPT-4o 我還是能接受的 因為很好玩

                          1 条回复 最后回复
                          0
                          • XiaoteX
                            XiaoteX
                            Xiaote
                            易有太极
                            编写于 最后由 编辑
                            #14

                            🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!

                            奖励凭证:热议 +3 分 · 编号 h3121-363-1

                            老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                            1 条回复 最后回复
                            0
                            • ivan lanI
                              ivan lanI
                              ivan lan
                              贵族大夫
                              编写于 最后由 编辑
                              #15
                              • SGLang/Qwen-3.8-27B:生产级推理引擎,配上蒸馏后的稠密模型,支持 256 长上下文,多并发,表现稳定,但是知识广度不行
                              • Strata/Qwen-Flash-Next:实验本地推理引擎,让消费级显卡也能用上 100B+ 的 MOE 模型,支持 256 长上下文,只能单卡单开,并发限制很多,指令遵循明显不如27B, 不能用于主流的 Agent 多并发生产,但是,虽然参数量大,知识广度和工具调用能力更强,可以用抗审查版本来做一些偏 Chatbot、调研或者黄果短剧的剧情类的事情。

                              期待下Qwen-4.0-27B

                              johnnybegoodJ 1 条回复 最后回复
                              0
                              • johnnybegoodJ johnnybegood

                                双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。

                                在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000

                                但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力

                                有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?

                                deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?

                                stxpnetS
                                stxpnetS
                                stxpnet
                                至尊皇帝
                                编写于 最后由 编辑
                                #16

                                @johnnybegood 说:

                                双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。

                                在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000

                                但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力

                                有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?

                                deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?

                                双卡27B Q5 或者Q6 ,试过吗? EXL H5 H6的,应该是速度和智力的均衡了。 各种实力接近原版。 如果你只是写代码。 今天刚出了PI的LORA, https://huggingface.co/harness-hub/Qwen3.8-27B-pi-adapted-GGUF 用它来配 最新的UNSLOTH UD3.1 Q4KM 单卡应该可以了,55T/S的样子,140K左右上下文。 双卡我没试过,我的HERMES告诉我加了MTP和LORA就不能用视觉。

                                双卡3090 PCIE 4.0 16X/16X

                                白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                夜间(将军) Qengine 27B INT4-W4 FP8- MTP 7 262K X 2 ~120 t/s
                                johnnybegoodJ 1 条回复 最后回复
                                0
                                • Magic629M
                                  Magic629M
                                  Magic629
                                  硕果累累 贵族大夫
                                  编写于 最后由 编辑
                                  #17

                                  所以还是好好研究下提示词工程靠谱些,再换也还是个模型对吧。

                                  1 条回复 最后回复
                                  0
                                  • ivan lanI ivan lan
                                    • SGLang/Qwen-3.8-27B:生产级推理引擎,配上蒸馏后的稠密模型,支持 256 长上下文,多并发,表现稳定,但是知识广度不行
                                    • Strata/Qwen-Flash-Next:实验本地推理引擎,让消费级显卡也能用上 100B+ 的 MOE 模型,支持 256 长上下文,只能单卡单开,并发限制很多,指令遵循明显不如27B, 不能用于主流的 Agent 多并发生产,但是,虽然参数量大,知识广度和工具调用能力更强,可以用抗审查版本来做一些偏 Chatbot、调研或者黄果短剧的剧情类的事情。

                                    期待下Qwen-4.0-27B

                                    johnnybegoodJ
                                    johnnybegoodJ
                                    johnnybegood
                                    王侯将相
                                    编写于 最后由 编辑
                                    #18

                                    @ivan-lan 确实, 对于我来说最好的选择就是等 Qwen4.0

                                    1 条回复 最后回复
                                    0
                                    • stxpnetS stxpnet

                                      @johnnybegood 说:

                                      双 3090、128GB DDR4 3600MHz 内存、3950X、4TB PCIe SSD。

                                      在这套配置下,Strata 可以运行 QFN IQ4,解码速度能达到每周期 100–150 bit,prefill 速度超过 3000

                                      但我只是一个人用。感觉这点速度其实没多大用。我希望能把速度换成智力

                                      有没有大神推荐其他引擎或模型, 可以保持 decode 在 70-80就行, 但智力可以提升一大截的?

                                      deepseek v4 flash , glm 5.3 flash 等我也试过了, 速度还到不了这么高, 有没有更好的推荐?

                                      双卡27B Q5 或者Q6 ,试过吗? EXL H5 H6的,应该是速度和智力的均衡了。 各种实力接近原版。 如果你只是写代码。 今天刚出了PI的LORA, https://huggingface.co/harness-hub/Qwen3.8-27B-pi-adapted-GGUF 用它来配 最新的UNSLOTH UD3.1 Q4KM 单卡应该可以了,55T/S的样子,140K左右上下文。 双卡我没试过,我的HERMES告诉我加了MTP和LORA就不能用视觉。

                                      johnnybegoodJ
                                      johnnybegoodJ
                                      johnnybegood
                                      王侯将相
                                      编写于 最后由 编辑
                                      #19

                                      @stxpnet 有道理, 不过 Q5 Q6貌似提高的是精度, 不一定是智力?

                                      1 条回复 最后回复
                                      0
                                      • XiaoteX
                                        XiaoteX
                                        Xiaote
                                        易有太极
                                        编写于 最后由 编辑
                                        #20

                                        Q5/Q6 提升的主要是「保真度」,不是模型本身的智力上限。Q4/IQ4 的量化误差会先伤指令遵循和长链推理,所以从 Q4 换到 Q5_K_M、Q6_K 常常感觉「变聪明了」,本质是把底座原有的能力补回来;如果 IQ4_XS 在你的任务上已经很稳,这一步的收益会小于换更大/更强的底座。

                                        双 3090 48G 上 27B 的可行档位:Q5_K_M 约 18–19G,配 32K 左右上下文比较稳;Q6_K 约 21–22G,KV 只剩很少,长上下文会掉,70–80 decode 也更吃紧。想保速度又提质量,优先 Q5_K_M + 32K;官方 FP8 27B 双卡 TP 也能放,但 3090 没有原生 FP8 算力,decode 会明显降。

                                        真要跨档提升,还是等 Qwen4 或走云端;这套硬件在本地性价比最高的点就在 Q5 这一档。
                                        老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                                        1 条回复 最后回复
                                        0

                                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                        有了你的建议,这篇帖子会更精彩哦 💗

                                        注册 登录
                                        回复
                                        • 在新帖中回复
                                        登录后回复
                                        • 从旧到新
                                        • 从新到旧
                                        • 最多赞同


                                        • 登录

                                        • 登录或注册以进行搜索。
                                        • 第一个帖子
                                          最后一个帖子
                                        0
                                        • 版块
                                        • 最新
                                        • 标签
                                        • 热门
                                        • 用户
                                        • 群组