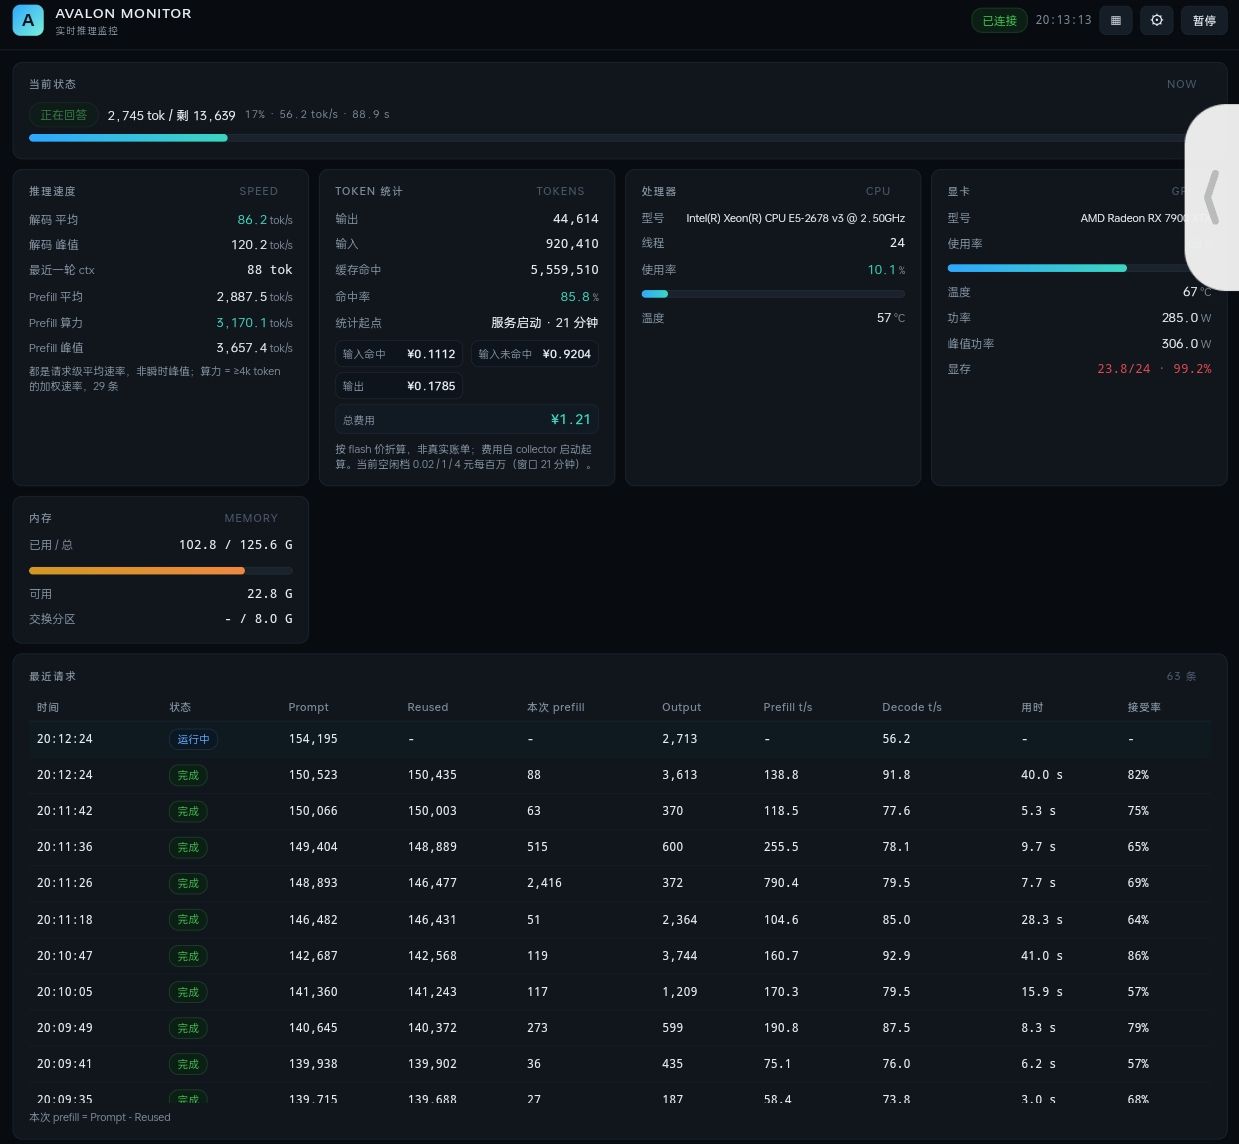
7900 XTX 一张卡跑 Qwen3.8flash :prefill 3600 t/s 不衰减,decode 破 100,峰值 120t/s
-
7900 XTX 一张卡跑 Qwen3.8flash :prefill 3600 t/s 不衰减,decode 破 100,峰值 120t/s
数据取自两轮全冷扫参。峰值 prefill 3605.5,峰值 decode 101.7,196697 token 冷启动 57.49 秒。
环境
- GPU:AMD RX 7900 XTX(gfx1100 / RDNA3),显存占用 23.8 GiB,99.2%
- CPU:Intel Xeon E5-2678 v3 @ 2.50 GHz(12C/24T,无 AVX-512)
- 内存:125.6 GiB,可用 27.3 GiB
- 系统:Ubuntu,内核 7.0.0-34-generic
- 引擎:Avalon(llama.cpp 分支),commit 762a3dae
- 模型:Qwen3.8-Flash-Next,IQ3_KS 33 分片共 94 GB
- MTP 草稿:zh65k 共享层 IQ3K + IQ4NL
- 视觉塔:CPU
- 关键参数:ctx 262144,KV q8_0,batch 32768,ubatch 32768,RAM cache 16384 MiB
方法
- 合成唯一文本,每档全冷重算,缓存命中率 0
- 两轮相隔 35 分钟,同一个 server 进程,不重启
总表:两轮全冷扫参,同一进程
上下文 一轮 prefill 二轮 prefill 一轮 decode 接受率 1.8k - 608.7 (2.97s) - - 8k 2082.7 2618.8 100.0 97% 16k 3063.3 - 98.8 96% 32k 3605.5 3437.6 (9.54s) 101.7 93% 64k 3600.5 3529.9 (18.58s) 99.7 90% 96k 3461.9 3536.2 (27.81s) 88.1 88% 128k 3514.3 3479.9 (37.68s) 85.0 80% 161k 3477.3 - 86.6 85% 196k - 3421.5 (57.49s) - - 单位都是 t/s。一轮 18:30 输出 256;二轮 19:05 输出 51。
- 二轮输出只有 51 token,短输出开销主导,解码不可比,所以解码与接受率只有一轮
- 真实 prompt token 一轮:7,732 / 15,621 / 31,376 / 63,907 / 96,432 / 128,992 / 161,520
- 真实 prompt token 二轮:1,805 / 7,765 / 32,797 / 65,577 / 98,357 / 131,137 / 196,697
- 同规模两轮差在 5% 内。196k 冷算 57.5 秒跑完,无卡死,无分配失败
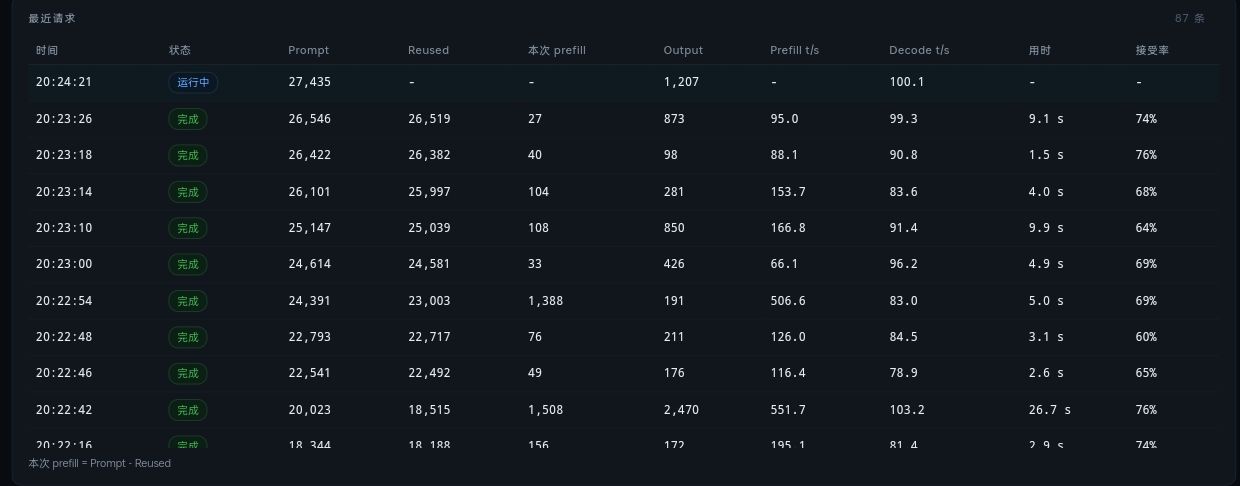
- 真实流量长输出的解码:20k 以下 96 到 100,100k 到 132k 约 92.5,160k 以上约 84.4
前缀复用
- warm 轮只评估 4 个新 token
- 整轮墙钟 2.3 到 2.8 s,与上下文长度无关
- 161k 上下文和 8k 上下文一样快
结论
- 32k 以上 prefill 基本持平,3420 到 3606,不随上下文衰减
- 约 2.9 s 的固定冷算开销,1.8k 档只有 609 t/s 就是被它拉低
- 瓶颈全在 prefill,解码在 100k 以上只是接受率下降
别误读
- 合成文本是上界。真实文本同进程口径:35k 是 2826.6,114k 是 2197.9
- 重启后第一条大 prompt 明显更慢,专家缓存未热
- 每档一个样本,不重复。251k 故意没测
-