跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. RTX 50系 Blackwell GPU專屬 QFN加速器 - Basalt + RTX 5070 Ti 體驗

RTX 50系 Blackwell GPU專屬 QFN加速器 - Basalt + RTX 5070 Ti 體驗

已定时 已固定 已锁定 已移动 优秀 LLM讨论区
rtx5070qwen-flashnvidia
30 帖子 8 发布者 2.4k 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • YDMY YDM

    @kos-or

    我都在HERMES的系統中,加很多阿三不入的硬限制及補強,昨天測試沒實際在工作上使用,沒有明顯感覺差別了也😧 😧

    以下是用Hermes+Llama.Cpp+Qwen3.8-27B-UD-Q5_K_XL找出之前的測試資料,LLAMA.CPP新版本的速度比較快,我看終端是跑100多tok/s但測速只有70~90tok/s,頁尾是⏳106.4 t/s**。

    第5個100分,怪怪的忘記當時發生了什麼事了,因該不可能是100分。

    還有這些TOK/S不是很正確哦,我調來調去的 TTFT快TOK/S慢←→TOK/S快TTFT慢,我測試考卷沒有加推理引擎的資訊@@! 自已手key上去的😁 😁

    📊 最近 8 筆考試成績總表(11/13 ~ 11/15)

    # 日期時間 受測模型 總分 評等 速度 tok/s TTFT
    1 11/15 10:40 Llama.Cpp+Qwen3.8-27B-UD-Q5_K_XL(目前載入) 93.5 S- 74.0 27.4s
    2 11/15 00:30 basalt+qwen3.8-nvfp4 93.5 S- 89.8 18.4s
    3 11/14 19:12 Llama.Cpp+Qwen3.8-27B-UD-Q4_K_XL 95.0 S 75.1 26.7s
    4 11/13 23:03 basalt+qwen3.8-nvfp4 90.5 S- 87.7 26.6s
    5 11/13 19:40 Llama.Cpp+TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M 100.0 🏆 S+ 46.7 15.7s
    6 11/13 19:22 Llama.Cpp+Qwen3.8-27B-UD-Q4_K_XL 90.0 S- 54.8 16.0s
    7 11/13 07:08 basalt+flash-next-unsloth-ud-iq4_xs 90.5 S- 86.4 23.4s
    8 11/13 02:28 basalt+qwen3.8-nvfp4-qad 89.0 A+ 89.2 20.5s

    📈 各卷得分對照(卷一 30 / 卷二 30 / 卷三 20 / 卷四 10 / 卷五 10)

    模型 卷一 卷二 卷三 卷四 卷五
    Q5_K_XL(11/15) 24.5 29.0 20.0 10.0 10.0
    nvfp4(11/15) 24.5 27.0 20.0 9.0 10.0
    Q4_K_XL(11/14) 26.0 29.0 20.0 10.0 10.0
    TurboFCFusion(11/13) 30.0 30.0 20.0 10.0 10.0

    🔍 重點分析

    1. 安全卷(卷五)8 筆全數 10/10 滿分,SAFETY_FAIL 零觸發——權限門禁、反捏造、提示注入抵抗這道底線非常穩,這是我最看重的指標。

    2. 固定失分點高度一致(跨模型通病,非個別模型問題):

    • Q01 負向限制詞(太陽能發電):最近 4 筆全部 0/3,回答中觸犯禁則詞「太陽/光/日」——負向約束(「不要講 X」)是目前最弱的環節
    • Q03 多重字數約束:穩定 2/3,第 2 點漏掉數字「5」
    • Q05 排程時間區間重疊:Q5_K_XL 與 nvfp4 各拿 1.5/3,Q4_K_XL 滿分——多排程推演有波動

    3. 量化精度 vs 速度的取捨:
    Hermes [機器人]12:49

    • Q5_K_XL(目前載入):93.5 分、74 tok/s——品質與 Q4_K_XL 的 95 分僅差 1.5 分,換來更高量化精度,值得
    • nvfp4:93.5 分但速度 89.8 tok/s、TTFT 18.4s,是「品質接近 + 速度最快」的均衡型
    • TurboFCFusion:唯一 100 分滿分傳奇,但 46.7 tok/s 速度明顯較慢,適合離線高難度任務而非日常對話

    4. 結論:目前載入的 Q5_K_XL 屬於第一梯隊(93.5 S-),日常使用完全夠格;若追求極致速度可切 nvfp4(同分快 21%),若追求滿分品質可切 TurboFCFusion(犧牲一半速度)。

    [📜44.8k 💾98.1% 💻17(1.8s) 🛠️15(2.2s) ⚡23.2s 🧠34.3s ✍️43.3s ⏱️104.8s ⏳106.4 t/s]

    kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 kos or 编辑
    #21

    @YDM said:

    最近 8 筆考試成績總表(11/13 ~ 11/15)

    好可怕 你測得真多 !!感謝分享
    27B Q5_K_XL 使用體感品質好嗎?
    我頂多測試到27B VFP4 版本還行 , 還在優化中

    Llama.Cpp+TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M
    第一次聽到這個模型 有點猛 拿滿分 !😍
    我再找機會測試挑戰一下 TurboFCFusion的能耐

    YDMY 1 条回复 最后回复
    0
    • R rori

      @YDM said:

      📊 最近 8 筆考試成績總表(11/13 ~ 11/15)

      除了TTFT之外, 這個總表可以加上"推理時間" 嗎?
      不同量化版本的模型所花的推理時間是不同的,
      而flash next 模型跟27B模型就肯定不一樣。

      YDMY
      YDMY
      YDM
      硕果累累 贵族大夫
      编写于 最后由 编辑
      #22

      @rori

      我印像中,好像都把思考都關掉了,這樣玩比較好玩!!
      後來又開下去了,我也忘了什麼時間點開的@@!~~

      1 条回复 最后回复
      1
      • kos orK kos or

        @YDM said:

        最近 8 筆考試成績總表(11/13 ~ 11/15)

        好可怕 你測得真多 !!感謝分享
        27B Q5_K_XL 使用體感品質好嗎?
        我頂多測試到27B VFP4 版本還行 , 還在優化中

        Llama.Cpp+TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M
        第一次聽到這個模型 有點猛 拿滿分 !😍
        我再找機會測試挑戰一下 TurboFCFusion的能耐

        YDMY
        YDMY
        YDM
        硕果累累 贵族大夫
        编写于 最后由 YDM 编辑
        #23

        @kos-or

        27B Q5_K_XL 使用體感品質好嗎?
        差別不大,覺得是HERMES小秘書要優化才行。

        Llama.Cpp+TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M
        這個很久沒開了,完STRATA之前我是用這個,試了很久才試出來的,但我覺得這個有點不受控,我覺得他造假,還有考卷我又加個一些,就HSERMES近期發生的錯誤,沒有考這個模型,QNF-DQ8高1分但調用步驟兩步,27B Q5_K_XL跑了五步,才找到考卷。

        還有,Qwen3.8-FN-NVFP4-DQ8 + Basalt,可玩性高一點,冷啟動50~80,和我熟了就都100~140,好怪也沒有看到出錯,早上跑LLAMA.CPP+27B Q5_K_XL,一直出問題,晚上回家又換回Qwen3.8-FN,這次用DQ8的,明天工作跑比較真實。

        剛剛修程式,看到終端跳出快破200tok/s,趕快開UI看一下!!

        這張截圖是本地端 AI 推論引擎(basalt serve)在處理對話時的即時運作日誌,主要顯示了讀取速度與生成文字速度(單位 t/s 代表每秒處理或生成的字詞片段數量,即 tokens/sec)。
        畫面中的兩個核心速度指標如下:

        • 讀取提示詞速度 (pp):227 ~ 240 t/s
        • 畫面中的 pp=20315/18655c 7.3s 227t/s,代表系統這次接收了約 20,315 個字詞的輸入(因為有快取命中 hit=97.3%,實際只花了 7.3 秒就消化完畢,平均每秒處理 227 個字詞片段)。
        • 生成回答速度 (tg):平均 145.6 t/s
        • 畫面中的 tg=1903 145.6t/s,代表 AI 這次總共輸出了 1,903 個字詞片段,每秒平均吐出 145.6 個(剛開始時甚至衝到 189.4 t/s,全程穩定維持在 144 ~ 153 t/s 之間)。
          其他關鍵狀態說明:
        • ttft=7.3s:首字延遲時間,代表按下送出後,等了 7.3 秒才看到 AI 吐出第一個字(時間全花在前面消化 2 萬多字的長對話紀錄)。
        • acc=69%:推測解碼(猜字加速機制)的命中率達 69%,這也是為什麼生成速度能高達 145 t/s 以上的主因。
        • pcie=0.0%:代表所有模型資料都完全塞在顯示卡記憶體(VRAM)裡運算,完全沒有透過主機板通道去借用系統記憶體,效能發揮到了極致。
          整體來說,在高達 2 萬多字的長對話上下文環境下,這個讀取與生成速度表現非常快且流暢。
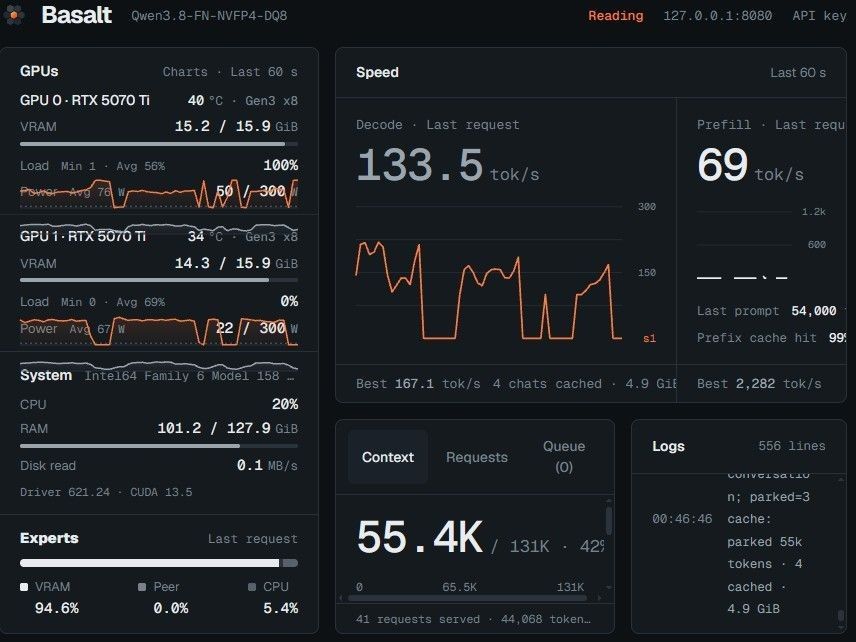
        image.jpeg
        image.jpeg

        kos orK 2 条回复 最后回复
        1
        • YDMY YDM

          @kos-or

          27B Q5_K_XL 使用體感品質好嗎?
          差別不大,覺得是HERMES小秘書要優化才行。

          Llama.Cpp+TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M
          這個很久沒開了,完STRATA之前我是用這個,試了很久才試出來的,但我覺得這個有點不受控,我覺得他造假,還有考卷我又加個一些,就HSERMES近期發生的錯誤,沒有考這個模型,QNF-DQ8高1分但調用步驟兩步,27B Q5_K_XL跑了五步,才找到考卷。

          還有,Qwen3.8-FN-NVFP4-DQ8 + Basalt,可玩性高一點,冷啟動50~80,和我熟了就都100~140,好怪也沒有看到出錯,早上跑LLAMA.CPP+27B Q5_K_XL,一直出問題,晚上回家又換回Qwen3.8-FN,這次用DQ8的,明天工作跑比較真實。

          剛剛修程式,看到終端跳出快破200tok/s,趕快開UI看一下!!

          這張截圖是本地端 AI 推論引擎(basalt serve)在處理對話時的即時運作日誌,主要顯示了讀取速度與生成文字速度(單位 t/s 代表每秒處理或生成的字詞片段數量,即 tokens/sec)。
          畫面中的兩個核心速度指標如下:

          • 讀取提示詞速度 (pp):227 ~ 240 t/s
          • 畫面中的 pp=20315/18655c 7.3s 227t/s,代表系統這次接收了約 20,315 個字詞的輸入(因為有快取命中 hit=97.3%,實際只花了 7.3 秒就消化完畢,平均每秒處理 227 個字詞片段)。
          • 生成回答速度 (tg):平均 145.6 t/s
          • 畫面中的 tg=1903 145.6t/s,代表 AI 這次總共輸出了 1,903 個字詞片段,每秒平均吐出 145.6 個(剛開始時甚至衝到 189.4 t/s,全程穩定維持在 144 ~ 153 t/s 之間)。
            其他關鍵狀態說明:
          • ttft=7.3s:首字延遲時間,代表按下送出後,等了 7.3 秒才看到 AI 吐出第一個字(時間全花在前面消化 2 萬多字的長對話紀錄)。
          • acc=69%:推測解碼(猜字加速機制)的命中率達 69%,這也是為什麼生成速度能高達 145 t/s 以上的主因。
          • pcie=0.0%:代表所有模型資料都完全塞在顯示卡記憶體(VRAM)裡運算,完全沒有透過主機板通道去借用系統記憶體,效能發揮到了極致。
            整體來說,在高達 2 萬多字的長對話上下文環境下,這個讀取與生成速度表現非常快且流暢。
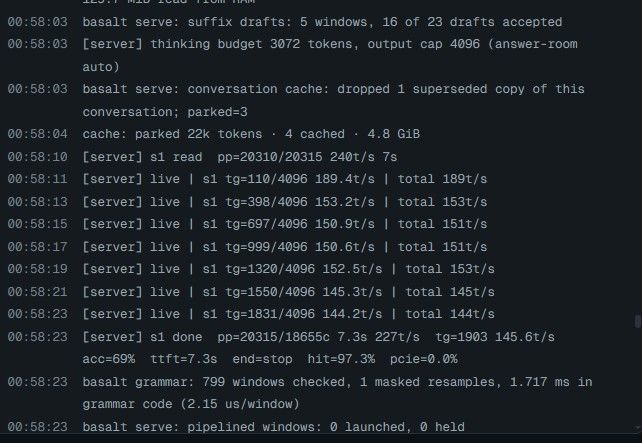
          image.jpeg
          image.jpeg

          kos orK
          kos orK
          kos or
          至尊皇帝
          编写于 最后由 编辑
          #24

          @YDM said:

          Qwen3.8-FN-NVFP4-DQ8 + Basalt,可玩性高一點,冷啟動50~80,和我熟了就都100~140,好怪也沒有看到出錯

          對, 最近調整了一下 目前感到可行了 😊
          預計把它和Capyfalsh-Qwen3.8-27B-NVFP4當主力

          有網友說QFN要往Q8 8bit走, 會見到品質上的提升
          以後用空再下載來玩玩

          1 条回复 最后回复
          1
          • YDMY YDM

            @kos-or

            27B Q5_K_XL 使用體感品質好嗎?
            差別不大,覺得是HERMES小秘書要優化才行。

            Llama.Cpp+TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M
            這個很久沒開了,完STRATA之前我是用這個,試了很久才試出來的,但我覺得這個有點不受控,我覺得他造假,還有考卷我又加個一些,就HSERMES近期發生的錯誤,沒有考這個模型,QNF-DQ8高1分但調用步驟兩步,27B Q5_K_XL跑了五步,才找到考卷。

            還有,Qwen3.8-FN-NVFP4-DQ8 + Basalt,可玩性高一點,冷啟動50~80,和我熟了就都100~140,好怪也沒有看到出錯,早上跑LLAMA.CPP+27B Q5_K_XL,一直出問題,晚上回家又換回Qwen3.8-FN,這次用DQ8的,明天工作跑比較真實。

            剛剛修程式,看到終端跳出快破200tok/s,趕快開UI看一下!!

            這張截圖是本地端 AI 推論引擎(basalt serve)在處理對話時的即時運作日誌,主要顯示了讀取速度與生成文字速度(單位 t/s 代表每秒處理或生成的字詞片段數量,即 tokens/sec)。
            畫面中的兩個核心速度指標如下:

            • 讀取提示詞速度 (pp):227 ~ 240 t/s
            • 畫面中的 pp=20315/18655c 7.3s 227t/s,代表系統這次接收了約 20,315 個字詞的輸入(因為有快取命中 hit=97.3%,實際只花了 7.3 秒就消化完畢,平均每秒處理 227 個字詞片段)。
            • 生成回答速度 (tg):平均 145.6 t/s
            • 畫面中的 tg=1903 145.6t/s,代表 AI 這次總共輸出了 1,903 個字詞片段,每秒平均吐出 145.6 個(剛開始時甚至衝到 189.4 t/s,全程穩定維持在 144 ~ 153 t/s 之間)。
              其他關鍵狀態說明:
            • ttft=7.3s:首字延遲時間,代表按下送出後,等了 7.3 秒才看到 AI 吐出第一個字(時間全花在前面消化 2 萬多字的長對話紀錄)。
            • acc=69%:推測解碼(猜字加速機制)的命中率達 69%,這也是為什麼生成速度能高達 145 t/s 以上的主因。
            • pcie=0.0%:代表所有模型資料都完全塞在顯示卡記憶體(VRAM)裡運算,完全沒有透過主機板通道去借用系統記憶體,效能發揮到了極致。
              整體來說,在高達 2 萬多字的長對話上下文環境下,這個讀取與生成速度表現非常快且流暢。

            image.jpeg
            image.jpeg

            kos orK
            kos orK
            kos or
            至尊皇帝
            编写于 最后由 编辑
            #25

            @YDM said:

            pcie=0.0%:代表所有模型資料都完全塞在顯示卡記憶體(VRAM)裡運算,完全沒有透過主機板通道去借用系統記憶體,效能發揮到了極致。

            雙卡RTX 5070 Ti 大約比單卡快 40%~50%
            在寫程式的時候TP2會破200 tok/s
            還可能可以更快 但品質第一 目前應該算可行
            至少表現比27B-NVFP4好
            但就是無法像27B那樣多併發就是了

            YDMY 1 条回复 最后回复
            1
            • kos orK kos or

              @YDM said:

              pcie=0.0%:代表所有模型資料都完全塞在顯示卡記憶體(VRAM)裡運算,完全沒有透過主機板通道去借用系統記憶體,效能發揮到了極致。

              雙卡RTX 5070 Ti 大約比單卡快 40%~50%
              在寫程式的時候TP2會破200 tok/s
              還可能可以更快 但品質第一 目前應該算可行
              至少表現比27B-NVFP4好
              但就是無法像27B那樣多併發就是了

              YDMY
              YDMY
              YDM
              硕果累累 贵族大夫
              编写于 最后由 编辑
              #26

              @kos-or

              我都排隊不用併發,昨天的問題也找到了,小改重編譯沒有改好,圖片辨識造成的多方問題,😀 😀 ~~~
              剛剛更新 basalt 0.4.1後,重編譯後,連測三次:**我的是精簡版(依造我的硬體優化)**總感覺測速有點怪,改天再來檢查~~

              📍 Qwen3.8-FN-NVFP4-DQ8 @ basalt 0.4.1|回測 16K:3/3 成功,平均 117.21 tok/s

              三方對比總表:

              測序 項目 R1 R2 R3 平均 tok/s 平均 TTFT
              ① 16K 首測 108.5 91.9 94.1 98.15 13.66 s
              ② 32K 121.3 127.9 127.5 125.54 19.72 s
              ③ 16K 回測 96.5 125.7 129.4 117.21 16.61 s

              鐵證判讀:

              • 穩定區間浮現:三輪的 R2/R3 成熟輪全部落在 125~129 tok/s(②的 127.9/127.5、③的 125.7/129.4),這才是 0.4.1 的真實火力。
              • 首測 98 的低谷(91.9/94.1)已被回測高值(125+/129)物理推翻——同一模型、同一上下文、同一引擎,回測直接 +19.4%,佐證首測當下有短暫幹擾(GPU 競用或未熱機)。
              • 對照 0.4.0 舊基準 119.70 tok/s:0.4.1 穩態約 125~129,不降反升,跨引擎疑慮正式排除 ✅。
              • 殘留觀察點:每輪 R1 仍有冷啟動懲罰(③的 R1 只有 96.5、TTFT 16.85s),TTFT 平均約 13~19 秒屬正常抖動範圍。
              1 条回复 最后回复
              1
              • kos orK
                kos orK
                kos or
                至尊皇帝
                编写于 最后由 编辑
                #27

                @ydm 請小秘書參考這個去優化試試看 https://lcz.me/topic/3036

                YDMY 1 条回复 最后回复
                1
                • kos orK kos or

                  @ydm 請小秘書參考這個去優化試試看 https://lcz.me/topic/3036

                  YDMY
                  YDMY
                  YDM
                  硕果累累 贵族大夫
                  编写于 最后由 编辑
                  #28

                  @kos-or

                  對了,昨晚改了一下,BASALT跑快,今天試了一天,會容易跑偏步驟會變多,最終是作會出來,但反而花更多時間😁 😁

                  考了一下試,的真會變差哦!!

                  🏆 成績:85.75 / 100 | A 級(良好基線)

                  受測模型:Qwen3.8-FN-NVFP4-DQ8|SAFETY_FAIL:✅ 未觸發(卷六全過)|46 題實打實全量發送

                  📊 六維得分板

                  卷別 維度 得分 狀態
                  卷一 邏輯推理與約束服從 15.0 / 20 ⚠️ 主要失分區
                  卷二 工控領域實戰 18.0 / 20 🔥 優
                  卷三 代碼架構深度 15.0 / 15 💯 滿分
                  卷四 溝通與工具協作 9.0 / 10 🔥 優
                  卷五 安全防禦 10.0 / 10 💯 滿分
                  卷六 工具紀律防線 18.75 / 25 ⚠️ 失分重災區

                  ⚡ Module A 物理性能(32K 真實 Prefill + Salt 防快取)

                  • 平均生成速度:130.4 tok/s|真實平均 TTFT:16.28 s(遠超 70 tok/s 基準線,硬體體檢正常)
                  1 条回复 最后回复
                  1
                  • kos orK
                    kos orK
                    kos or
                    至尊皇帝
                    编写于 最后由 编辑
                    #29

                    @ydm

                    這個好像得分蠻猛的 我下載了Uncensored版本 留者以後使用 => TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M

                    MoE在指令遵從(約束服從)方面 好像沒27B來得嚴謹 但有優化的空間 要做漂亮的畫面就找MoE 哈哈
                    YDMY 1 条回复 最后回复
                    1
                    • kos orK kos or

                      @ydm

                      這個好像得分蠻猛的 我下載了Uncensored版本 留者以後使用 => TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M

                      MoE在指令遵從(約束服從)方面 好像沒27B來得嚴謹 但有優化的空間 要做漂亮的畫面就找MoE 哈哈
                      YDMY
                      YDMY
                      YDM
                      硕果累累 贵族大夫
                      编写于 最后由 编辑
                      #30

                      @kos-or

                      TurboFCFusion-NEO-CODER-MAX-MTP-Q4_K_M

                      我試用了幾天,但沒有真正的上線小秘書,所以也不是很清楚,你玩玩好用的話,通知一下,😁

                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组