
【2×7900XTX】接 3035 的彩蛋:kitchen 里面除了 int8 还有 SOL(1.30×–2.39×),有视频和样张左右对照,看看哪个好?
-
这条线是 @xiongjie-gao 的:3035 给了判据(S1)、五档验收表、完整条件、还有 kuzuryusen 的
bench.py+run_tp.sh。我照他的条件复现,单卡三档在他 6% 以内。我只是顺手量了他没测的那一跳:kitchen 里面,int8 → SOL。1. 下面部分数据是引用他给我的《补充报告_双卡互联带宽并表》:
(a)3035 主帖:他的机器、他的验收线(2×RX 7900 XTX 24G / Xeon E5-2696 v4 / 125 GB / PCIe 4.0 ×8,非 ×16;DiT
fl2va w4a811.7 GB、TEw4a826 GB、LoRAturbo_v4_step600)他的档 单卡 s/it(显存) 他的 TP2 s/it 相对单卡 832×480 · 124f · 8 步 11.235 7.618 1.47× 832×480 · 362f · 8 步 53.7(19.96 GB) 31.9 1.68× 1344×768 · 362f · 2 步 257.9(23.82 GB) 112.3 2.30× 单算子判据(他的 S1):8192 token,sub_quad 922.5 ms → kitchen 152.7 ms;≤200 ms 为健康、>800 ms 为坏。整条链:34.5 min → 3.3 min(1050%↑)。
我这台的复现(不同权重、不同 CPU,只比同档比值):10.564 / 50.78 / 251.90,显存 23.83 / 20.01 / 23.84 —— 三档都在他 6% 以内。(这是 11-17 那次复现;§3 是 11-18 的 A/B,两次的 int8 列差 <0.6%:10.53 / 50.78 / 250.58。)
(b)他的《补充报告_双卡互联带宽并表》——他那台 X99-TF(根口 Gen3 x8):
他实测的 数值 卡到卡 P2P 5.00 GB/s(Gen3 x8 理论 7.88,效率 63%);换 x16 板(X99-T8 类)10.30 / 双向 19.36 TP2 每步通信 450 次 all-reduce(50 block × 9)、单次 137 MB、每步 62.0 GB、持续 1.90 GB/s = 链路 38% 真正暴露在关键路径 4.0 s = TP2 单步的 12.2%(分块 MLP 把约一半藏在 GEMM 后) 只改互联(5.00→10.30) 32.7 → 30.7(保守)/ 28.7(乐观)s/it = 1.065–1.139×,代价是换主板 SOL 单算子(真实打包序列) S=15,090 / 23,020 / 38,490:int8 0.078 / 0.191 / 0.530 s,SOL 0.022 / 0.049 / 0.128 s = 3.5–4.1× 他的折算(最有用的那条) 单步 50 次注意力调用。0.4MP:38,490×50 ≈ 26.5 s = 整步的 46% → 1.54×;1MP:占比 66% → 2.0× 并表后的总账 10.5× → +SOL 11.9× → +P2P 12.5×(单条 3.3 → 2.90 → 2.76 min) 判我的错 qkv_proj [21504,2688]= 3×56头×128,整块chunk(2,dim0)语义断裂;判据是切分往返 + 单 blockmax_abs,不是 mean|Δ|**结论是他先给的:真正的大头是注意力,不是卡间带宽。**我这台独立对上:装
p2p_force+ 按真实拓扑生成NCCL_TOPO_FILE,isAllDirectP2p 1、通道via P2P/IPC、他自己的 bootcheck[OK] KFD 链路 2——只快 1%(11.99 → 11.95 s/it)。2. 我这组 A/B 的条件(照他的口径,可直接 FORK)
项 值 机器 8.7:Ryzen 5950X + 2×RX 7900 XTX 24G(gfx1100,可用上限 23.98 GB),125 GB,两卡到 CPU 都是 PCIe 4.0 ×8( cat /sys/bus/pci/devices/*/current_link_width;端点 x16 不算结论,要看上一级)软件 ComfyUI 0.45.2,torch 2.15.0+rocm7.14 权重 DiT Minimax-h3_Singularity_ref2va_v2_Pruned_w4a8.safetensors(12.55 GB)· TEqwen3vl_32b_minimax_h3_nvfp4_awq.safetensors(15.69 GB)· VAEminimax_h3_video_vae_fp16+minimax_h3_audio_vae_fp32· LoRAminimax_h3_dmd_ref2va_8step_turbo_pruned(strength 1.0)工作流 他 bench.py里那张(文字→视频,无参考图):MiniMaxH3ImageToVideo(prompt,width,height,length)→BasicGuider→BasicScheduler(scheduler=simple, denoise=1.0)→KSamplerSelect(**res_multistep**)→SamplerCustomAdvanced→VAEDecode/VAEDecodeAudio→CreateVideo(fps 24)提示词 他 bench.py的默认值:A calm lakeside at sunrise, slow dolly-in, mist over the water, gentle ripples, cinematic soft light.采样 seed 145;档位 =(world, W, H, frames, steps)见 §3;每档冷启动(重启实例) 启动参数 --enable-dynamic-vram --use-ck-attention --mmap-torch-files --disable-smart-memory;TP2 用他run_tp.sh的默认(COMFY_TP_MLP_CHUNKS=8、COMFY_TP_AR_MODE=bf16、VAE_SPLIT=0、P2P 补丁开)s/it 口径 他的口径:取第 2…steps−1 步(首步含加载/预热,末步含收尾);端到端 = 整条工作流墙钟 跑之前 systemctl stop strata-fork.service(否则两卡各占 ~23 GB,探针会 OOM)唯一差别 插一个节点(下面);其余两列完全一样 # custom_nodes/sol-attn/__init__.py —— 接在 UNET/LoRA 之后、BasicGuider/BasicScheduler 之前 import functools, comfy.ldm.modules.attention as attn class MiniMaxSOLAttention: @classmethod def INPUT_TYPES(cls): return {"required": {"model": ("MODEL",), "tau": ("FLOAT", {"default": 1.0, "min": 0.0, "max": 4.0, "step": 0.05})}} RETURN_TYPES = ("MODEL",); FUNCTION = "apply" def apply(self, model, tau): if not attn.comfy_kitchen.sol_attn_is_available(model.load_device): raise RuntimeError("sol_attn unavailable") # 不静默退回 m = model.clone() m.set_model_optimized_attention(functools.partial(attn.attention_comfy_kitchen_sol, tau=tau)) print(f"[sol] attention backend -> comfy_kitchen sol_attn tau={tau}", flush=True) return (m,)SOL 不在节点下拉里(内置只给 pytorch / kitchen int8),只能这样接。日志那行
[sol] attention backend -> comfy_kitchen sol_attn tau=1.0是生效的判据。EXTRA_ARGS="--enable-dynamic-vram --use-ck-attention --mmap-torch-files --disable-smart-memory" \ bash run_tp.sh <world> 8191 <tag> python bench_sol.py --ports 8191 [8192] --attn sol … # = 他的 bench.py + 6 行:把节点 17 插在 2→8/10 之间 # 单算子:python attn_path_bench_87.py # 56 heads × 128 head_dim,fp16,无 mask,warmup 2 + 10 次取均3. 结果:同档同 seed,只换这一条路径
档 kitchen int8:s/it · 端到端 · 峰值 SOL:s/it · 端到端 · 峰值 s/it 1c · 832×480 · 124f · 8 10.53 · 108.2 s · 23.83 GB 8.09 · 87.2 s · 23.83 GB 1.30× 1c · 832×480 · 362f · 8 50.78 · 455.6 s · 20.01 GB 28.96 · 280.5 s · 23.83 GB 1.75× 1c · 1344×768 · 362f · 2 250.58 · 596.8 s · 23.84 GB 105.00 · 312.5 s · 23.83 GB 2.39× TP2 · 832×480 · 124f · 8 6.55 · 77.6 s · 23.85 GB 5.32 · 68.4 s · 23.74 GB 1.23× TP2 · 1344×768 · 362f · 2 132.40 · 367.6 s · 17.60 GB 60.47 · 226.3 s · 17.87 GB 2.19× 单算子我这台 3.2–3.7×(16384 token:25.3 vs 93.3 ms);形态和他的一致:序列越长赢越多,因为注意力占整步的比在涨(他的折算 46% → 66%)。
1MP 不用再上双卡:单卡 SOL 105.0 s/it 比双卡 int8 的 132.4 还快,显存同为 23.83。
4. 质量:差 ≈ 换一次 seed,不是坏图
同一段 124 帧、同 seed,
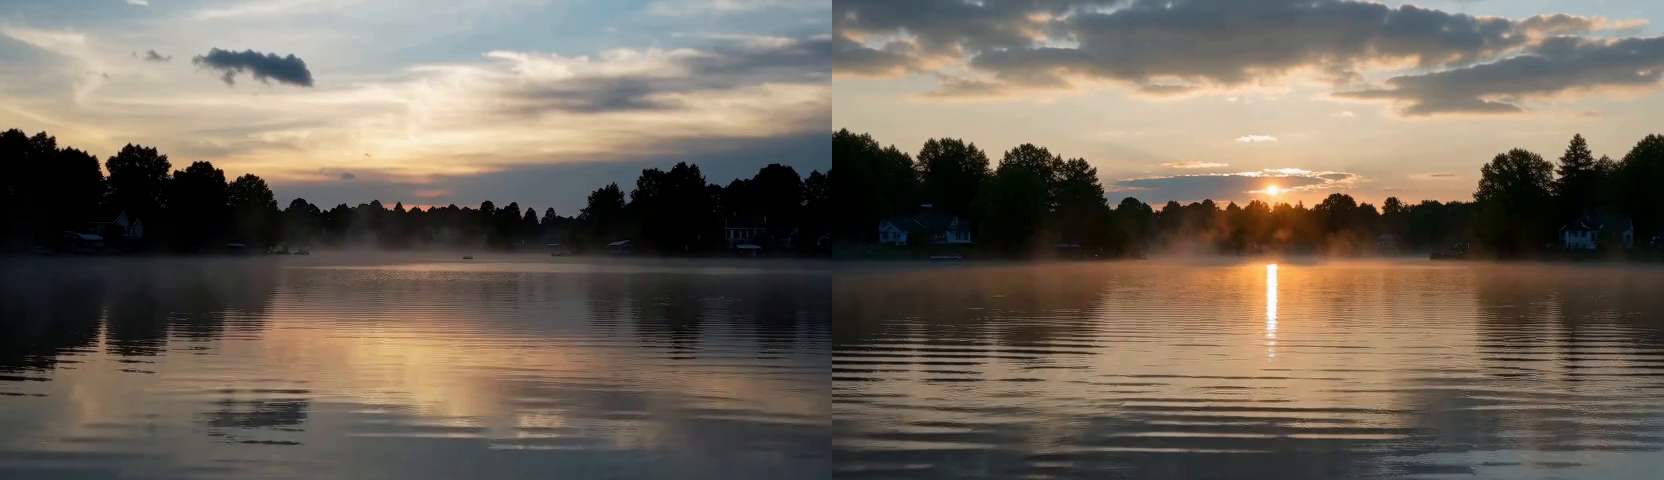
dumpframes.py取前 12 帧(每 4 帧 1 张),viddiff.py算整帧 mean|Δ|、vidstruct.py算 1/8 缩的结构差:整帧 mean|Δ| 结构(1/8) RGB int8 vs SOL(单卡) 30.5 27.4 110/103/95 → 115/101/86;std 67.1 → 62.3 参照:同配置跑两次 0.00 — — 参照:换 seed 34.1 — — 参照:坏图(没切权重) 54.8 — — 两边都是正常的湖面日出,SOL 偏亮一点、对比略低;没有 3092 那种划痕/马赛克。左右对照(左 int8、右 SOL,832×480·124f·seed145):https://youtu.be/G5YrTN-JZEo
代价:0.4MP·362f 那档 int8 的 3.8 GB 余量被 SOL 吃掉(20.01 → 23.83)。24G 卡跑 362 帧档的,用 SOL 要重算余量。
两张样片左右对照(左 = kitchen int8,右 = sol)
5. 一处更正(他判的,我接受)
我在 3035 下面交的双卡 1.61×/1.91× 请当成"能跑、切法待修":
qkv_proj [21504,2688]= 3×7168 = 3×56头×128,整块chunk(2,dim0)会让 rank0 拿到全部 q + 半个 k、rank1 拿到半个 k + 全部 v,attention 语义断裂;正确切法是先chunk(3,dim0)分 q/k/v、每段再按头切。判据是切分往返 + 单 blockmax_abs,不是 mean|Δ|——我那个 16.5 恰好落在"换 seed 34.1"和"没切 54.8"之间,正是错误切分会给的形态。单卡三行不受影响;重切后我补测。6. 没测的
tau只用 1.0(SOL 是近似注意力,质量结论只在 tau=1.0 成立);比赛那档 294f 没跑过 SOL(跑的是 362f);只测 8 步蒸馏 LoRA;一次 seed——按他 3035 的 F8 该换 seed 再验。
**谢谢 @xiongjie-gao。**判据、验收表、条件、连我这里的错,他都是直接给的。我这边只是把 int8 → SOL 这一跳量到了五档。
-
论证翔实,昨天我是通过抽桢校验的方式肉眼比对同桢的剑心打架图

与其说未分高下,实际真象更接近两个都是渣渣。
你这个案例对比更直观,虽然AI都说Sol生成质量略差,但可能在部分指定效果上(如你跑的风景),肉眼感观更倾向于Sol的交付效果。
所以这事就不仅仅是牺牲一点质量换速度,而是在部分场景中可以完全代替并有全面提升。
-
,E Enigma 引用了 此主题
-
论证翔实,昨天我是通过抽桢校验的方式肉眼比对同桢的剑心打架图
与其说未分高下,实际真象更接近两个都是渣渣。
你这个案例对比更直观,虽然AI都说Sol生成质量略差,但可能在部分指定效果上(如你跑的风景),肉眼感观更倾向于Sol的交付效果。
所以这事就不仅仅是牺牲一点质量换速度,而是在部分场景中可以完全代替并有全面提升。
