跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 3090 24G 跑QWOPUS 3.6 27B mtp 131K上下文 KV(Q8_0) 55TOK/S 智能开关思考- 最终配置,再也不折腾了(6月14日更新)

3090 24G 跑QWOPUS 3.6 27B mtp 131K上下文 KV(Q8_0) 55TOK/S 智能开关思考- 最终配置,再也不折腾了(6月14日更新)

已定时 已固定 已锁定 已移动 热议 LLM讨论区
rtx3090mtp
22 帖子 11 发布者 1.7k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • ran zR
    ran zR
    ran z
    发表于 最后由 编辑
    #13

    5090移动版也是24g,能抄作业吗?

    terryT 1 条回复 最后回复
    0
    • A
      A
      applejuice
      王侯将相
      发表于 最后由 applejuice 编辑
      #14

      我用vllm 双卡没有NVLINK

      Prefill 4K 重复测量 (5 次)

      run prompt_tokens ttft tok/s
      1 3 836 2 776 ms 1 382
      2 3 836 2 735 ms 1 403
      3 3 834 2 665 ms 1 439
      4 3 833 2 770 ms 1 384
      5 3 838 2 772 ms 1 384

      Decode 单流 重复测量 (4 次)

      run prompt_tokens completion_tokens ttft decode tok/s
      1 76 220 256 ms 66.2
      2 79 220 278 ms 66.6
      3 81 220 284 ms 66.7
      4 80 220 284 ms 66.7
      1 条回复 最后回复
      0
      • ran zR ran z

        5090移动版也是24g,能抄作业吗?

        terryT
        terryT
        terry
        易有太极
        发表于 最后由 编辑
        #15

        @ran-z 5090移动版也快很多,有啥不能抄的?

        油管:https://www.youtube.com/@抡锤者

        1 条回复 最后回复
        0
        • C c0aster

          我直接用的3090club的 ik_llama + IQ4_KS + MTP,对比你自行编译的BoFan的分支,是哪个强?

          毅袁毅
          毅袁毅
          毅袁
          发表于 最后由 编辑
          #16

          @c0aster 感谢分享,已经按照ik-llama实施,实测Qwen3.6-27B-uncensored-heretic-v2-Native-MTP-Preserved-Q4_K_M.gguf达到69t/s,已经能够满足生产力需求了

          C 1 条回复 最后回复
          0
          • 毅袁毅 毅袁

            @c0aster 感谢分享,已经按照ik-llama实施,实测Qwen3.6-27B-uncensored-heretic-v2-Native-MTP-Preserved-Q4_K_M.gguf达到69t/s,已经能够满足生产力需求了

            C
            C
            c0aster
            发表于 最后由 编辑
            #17

            @毅袁 你不是用的3090clud的脚本是吧,我用3090club的脚本只有40多,你咋能跑69,分享下具体的呗

            毅袁毅 1 条回复 最后回复
            0
            • terryT terry 于 取消固定此主题
            • 5
              5
              5ccccc
              发表于 最后由 编辑
              #18

              我今天用7900xtx跑一个本地任务的时候也oom了,参考的论坛内的一个设置

              1 条回复 最后回复
              0
              • C c0aster

                @毅袁 你不是用的3090clud的脚本是吧,我用3090club的脚本只有40多,你咋能跑69,分享下具体的呗

                毅袁毅
                毅袁毅
                毅袁
                发表于 最后由 编辑
                #19

                @c0aster https://github.com/ikawrakow/ik_llama.cpp 从这个项目自己编译的ik_llama,启动参数如下:
                start "ik_llama - heretic-v2 27B" "%EXE%" ^
                -m "J:\llama-b9370-bin-win-cuda-12.4-x64\models\1\Qwen3.6-27B-uncensored-heretic-v2-Native-MTP-Preserved-Q4_K_M.gguf" ^
                --mmproj "J:\llama-b9370-bin-win-cuda-12.4-x64\models\1\Qwen3.6-27B-mmproj-BF16.gguf" ^
                -ngl 99 -c 131072 --threads 12 --no-mmap ^
                --flash-attn on ^
                --cache-type-k q4_0 --cache-type-v q4_0 ^
                --batch-size 512 --ubatch-size 256 ^
                --merge-qkv --merge-up-gate-experts ^
                --cache-ram 32768 ^
                --spec-type mtp:n_max=4,p_min=0.0 ^
                --jinja --chat-template-file "%TEMPLATE%" ^
                --timeout 3600 --host 0.0.0.0 --port 8080

                1 条回复 最后回复
                1
                • stxpnetS
                  stxpnetS
                  stxpnet
                  王侯将相
                  发表于 最后由 stxpnet 编辑
                  #20

                  今天准备使用的参数如下:

                  #top-p 0.95 则尾部应该--min-p 0.01 将尾部噪音切除,否则可能造成循环! 
                  # 只开n-max 为2的话,长上下文稳定性应该好, k精度取q8_0获得较高的注意力精度
                  # 预留1024M空间,防止腾挪时发生显存爆炸
                  #bofan Qwopus3.6-27B-Coder-MTP-IQ4_XS
                  killall llama-server 2>/dev/null; sleep 3
                  cd /data/model2/bofan-llama.cpp/build/bin
                  CUDA_SCALE_LAUNCH_QUEUES=4x \
                  ./llama-server \
                    -m /data/model2/Qwopus3.6-27B-Coder-MTP-IQ4_XS.gguf \
                    -c 132000 \
                    -ngl 9999 \
                    -fa on --metrics --fit-target 1024 \
                    -ctk q8_0 -ctv turbo4 \
                    --spec-type mtp \
                    --spec-draft-n-min 2 \
                    --spec-draft-n-max 3 \
                    --jinja \
                    --chat-template-file /data/model2/chat_template-fixed-v20.jinja \
                   --temp 0.6  --top-k 20 --top-p 0.95 --min-p 0.01 \
                    --mlock -np 1   \
                    -b 1024 -ub 1024 \
                    --host 0.0.0.0 --port 8025 \
                    --reasoning auto \
                    --reasoning-format deepseek --reasoning-budget 4096


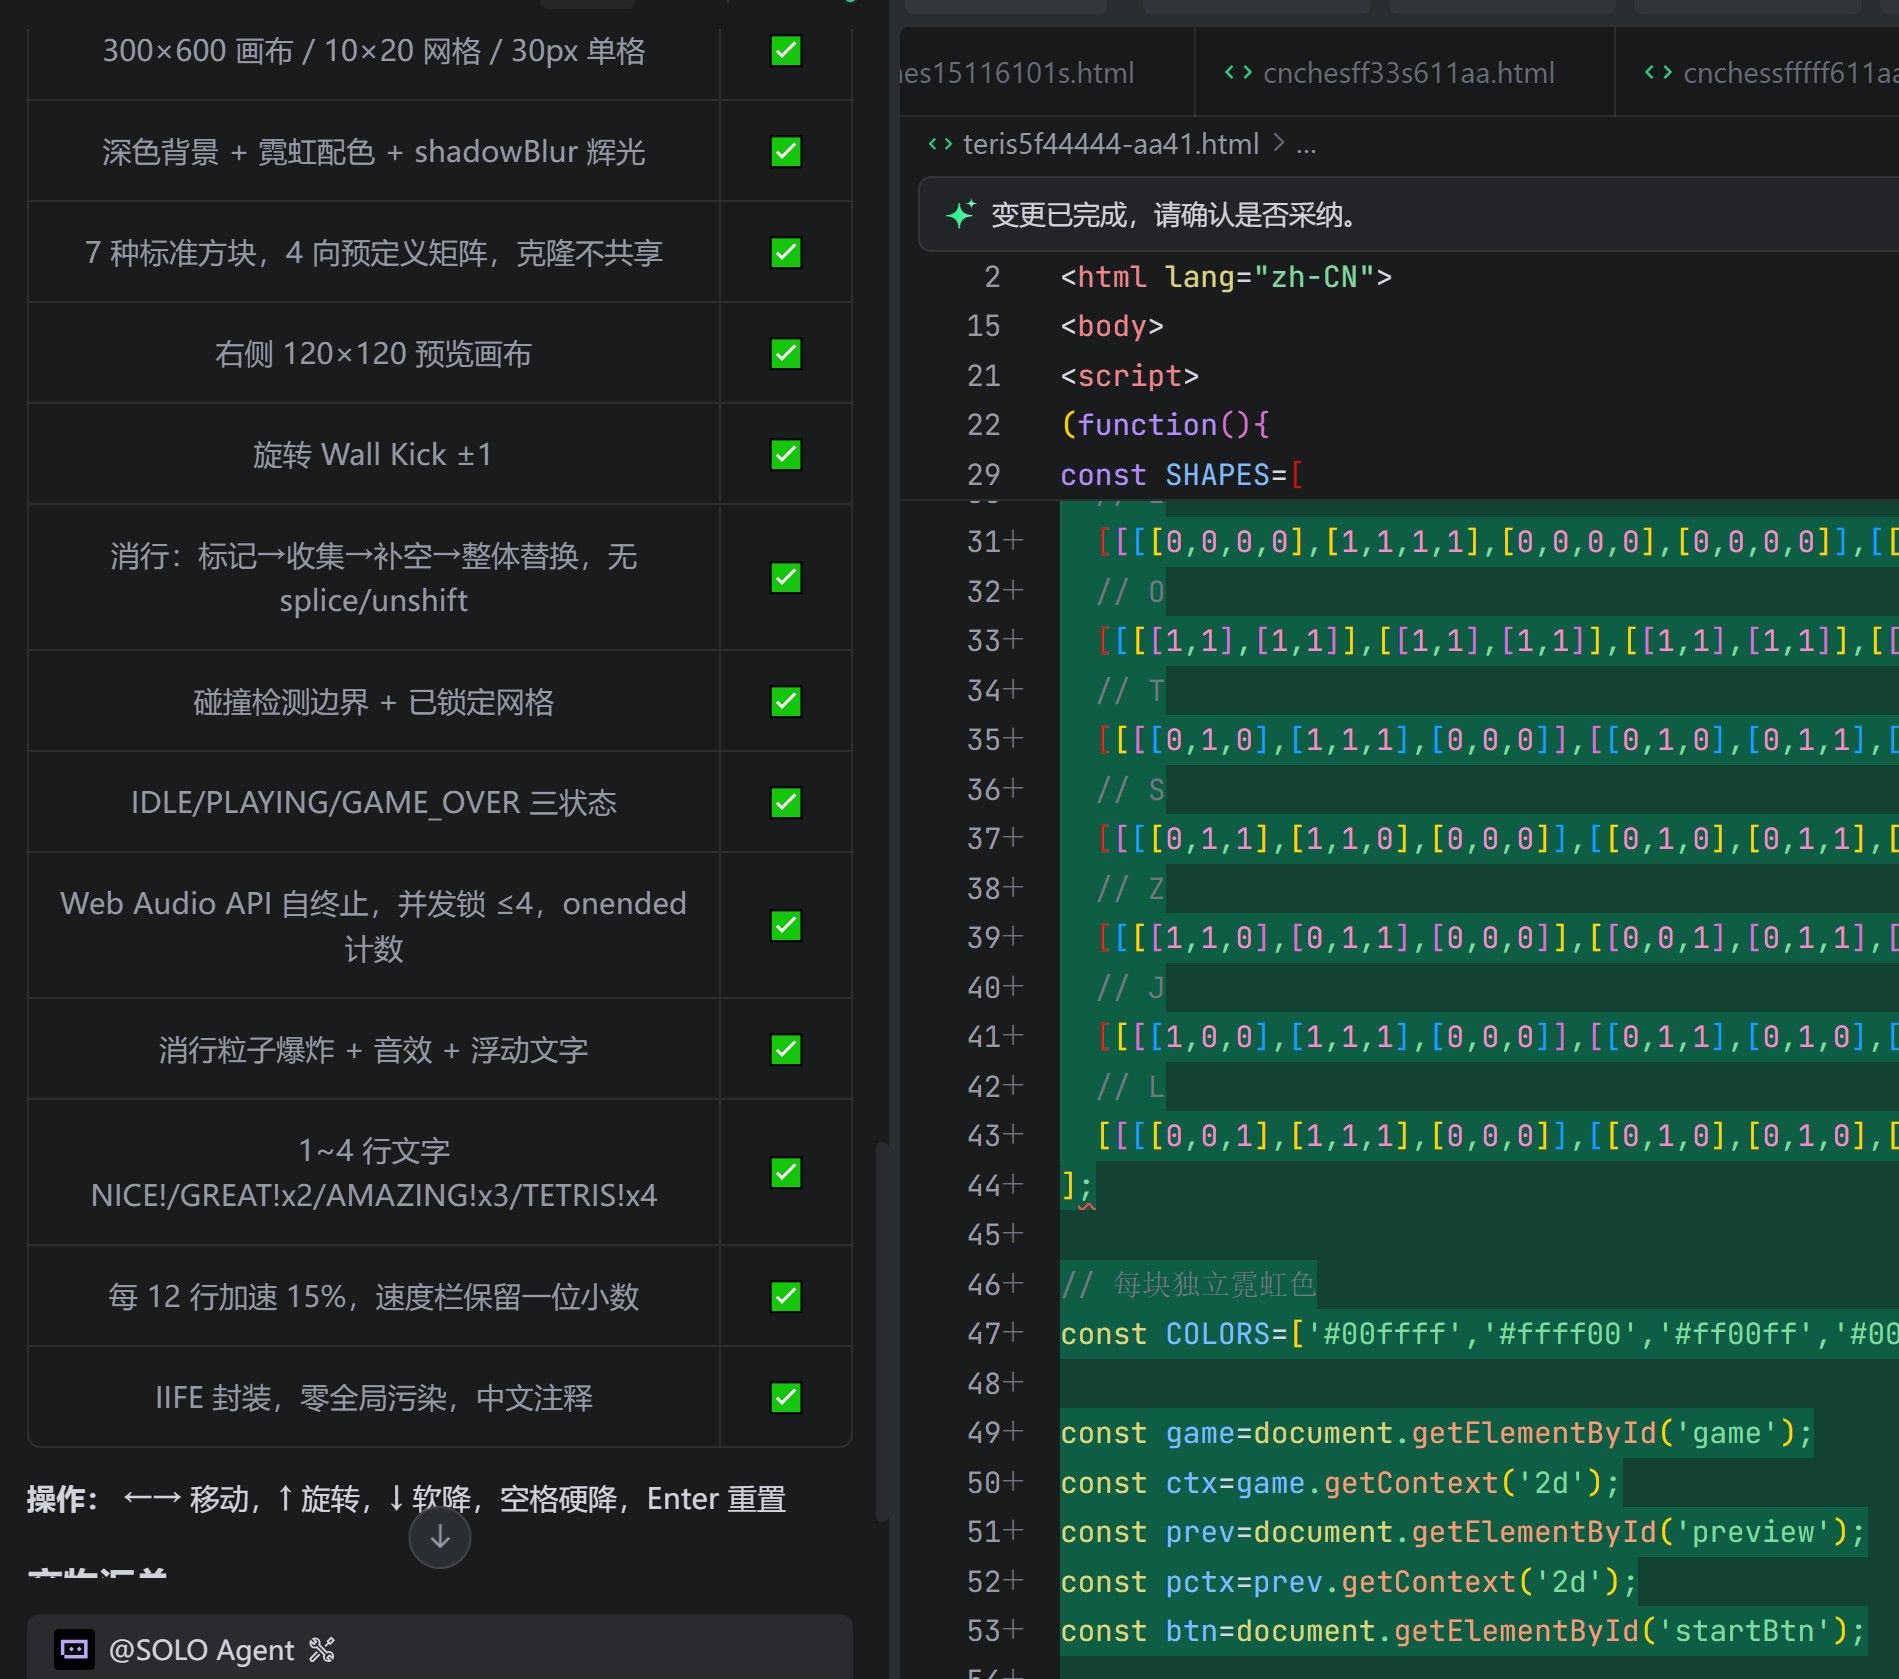
                  较复杂的俄罗斯方块多步生成 ,要10分钟左右,这个模型和参数似乎拥有并行修改错误代码的能力
                  b8c324ee-c13b-4fed-bc5c-344de85b62bd-image.jpeg

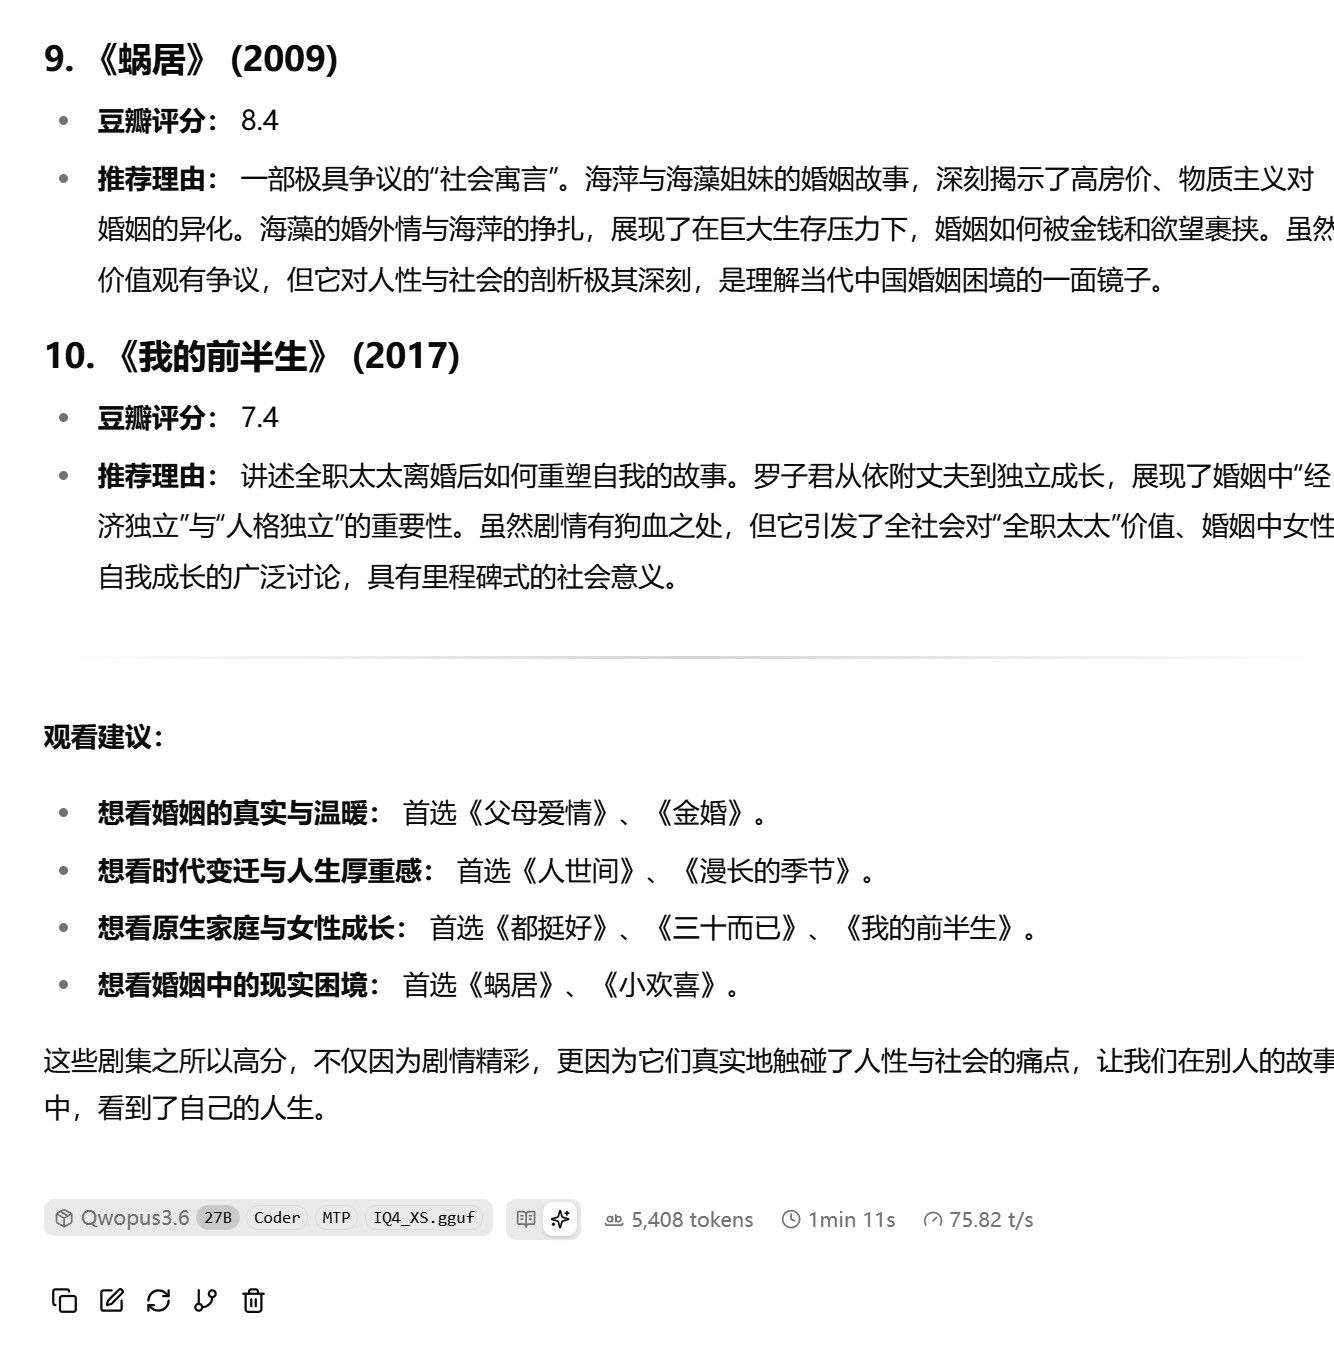
                  生成 俄罗斯方块之后,再在WEB UI测试 半开放式问题。内容质量及速度都比较均衡:(平衡75T/S)
                  f2bc32bc-5aa0-4f42-b7b9-b6e36a50ed0f-image.jpeg

                  这个模型比较适合写程序代码,如果内容创作,建议使用qwen 3.6 27B V2 MTP原版

                  双卡3090 PCIE 4.0 16X/16X

                  白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                  夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                  1 条回复 最后回复
                  0
                  • Boling LiB
                    Boling LiB
                    Boling Li
                    发表于 最后由 编辑
                    #21

                    @stxpnet 太棒了。视觉的pp太瓶颈了,做脑子还是MTP+阉割视觉。楼主有遇到过loop的问题吗?相同的模型后台一直卡在一个“summary” 的任务下重复了半个小时

                    stxpnetS 1 条回复 最后回复
                    0
                    • Boling LiB Boling Li

                      @stxpnet 太棒了。视觉的pp太瓶颈了,做脑子还是MTP+阉割视觉。楼主有遇到过loop的问题吗?相同的模型后台一直卡在一个“summary” 的任务下重复了半个小时

                      stxpnetS
                      stxpnetS
                      stxpnet
                      王侯将相
                      发表于 最后由 编辑
                      #22

                      @Boling-Li 多方面原因的,你这种有可能是K V CACHE里面产生的参数模型权重内找不到。 我上面是用了min-p=0.01来规避。

                      双卡3090 PCIE 4.0 16X/16X

                      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组

