跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 全站首发:RTX 3090 24G 无痛爽玩 华为最新开源KV cache格式 (每日更新总结,希望3090卡友进来讨论)

全站首发:RTX 3090 24G 无痛爽玩 华为最新开源KV cache格式 (每日更新总结,希望3090卡友进来讨论)

已定时 已固定 已锁定 已移动 LLM讨论区
rtx3090
17 帖子 6 发布者 969 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • stxpnetS
    stxpnetS
    stxpnet
    王侯将相
    发表于 最后由 编辑
    #4

    现在开始用noonghunna的配置和镜像 测试 Qwopus CODER 3.6 27B MTP Q 5 KM.
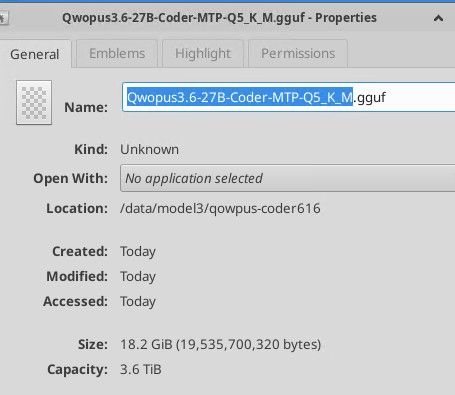
    1d9604c1-9622-44e6-a2a7-75d58519b024-image.jpeg 权重就达到了19.5G,比我平时用的都多了6GB啊? 增加的这部分体积能起到相应的效果吗?
    一开始直接上160K,问第二段时直接爆显存(根本原因可能是我那440M显存开机被占用了,下次重装系统一定安装server版 headless系统)
    两段式生成文学试卷题,共花费59秒. 感觉比小模型要谨慎一些.
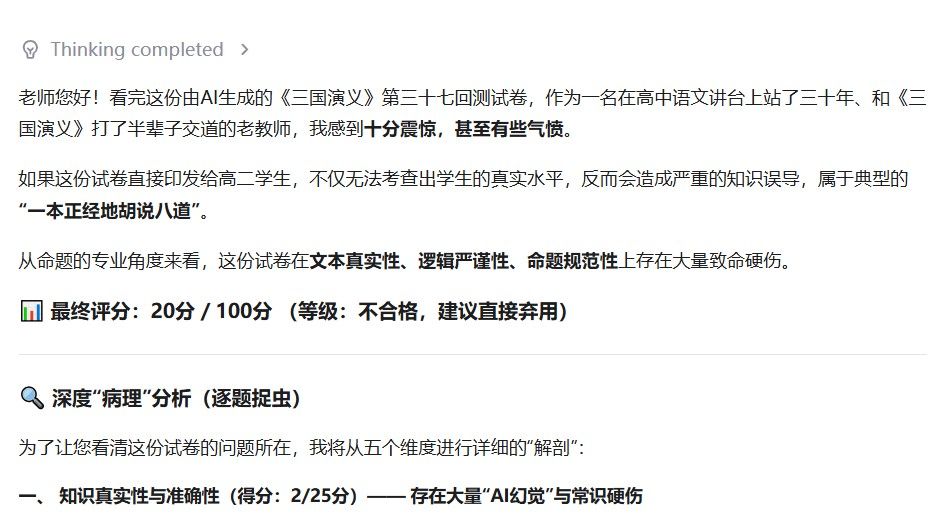
    同样丢 给在线的千问打分(已经开了分支对话,避免其它污染干扰)
    给出的分数是20分,这不稀奇,因为它是CODER模型,文学被削弱了是好事,说明编码能力可能被增强.
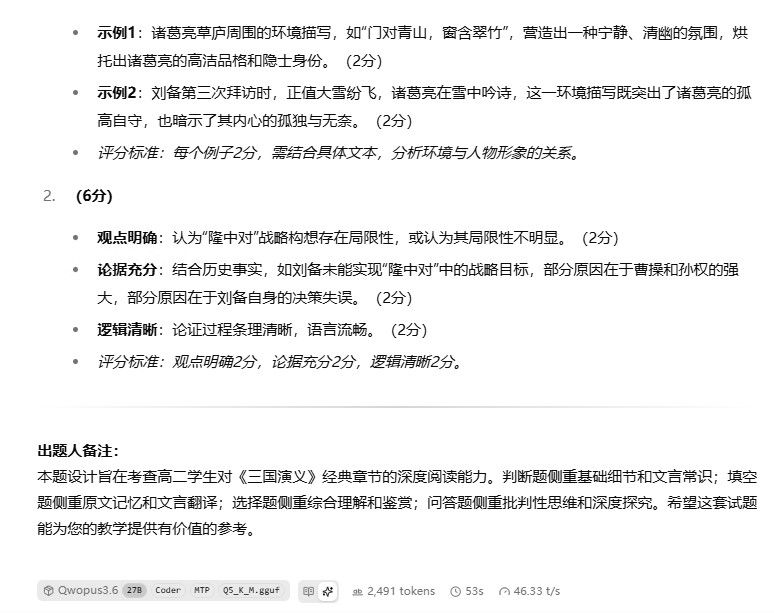
    6f835751-fd46-4fc2-9a08-ac0bcb5454e0-image.jpeg
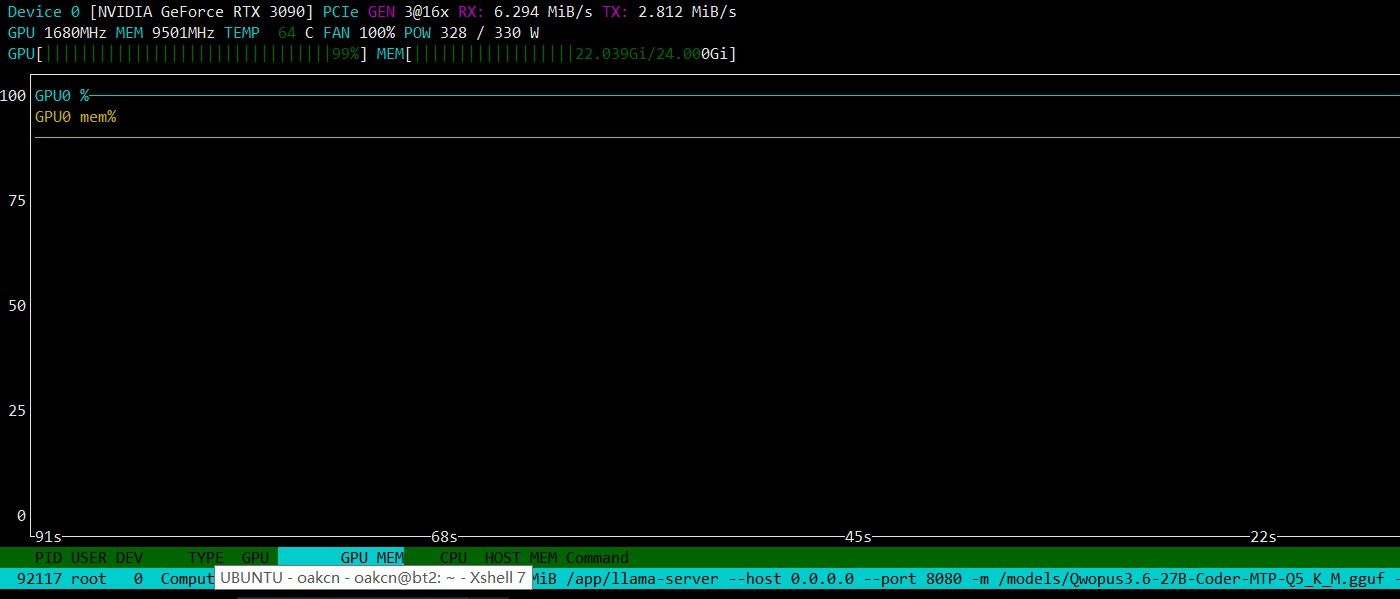
    显存维持在22G左右(剩余1.9G)

    写俄罗斯方块用了3分钟,我玩了3分钟,基本无错.Q5权重 及coder优化 起到了相当的效果.
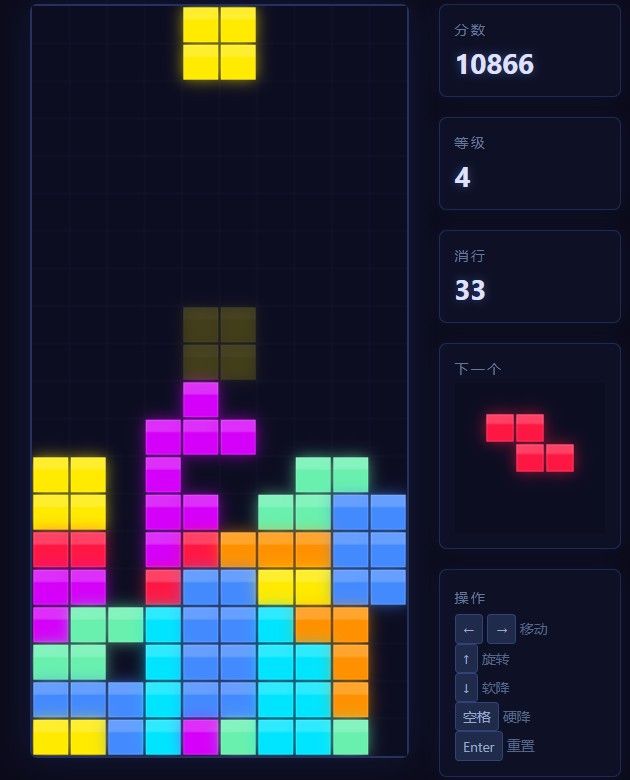
    81f4432a-b137-47f9-8d3f-5dc998f1bec7-image.jpeg
    写完之后显存占用没变,显存管理挺优秀.
    d7f8b4a5-309e-4d01-8dee-d90f705d0392-image.jpeg

    下面开始写中国象棋,我修改了一下提示词,防止需求内部矛盾导致后续 写了代码又大段大段删除.如果这个测试能完美,证明它的CODER能力确实有增强. 否则我还不如用unsloth的UD mtp模型呢.
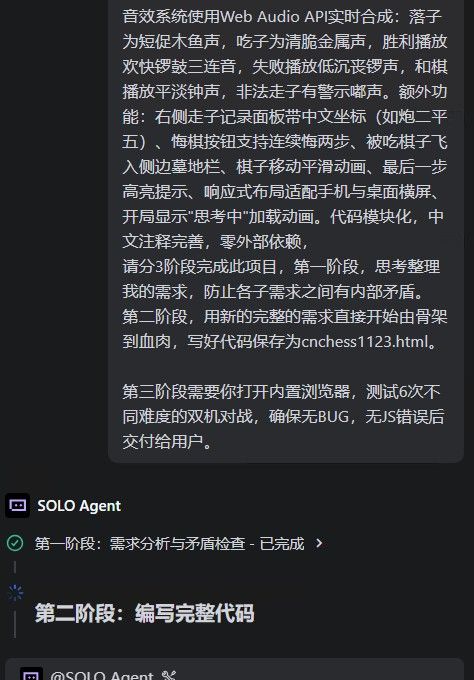
    a3bca7df-c6c2-4da4-af4f-901e82847dd6-image.jpeg

    这个模型挺均衡的,给我显卡干到64度了,心疼显卡3秒钟.

    ae20e85c-1be1-4d73-8f77-e504523878ff-image.jpeg

    双卡3090 PCIE 4.0 16X/16X

    白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
    夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
    A johnnybegoodJ 2 条回复 最后回复
    0
    • stxpnetS
      stxpnetS
      stxpnet
      王侯将相
      发表于 最后由 编辑
      #5

      346e6cef-75b4-4ca7-ac31-cb0463621317-image.jpeg
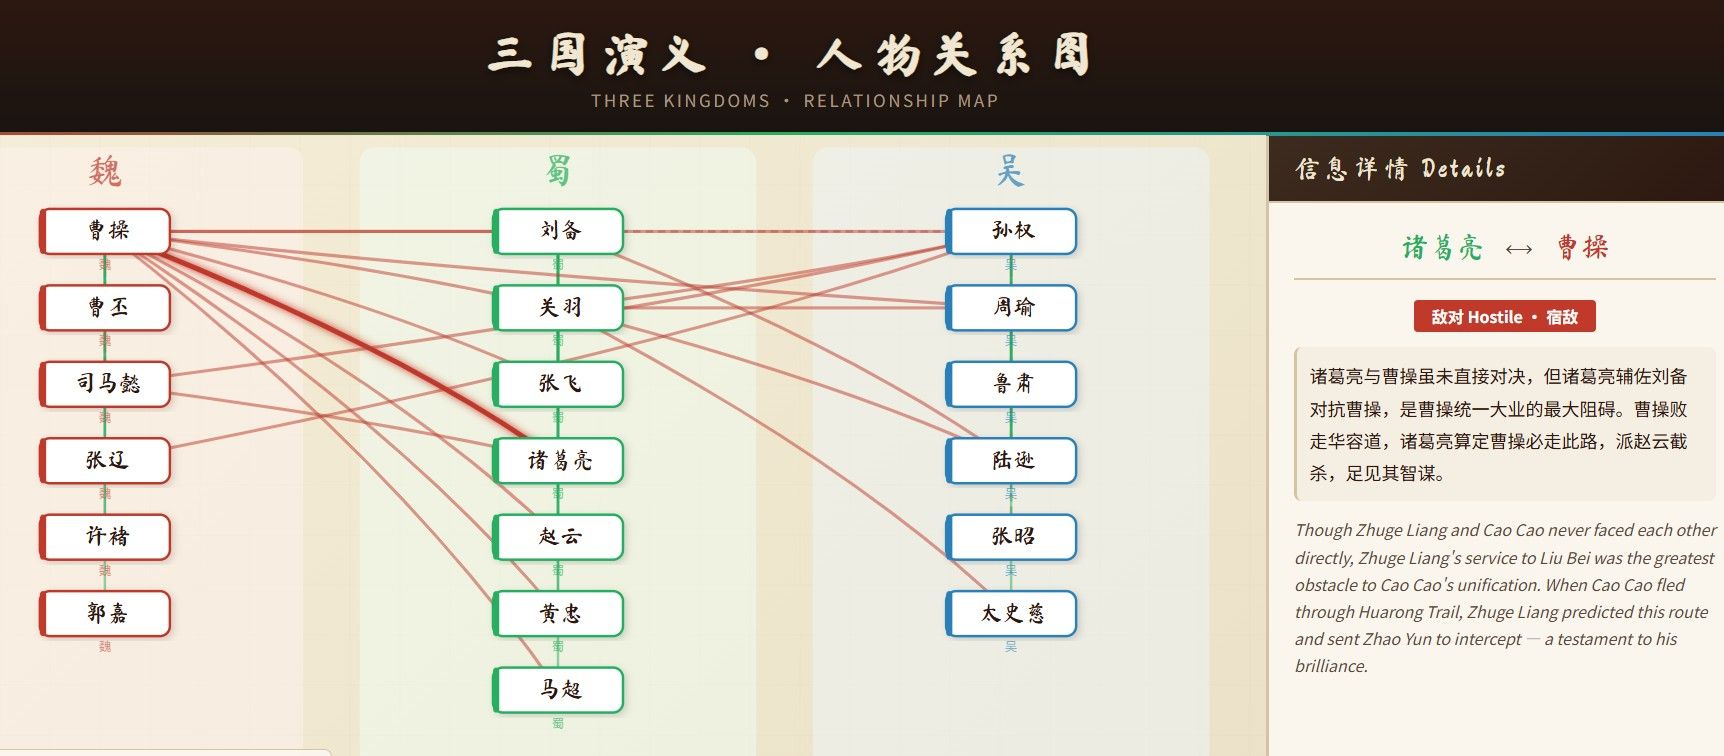
      让它做的三国人物关系图,耗时13分钟,略带惊艳, 是最近我测试过的里面最好的了. 这个测试必须给98分啊.

      双卡3090 PCIE 4.0 16X/16X

      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
      1 条回复 最后回复
      0
      • terryT terry 于 将此主题固定
      • stxpnetS
        stxpnetS
        stxpnet
        王侯将相
        发表于 最后由 编辑
        #6

        79f75114-0d89-469f-ac23-3aed55d7b352-image.jpeg
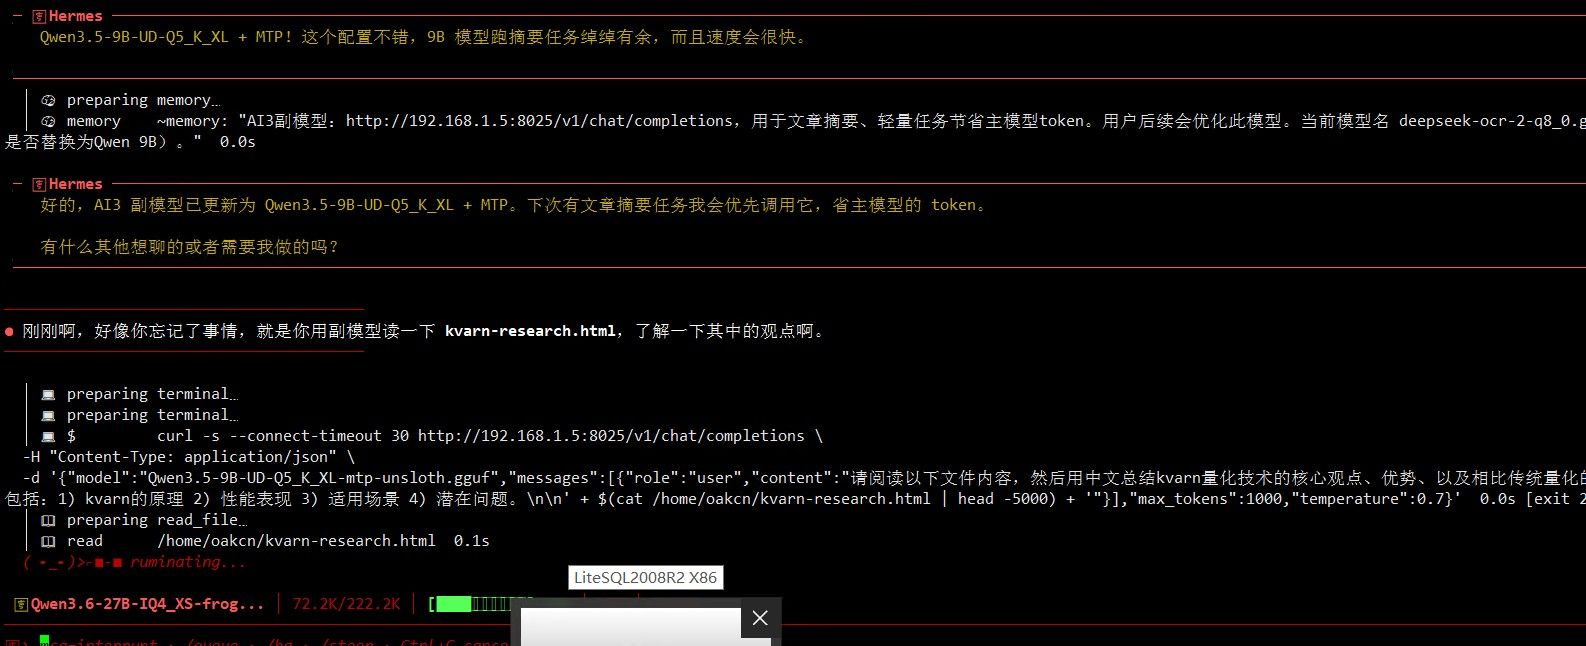
        今天有个非常大的收获,可以说是最近10天来史诗级的 进步.我的Hermes终于可以和我日常聊天了. 不要太爽. P100破显卡做副模型.哈哈.

        双卡3090 PCIE 4.0 16X/16X

        白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
        夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
        1 条回复 最后回复
        1
        • stxpnetS stxpnet

          现在开始用noonghunna的配置和镜像 测试 Qwopus CODER 3.6 27B MTP Q 5 KM.
          1d9604c1-9622-44e6-a2a7-75d58519b024-image.jpeg 权重就达到了19.5G,比我平时用的都多了6GB啊? 增加的这部分体积能起到相应的效果吗?
          一开始直接上160K,问第二段时直接爆显存(根本原因可能是我那440M显存开机被占用了,下次重装系统一定安装server版 headless系统)
          两段式生成文学试卷题,共花费59秒. 感觉比小模型要谨慎一些.
          同样丢 给在线的千问打分(已经开了分支对话,避免其它污染干扰)
          给出的分数是20分,这不稀奇,因为它是CODER模型,文学被削弱了是好事,说明编码能力可能被增强.

          6f835751-fd46-4fc2-9a08-ac0bcb5454e0-image.jpeg
          显存维持在22G左右(剩余1.9G)

          写俄罗斯方块用了3分钟,我玩了3分钟,基本无错.Q5权重 及coder优化 起到了相当的效果.

          81f4432a-b137-47f9-8d3f-5dc998f1bec7-image.jpeg
          写完之后显存占用没变,显存管理挺优秀.
          d7f8b4a5-309e-4d01-8dee-d90f705d0392-image.jpeg

          下面开始写中国象棋,我修改了一下提示词,防止需求内部矛盾导致后续 写了代码又大段大段删除.如果这个测试能完美,证明它的CODER能力确实有增强. 否则我还不如用unsloth的UD mtp模型呢.
          a3bca7df-c6c2-4da4-af4f-901e82847dd6-image.jpeg

          这个模型挺均衡的,给我显卡干到64度了,心疼显卡3秒钟.

          ae20e85c-1be1-4d73-8f77-e504523878ff-image.jpeg

          A
          A
          applejuice
          王侯将相
          发表于 最后由 编辑
          #7

          @stxpnet 我的显卡长期70+啊

          stxpnetS 1 条回复 最后回复
          0
          • A applejuice

            @stxpnet 我的显卡长期70+啊

            stxpnetS
            stxpnetS
            stxpnet
            王侯将相
            发表于 最后由 编辑
            #8

            @applejuice 温度?

            双卡3090 PCIE 4.0 16X/16X

            白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
            夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
            A 1 条回复 最后回复
            0
            • stxpnetS stxpnet

              @applejuice 温度?

              A
              A
              applejuice
              王侯将相
              发表于 最后由 编辑
              #9

              @stxpnet 对啊 只要一跑起来就70度

              1 条回复 最后回复
              0
              • 5
                5
                566656661
                王侯将相
                发表于 最后由 编辑
                #10

                突然發現up寫的是MoQ

                我還打算在這個周末測測看

                1 条回复 最后回复
                0
                • stxpnetS
                  stxpnetS
                  stxpnet
                  王侯将相
                  发表于 最后由 编辑
                  #11

                  目前我已经切换到IQ4_XS了,我觉得这个才是最适合coding的量化格式。

                  双卡3090 PCIE 4.0 16X/16X

                  白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                  夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                  5 1 条回复 最后回复
                  0
                  • stxpnetS stxpnet

                    目前我已经切换到IQ4_XS了,我觉得这个才是最适合coding的量化格式。

                    5
                    5
                    566656661
                    王侯将相
                    发表于 最后由 编辑
                    #12

                    @stxpnet

                    我是打算測試的同時講一講MoQ的技術, 評分可能就引用這篇文了

                    IQ4_XS BPW就是Q4KM附近, 模型權重大約在15gb吧?

                    留8~9gb給kv cache給長上下文很不錯的

                    1 条回复 最后回复
                    0
                    • stxpnetS
                      stxpnetS
                      stxpnet
                      王侯将相
                      发表于 最后由 stxpnet 编辑
                      #13

                      可以多在reddit上搜索看一下,我昨晚看了,也有人在研究这个格式的kv cache了,对咱们这批老用户是个好消息.
                      我目前的体感是64K或者128K比较适合咱们这个卡. 开0.7的温度,和hermes聊天. 0.6的温度编程. 下面是各种kv cache 的分歧度. 及显存占用 ,二者都是越小越好. 但我还想到一层:
                      就是如果你的模型权重本身 是Q4的话,产生Q5或Q6级别的cache,可能会拖慢速度,因为它在原始权重中找不到对应的参数.要在KV CACHE里面找,可能拖慢速度. 所以有空可以试试Q5级别的权重.
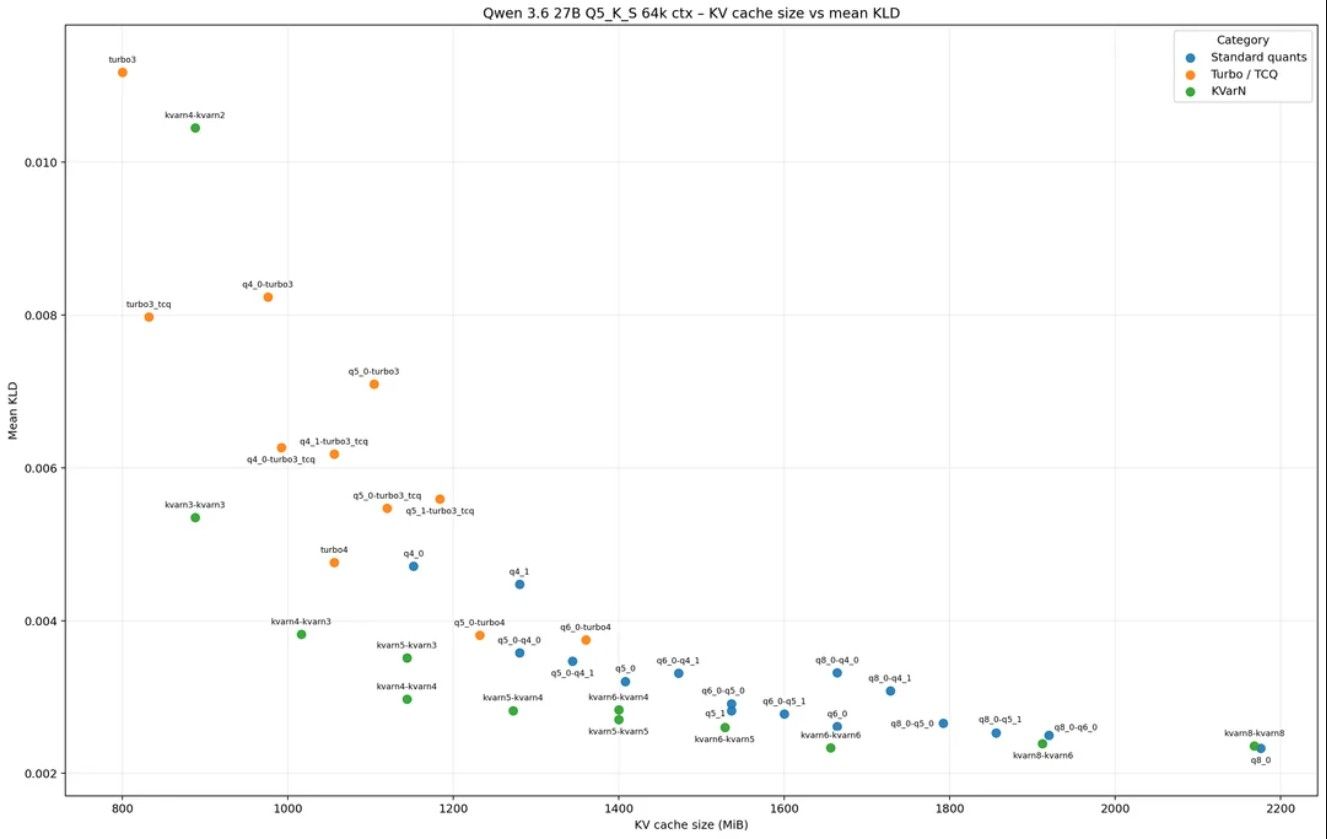
                      51fe9640-998b-4bb5-8ab2-8a868a1f83ea-image.jpeg

                      双卡3090 PCIE 4.0 16X/16X

                      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                      5 1 条回复 最后回复
                      1
                      • stxpnetS stxpnet

                        可以多在reddit上搜索看一下,我昨晚看了,也有人在研究这个格式的kv cache了,对咱们这批老用户是个好消息.
                        我目前的体感是64K或者128K比较适合咱们这个卡. 开0.7的温度,和hermes聊天. 0.6的温度编程. 下面是各种kv cache 的分歧度. 及显存占用 ,二者都是越小越好. 但我还想到一层:
                        就是如果你的模型权重本身 是Q4的话,产生Q5或Q6级别的cache,可能会拖慢速度,因为它在原始权重中找不到对应的参数.要在KV CACHE里面找,可能拖慢速度. 所以有空可以试试Q5级别的权重.

                        51fe9640-998b-4bb5-8ab2-8a868a1f83ea-image.jpeg

                        5
                        5
                        566656661
                        王侯将相
                        发表于 最后由 566656661 编辑
                        #14

                        @stxpnet

                        我自己的認知是要不模型權重量化跟KV Cache同Bit等級(Q8對上FP8, 8 : 8 ~= 1 : 1), 要不就是容易Scale Up (Q4 對上FP8, 4.x : 8 ~= 1 : 2)

                        如果沒對上的話應該要額外再增加一個轉換程序, Prefill會慢,外加有額外精度損失 (不記本身Scale up/down的話), 比較直觀的話就是KLD了

                        1 条回复 最后回复
                        0
                        • 系统 于 取消固定此主题
                        • C
                          C
                          c0aster
                          发表于 最后由 编辑
                          #15

                          坐等大佬更新,等一波抄作业

                          1 条回复 最后回复
                          0
                          • 5 566656661 于 引用了 此主题
                          • stxpnetS stxpnet

                            现在开始用noonghunna的配置和镜像 测试 Qwopus CODER 3.6 27B MTP Q 5 KM.
                            1d9604c1-9622-44e6-a2a7-75d58519b024-image.jpeg 权重就达到了19.5G,比我平时用的都多了6GB啊? 增加的这部分体积能起到相应的效果吗?
                            一开始直接上160K,问第二段时直接爆显存(根本原因可能是我那440M显存开机被占用了,下次重装系统一定安装server版 headless系统)
                            两段式生成文学试卷题,共花费59秒. 感觉比小模型要谨慎一些.
                            同样丢 给在线的千问打分(已经开了分支对话,避免其它污染干扰)
                            给出的分数是20分,这不稀奇,因为它是CODER模型,文学被削弱了是好事,说明编码能力可能被增强.

                            6f835751-fd46-4fc2-9a08-ac0bcb5454e0-image.jpeg
                            显存维持在22G左右(剩余1.9G)

                            写俄罗斯方块用了3分钟,我玩了3分钟,基本无错.Q5权重 及coder优化 起到了相当的效果.

                            81f4432a-b137-47f9-8d3f-5dc998f1bec7-image.jpeg
                            写完之后显存占用没变,显存管理挺优秀.
                            d7f8b4a5-309e-4d01-8dee-d90f705d0392-image.jpeg

                            下面开始写中国象棋,我修改了一下提示词,防止需求内部矛盾导致后续 写了代码又大段大段删除.如果这个测试能完美,证明它的CODER能力确实有增强. 否则我还不如用unsloth的UD mtp模型呢.
                            a3bca7df-c6c2-4da4-af4f-901e82847dd6-image.jpeg

                            这个模型挺均衡的,给我显卡干到64度了,心疼显卡3秒钟.

                            ae20e85c-1be1-4d73-8f77-e504523878ff-image.jpeg

                            johnnybegoodJ
                            johnnybegoodJ
                            johnnybegood
                            王侯将相
                            发表于 最后由 编辑
                            #16

                            @stxpnet 平时我只要跑起来就 90度啊。。。

                            stxpnetS 1 条回复 最后回复
                            0
                            • johnnybegoodJ johnnybegood

                              @stxpnet 平时我只要跑起来就 90度啊。。。

                              stxpnetS
                              stxpnetS
                              stxpnet
                              王侯将相
                              发表于 最后由 编辑
                              #17

                              @johnnybegood 90度,nvtop显示GPU和显存频率分别多少呢? 我的显卡要是到80度我就直接停了,我平时高负载从来没有超过70度过。

                              双卡3090 PCIE 4.0 16X/16X

                              白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                              夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                              1 条回复 最后回复
                              1

                              你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                              厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                              有了你的建议,这篇帖子会更精彩哦 💗

                              注册 登录
                              回复
                              • 在新帖中回复
                              登录后回复
                              • 从旧到新
                              • 从新到旧
                              • 最多赞同


                              • 登录

                              • 登录或注册以进行搜索。
                              • 第一个帖子
                                最后一个帖子
                              0
                              • 版块
                              • 最新
                              • 标签
                              • 热门
                              • 用户
                              • 群组