Your browser does not seem to support JavaScript. As a result, your viewing experience will be diminished, and you have been placed in read-only mode.
Please download a browser that supports JavaScript, or enable it if it's disabled (i.e. NoScript).
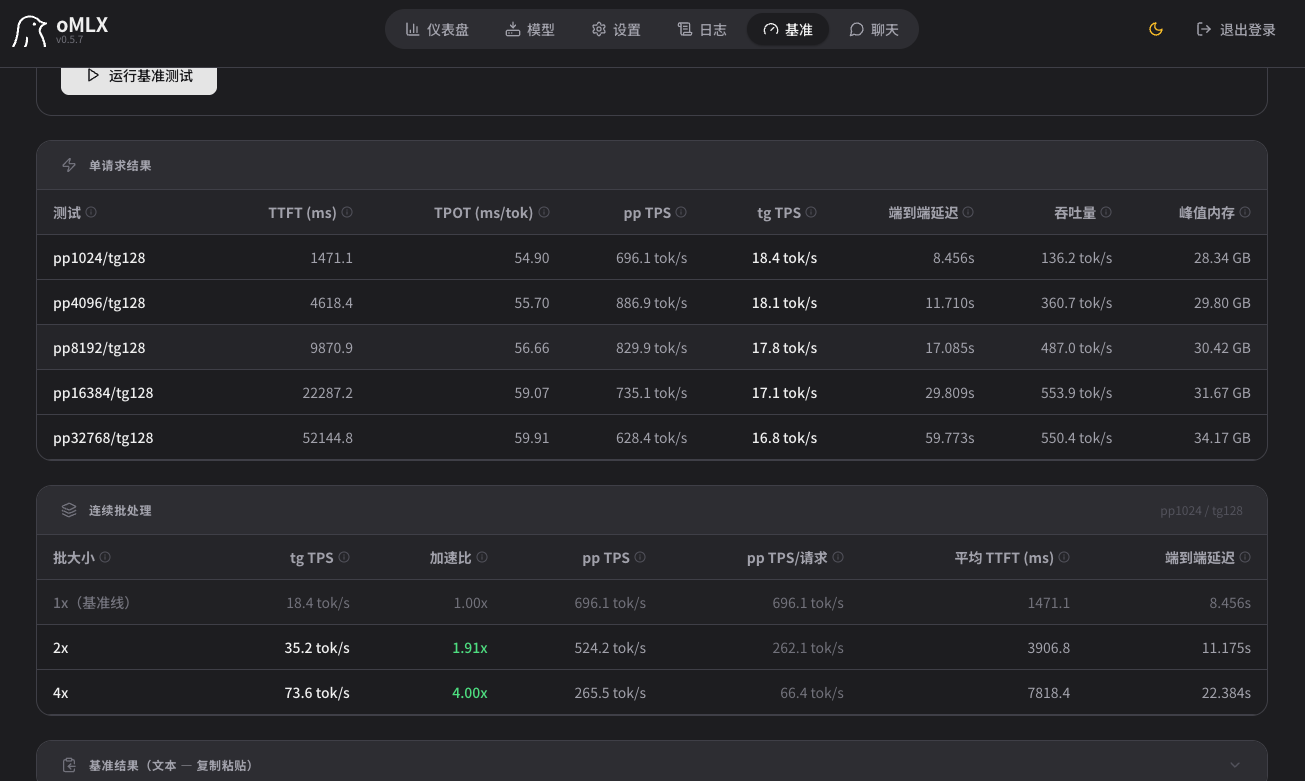
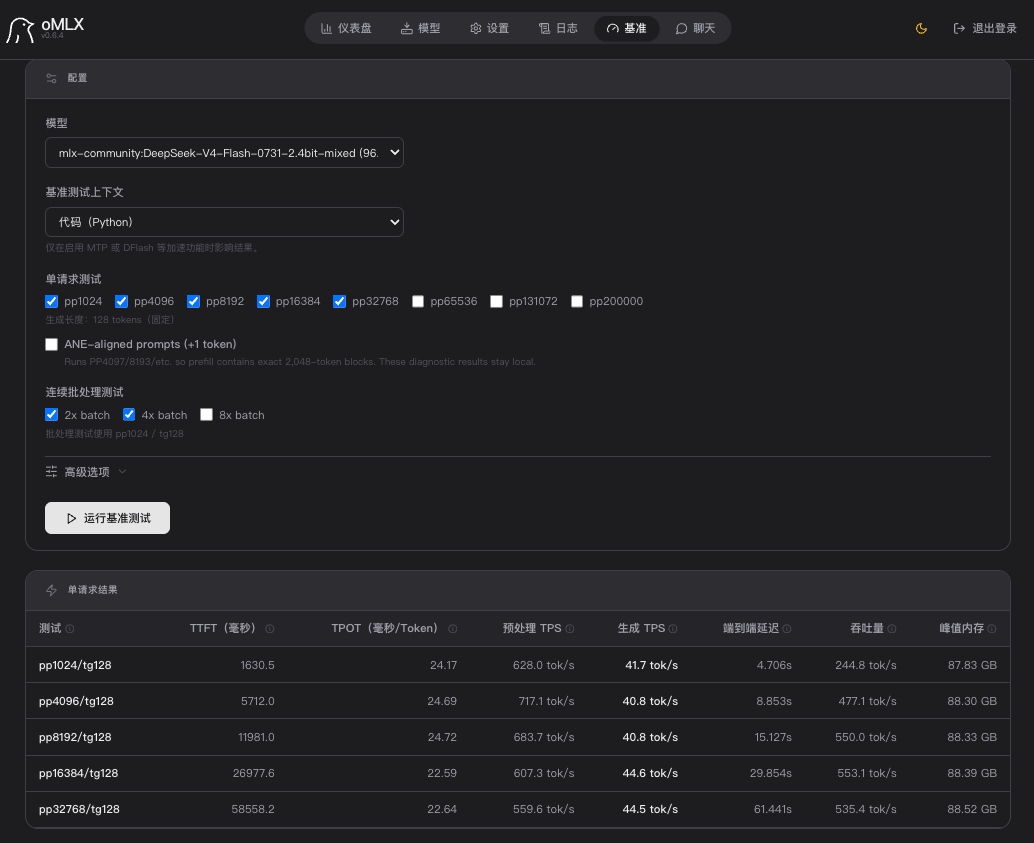
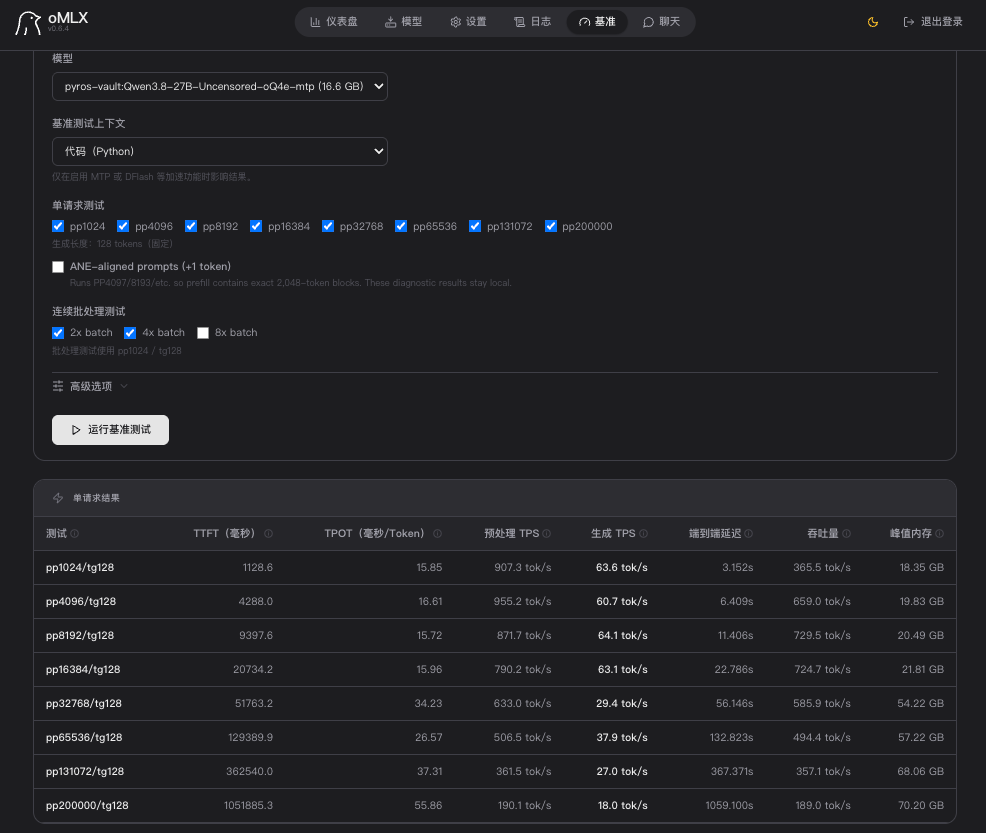
Qwen3.8发布,先试了试在M5 Max上跑的速度,用的是lmstudio-community/Qwen3.8-27B-MLX-8bit,结果如下,供大家参考。
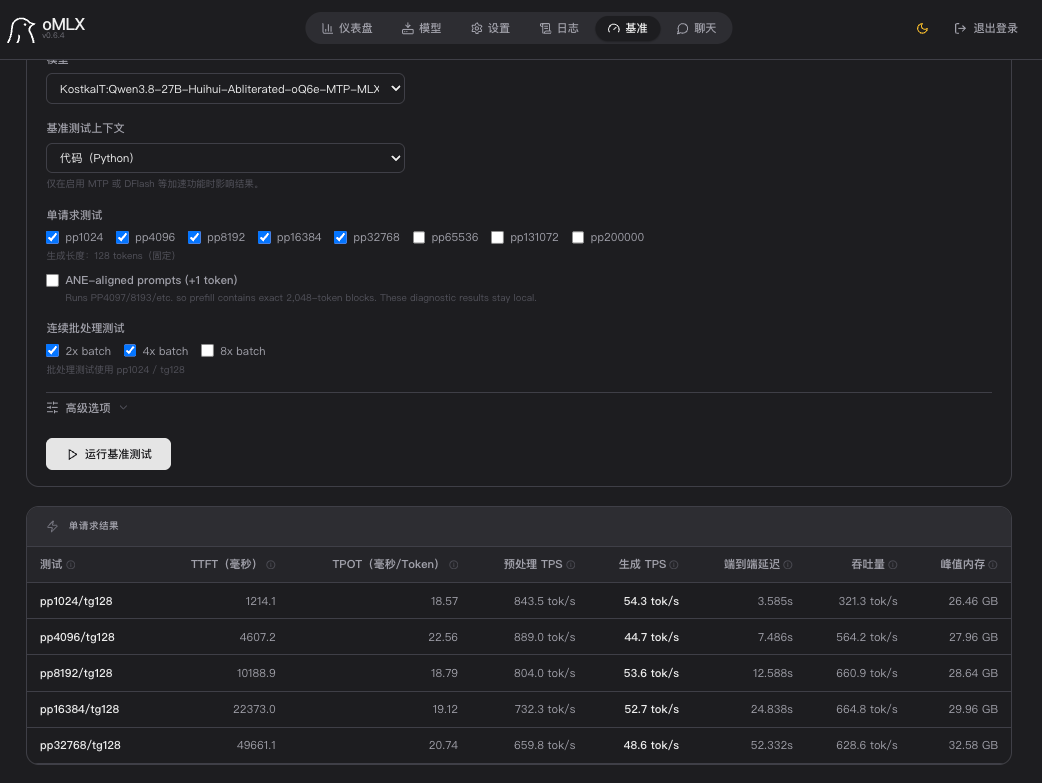
开了MTP Q6可以跑到40-50tps,还是多模态无审查模型。纯文本Deepseek V4 flash也是可用的速度。
@zorg 那还挺好,长上下文如何,我看最高才32K,意义不大。max的算力还是不错啊,其实640G的带宽和R9700 Pro一样了。
@terry
@zorg 这个速度感觉真能用了。就是价格还是有点美丽
@zorg 还行,prefill如何,如果不慢这速度够用,加上苹果的安静,是有市场的。
@zorg said: 开了MTP Q6可以跑到40-50tps,还是多模态无审查模型。
@zorg said:
开了MTP Q6可以跑到40-50tps,还是多模态无审查模型。
如果是 MTP Q4 不就可以上50-60 tps, 但要看輸出品質的差異是否可用? Agent 可能差異不大 但coding或許有差異
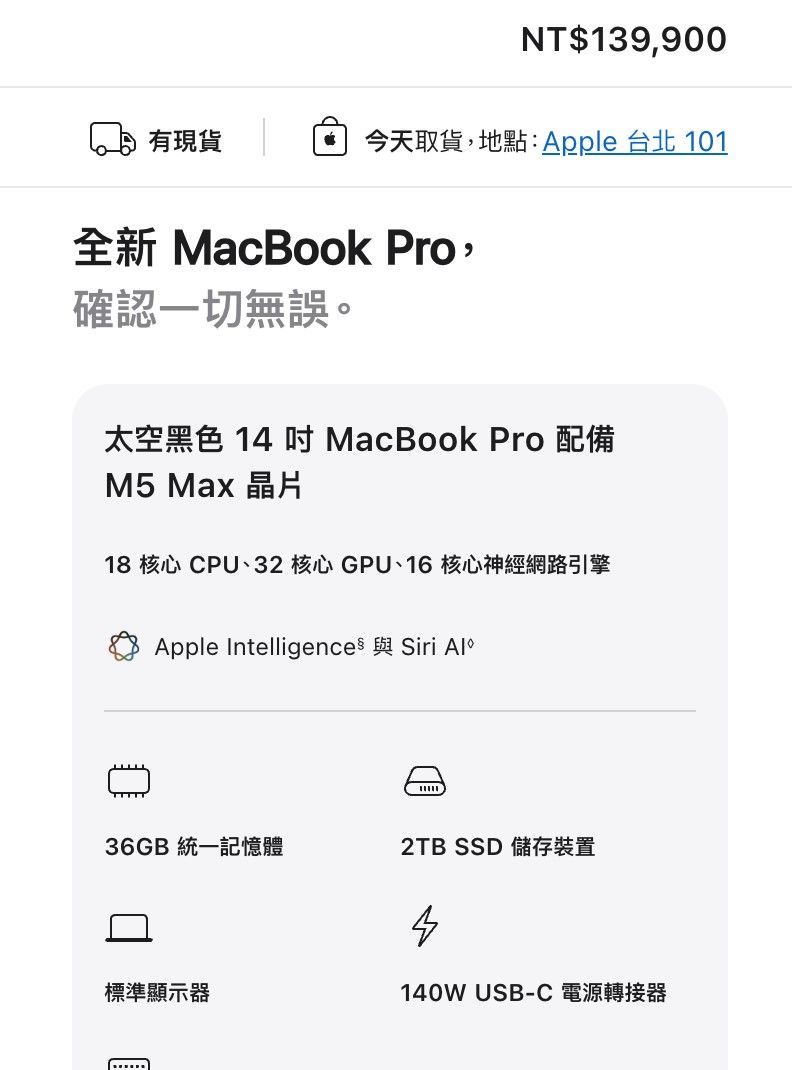
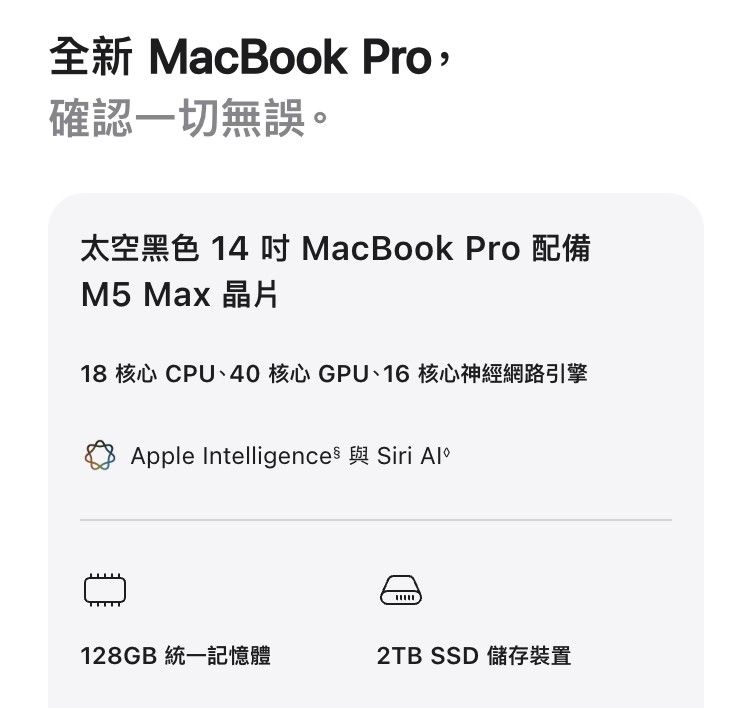
沒研究過Apples , 放在供大家 參考一下價格
Apple "MacBook Pro" M5 Max 基本款 約14萬台幣 , 18C CPU/32C GPU , 36 GB Unified Memory,
Apple "MacBook Pro" M5 Max 頂規 約24萬台幣 , 18C CPU/40C GPU , 128 GB Unified Memory,
上下文窗口32K其实在真实环境下使用率不高,同样的M5MAX 128G, 为了用DSH,开了262K,关闭思考,越到后面越慢,加上dflash2,也就堪堪能用,不过那速度真的别指望了,这种情况还不能完全指望用hermes。所以现在换成qwen3.6-35B-A3B顶着,至少能看到点儿希望。
等吧,如果qwen3.8出MOE了应该会好不少。
你好!看起来您对这段对话很感兴趣,但您还没有一个账号。
厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。
有了你的建议,这篇帖子会更精彩哦 💗