
Qwen3.8-27B 测试Nvidia RTX 3090 llama.cpp MTP TurboQuant
-
简单测试一下,供大家参考
配置项 具体信息 硬件 NVIDIA GeForce RTX 3090 24GB 推理框架 llama.cpp 加速技术 MTP (Multi-Token Prediction) 显存优化 TurboQuant 模型文件 Qwen3.8-27B-Q3_K_M.gguf 启动脚本
./llama-cpp-turboquant-mtp/build/bin/llama-server \
  -m ./models/Qwen3.8-27B-Q3_K_M.gguf \
  --mmproj ./models/mmproj-BF16.gguf \
  -c 131072 \
  -n 512 \
  -t 12 \
  -ngl 99 \
  --parallel 1 \
  --cache-type-k turbo3 \
  --cache-type-v turbo3 \
  --flash-attn on \
  --mlock \
  --batch-size 512 \
  --ubatch-size 512 \
  --reasoning-budget 0 \
  --spec-type draft-mtp \
  --spec-draft-n-max 3 \
  --spec-draft-p-min 0.75 \
  --host 0.0.0.0 \
  --port 8080 \
  --log-disable
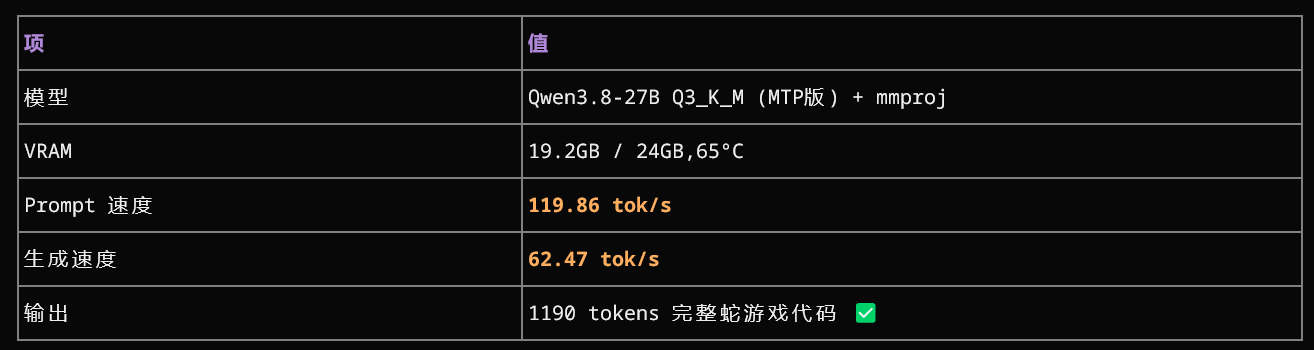
贪吃蛇简单测速
3D小球测试
请制作一个网页 3D 小球物理实验,要求同时存在 10 个不同颜色的球,它们受到重力影响并发生碰撞,用户可以拖动球,右侧可以调整重力和弹性,并提供开始、暂停、重置按钮。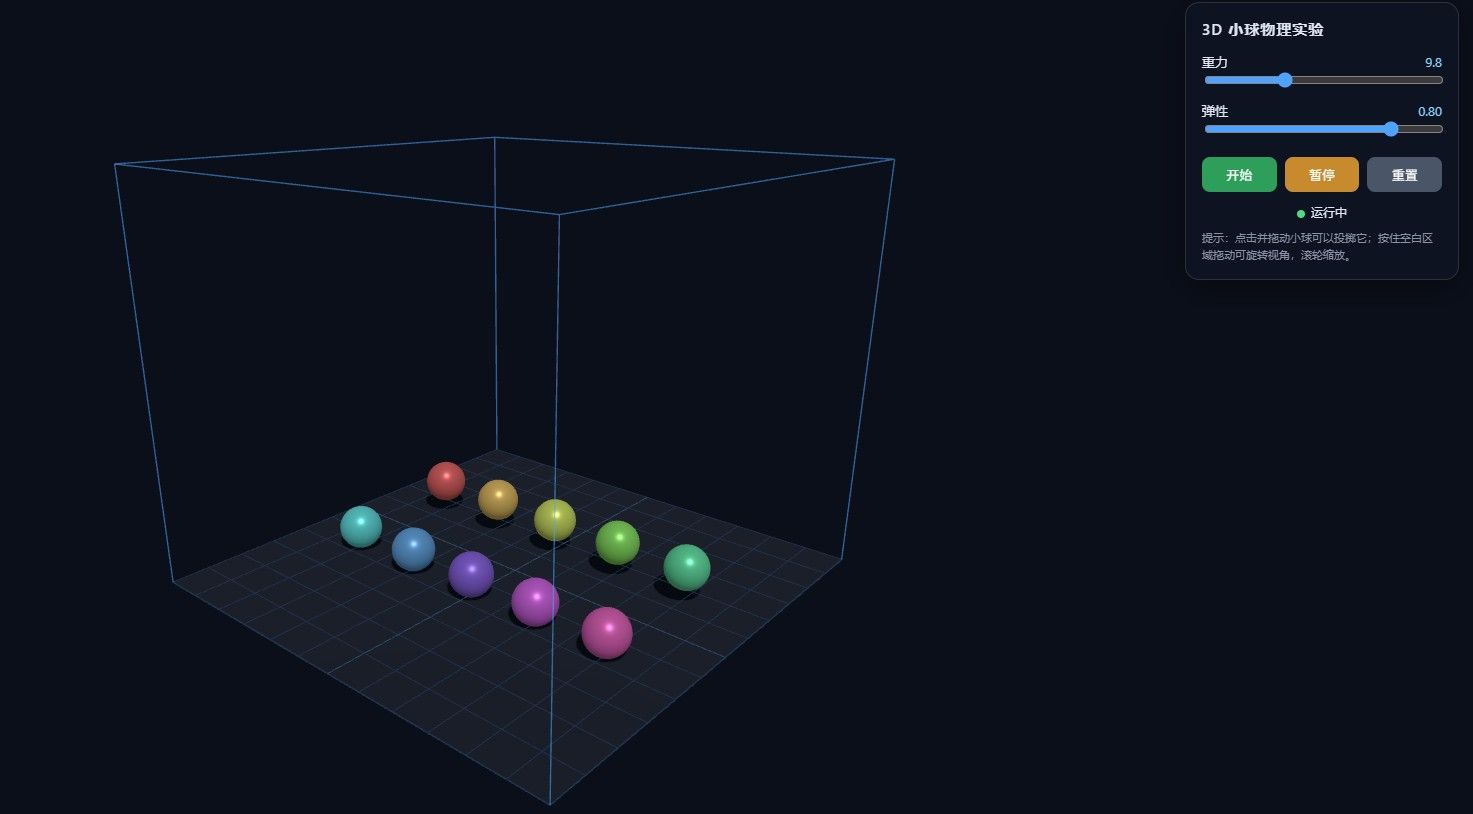
-
,
 T terry 固定了此主题
-
-
文中有地方显示错误,还是输入问题。
Qwen3.6-27B-Q3_K_M.gguf 一直都是用的这个模型。@williamlouis 我被打脸了
@像素盒子 哥们你看下你的帖子,有要要修正的地方吗? -
@williamlouis 我被打脸了
@像素盒子 哥们你看下你的帖子,有要要修正的地方吗? -
文中有地方显示错误,还是输入问题。
Qwen3.6-27B-Q3_K_M.gguf 一直都是用的这个模型。 -
,系统 取消固定了此主题

