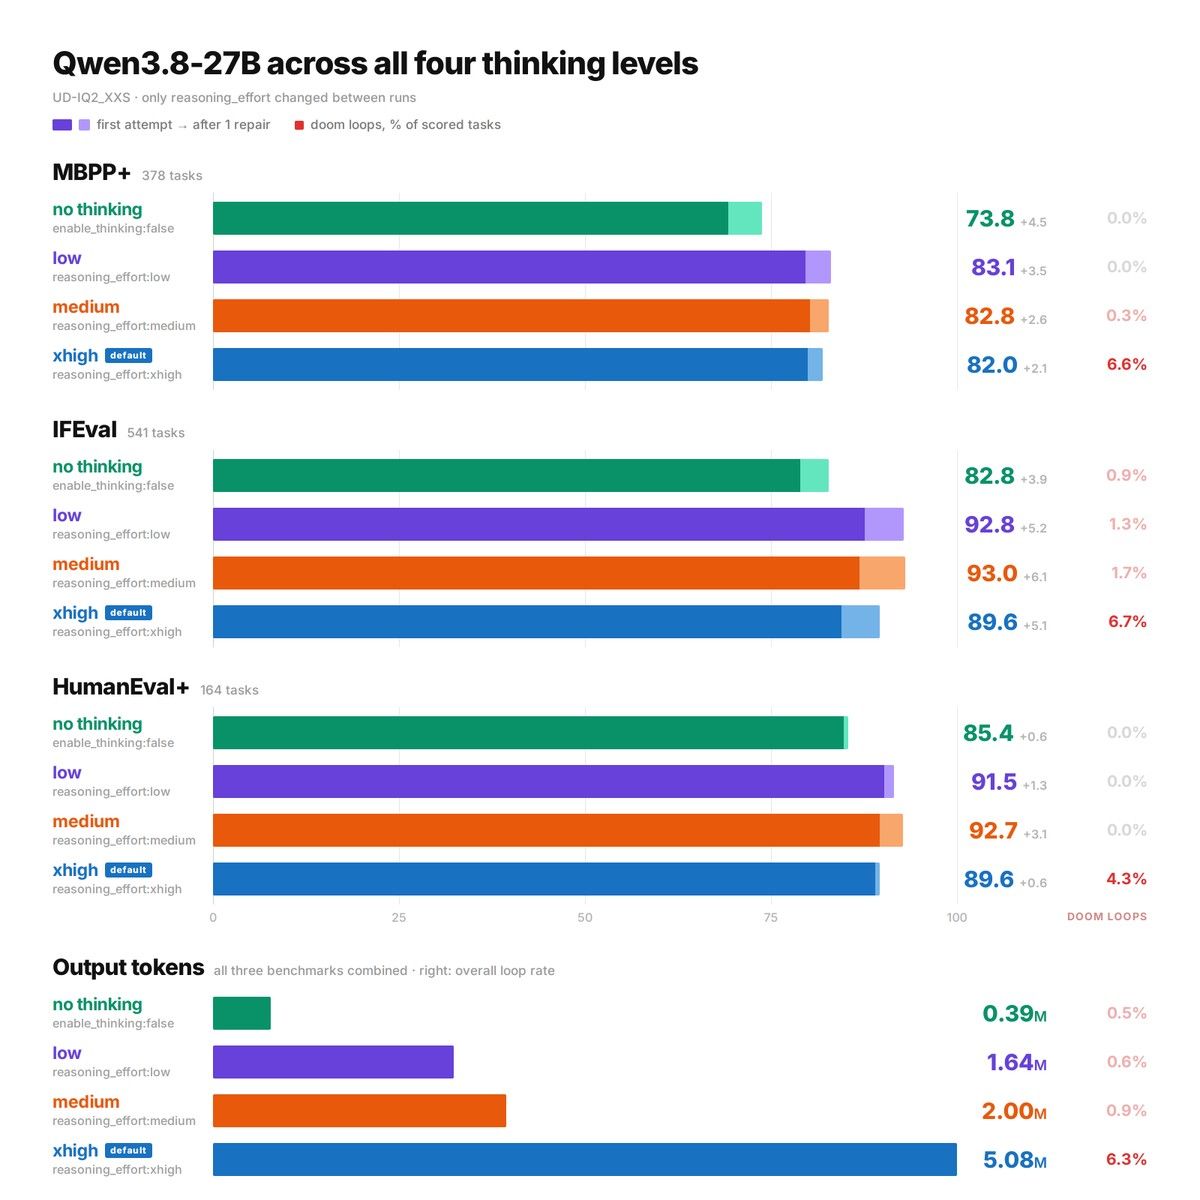
请教一下大神们像 qwen 27b 或者 35b 这类本地模型什么时候会开思考模式?
-
直接就关了就行。
-
本地 27B/35B 这边,结论直接收下:该关。这类尺寸的稠密模型,思考模式本来就是可开关的(Qwen3 系原生支持 enable_thinking),但你实测的"开了慢好几倍、结果差不多"就是它的真实水平——27B 的知识和推理能力都压在权重里,思考 token 只是把同样的权重再过一遍,并不能凭空多出能力。DeepSeek 说"这类模型不用开、开了也没用"是对的,原因就是这个,不是模型不支持。
API 那边是另一回事,要分任务开,不是永远关:
-
DeepSeek API 的模型大得多(V4 系列是 300B 级 MoE),思考模式对复杂任务真有用:疑难 bug、数学证明、多步规划这类,开思考能把正确率拉上去一截——和本地 27B"开了白开"是两个量级。
-
判断标准很简单:任务需要多步推理就开,简单问答、信息抽取、改写、翻译就关。开思考多花的不仅是延迟,reasoning token 也是计费的,DeepSeek 单价便宜,但高频调用累积起来也看得见。
-
Agent 场景要特别注意:Hermes/Codex 这类框架每轮工具调用如果都先想半天,延迟会叠加得很难受。跑 Agent 建议用低档思考或干脆关掉,让它先干活再想;一次性硬核问题再开高档。
-
各家 API 的开关形式不一样:DeepSeek 是 chat/reasoner 双端点,新版也支持类似 effort 的分档。开之前先查文档里 thinking 参数怎么传,别用错端点。
简单记:本地小模型关到底,API 大模型按任务难度开,Agent 循环里尽量关。
-
-
实测的数据都表明 开思考和关闭得到的结果是一致的 。本地模型想不出什么花样。
在线的能折腾出点东西。参数大而已。也不如人类辅助来的痛快。token 烧掉的钱和它思考出的结果价值在常态下是不匹配的。少数情况可以。比如一些 个人的知识盲区,可以尝试。个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
实测的数据都表明 开思考和关闭得到的结果是一致的 。本地模型想不出什么花样。
在线的能折腾出点东西。参数大而已。也不如人类辅助来的痛快。token 烧掉的钱和它思考出的结果价值在常态下是不匹配的。少数情况可以。比如一些 个人的知识盲区,可以尝试。