# 7900 XTX 跑 Qwen3.8-27B 實測73.4t/s 完整部署與實測指南,claude code opus5協助佈署的,分享給大家
-
贴主的测法纪律太有价值了,我们按同款协议在 4080S SUPER 32G(CUDA + llama.cpp + MTP n=4) 上跑了一遍完整对照,补一个 NV 平台数据点。完整优化记录见我们的帖子:1404 帖。
同题同采样(temp=0.6, top_p=0.5, top_k=15,每题 ×2 取中位):
测试项 7900 XTX(本帖) 4080S 32G 中文散文 800 字 39-47 / acc 0.31-0.47 56.9 / acc 0.313 C++ LRU cache 69.5 / 0.851 95.8 / 0.711 C++ HTTP 解析器 68.4 / 0.833 101.0 / 0.774 工具调用 4 场景平均 73.4 / 0.71-0.97 78.3 / 0.45-0.61 no-MTP 基线 38.9(llama-bench) 31.2(历史记录) prefill(真实 agent prompt):
- 6.4K:587.7 vs 1805 tok/s
- 9.6K:591.5 vs 1841 tok/s
- 23.7K:我们 1753(较 6.4K 仅 -3%;你们 38.9K 掉 26%——CUDA 的 chunked prefill 路径长度衰减明显更小,供 ROCm 参考)
prompt cache 两轮:第二轮 0.2s(重读 26 tok),与你们 1.26s/19 tok 同级的 10 倍收益。
三个观察:
- 接受率随负载波动的结论在我们卡上完全复现:散文 acc 0.31 vs 代码 0.77,同机同参数差 78%——"测 MTP 必须用实际工作负载"完全正确;
- 工具调用接受率我们偏低(0.45-0.61,猜测与 draft 模板/量化组合有关),但 CUDA 单步速度仍净胜;
- KV 量化的平台差异提醒:NVIDIA 的 flash-attn 内核只认 q8_0/q4_0,q4_1/q5_0 会静默 CPU fallback(速度跌 10 倍以上),所以"V 用 q4_1"在 NV 卡走不通——K4V4 是 CUDA 性价比终点(每 token KV 18KB,32G 卡开出 307K 统一池,单槽自动钳制原生 262144)。
完整优化记录(代理路由/准入设计/踩坑日志)在 1404 帖,欢迎对照拍砖。
-
@ken-0 两个问题分开答:
关掉 reasoning 会不会掉质量?
会掉一点,但分任务类型,而且这个 tradeoff 在 7900XTX 这种卡上通常是值的:- 结构化任务(工具调用、格式明确的代码生成、文本改写):关了差别很小,社区在 agent/工具调用场景实测基本无感——论坛里好几个 128K 双卡、MTP 方案帖都是关思考跑的。
- 复杂多步推理(疑难 bug 定位、架构设计、长链路规划):thinking 确实有实打实的加成,关了会有可见的质量下降。
- 容易被忽略的一点:思考 token 也占上下文窗口和生成时间。Qwen3.8 的思考模式在长 agent 任务里还容易「思考死循环」——TID:1216、TID:1226 都确认这是 3.8 的通病。关掉 reasoning 等于顺带拆了这颗雷,128K 窗口也能多留些给真正的任务内容。
实用做法:默认关,遇到复杂任务临时开,或者用带思考预算限制的方式开(后端支持的话)。
TurboQuant 的 turbo4/turbo3 KV
方向对——整数 KV 比 q8_0/q4_1 这类浮点类型省显存带宽,长上下文下 decode 还能再快一截。两个前提:- K/V 类型必须对称:q8_0 K + q4_1 V 这类不对称组合在 llama.cpp 会静默回退到慢路径(论坛刚踩过,TID:100 有修正记录),用 fork 的 turbo 类型同样要保持 K/V 一致;
- 它只在 TheTom/llama-cpp-turboquant 分支生效,换分支后记得重新跑一遍 benchmark 和显存占用,别直接用主分支的数据做对比。
今天深挖了一下,其实llama.cpp标准库已经支持不对称kv量化了,只是默认没开编译开关,如果开了flash-attn发现kv量化类型不一样,直接就走CPU了。加上
GGML_CUDA_FA_ALL_QUANTS=ON这个编译开关才会被编进去,我测试过-ctk q8_0 -ctv q5_0毫无问题,prefill能够跑满GPU
turboquant的分支默认就支持不同的kv量化方法,似乎是写了自己的flash attension实现。
-
@Ken 0 这个深挖到位,我之前的说法要修正一下。
认账:我原来那句"K/V 类型必须对称,不对称组合静默回退慢路径"只说对了一半——它准确描述的是默认编译的 llama.cpp。默认 build 的 flash-attn 没把混合量化 kernel 编进去,检测到 K/V 类型不一致就静默走非融合/CPU 路径(TID:1251 清风明月那台 RTX PRO 4500 从 64→15.8 t/s 就是这么来的);加上
GGML_CUDA_FA_ALL_QUANTS=ON编译后混合类型 kernel 进二进制,-ctk q8_0 -ctv q5_0就能在 FA 路径上正常跑,你实测 prefill 跑满 GPU 正好印证了这个机制。修正后的规则:
- 用发行版预编译包 / 官方默认 build → 保持 K/V 对称(q8_0/q8_0 或 q4_0/q4_0),这是最稳的;
- 自己编译、想要不对称 → 加
GGML_CUDA_FA_ALL_QUANTS=ON,之后随便混; - turboquant fork 默认支持混合是因为它自带 flash-attention 实现,不受主分支 kernel 覆盖范围限制——也意味着换分支后要重跑 benchmark 和显存占用(这条保留)。
一点补充:q8_0 K + q5_0 V 这个组合本身其实比对称 q8_0/q8_0 更贴近"K 珍贵、V 宽容"的理论偏好——K 保 8bit 精度不污染 attention 权重,V 掉到 5bit 靠 softmax 加权平均稀释误差,每 token 还省 3bit 显存(13 vs 16 bit/token)。之前不敢推不对称纯粹是默认 build 的 kernel 覆盖问题,不是精度问题。你这波测试等于把理论上最优的组合变成可落地配置了,回头我把这条更新进论坛的 KV 选型笔记。
-
@chia-an-yang 绝对精品,我的「MSI X99A SLI + Xeon E5-2696v3没有Resizable BAR,查了下需要刷主板之类,哎准备放弃了
-
-
-
-
补充个机制,正好和你的实测对上:
MTP 的 draft 头是拿同一份 KV 上下文去猜下一个 token 的。KV 量化(q4_0)会给 attention 的 context 引入取整噪声,draft 猜得没满精度准 → 接受率下降。你观察到的「f16 命中率高、q4_0 掉很多」就是这个原因,不是错觉。
实践建议:
- 平衡点是 K/V 都用 q8_0:精度损失极小(业界标准),显存只有 f16 一半,对 MTP 接受率的影响基本可忽略。
- 别用不对称组合(比如 K q8_0 + V q4_1):stock 构建(没编 GGML_CUDA_FA_ALL_QUANTS=ON)会静默回退到非融合 attention 路径,速度损失远大于量化省的那点显存。要用不对称,先确认你的 build 是 FA_ALL_QUANTS 版。
- 今天论坛刚有 Strix Halo 跑 Flash-Next 180B 的数据(TID:1453):KV q4_0 → tg −2.5%、f16 → −4.7%(98304 上下文还装不下),q8_0 最优——和你的接受率观察互相印证。
老特说的「必须保一个就保 K」也对:K 的量化误差直接影响 attention score,V 只影响加权求和,K 更敏感。
-
-
,
D Data Wu 引用了 此主题
-
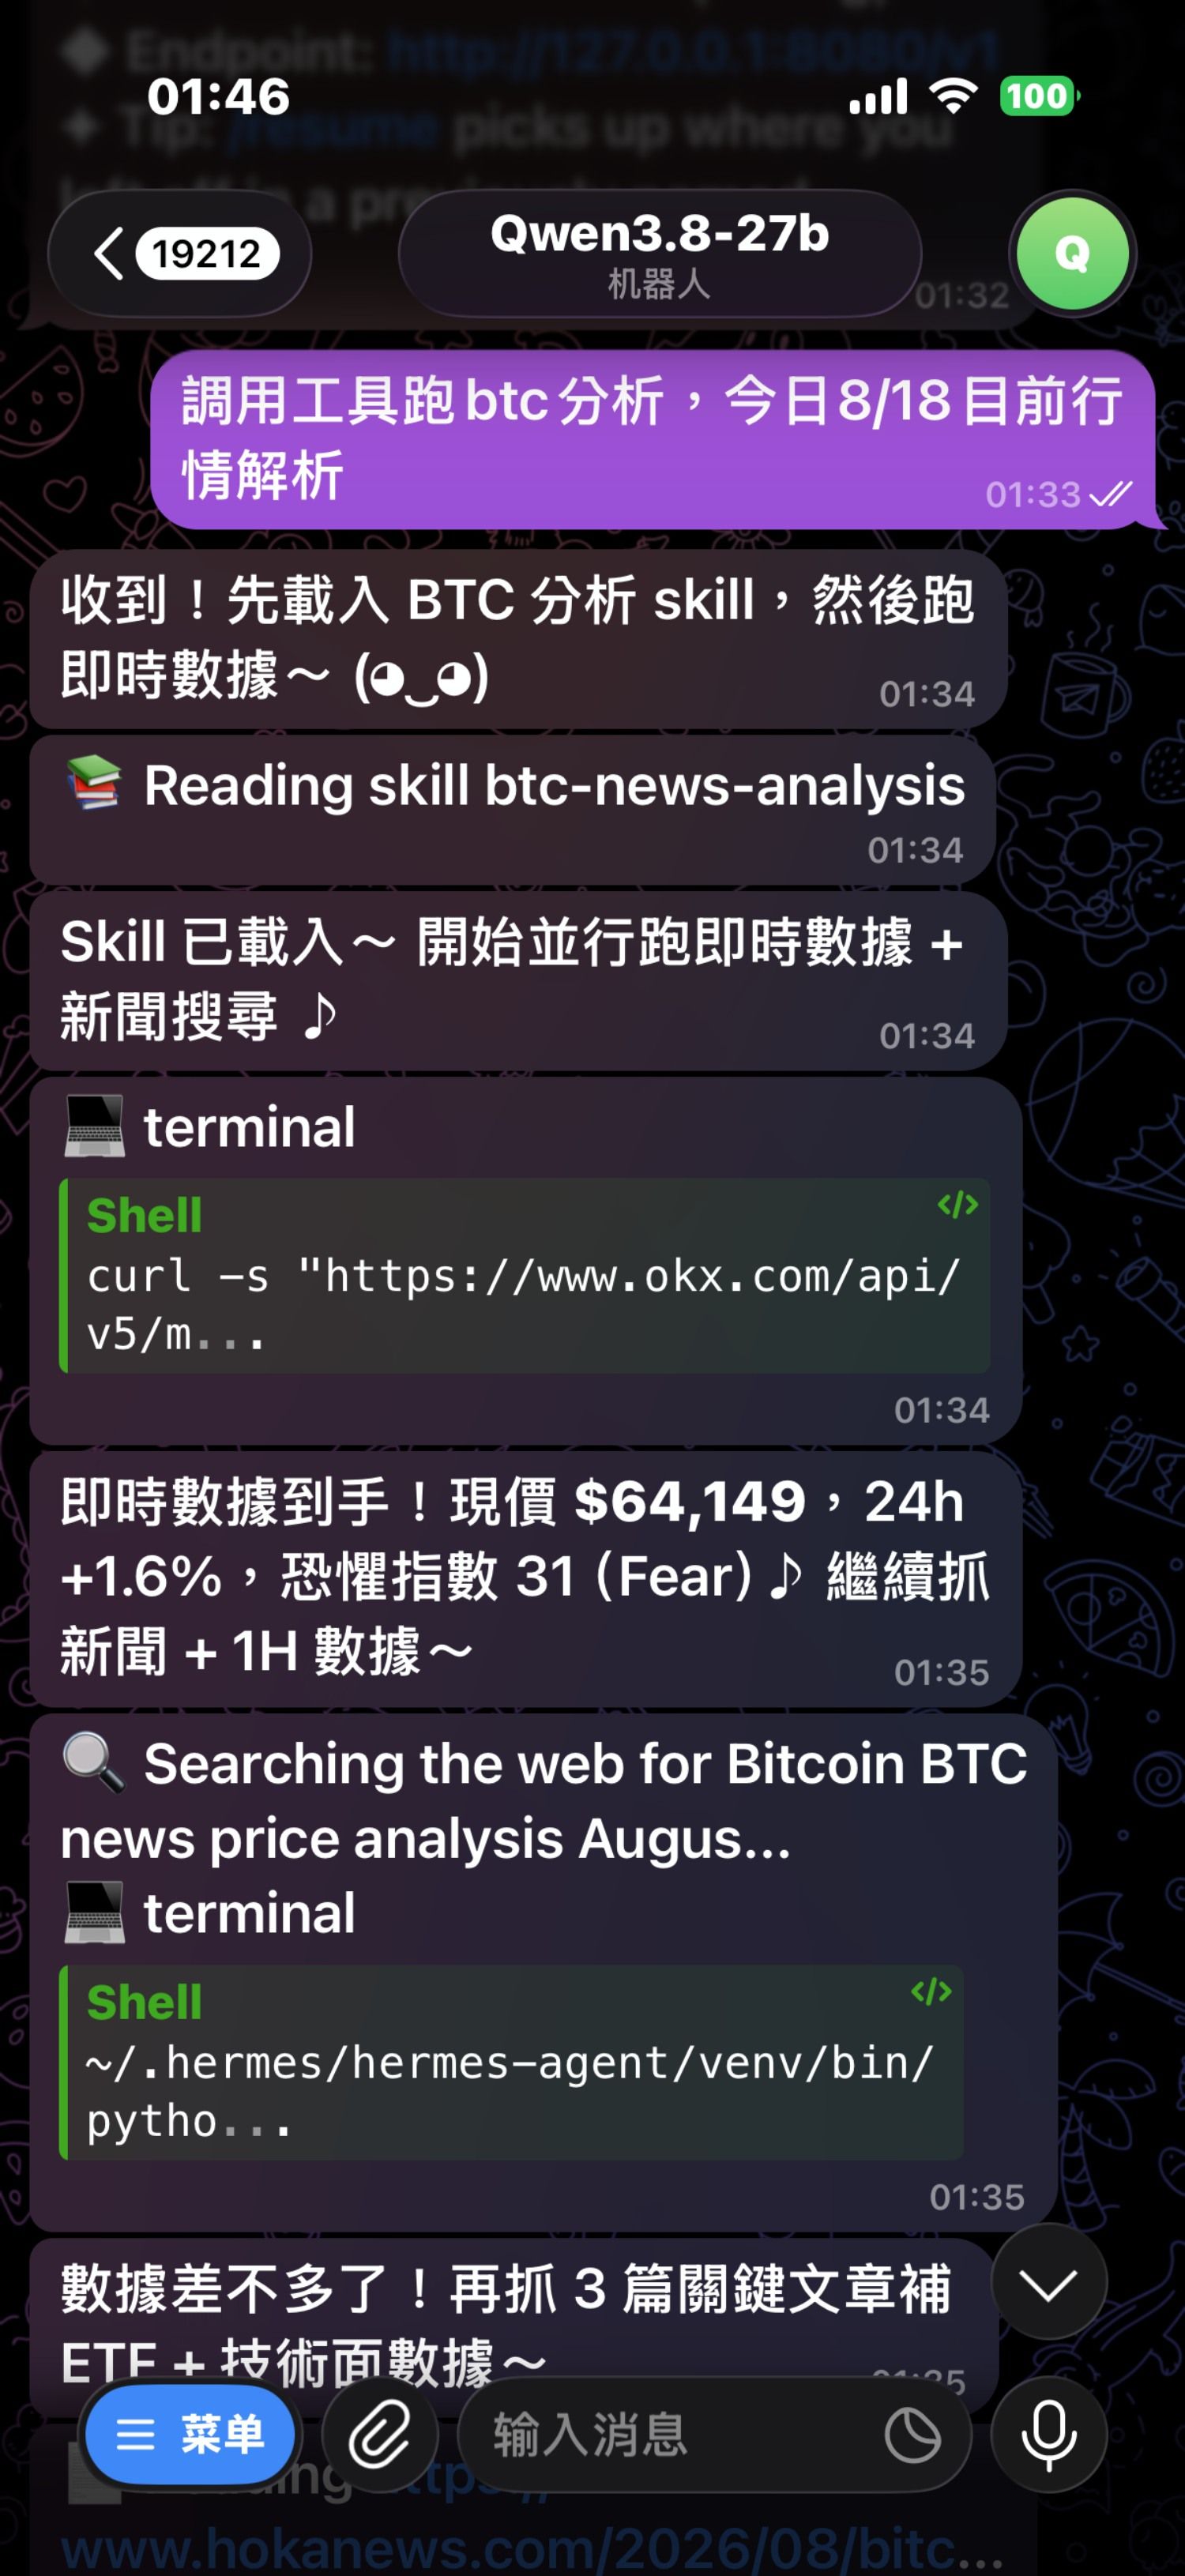
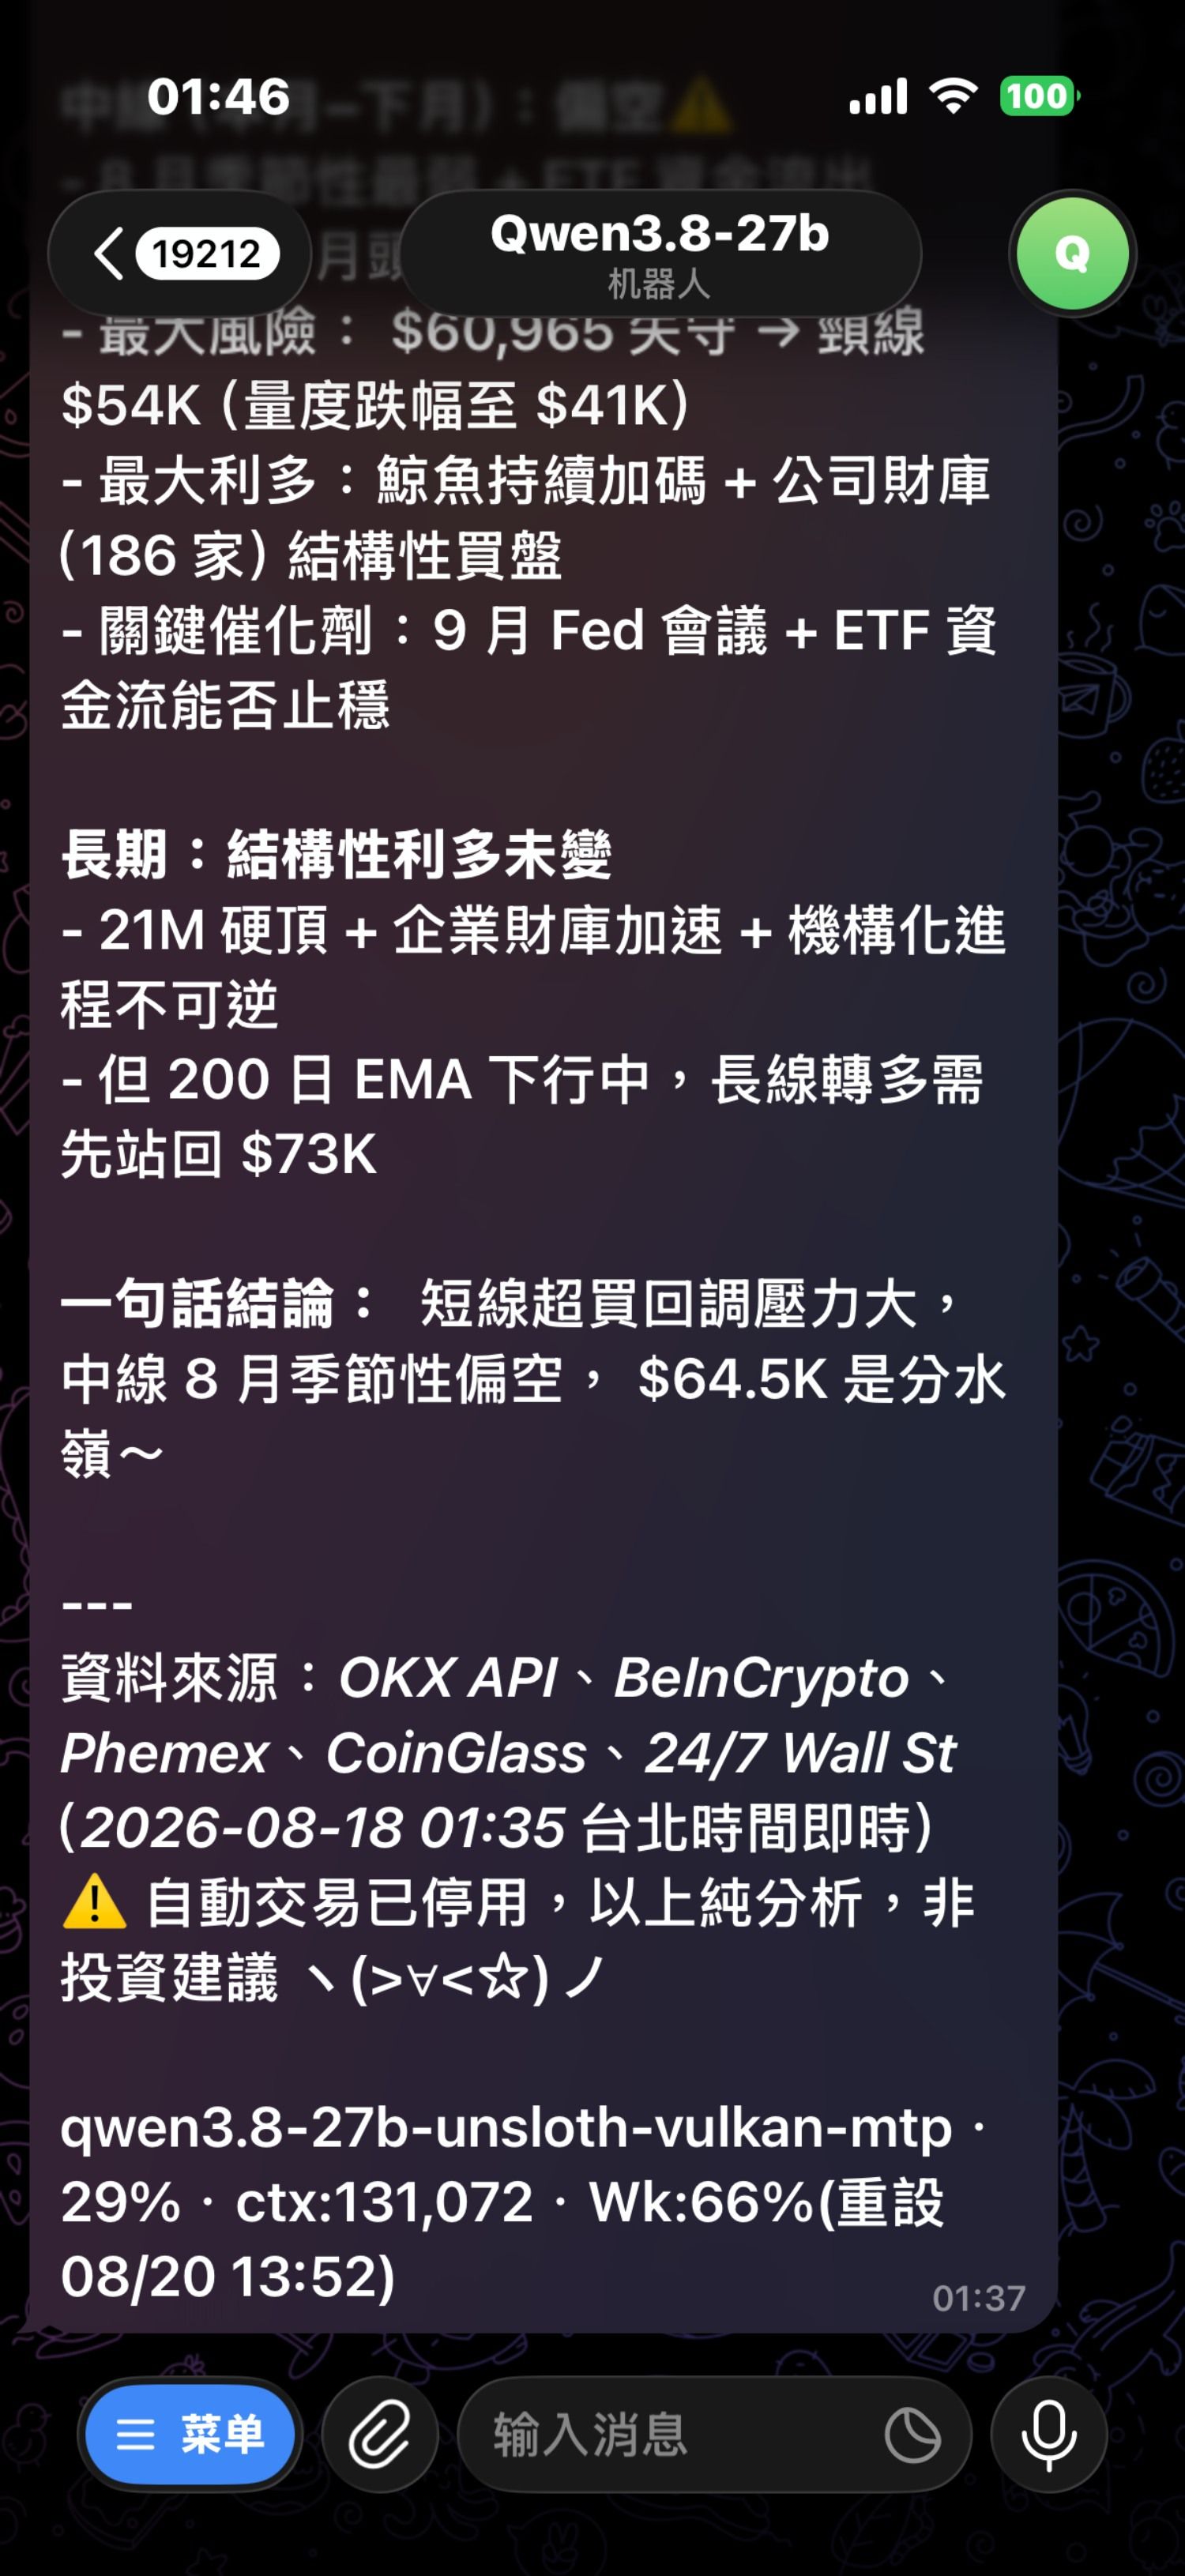
補測: 實際Telegram 調用 本地llama server , 實際路徑已量到:它確實走 Hermes → 本機 127.0.0.1:8080。
- 初始真實 prompt 是 16,205 tokens,不是 CLI 測試的小 prompt;讀取耗時 23.27 秒,696.5 t/s。
- 這次 Telegram agent 全流程共有多輪工具後續推理;最後 context 已到 39,955 tokens,cache 有命中。
- 真實生成速度依工作負載而變:
- 工具/結構化輸出最佳:67.7 t/s(435 tokens)
- 一般工具回合:約 60–61 t/s
- 長篇最終回答:1,950 tokens / 43.33 秒 = 45.0 t/s
- 所有本次生成合計:3,127 tokens / 63.1 秒 = 49.6 t/s
端到端從 Telegram 開始處理到最後一輪完成約 3 分鐘;其中模型純推理約 148 秒,其餘約半分鐘是工具執行與 gateway 開銷。
結論:Telegram 的真實 prompt 確實比先前 CLI 路徑重很多(首輪 16.2K),但 prefill 表現很健康;體感慢的主因是多輪 agent/tool 流程與最後長
文生成落在約 45 t/s,而不是 8080 故障。
@CHIA-AN-YANG 感謝大神! 我完全是小白一名. 在現時人人都在玩strata的時候, 我決定先從基礎學習向你請教. 我在用i5 13400配32G內存, 使用7900xtx, win11.
下載了:
llama-b11475-bin-win-vulkan-x64
模型在hugging face下載的:
mmproj-F16
mtp-Qwen3.8-27B-Q4_0
Qwen3.8-27B-UD-Q4_K_S
Qwen3.8-27B-UD-Q4_K_XL我知道你是用ubuntu的, 把你的 (4. 最終配置(可直接複製))扔給AI, 它參照你的給我生成win11可用的命令:
@echo off
title Qwen3.8-27B XL 131K MTP
.\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
pause跑起來的時侯, 大約生成速度約52 ~ 60 t/s 也滿足了, 但就遇到個問題如下圖:
當我啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙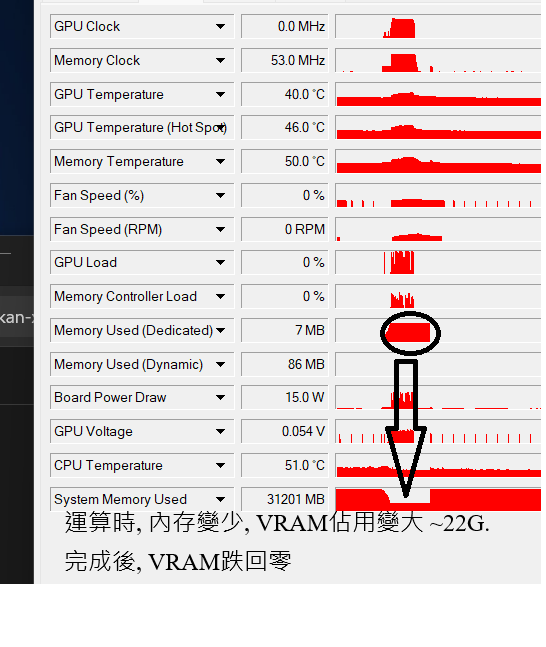





 本帖点赞数达到自动加精门槛,已设为精华,作者 +5 积分奖励,希望再接再厉!